Cerebras 万亿参数部署拆解:Kimi K3 装进 59 片 WSE-3T 晶圆的完整算式
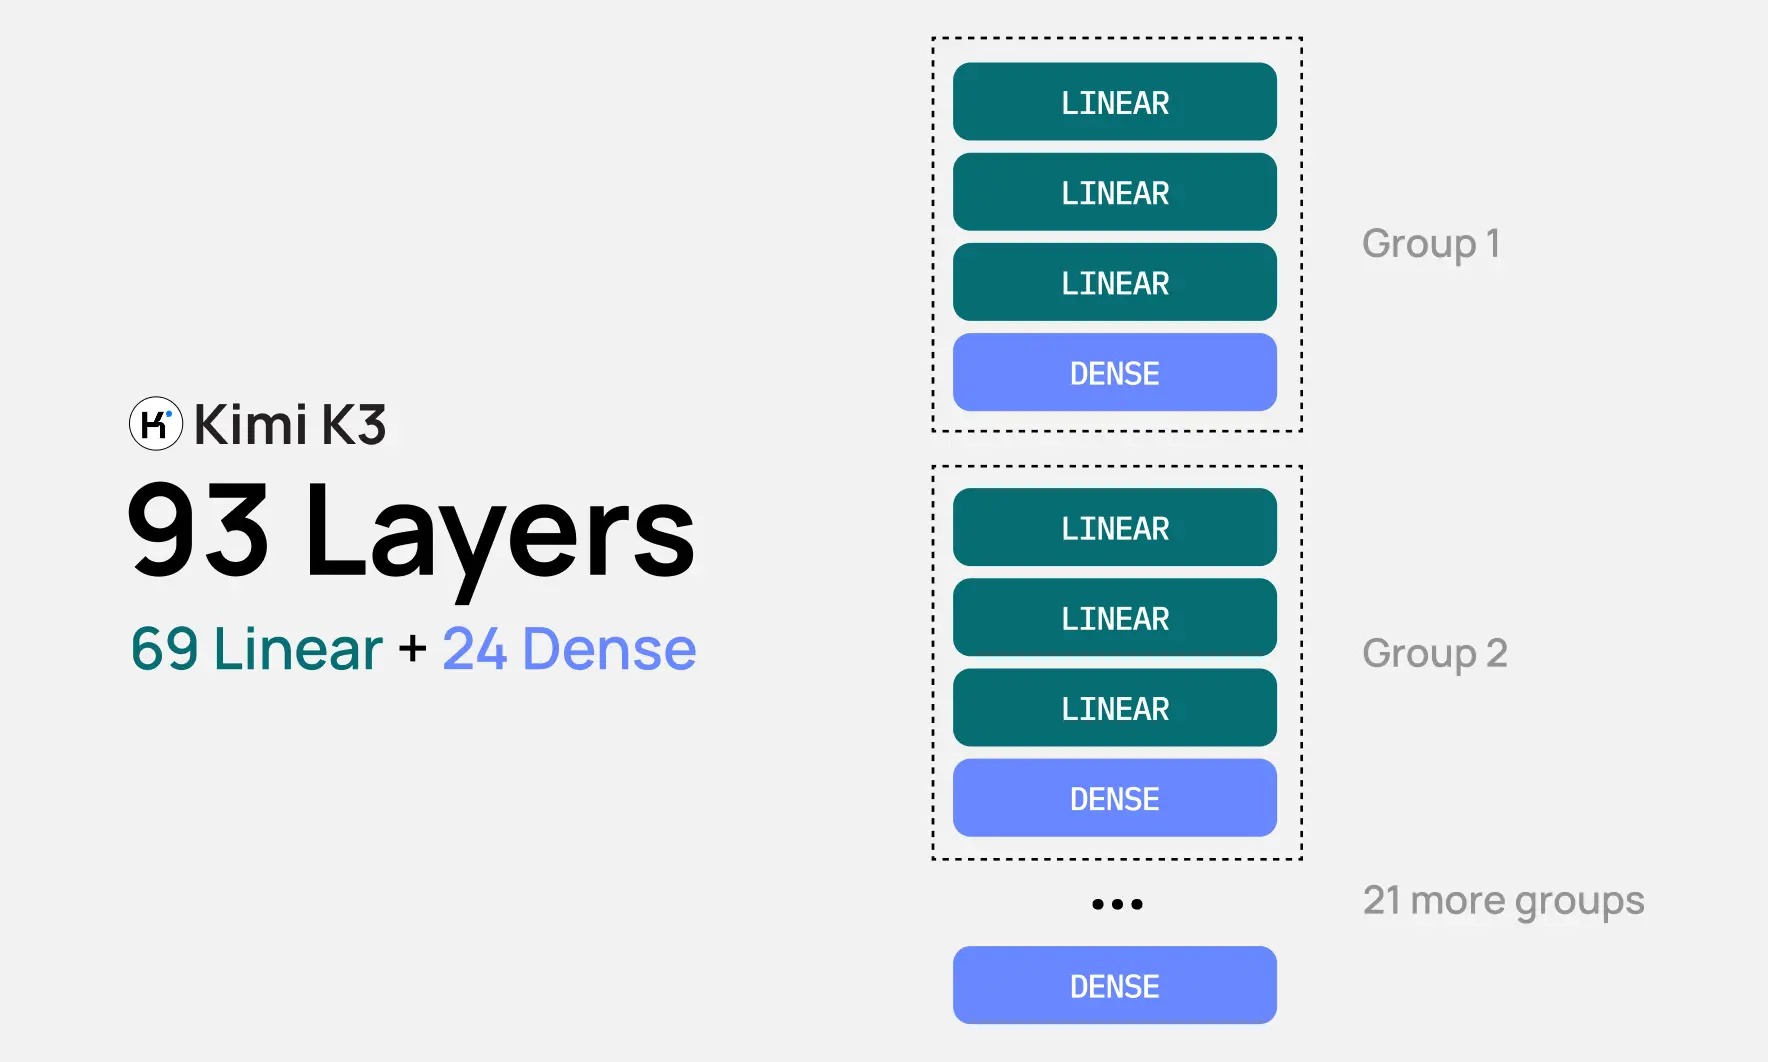
一片 Cerebras WSE-3T 晶圆只有 44 GB 片上内存,而万亿参数模型光权重就要占掉 TB 级空间。这个数量级差距怎么解决?Cerebras 工程团队在官方博客发了一篇完整的部署推演,以开源模型 Kimi K3(约 3 万亿参数)为例,把「3T 参数放进多少片晶圆、每片放什么、怎么连起来、能同时服务多少请求」四个问题全部算了一遍。这篇文章把整条…
一片 Cerebras WSE-3T 晶圆只有 44 GB 片上内存,而万亿参数模型光权重就要占掉 TB 级空间。这个数量级差距怎么解决?Cerebras 工程团队在官方博客发了一篇完整的部署推演,以开源模型 Kimi K3(约 3 万亿参数)为例,把「3T 参数放进多少片晶圆、每片放什么、怎么连起来、能同时服务多少请求」四个问题全部算了一遍。这篇文章把整条…
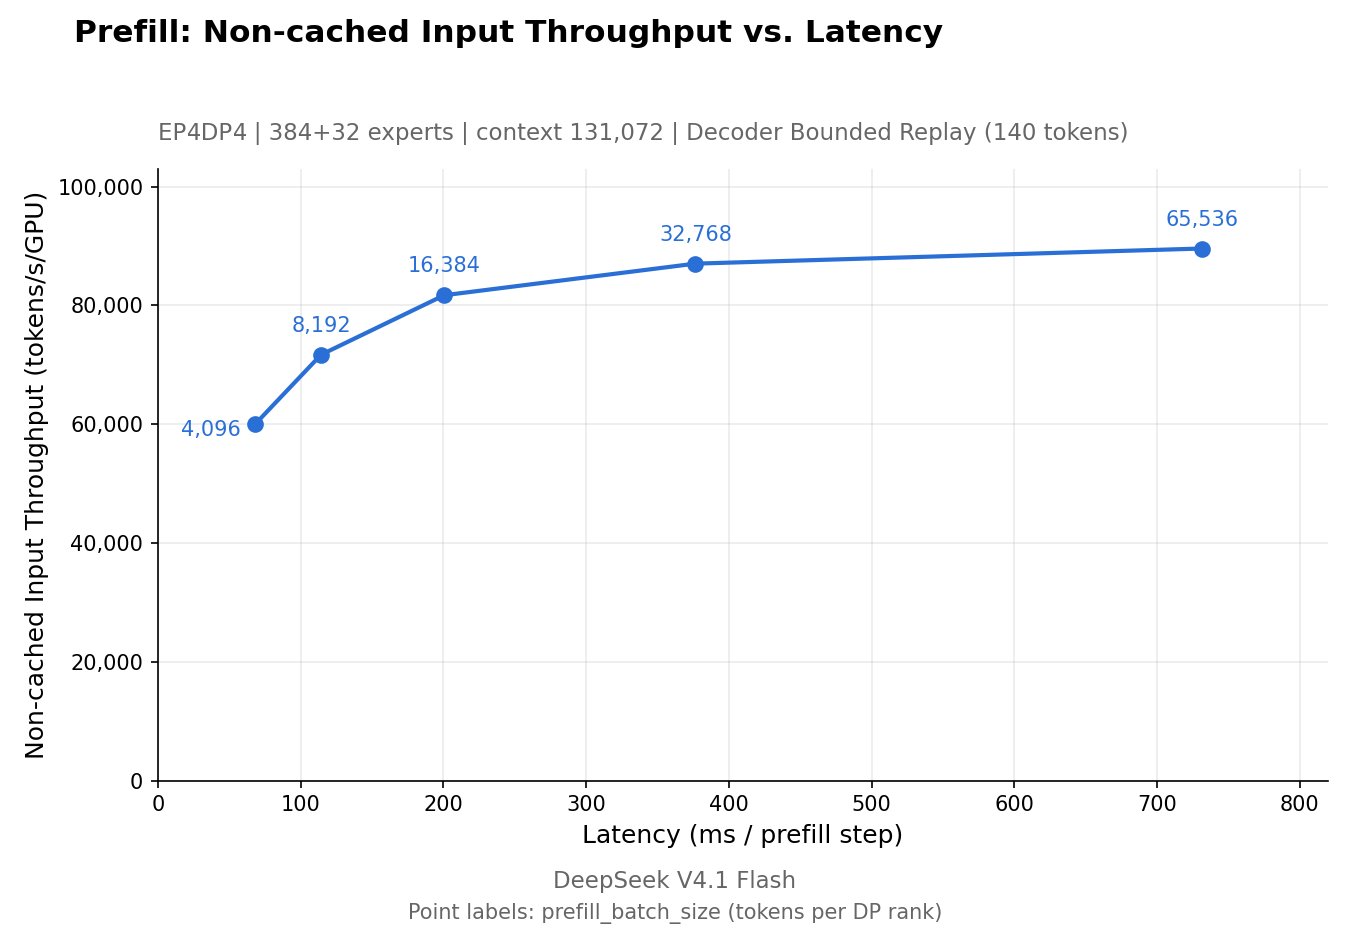
DeepSeek 把自家生产环境用的推理框架 DeepInfer 开源了,仓库 Apache 2.0 协议,同日放出配套的 Token 编解码组件 deepseek-recipe(MIT 协议)和一份 30 页的《DeepSeek V4.1 Flash 推理部署 Q&A》。官方在 Q&A 文档里给出了这套路由和生产集群的运转数据:单一集群服务吞吐 155 万…
750 tokens per second. Cerebras 和 OpenAI 在 8 月 13 日联合发布的 GPT-5.6 Sol Ultrafast 模式达到了这个数字,比 GPT-5.6 Sol 的标准推理速度快 14 倍。更关键的是,这个速度没有牺牲任何智能水平:运行在 Ultrafast 模式下的 GPT-5.6 Sol 与标准模式输出完全相同…
一台 16GB 内存的 Mac mini 跑 80B 参数的大模型,一台 iPhone 17 跑 35B 参数的模型——而且不是靠云端中转,全部在本地完成。开源项目 Swiftlet 用一种叫做「专家流式推理」(Expert Streaming)的技术做到了这一点,峰值内存占用分别只有 4.3GB 和 2.5GB。 Swiftlet 项目主页 Swiftle…