一片 Cerebras WSE-3T 晶圆只有 44 GB 片上内存,而万亿参数模型光权重就要占掉 TB 级空间。这个数量级差距怎么解决?Cerebras 工程团队在官方博客发了一篇完整的部署推演,以开源模型 Kimi K3(约 3 万亿参数)为例,把「3T 参数放进多少片晶圆、每片放什么、怎么连起来、能同时服务多少请求」四个问题全部算了一遍。这篇文章把整条计算链展开,并补上每一步背后的架构含义。
先看被部署的模型:Kimi K3
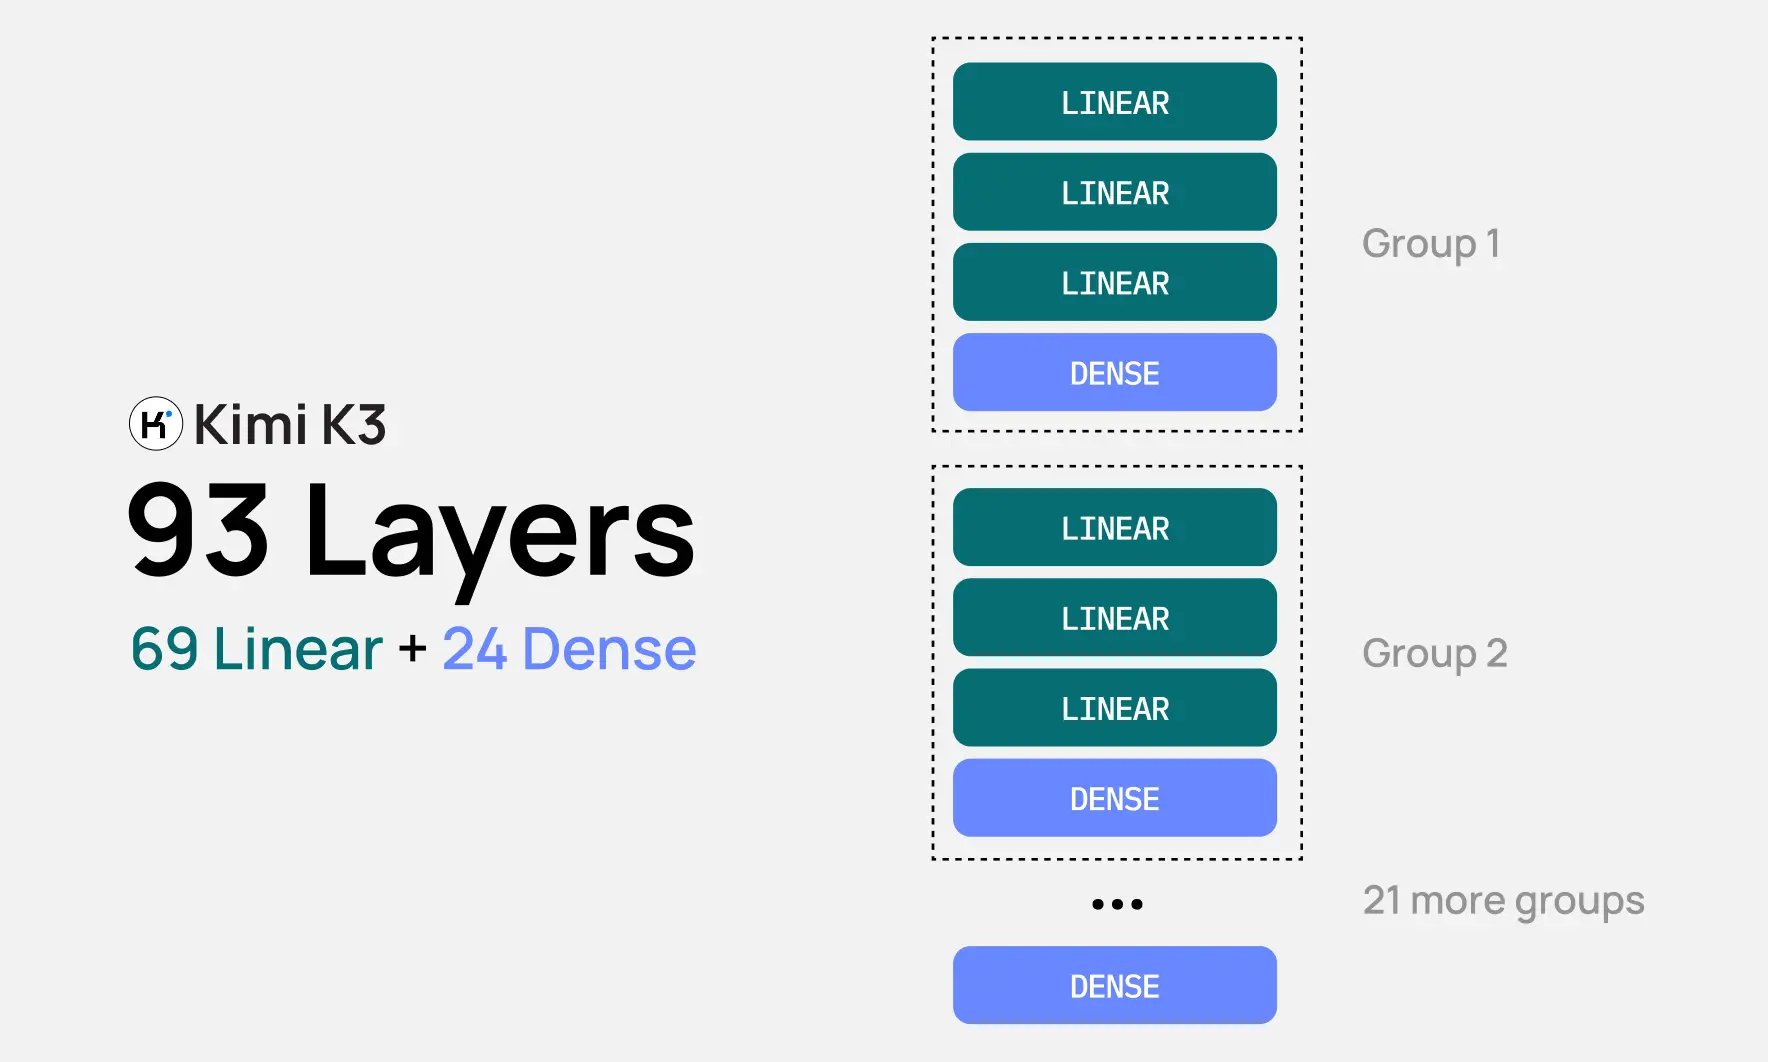
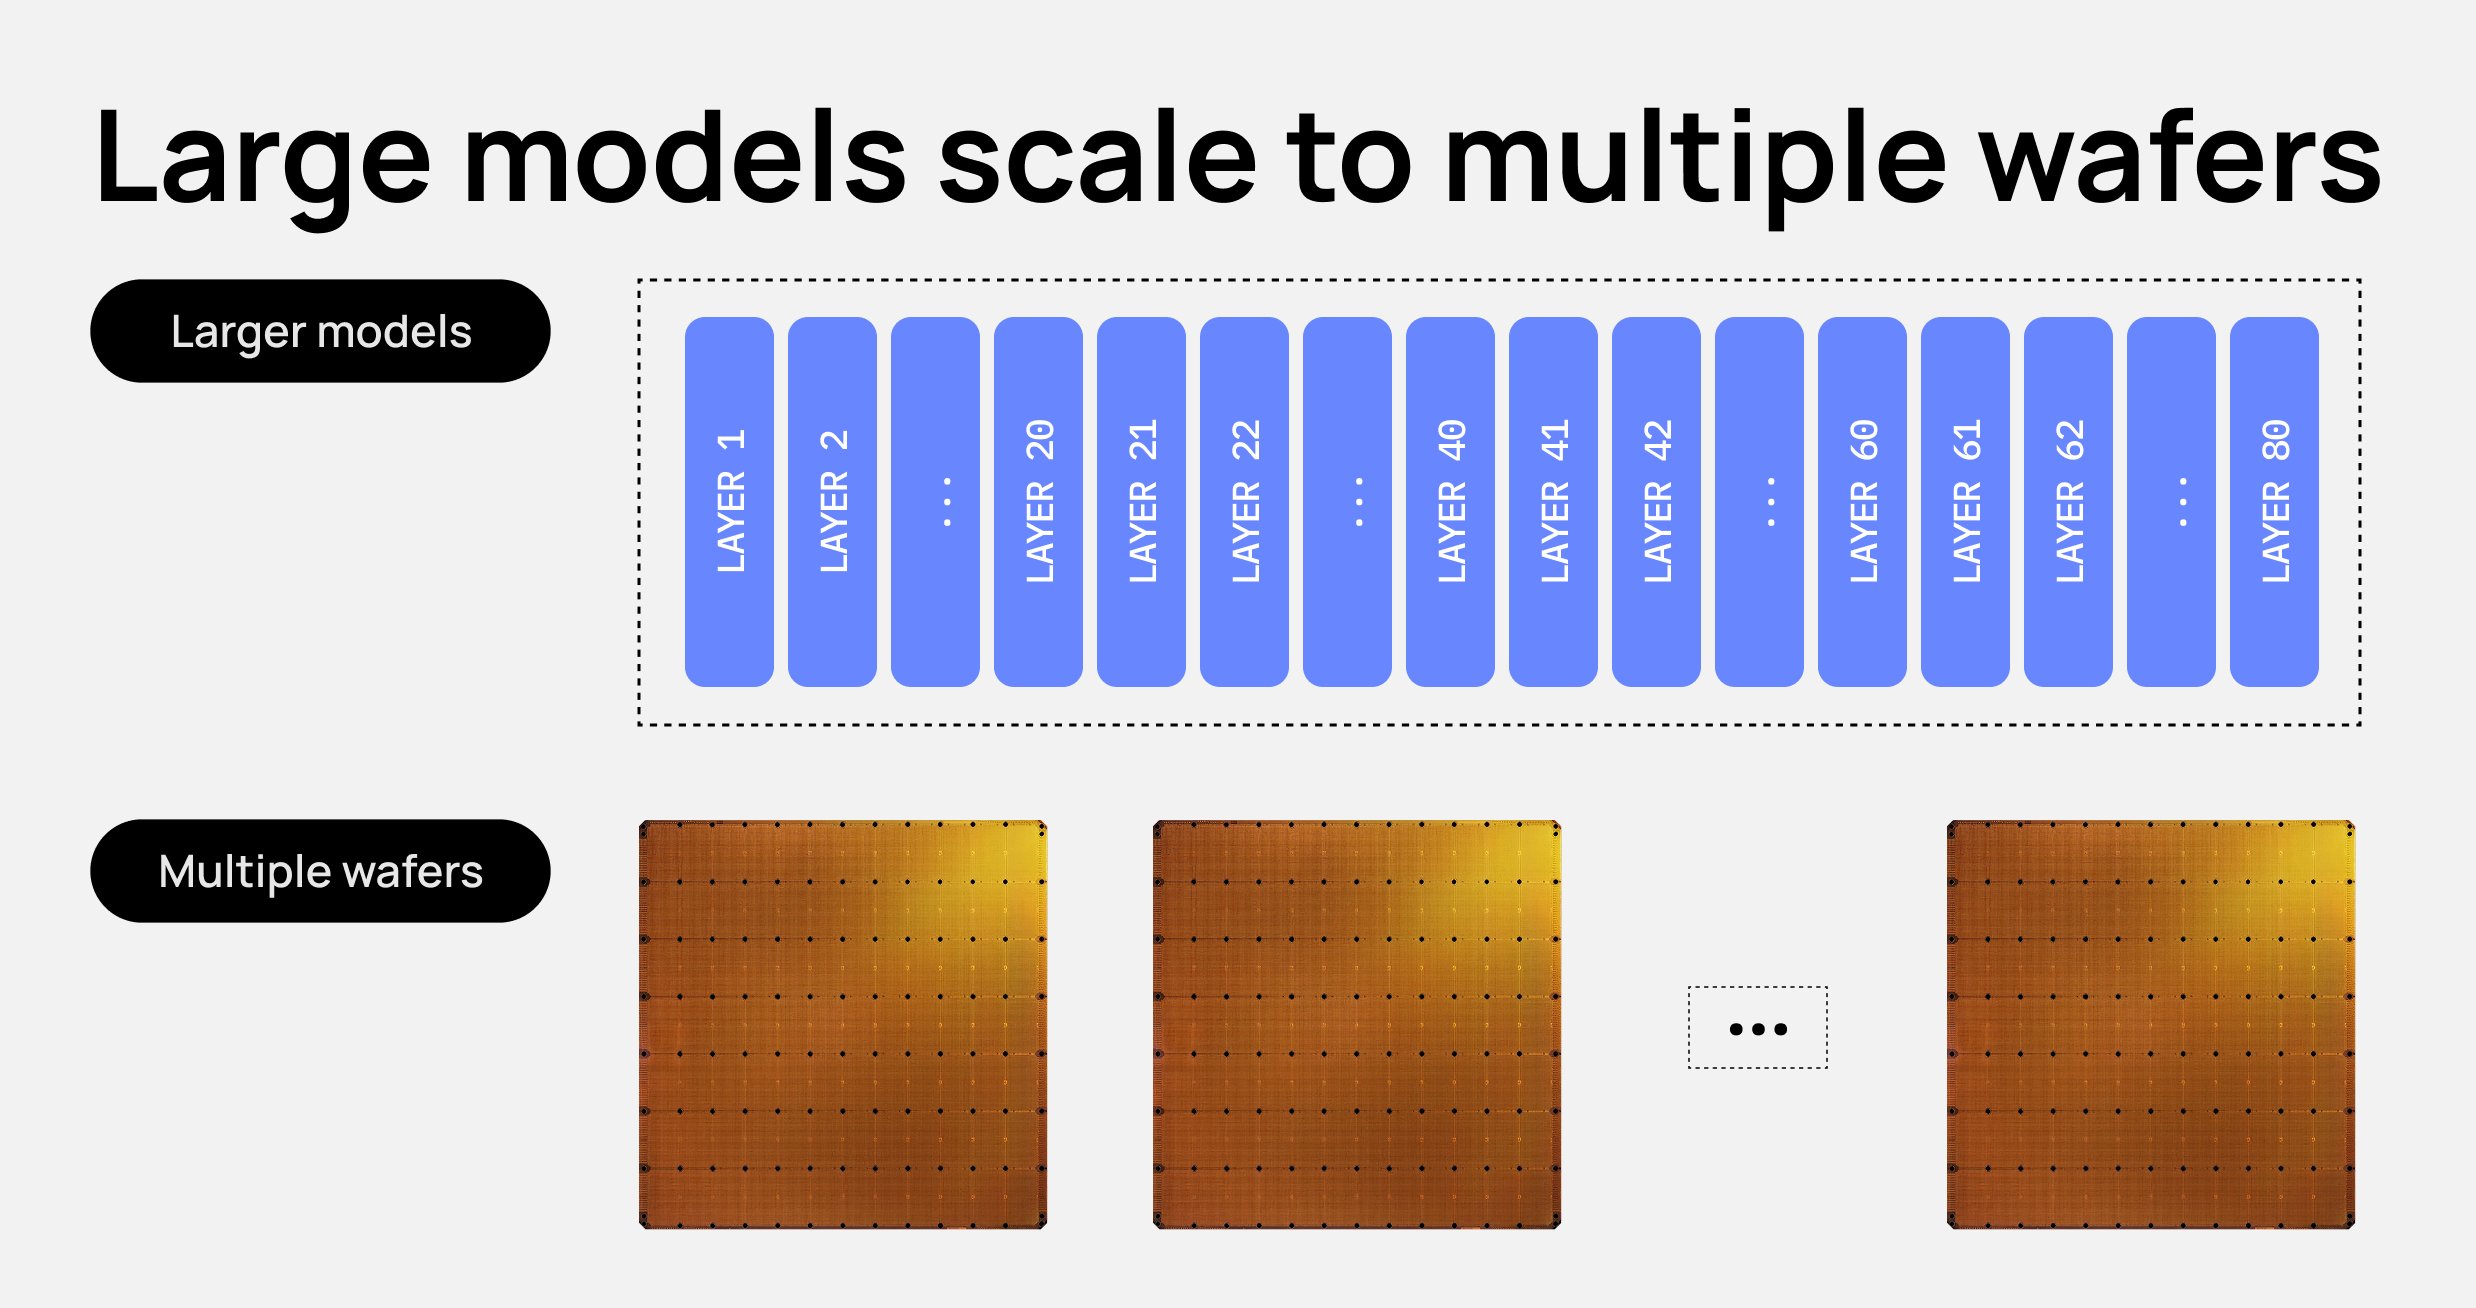
Kimi K3 是月之暗面开源的 3 万亿参数模型,结构上有两个数字决定了后面所有部署决策:69 层线性注意力(linear attention)加 24 层稠密注意力(dense/full attention),共 93 层。
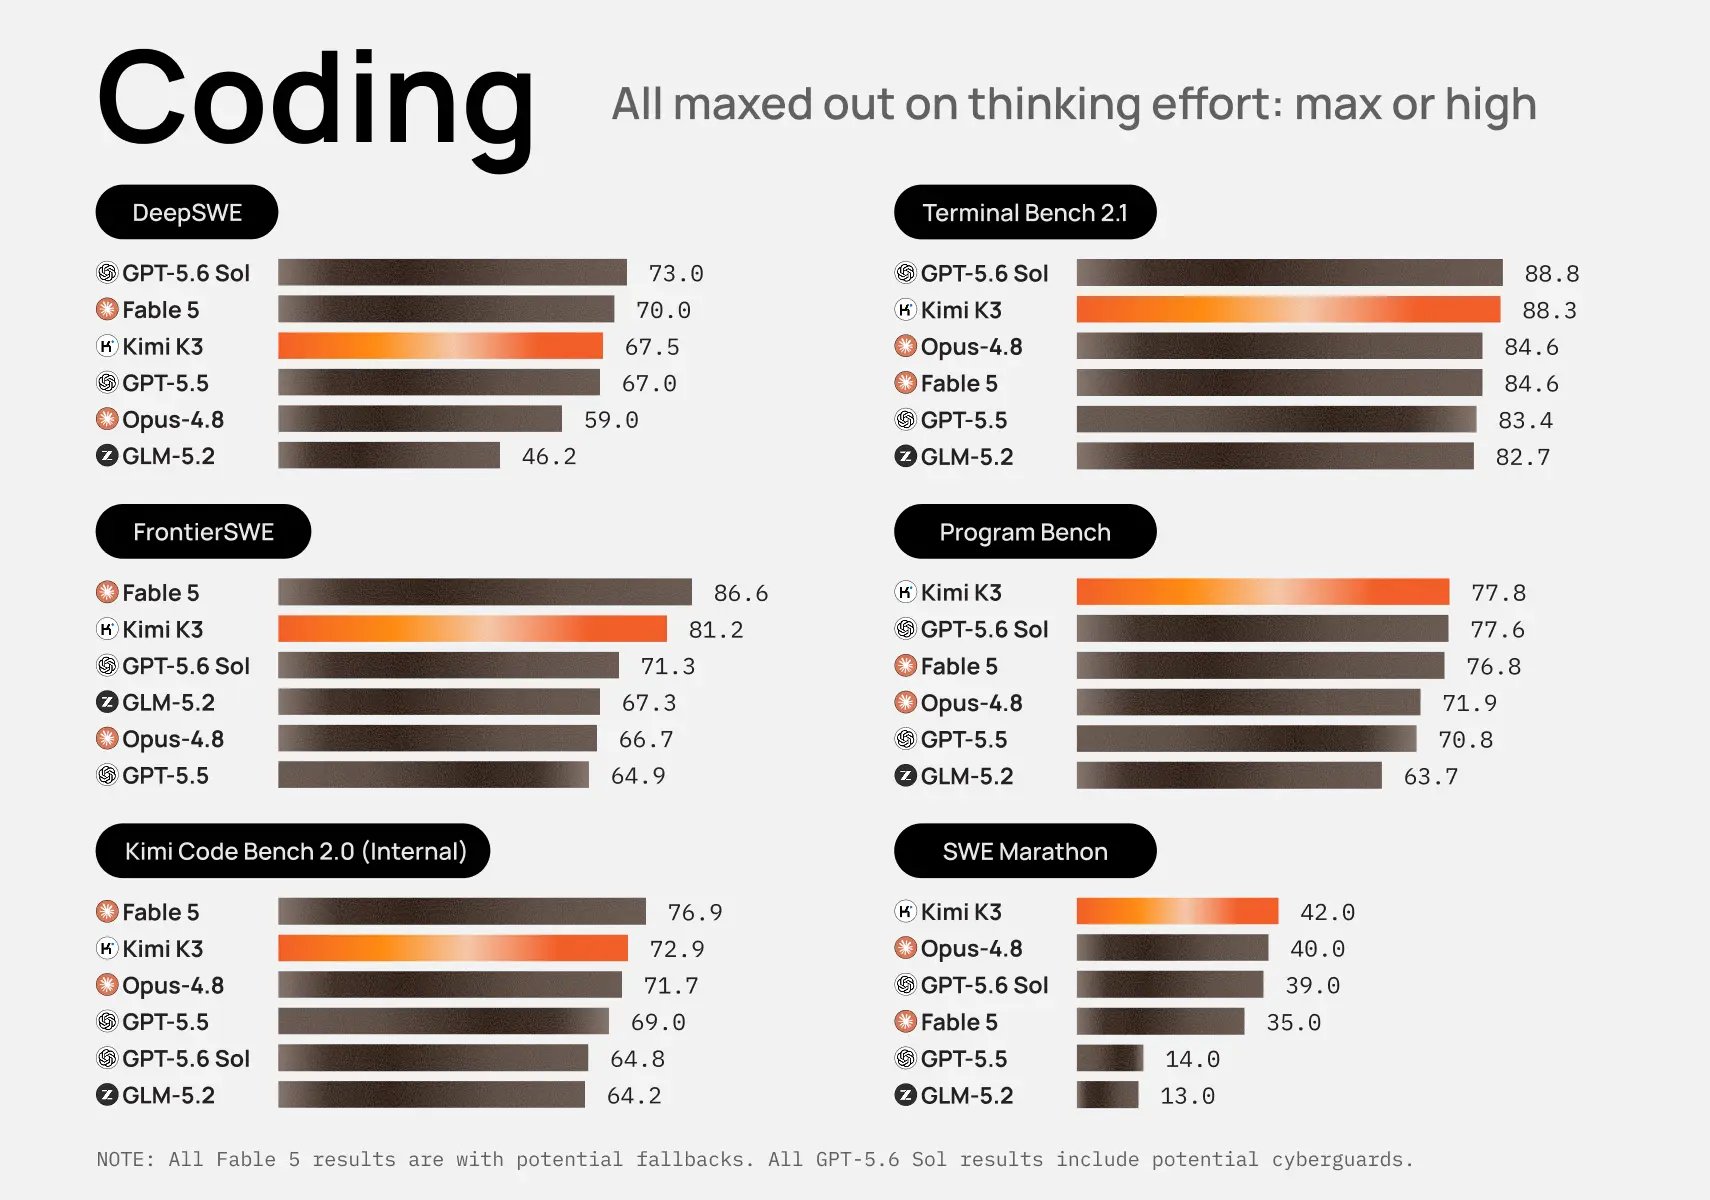
能力上,Cerebras 引用了两项基准:Terminal-Bench 2.1 得分 88.3%(GPT-5.6 Sol 为 88.8%),BrowseComp 得分 91.2%(GPT-5.6 Sol 为 90.4%)。在代码与智能体任务上,这个开源模型已经处在第一梯队。附带的六项代码基准里,Kimi K3 在 Program Bench(77.8)和 SWE Marathon(42.0)两项排第一,DeepSWE 和 FrontierSWE 落后于 GPT-5.6 Sol 与 Fable 5。
Kimi K3 之外,Cerebras 推理云上已经跑着 Llama、Qwen、GPT-OSS 等开源系列,按 token 计费,免费档每月有少量额度。这次把 K3 的完整部署算式公开,等于把「晶圆级推理」从宣传语落到了可复算的工程数字上。
部署推演基于三个假设:请求平均长度按 256k token 计,权重按 4-bit 量化(与 Hugging Face 实现一致),KV cache 按 8-bit 存储。这三个假设直接进入后面的算式。
第一步:每层多大
3 万亿参数,每个参数 4 bit,换算成字节:
3 trillion × 4 bits ÷ 8 bits/byte = 1.5 terabytes权重总量 1.5 TB,平摊到 93 层:
1500 GB ÷ 93 ≈ 16 GB / 层每层约 16 GB。对照 44 GB 的片上 SRAM,一层权重放得下,甚至能放两层。真正的约束出现在下一步。
第二步:稠密层与线性层,一片晶圆放几层
KV cache 的行为把 93 层分成了两类。
稠密注意力层要为每个在途请求的每个 token 保存 key 和 value,缓存随上下文长度线性增长。所以部署时每片晶圆只放一个稠密层,剩余 SRAM 留给它的 KV cache。
线性注意力层不保存逐 token 的 key/value,而是为每个请求维护一个固定大小的状态,与上下文长度无关。一片晶圆放两层线性层(2 × 16 GB = 32 GB)还有富余。
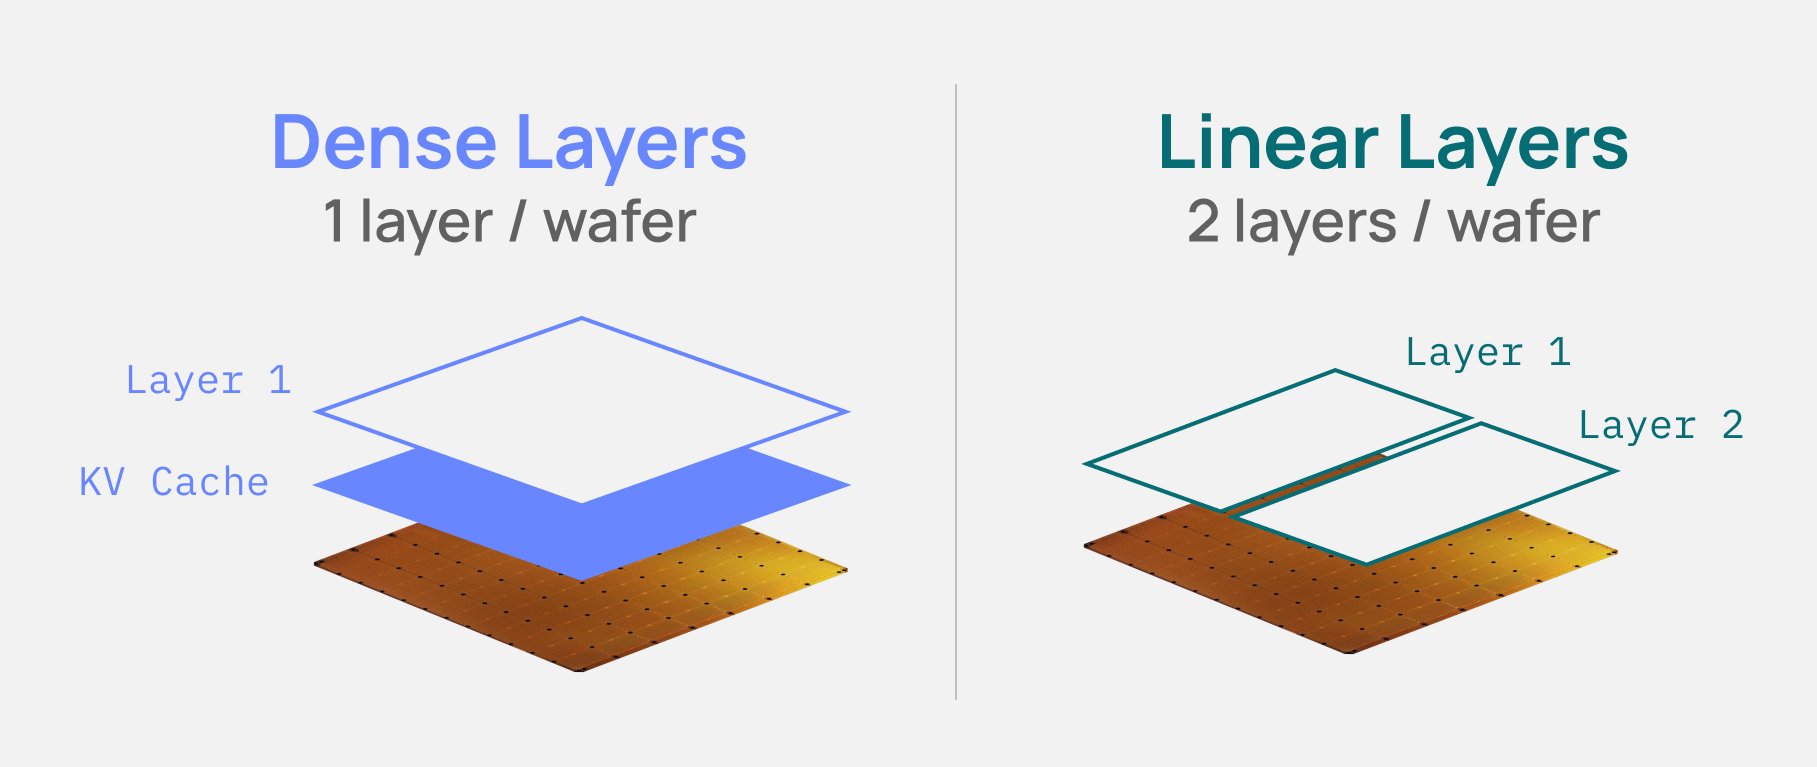
于是晶圆数量就是一个两行算式:
69 linear ÷ 2/wafer(向上取整)= 35 wafers
24 dense  ÷ 1/wafer           = 24 wafers
合计 59 片。3 万亿参数的模型,整体装进 59 片 WSE-3T 的片上 SRAM。
这里有一个容易被忽略的架构事实:Kimi K3 的层构成(69 线性 : 24 稠密)直接决定了晶圆用量。如果 93 层全是稠密层,需要 93 片;线性注意力占多数,把部署成本压掉了三分之一以上。混合架构的优势在推理侧以硬件数量为单位兑现。
第三步:59 片晶圆怎么连成一台推理机
Cerebras 的执行模型是流水线。编译器把模型层映射到各晶圆区域,运行时再规划 token 在晶圆之间的流动路径。
关键设计:权重不动,只有激活值(activation)跨晶圆传输,走以太网上的 RDMA,每一跳约 2 微秒。因为每片晶圆 44 GB、每层只有 16 GB,绝大多数情况下整层权重可以直接驻留在一片晶圆内部,层不需要切开分到多片。
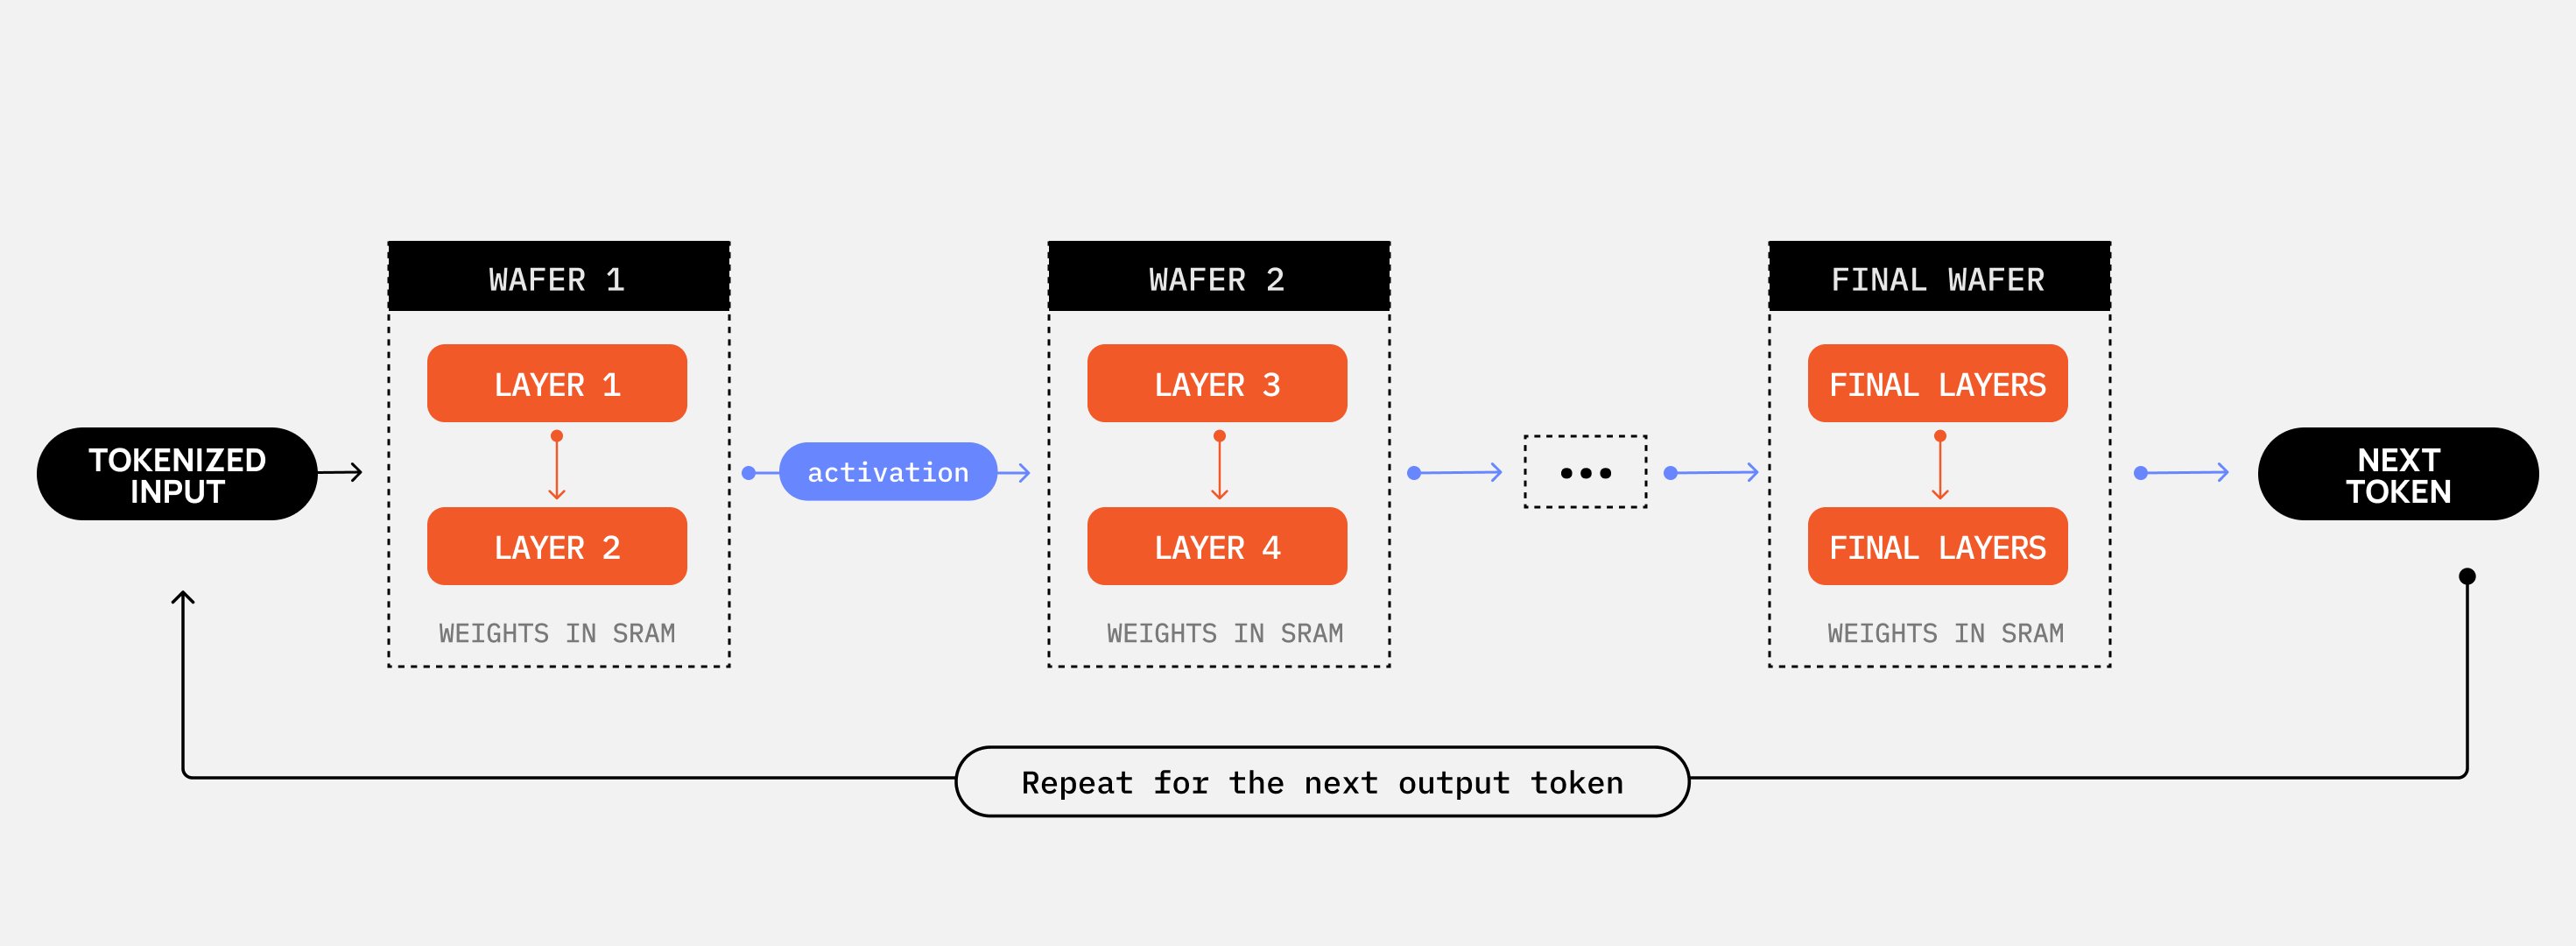
从 token 视角看,这就是一条装配线:tokenized input 进入晶圆 1 跑第 1-2 层,激活值传给晶圆 2 跑第 3-4 层,直到最后一片晶圆吐出 next token;然后整个请求循环往复,生成下一个 token。Cerebras 用这套结构把多万亿参数模型的输出速度做到每秒 1000-2000+ token。Cerebras 自己的历史数据可作参照:Llama 3.1-70B 在其平台上跑到过每秒约 2100 token,官方当时标注比最快的 GPU 方案快 16 倍。万亿参数模型的输出速度通常随参数量上升而下降,1000-2000+ 这个区间对应的正是 Kimi K3 这个量级。
第四步:流水线怎么不空转
流水线有一个天然质疑:token 要按顺序流过每片晶圆,后面的晶圆是否在等前面?系统是否等效于 batch size = 1?
Cerebras 的回答是让整条流水线同时装着不同请求。第 3 级在处理请求 A 的 token 时,第 2 级处理请求 B,第 1 级处理请求 C。每一级处理的还是一个 micro-batch(一小组请求),所以在途请求数约等于级数乘以 micro-batch 大小。micro-batch 调小,单请求延迟更低;调大,总吞吐更高。Cerebras 在生产中用的分级比文中的「每级一层」细得多,级数也多得多。
第五步:并发上限由什么决定
片上内存分给 KV cache 的部分,决定了并发请求的天花板。KV cache 只存在于稠密层晶圆上,所以只需要对 24 片稠密层晶圆算这笔账。
每片稠密层晶圆的可用缓存:
44 GB − 16 GB = 28 GB单个 256k 请求占用的缓存(按 8-bit KV cache):每 token 每层 576 字节,乘以 256,000 token:
576 bytes × 256,000 ≈ 147 MB / sequence并发数:
28 GB ÷ 147 MB ≈ 190 concurrent requests约 190 个请求同时在流水线中流动。Cerebras 特别强调,这个数字与 GPU 的 batch 语义不同:流水线里的请求互相不等待谁完成,各自连续流过整条线。
评估推理系统时更有意义的指标,Cerebras 给出的是「相同输出生成速度下,每兆瓦的总 token 吞吐」(tokens per second per megawatt)。并发数和 batch size 都无法单独说明效率。
这套方法的扩展边界
同样的流程可以套到更大的模型:算出权重和请求状态的内存需求,把模型分布到若干晶圆上,连成流水线。每加一片晶圆,同时增加算力和片上内存,模型容量上限随晶圆数量线性外推,不受单芯片容量约束。
对开发者的实际入口是 Cerebras 的推理云:cloud.cerebras.ai 提供免费 API,Kimi K3 的 4-bit 量化版本可以直接调用。想在自己集群上复现这条部署路径,则受限于 WSE-3T 的硬件可得性,但推演本身(每层 16 GB、线性层双装、稠密层单装留缓存、激活值跨片流动)对任何多芯片流水线推理的设计都有参考价值:先把「哪类层占多少内存、谁需要随长度增长的缓存」算清楚,硬件数量就是一道四则运算。GPU 集群上跑超大模型的常见做法是张量并行(把单层切到多卡)加流水线并行(把层组分到不同卡组)组合,权重在 HBM 和 NVLink 之间流动;Cerebras 的方案把权重全部钉进片上 SRAM,跨片只传激活值,避开了内存墙问题,代价是硬件形态完全绑定自家晶圆。
来源
- How we deploy Trillion-parameter frontier models on Cerebras(Cerebras 官方博客,Sarah Chieng,2026-10-22)
- Kimi K3 六项代码基准图与层结构图引自上述官方博文