一个 2026 年 4 月才创建的 GitHub 仓库,现在每天还在以两千多 star 的速度增长。VoiceStudio 是一个完全本地运行的语音工作台:克隆声音、按文字描述设计声音、给视频配音、录音转文字、批量产出有声书,全部在自己机器上完成,不依赖任何云端 API。它 73,225 个 star 的背后,有一个常被忽略的技术事实:真正干活的引擎是 k2-fsa 团队的 OmniVoice 模型,一个支持 600 多种语言、推理速度最高达到实时 40 倍的开源 TTS 模型。这篇拆开看三层:桌面应用做了什么、底层模型凭什么快、以及它给编码 Agent 留的那个接口意味着什么。
项目基本盘
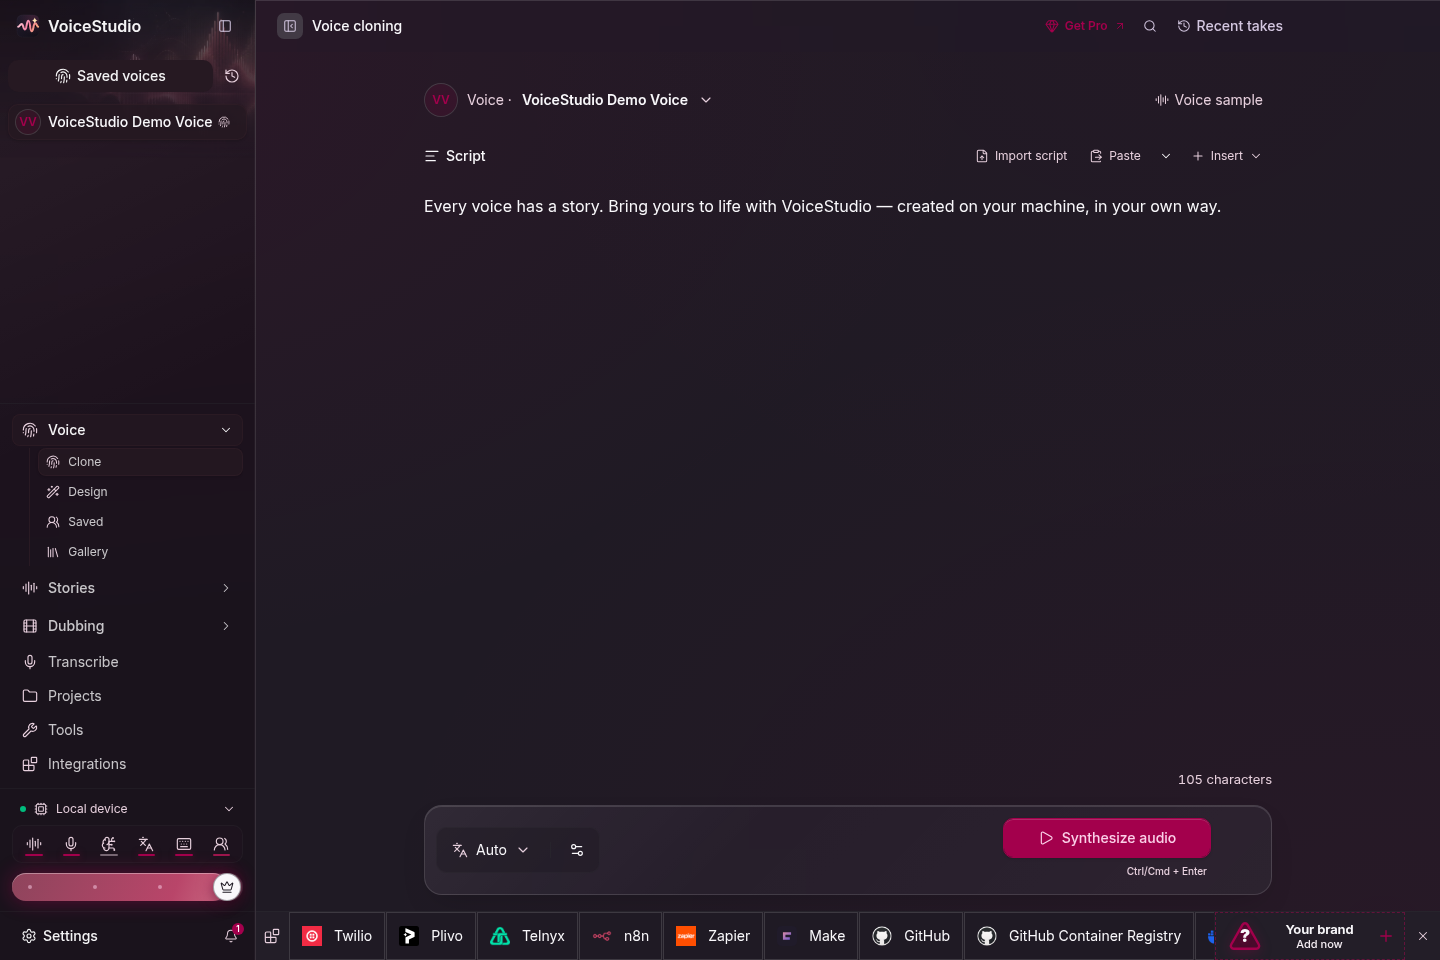
先把仓库的真实数据摆出来。VoiceStudio 由 debpalash 开发,采用 AGPL-3.0 许可证(商业使用需遵守其开源条件),GitHub 上 73,225 star、8,012 fork,创建于 2026 年 4 月 9 日,最近一次代码提交就在本文写作前一天。最新版本 v0.5.6 于 9 月 23 日发布,此前 0.5.3 版本完成了一次大迁移:桌面壳从 Tauri 换成了 Electron,旧 Tauri 入口已删除。安装方式覆盖 macOS(.dmg)、Windows(.exe)、Linux(.AppImage/.deb)和 Docker,也提供一条 curl | sh 命令行安装。
硬件要求分三档。NVIDIA GPU 走 CUDA 加速,Apple Silicon 走 Metal(MPS),没有独立显卡的机器纯 CPU 也能跑,只是慢(CPU 版 PyTorch 约占 5 GB 磁盘)。默认引擎对显存的要求是 6 GB 起步:4 GB 显存的显卡(如 GTX 1650 Ti)会把数据页出到系统内存,一段本该几秒的合成会拖到几分钟然后超时。显存不够或纯 CPU 的机器可以换 OmniVoice GGUF 变体,同一个模型跑在量化后的原生二进制上,内存占用小得多。
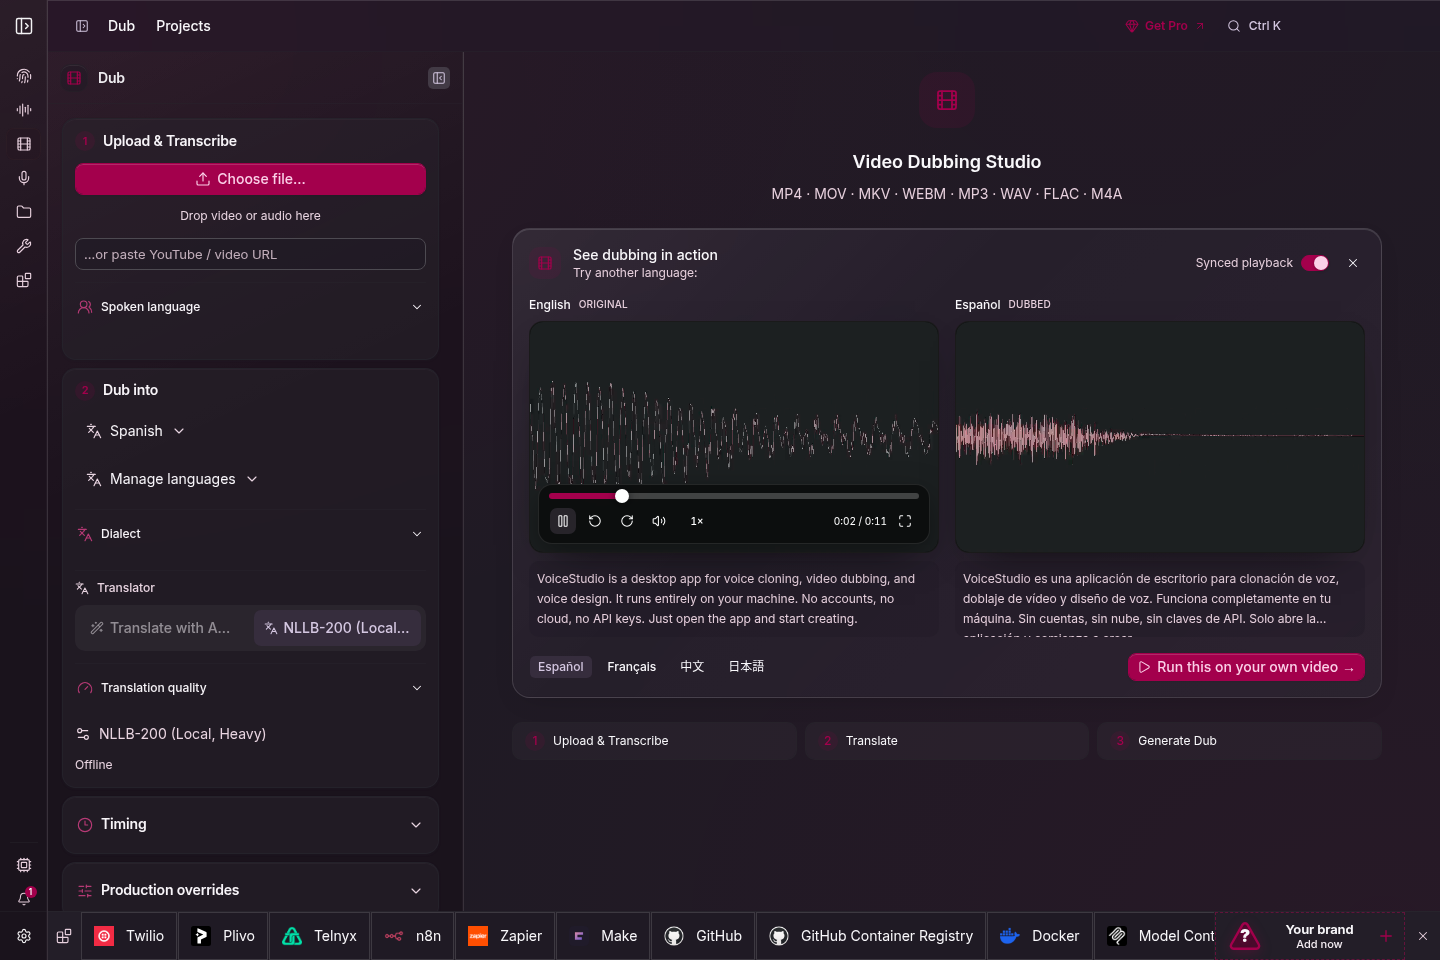
功能面上,克隆只需要 3 到 10 秒的参考录音;配音工作区接受 MP4/MOV/MKV 等常见格式,先转写、再翻译(可用本地的 NLLB-200 离线翻译)、再生成目标语言音轨;转写默认用 WhisperX,另有 Faster-Whisper、MLX Whisper、Parakeet 等 9 种可选;听写用悬浮小组件;批量队列处理有声书这类长任务。
底层引擎:OmniVoice
VoiceStudio 的默认引擎是 k2-fsa/OmniVoice,一个零样本(zero-shot,不需要针对每个声音单独训练)多语言 TTS 模型。k2-fsa 是语音识别框架 k2 的开发团队,作者名单里有 Daniel Povey(Kaldi 的原作者),模型论文《OmniVoice: Towards Omnilingual Zero-Shot Text-to-Speech with Diffusion Language Models》已挂在 arXiv(编号 2604.00688)。
架构上,OmniVoice 用的是扩散语言模型(diffusion language model)风格的设计,官方给出的推理速度是 RTF 低至 0.025。RTF(real-time factor,实时率)指生成一秒音频需要的计算秒数,0.025 意味着 40 倍实时速度。NVIDIA H100 上的官方 benchmark 数据:batch=1 时基线 RTF 0.0899,启用 FlashInfer 内核后降到 0.0430(2.1 倍加速),再加 CUDA graph 后到 0.0367(2.4 倍);batch=8 时 RTF 0.0115,加速 2.6 倍。这组测试跑的是 seed-tts 中文测试集(2020 条样本、3.3 小时音频)、fp16 精度、32 步扩散,并且输出经过 ASR 校验确认无损。
语言覆盖是 600 多种,官方称这是零样本 TTS 模型中已知最广的。克隆质量上有一个细节要注意:参考音频和目标文本是同一语言时发音最标准,跨语言克隆(用中文录音克隆、生成英文语音)会带上参考语言口音。声音设计模式(用属性描述生成声音)只用中英文数据训练过,官方明确说明它对低资源语言可能不稳定。这两个边界条件写在官方文档里,比宣传页的"646 种语言"更接近实际使用体验。
细粒度控制是另一个技术亮点。文本里可以内联非语言标记([laughter]、[sigh] 等十余种),中文可以用带声调的拼音逐字纠正发音(比如"打ZHE2出售"强制读二声),英文可以用 CMU 音标覆盖默认读音。数字读法可以通过 normalize_text=True 自动归一化("2345"读成"two thousand three hundred forty-five"而不是逐位读数字),依赖 WeTextProcessing 实现。
十六种引擎的可插拔矩阵
VoiceStudio 不绑定单一模型。TTS 引擎目录里列了 16 个可切换选项,除了默认的 OmniVoice,还有 VoxCPM2、CosyVoice 3、GPT-SoVITS、IndexTTS 2.5、MOSS-TTS、KittenTTS 等国产和社区模型,每个引擎的适用场景、显存需求、克隆能力在文档里逐个列明。切换在 Model Catalogue 界面完成,或者用环境变量 OMNIVOICE_TTS_BACKEND 固定。转写侧同样如此,Whisper 系、Parakeet、Moonshine、FunASR 等引擎可按硬件和语言选型。
这套矩阵解决一个实际问题:没有哪个 TTS 模型在所有语言、所有硬件上都最优。中文用户可能更愿意用 CosyVoice 3 或 GPT-SoVITS,低配机器换 KittenTTS(纯 CPU、8 个预设声音),Apple Silicon 用户有 MLX-Audio 路线。模型热加载时权重在应用内共享,配音和转写不会重复加载同一份模型。
benchmark 方法论也做得克制。仓库的 benchmarks 页面目前没有一条数据,官方解释是每个数字都必须由仓库自带的测试脚本在具名硬件、具名版本上实测后提交 PR 才能录入,不同机器的数字不直接可比,"目的是诚实的预期,不是排行榜"。脚本会逐阶段剖析流水线,内存不够直接拒绝启动,阶段之间卸载模型。在 TTS 工具普遍拿一个实验室数字宣传的背景下,这种把空表格摆出来的做法与行业惯例形成了对照。
MCP 接口:让 Agent 用你的声音说话
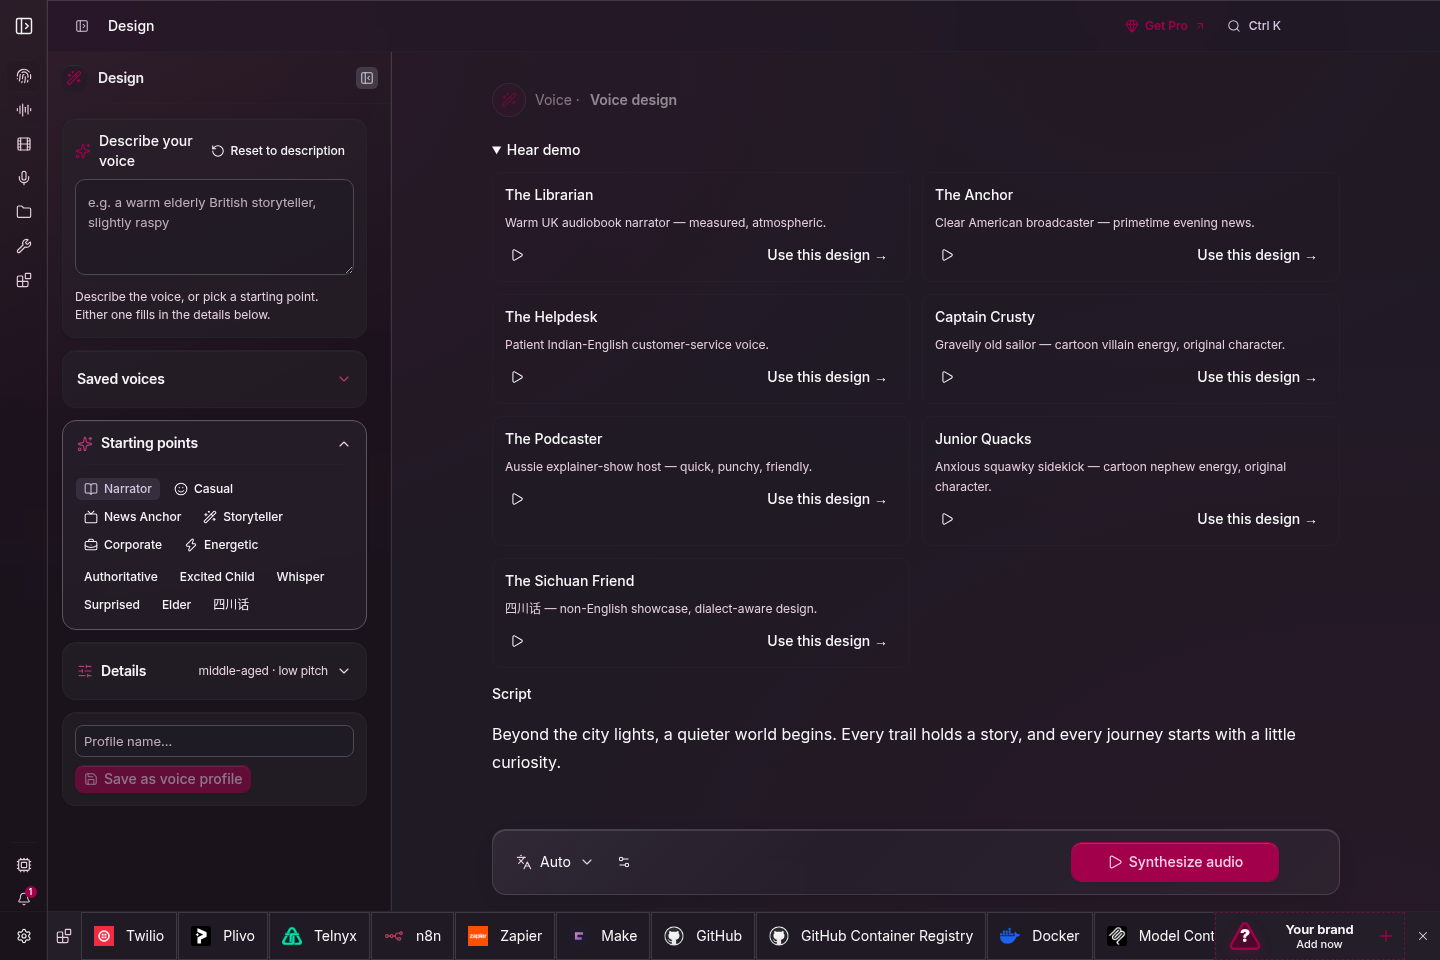
VoiceStudio 内置了一个 MCP(Model Context Protocol)服务器,挂在后端的 /mcp 端点上。Claude Code、Cursor、Codex CLI 这类编码 Agent 连上之后,可以直接调用 generate_speech(文字转语音)、clone_voice(参考音频克隆新声线)、design_voice(属性描述生成声线)、transcribe(音频转文字)等 8 个工具。
工程细节里有两个设计值得展开。第一是输出模式:LLM Agent 的上下文按字节计费,一段 WAV 音频转成 base64 内联返回会吃掉大量 token。VoiceStudio 用环境变量 OMNIVOICE_MCP_OUTPUT_MODE 把音频移出对话:files 模式返回磁盘路径和 HTTP URL,both 模式两者都给。第二是安全边界:OMNIVOICE_MCP_BASE_PATH 指定的目录是所有文件读写的硬边界,路径参数越界直接拒绝(符号链接先解析再校验,防止目录穿越),没配置 base path 时所有路径参数一律拒绝执行。
每个 Agent 可以绑定不同声音:请求头里带 X-OmniVoice-Client-Id 标识客户端,再把这个 client id 绑定到某个声音档案,官方文档举的例子是"Claude Code 用 Morgan 的声音,Cursor 用 Scarlett 的声音"。局域网共享模式有 PIN 码门禁,但文档同时明确警告:反向代理必须自己做认证,因为 loopback 请求会绕过 PIN 校验,MCP 传输层本身没有加密。这些边界条件写进了文档而不是埋在代码里,对部署者是直接可用的信息。
隐私模型与许可
整个语音管线可以完全离线:模型权重本地下载、翻译用本地 NLLB-200、遥测数据需要用户明确同意才收集。应用左侧栏那个 "Local device" 绿点表示的就是当前语音任务跑在本机。
许可分两层,容易踩坑。应用本身是 AGPL-3.0,允许商业使用但有开源义务;模型权重、tokenizer、声音档案和生成内容的权利是单独一层,付费应用许可并不自动授予这些权利。Model Manager 里给每个模型标注了版本化的来源声明、证据链接和未解决的审查缺口。官方态度同样不含糊:仅限获得本人许可的声音才能克隆。
写在最后
VoiceStudio 的增长曲线说明两件事同时发生了:一是"本地优先"在语音生成这个云服务定价最凶的品类里已经有了完整的开源替代,二是底层模型(OmniVoice 的扩散语言模型路线)把多语言克隆的速度推过了实用阈值。对开发者,值得动手的点是把 /mcp 端点接进自己的 Agent 工作流;对普通用户,一条安装命令加 3 秒参考录音就能验证效果。仓库地址 github.com/debpalash/VoiceStudio,模型论文 arXiv:2604.00688。
来源:VoiceStudio GitHub 仓库与官方文档(github.com/debpalash/VoiceStudio)、k2-fsa/OmniVoice 仓库与论文(arXiv:2604.00688)