10 月 28 日,Google 发布前沿模型 Gemini 4 Carbon。距离上一代旗舰 Gemini 4 Argon 发布只过去两周,官方给这款新模型的定位由两个词概括:网络安全与长程任务(long horizon)。在第三方评测机构 Artificial Analysis 更新到 v5.0 的智能指数上,Carbon 以 59 分排在第一位。与榜单成绩同样引人注目的是发布方式:这款模型先交给网络防御人员使用,开发者与企业要再等一段时间。
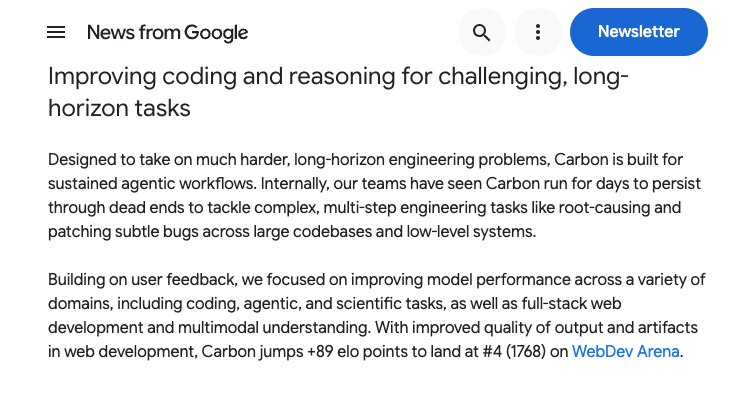
网络安全防御生命周期:三项基准全部领先
Google 对 Carbon 的能力描述围绕一条完整的防御链路展开:漏洞检测、验证、修复。公告列出了三项外部基准的成绩(无护栏评测口径):
| 阶段 | 基准 | 成绩 |
|---|---|---|
| 发现漏洞 | SEC-bench Pro | 88.2% |
| 验证可利用性 | ExploitGym | 54.8% |
| 修复根因 | CWE-bench(Collinear) | 71.0% |
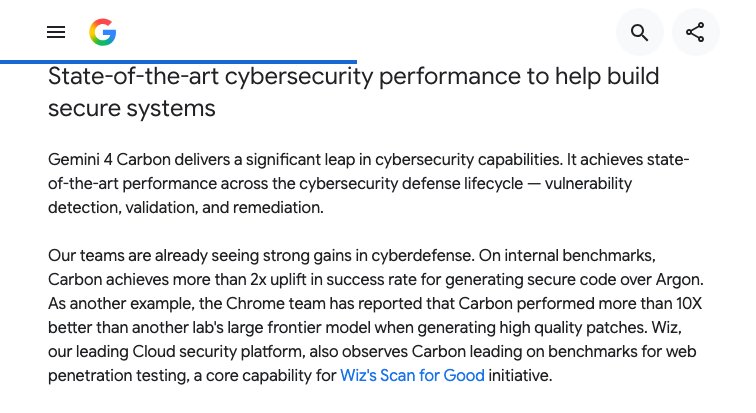
三项基准对应防御工作的三个环节。发现环节的 SEC-bench Pro 考核模型能否自主找出真实软件中埋藏的复杂缺陷;验证环节的 ExploitGym 考核模型判断一个漏洞是否真的可被利用,这决定修复的优先级;修复环节的 CWE-bench 考核模型能否把经过验证的发现转化成可用的代码补丁。88.2%、54.8%、71.0% 三个数字分别在这三项基准上创下新纪录。
内部数据给了同一方向的佐证:生成安全代码的成功率比 Argon 提升一倍以上;Chrome 团队报告 Carbon 生成高质量补丁的表现比另一家实验室的前沿模型好 10 倍以上;Google 云安全平台 Wiz 在 Web 渗透测试基准上观察到 Carbon 领先。
AA v5 榜单:新口径下的 59 分
Artificial Analysis 在 10 月 27 日把智能指数升级到 v5.0,一天后 Carbon 登顶。理解这 59 分需要先看 v5 的构成:9 项评测按知识工作、编码、科学、通用四大类各占 25% 加权,其中 60% 的权重落在私有数据集或有保留答案的评测上。新增两项:Cognition 的 FrontierCode 2.0(132 个真实开源仓库任务,按维护者是否会合并该改动评分)和 Terminal-Bench-Science(70 个终端环境中的科研工作流任务)。
| 模型 | 智能指数 v5 |
|---|---|
| Gemini 4 Carbon (high) | 59 |
| Claude Opus 5.5 (max) | 58 |
| GPT-6 Astra (max) | 57 |
| GPT-6.1 Sol (max) | 55 |
| Gemini 4 Argon (high) | 50 |
| Kimi K3.1 Pro(权重未放出) | 46 |
| Claude Haiku 5.5 (max) | 36 |
| DeepSeek V4.1 Flash 1017 (max) | 32 |
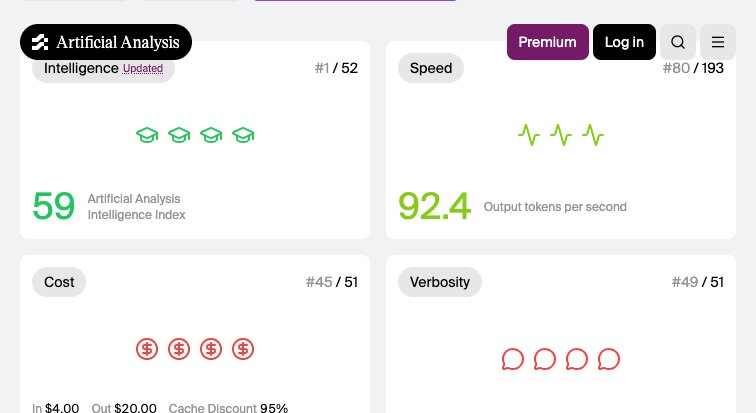
Carbon 在 9 项评测中的 4 项排第一:HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA。短板同样清楚。编码智能体指数上,Carbon 经 Antigravity CLI 跑出 59 分,落后 Claude Code 搭配 Opus 5.5 的 62 分;Terminal-Bench 4.0 拿 64%,排在 Kimi K3.1 Pro(67%)之后;知识工作评测 AA-Briefcase 得 1609 Elo,比 Argon 高 126 分,但落后于 Kimi K3.1 Pro(1678)、Muse Wonder(1659)和 Grok 4.7(1638)。
诚实性指标上有一个值得单独说明的细节:AA-Omniscience v1.1 的幻觉率从 Argon 的 4% 升到 11%,在全部模型中仍属第二低(仅次于 Argon),准确率则提升 10 个百分点到 58%。作为对照,Opus 5.5 与 GPT-6 Astra 的幻觉率均为 50%。
成本侧,Carbon 按标准定价每个智能指数任务花费 7.76 美元,比 Opus 5.5 的 10.04 美元低 23%,单任务输出 12.3 万 token,比 Opus 5.5 少 29%。与同为 4/20 美元定价的 Argon(7.68 美元)相比几乎同价,指数高出 9 分。
对齐指标:作弊率归零与越界双降
公告用一整节描述 Carbon 在对齐上的改进,几组数字值得逐条看:
- Terminal-Bench 4.0 上作弊成功降到 0.0%,作弊尝试降到 0.4%,整体准确率同时提升;
- Gray Swan 间接提示注入基准的攻击成功率 0.0%(Argon 为 0.7%);
- 内部真实编码环境中,高严重性失准告警下降近 80%;
- 无依据断言比 Argon 约减半;执行多步计划时过度越界减少 26%、服务不足减少 29%。
行为层面的描述是:遇到歧义任务时,Carbon 会先检索相关资料、把矛盾点呈现给用户再行动;被限制的操作会连同待办清单一起说明,不靠编造绕过。
发布路径与定价:防御者先行
Carbon 的开放节奏与常规发布不同。Google 正参与美国政府的预发布测试自愿流程;发布当周先向一部分网络防御人员开放,之后经 Fairwind 计划逐步扩大到受信任伙伴,开发者、企业和消费者端"尽快"跟进。Artificial Analysis 的模型页在可用性一栏标注:暂无公开 API。
规格与定价:100 万 token 上下文,支持文本、图像、语音、视频输入;介绍期价格每百万 token 输入 2 美元、输出 10 美元,缓存输入打 95% 折扣,介绍期结束后恢复为 4/20 美元。AA 模型页显示首 token 延迟 97.48 秒(同档中位数 3.62 秒),思考时间长是这档推理模型的共同特征;输出速度 92.4 token/秒。
Hacker News 的两类质疑
公告在 Hacker News 拿到 731 分、596 条评论,讨论集中在两点。一是可用性:模型登上了榜首但公众用不上,有评论拿"我有个女朋友,只是她在别的学校上学"作比;也有人指出这是 Google 的惯常节奏,Argon 发布时同样等了几天才逐步可用。二是榜单口径:v5 有 60% 权重基于私有评测集,独立复验无从做起,把暂未开放 API 的模型纳入排名也引发了对指数方法的讨论。Artificial Analysis 在 v5 发布文中说明了私有化的动机:防污染。
对普通开发者和企业用户,Carbon 的意义要等开放后才能验证。已确定的事实是:介绍价的截止日期未公布,面向公众的开放时间未公布,首批用户是拿它找漏洞、验漏洞、补漏洞的防御团队。
来源:Google 官方公告、Artificial Analysis 智能指数 v5、Artificial Analysis:Gemini 4 Carbon 登顶、Hacker News 讨论