DeepSeek 把自家生产环境用的推理框架 DeepInfer 开源了,仓库 Apache 2.0 协议,同日放出配套的 Token 编解码组件 deepseek-recipe(MIT 协议)和一份 30 页的《DeepSeek V4.1 Flash 推理部署 Q&A》。官方在 Q&A 文档里给出了这套路由和生产集群的运转数据:单一集群服务吞吐 155 万亿 token/天,整体收入每卡每小时 38 美元(按谷时电价口径)。
这不是 DeepSeek 第一次把推理侧的家底往外搬。此前的 TileLang、FlashMLA、DeepGEMM、DeepEP、TileKernels 已经覆盖了算子层,这次开源的是算子之上的调度框架本身,相当于把 V4.1 Flash 线上服务的"骨架"完整放了出来。
DeepInfer 是什么:生产框架的离线部分
按官方 README 的定位,DeepInfer 是"支撑 DeepSeek 大规模生产服务的高性能推理框架",这次开源提供的是离线推理能力和规模化服务的核心特性。目前完整支持的模型只有 DeepSeek-V4.1-Flash(默认下载 deepseek-ai/DeepSeek-V4.1-Flash-1017 权重)。
硬件支持两条线:NVIDIA SM100 GPU 和华为昇腾 950 NPU。前者要求 CUDA 13,后者要求 CANN 9.2,构建时用 DEEPINFER_ACCELERATOR=nvidia 或 ascend 切换。一套框架同时吃下两家芯片,是 DeepSeek 推理系统一贯的双栈路线。
开源出来的核心特性清单:
- 优化的算子栈:集成 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 和自研 TileLang kernel;
- 并行策略:Attention 侧 DP(均衡 CP)、MoE 侧 EP + EPLB 专家负载均衡;
- DSpark 与置信度调度验证(confidence-scheduled verification):投机解码的变长验证;
- SWA Bounded Replay:滑动窗口注意力的有界重算;
- 异步调度器:零开销 batch 调度,CPU 排队与 GPU 前向完全重叠;
- 批量不变推理与确定性采样:不同 batch 组合下输出逐 token 一致(NVIDIA 平台);
- 结构化输出:用 regex、JSON Schema 或 EBNF 文法约束生成。
明确不在这次开源范围内的,是 KVCache 管理与负载均衡组件:官方原话是这部分"与内部基础设施耦合较深,相关代码目前尚未完整开源"。换句话说,开源的是引擎,不是整个车队的调度中心。
部署形态:8 卡 Prefill、64-128 卡 Decode
Q&A 文档把 V4.1 Flash 推理系统的三个设计目标写得非常具体:
- 兼容多种厂商的计算芯片;
- 用常见的 8 卡机器做 Prefill,用 64-128 卡超节点做 Decode;
- KVCache 保留 72 小时以上。
对应到部署参数:Prefill 用 EP2-8/DP2-8,显存够用就取尽量小的并行度;Decode 用 EP64-128/DP64-128 的 Wide-EP,卡有余量就往大了开;Vision Encoder 单卡部署即可,官方建议用便宜的卡。TP 和 CP 暂未使用。
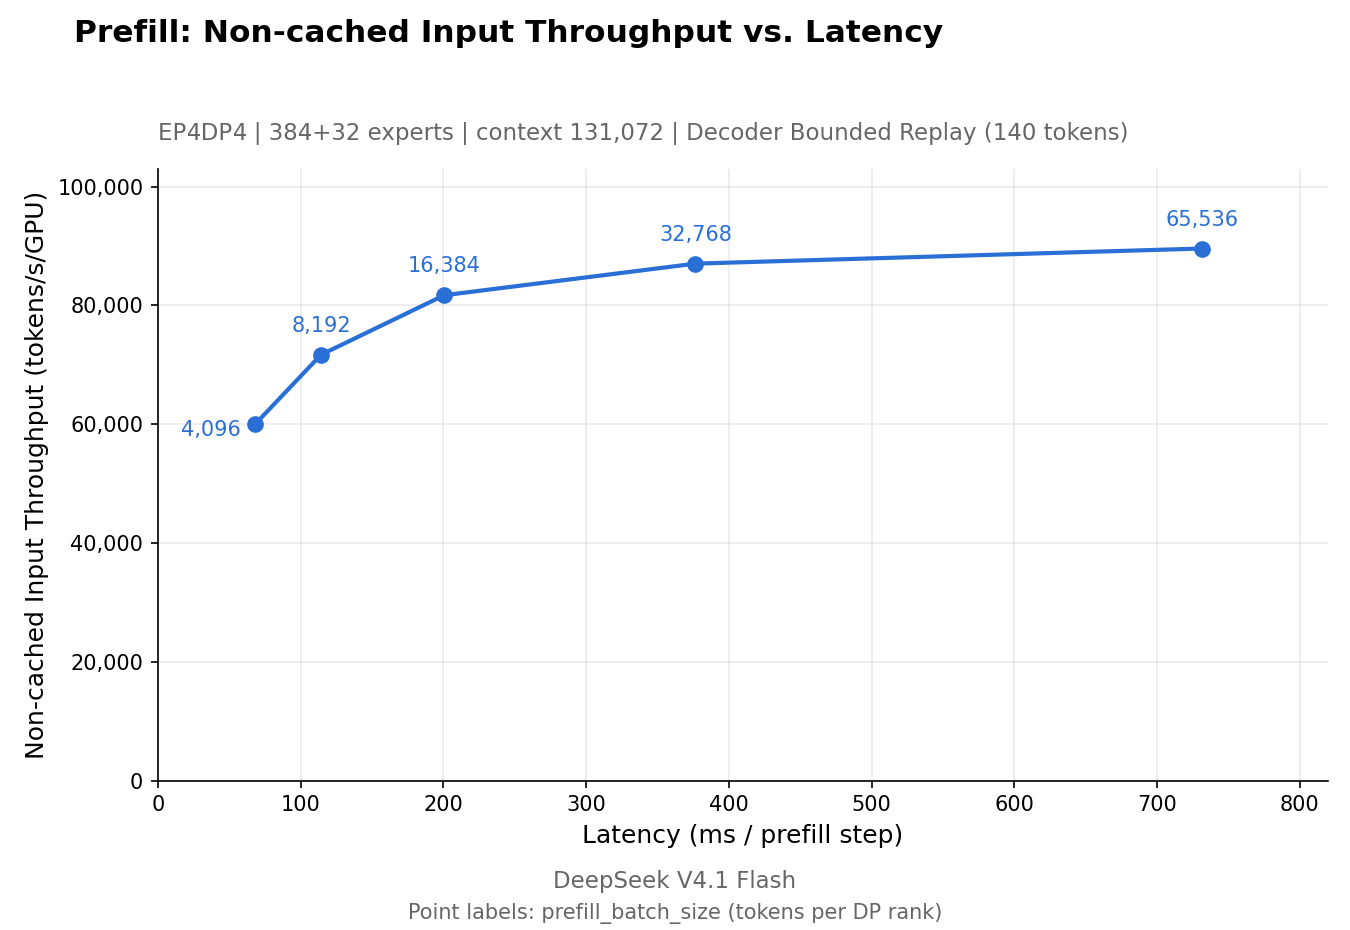
为什么 Decode 要开 Wide-EP?官方给的解释是 Wide-EP 显著减少了每步 MoE 专家部分的访存量,配合 EPLB 能有效提升 TPS。仓库里的基准测试也按这个形态给出:prefill 曲线测在 4 张 SM100 上,decode 曲线测在 64 张上,各自处于一个 scale-up 域内。
最小部署单元的答案写在了 Q&A 里:1P+1D 也能跑,但 P 和 D 的卡数比例实践中基本是 1:1,Decode 推荐 EP64 以上,所以"效率高的最小部署单元"是 64 卡 Prefill + 64 卡 Decode。
155 万亿 token/天背后的账
官方披露的单集群数据如下:服务吞吐 155 万亿 token/天,整体收入每卡每小时 38 美元(按谷价)。
155 万亿 token/天折算约每秒 18 亿 token。按 Q&A 给出的实践配比(约 14.4 TB KVCache 存储配每卡、P:D 卡数 1:1),一个这样的集群是数千卡规模的持续运转。每卡每小时 38 美元的收入数字对应的是 H20/H800 级别的硬件租金加上电力、带宽、运维之后的整体毛利水平——HN 评论区有人拿这个数反推了之前流传的"10 个月回本"说法,结论是对得上的。
收入端的定价背景:DeepSeek V4.1 Flash API 从 9 月 10 日起执行峰谷定价,高峰时段价格为空闲时段的两倍(输入缓存命中 0.04 元/百万 token 对 0.02 元,未命中 0.30 元对 0.15 元,输出同比例)。谷时把闲置算力填满,是这套 72 小时 KVCache 保留策略的直接动机——缓存命中的请求不用重算 Prefill,接得越多,每 token 的实际成本越低。
KVCache:独立存储集群 + 3 天到 7 天 TTL
这次披露里信息密度最高的部分是 KVCache 存储。Block KVCache(Main KV + Indexer K)不放本机内存,而是走独立的 3FS 存储集群:
- 推荐单台存储服务器配置 20 块 30.73 TB SSD,至少 40GB/s 读、5GB/s 写,总空间保留 24 小时数据;
- 实践中按逻辑表大小约 14.4 TB/卡 配存储;
- 数据用 10+2 纠删码,每个 EC 组可容忍 2 节点同时故障;读取时同时向组内 11 台 Storage 节点发请求,任意 10 个响应即可解码;
- 总量约 100 PiB 的 SSD 存储;
- TTL:agent 流量的 KVCache 保留 3 天,chatbot 流量保留 7 天。
独立存储集群的好处官方列得很清楚:所有 Prefill 机器能命中任何前缀,前缀亲和和负载均衡不再互相打架;存储和计算节点可以独立扩缩容;计算节点宕机(故障率比存储高几个数量级)不影响缓存。
V4.1 Flash 大幅压缩后的 KVCache 还让一件以前不现实的事变得可行:跨机房部署。Prefill 和 Decode 可以放在不同但相邻的机房,每 8 张卡配 400Gbps 互联带宽,官方提醒的代价是"跨机房的光纤容易被挖断"。
命中策略分两层:命中长度由 Block KVCache 决定,最后一个 block 是否需要重算由 SWA KVCache 决定。SWA 部分缺失时,用 SWA Bounded Replay 只重算最近 128 个 token,重算代价与上下文长度和层数无关,是常数。Decode 侧的 prefill 计算只在 encoder 层进行,decoder 层只重算 prompt 末尾 128 个 token,总 prefill 计算量近乎减半。
负载均衡:四级 Balancer 与 80% 的离线基准
DeepSeek 给系统配了四个负载均衡器:Prefill、Decode、Vision Encoder、Expert-Parallel。各自的策略:
EPLB(专家并行):每卡在自己该管的专家之外多备冗余专家放热门专家副本,统计最近 N 步负载、每 M 步重排。Prefill 每卡 4 个冗余专家起步,统计窗 100 步、每 1000 步重排,实测最慢 rank 与均值之比 1.074(EP4DP4)/ 1.045(EP2DP2);Decode 每卡 1 个冗余专家,EP64 下每卡 7 个专家,统计窗 1000 步、每 10000 步重排,实测 1.090。
Prefill LB:按 context 总长把请求分进 4 个桶(<16K / 16-64K / 64-256K / ≥256K),每档分到的引擎台数按上一轮 compute-quota 需求占比动态重分;任何引擎都能命中任何前缀,所以不做前缀亲和路由。单卡内的 chunk size 不固定,由时间预算反解:每步定一个纳秒级预算,用拟合的二次代价模型预测耗时,反解出"正好把预算吃满"的最大序列长度。
Decode LB:对所有 decode 实例统一路由,同时均衡请求数和 KVCache 总长度两个维度,短请求发给并发小、缓存长的卡,长请求反过来。
四个均衡器叠起来的整体效果,官方给了一个诚实的数字:达到完全均衡的离线 benchmark 的 80%。
投机解码:按接受率砍掉 30% 的验证算力
DSpark 的变长验证是另一处优化。固定长度验证会对每个位置都验证 5 个 draft token,但不同请求、不同位置的接受概率差异很大,算力经常浪费在低概率 token 上。
DeepInfer 的做法:Confidence Head 预测每个 draft token 的接受率,draft 一次生成 5 个 token,按预期接受率排序,只选有效吞吐最大的前缀子集做验证。线上效果:每步验证的 draft token 数从 5.00 砍到 3.2 到 4.4(约 -30%),平均接受长度基本不变(3.29 对 3.20),在 EP64/DP64 生产运行点(每 rank 约 60 并发)折合 +4% 到 +7% 吞吐。
异步调度器解决的是另一类空转:Decode 第 N 步的流程里,CPU 的 schedule 和 post-process 阶段 GPU 是空闲的。DeepInfer 参考 SGLang 和 NanoFlow 的思路把流水线重叠——GPU 执行 forward 和 sample 时,CPU 同步做下一步的调度和发射,GPU 全程无空闲。
DeepSeek Recipe:把 API 协议层也标准化了
配套开源的 deepseek-recipe 是一组 Rust 库加 Python 绑定,负责 API 请求与模型 token 序列之间的全部转换:Chat Completions、Responses、Messages 三种协议的请求统一转成同一种对话格式,共用模板和编码逻辑;输出侧解析思考内容、工具调用、JSON 输出,再转回流式响应。
两个安全设计与安全直接相关。其一,special token 注入防护:用户输入、工具返回里出现的 <|User|>、<|image|> 等字符串一律编码为普通 token 序列,防止通过文本注入控制 token 影响模型行为。其二,输出侧按 token ID 识别 </think> 和 DSML 标签,模型用普通 token 拼出的相同文本不会被误判为控制标记。
性能侧的优化是分段并行编码:special token 之间的普通文本段可以独立编码,先跳过、再并行、最后按序拼接,降低超长上下文请求的分词耗时。流式解析用状态机处理跨 chunk 的 UTF-8 字符和 DSML 标签,KMP 增量匹配分隔标记。
生成设置的默认值也随库公开:非思考模式 max_tokens 默认 8192,思考模式 65536,思考模式 max 档 131072。
开源边界与对部署方的实际意义
把这次开源的完整拼图摆出来:算子层(TileLang、FlashMLA、DeepGEMM、DeepEP、TileKernels,此前已开源)、调度引擎(DeepInfer,本次)、协议与编解码(deepseek-recipe,本次)、设计文档与 Q&A(本次)。官方同时承诺新模型的推理代码和后续性能优化会在 DeepInfer 持续开源。
没开源的部分同样明确:KVCache 管理与负载均衡组件(与内部集群管理工具耦合)、KVCache Storage 本身、VE/P/D 分离部署的完整服务层、跨副本负载均衡。README 原话是这些是"a complete inference service"的必要件,"most required engine functionality is already implemented"——引擎功能基本齐了, 组一个完整的在线服务还要自己补周边。
对要自部署 V4.1 Flash 的团队,这份开源的直接价值是三个数字可以先算清楚:效率最高的最小部署单元是 64 卡 P + 64 卡 D;KVCache 存储按 14.4 TB/卡规划、TTL 拉到 3 天以上才吃满缓存收益;吞吐预期可以按官方离线基准的 80% 折算。至于 155 万亿 token/天和每卡每小时 38 美元的线上数据,则是这套架构在超大尺度上跑通的实证。
参考来源: