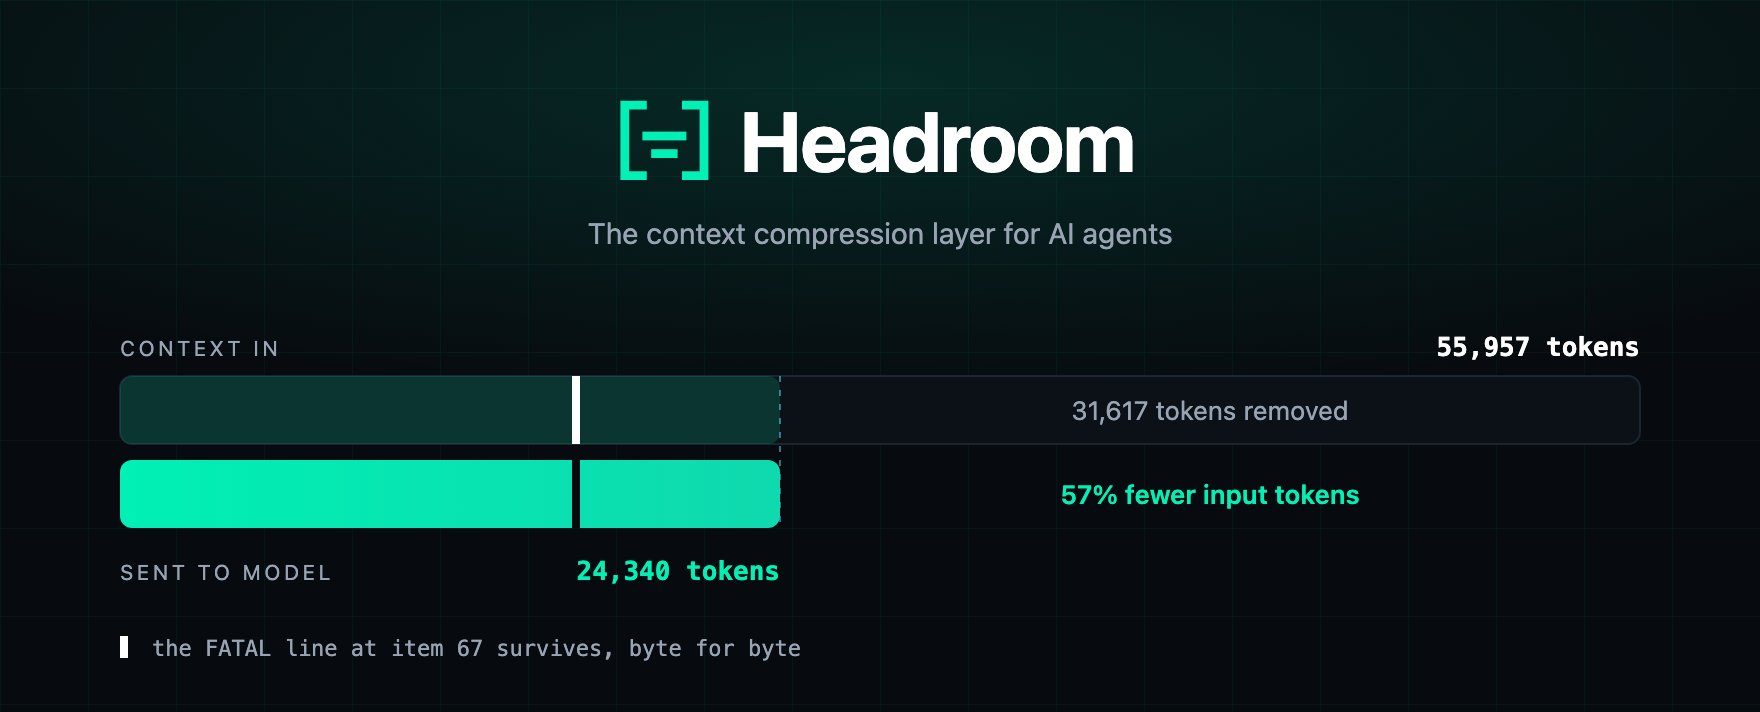
AI 编码代理的 token 消耗大头通常在输入侧:工具返回的搜索结果、日志转储、RAG 检索块、读进上下文的文件,加上越滚越长的会话历史,每一轮都在向模型重复发送数万 token。开源项目 Headroom(GitHub:headroomlabs-ai/headroom,Apache 2.0 协议)在 agent 与 LLM 之间加了一层本地压缩,官方给的旗舰数字是:55,957 token 的 agent 提示词压缩到 24,340 再发给模型,输入削减 57%,日志中第 67 条的 FATAL 错误行逐字节保留。项目当前约 7.7 万 star,GitHub Trending 日增 555 star,Trendshift 当日仓库第一。
压缩层放在哪
Headroom 提供四种接入形态,覆盖从零改造到深度定制的梯度:
- 库调用:Python 里
compress(messages)、TypeScript 里await compress(messages, { model }),直接嵌进应用代码; - 本地代理:
headroom proxy --port 8787起一个本地代理,任何语言的应用把 base URL 指过来即可,代码零改动; - agent 包装:
headroom wrap claude|codex|grok|copilot|cursor|aider|opencode|cline|continue|goose|openhands等一条命令完成配置,headroom unwrap可回滚; - MCP server:暴露
headroom_compress、headroom_retrieve、headroom_stats三个工具,供任意 MCP 客户端调用。
压缩全部在本机完成,提示词和文件内容不会发往外部服务。这个设计决策对处理代码和日志的场景有实际意义:工具输出里常有密钥、内部路径和未公开的业务逻辑。
实测压缩率:四场景数据
官方用真实 MCP server 输出格式构造了四个场景,用 provider 的 tokenizer 和随产品发布的 compress() 测量,种子固定、离线运行,任何人可以用同一条命令复现:
uv run python benchmarks/index_proof_table.py --seed 20260902| 场景 | 压缩前 | 压缩后 | 节省 |
|---|---|---|---|
| 代码搜索(100 条结果) | 17,199 | 13,597 | 21% |
| SRE 事故调试 | 55,957 | 24,340 | 57% |
| 代码库探索 | 58,801 | 33,895 | 42% |
| GitHub issue 分诊 | 46,067 | 32,429 | 30% |
压缩率与负载的重复度强相关。重复出现的 JSON 数组和日志行在 benchmarks/bench_latency.py 里能压掉 90% 以上;散文和本已致密的输出几乎压不动。官方也直接说明:短对话、纯文本交流、低于 min_input_words 阈值的块原样返回。想拿自己流量的真实数字,跑 headroom savings。
压缩自身的延迟开销:10K token 的 JSON 搜索结果上 p50 为 0.21 毫秒,100K token 时 1.4 毫秒,对 agent 的整体延迟没有可感知影响。
机制:内容路由 + 三个专用压缩器
Headroom 的核心管线是 CacheAligner → ContentRouter → CCR 三段:
ContentRouter 先判断内容类型,再把负载分给对应的压缩器:
- SmartCrusher 处理 JSON:字典数组、嵌套对象、混合类型。它的保留策略基于字段方差统计挑选,保住错误条目、统计范围外的异常值、首尾边界,而非依赖关键词清单。日志里真正有价值的就是报错行和离群点,这个选择与调试场景的需求对得上。
- CodeCompressor 处理源码:基于 AST 的感知压缩,支持 Python、JS/TS、Go、Rust、Java、C/C++、C#、PHP 八种语言。
- Kompress-v2-base 处理自然语言文本:这是团队发布在 HuggingFace 上的自训模型(chopratejas/kompress-v2-base),用 agent 运行轨迹训练。
另有独立的图像压缩通道,通过训练出的 ML 路由器做 40–90% 的削减。
KV-cache 保护:CacheAligner 与 live-zone
压缩方案最常见的翻车点是provider 端的 prompt cache 失效:前缀一旦变化,缓存全失效,省下的 token 又以缓存重算的形式还回去了。Headroom 用两个组件处理这件事:
- CacheAligner 标记会破坏 provider KV-cache 前缀的易变内容,只标记、从不改写提示词;
- live-zone 压缩:每轮只压缩新增字节(新鲜工具输出、最新一轮对话),冻结前缀保持字节级一致,provider 缓存存活,历史也从不丢弃。
这个设计让它与「每轮全量重写上下文」的摘要式方案区分开:后者省了 token,却把缓存命中率打没了,在按缓存命中计价的 provider 上反而可能更贵。
可逆性:CCR 压缩缓存
压缩是有损变换,模型拿到的只是压缩视图。Headroom 的 CCR(可逆压缩缓存)把原文缓存在本地,模型在需要完整内容时调用 headroom_retrieve 工具按需取回,缓存在配置的 TTL 内有效。压缩视图负责日常轮次,原文在关键决策点可回溯,这套组合把「省 token」和「不丢信息」拆成了两个独立开关。
输出侧:verbosity steering 与 effort routing
输入压缩之外,Headroom 还从代理层修剪模型写回的内容。在 Opus 级模型上输出价格是输入的 5 倍,而输出里有大量仪式性内容:复述上下文、原样回贴代码、在例行步骤上展开的深度推理。两个机制默认关闭,export HEADROOM_OUTPUT_SHAPER=1 开启:
- verbosity steering:在系统提示词末尾追加一段「保持简洁、不复述上下文」的指令。追加位置选在末尾是有讲究的,前缀不动,prompt cache 照常命中;
- effort routing:当一轮只是工具结果返回后的续跑(读文件、测试通过),自动调低思考强度;新问题和错误保持全档。OpenAI 路径调
reasoning_effort,Anthropic 路径调thinking.budget_tokens/output_config.effort。
输出节省的度量是反事实的(没人知道模型原本会写多长),所以 Headroom 报告的是带置信区间的估计值,并标注 estimated。要实测数字,留出 10% 会话做不整形对照组(HEADROOM_OUTPUT_HOLDOUT=0.1),仪表盘会切换成 measured 口径。
准确率验证
压缩不能以答错题为代价。官方的评估套件 python -m headroom.evals suite --tier 1 结果:
| 基准 | 类别 | N | 基线 | Headroom | 变化 |
|---|---|---|---|---|---|
| GSM8K | 数学 | 100 | 0.870 | 0.870 | ±0.000 |
| TruthfulQA | 事实 | 100 | 0.530 | 0.560 | +0.030 |
| SQuAD v2 | 问答 | 100 | — | 97% | 19% 压缩率下 |
| BFCL | 工具调用 | 100 | — | 97% | 32% 压缩率下 |
N=100 时 ±0.03 的差值落在置信区间内,TruthfulQA 的 +0.030 应读作无可检测差异,官方在文档里自己也这么标注。四项里最关键的是 BFCL:工具调用能力在 32% 压缩下保持 97%,这是 agent 场景的生死线。
agent 兼容矩阵
官方维护的 headroom wrap 支持列表覆盖 18 个 agent:Claude Code、Codex、Grok CLI、Aider、Copilot CLI、VS Code Copilot、OpenClaw、OpenCode、Cline、Continue、Goose、OpenHands、Mistral Vibe、Oh My Pi、Kimi CLI、ZCode 等一键包装,Cursor 和 ZCode 走手动配置路径,Cortex Code 仅库模式(官方报告 60–65% 节省)。
跨 agent 还有一层共享记忆:Claude、Codex、Gemini、Grok 的会话存进同一个本地存储,带 agent 来源标记和自动去重。headroom learn 会挖掘失败会话,把修正写进 CLAUDE.local.md(默认,gitignore 内)、AGENTS.md 或 GEMINI.md。
安装上 Python 端要求 3.10+,CLI 只随 PyPI 包发布;npm 的 headroom-ai 是纯 TypeScript SDK,不含命令行。Docker 镜像 ghcr.io/headroomlabs-ai/headroom:latest 可直接拉取。macOS Apple Silicon 和 Linux 有原生 wheel。
边界与同类对比
官方文档明确了适用边界:长会话、重工具输出的 agent 场景收益最大;单一 provider 自带的 compaction 够用、不需要跨 agent 记忆、或沙箱环境跑不了本地进程的,都不必上。遥测方面,匿名 beacon 默认开启,上报压缩率和计数器、provider 与模型 ID、OS 架构,不含提示词、补全、代码或文件路径,HEADROOM_BEACON=off 或 DO_NOT_TRACK=1 可关。
与同类方案的位置关系:
| 覆盖范围 | 部署 | 本地 | 可逆 | |
|---|---|---|---|---|
| Headroom | 全部上下文(工具/RAG/日志/文件/历史) | 代理·库·中间件·MCP | 是 | 是 |
| Compresr / Token Co. 等托管 API | 发送到其 API 的文本 | 托管 API 调用 | 否 | 否 |
| OpenAI Compaction | 会话历史 | provider 原生 | 否 | 否 |
小结
Headroom 把 agent 上下文压缩做成了独立的本地基础设施层:确定性管线处理 JSON 与源码,自训模型处理散文,CacheAligner 守住 KV-cache 前缀,CCR 保证原文可回溯,输出侧再补上 verbosity 控制与 effort 分档。四场景 21–57% 的输入节省、0.21 毫秒级的压缩开销、BFCL 97% 的工具调用保持率,这三组数字构成了它作为压缩层的基本盘。仓库地址 github.com/headroomlabs-ai/headroom,文档在 docs.headroomlabs.ai。