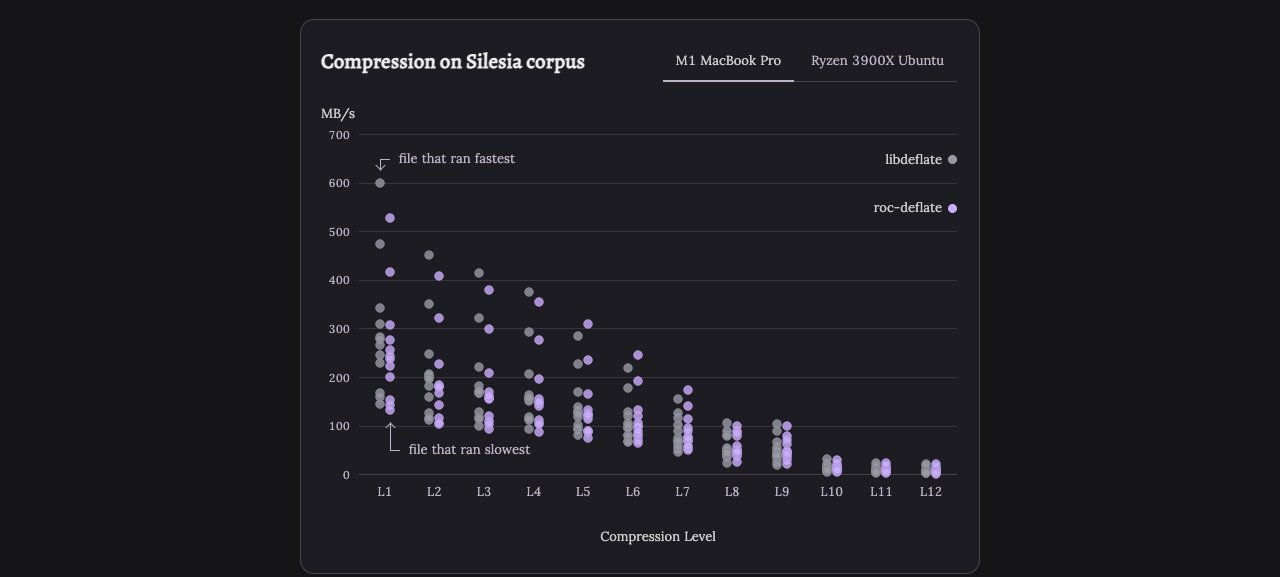
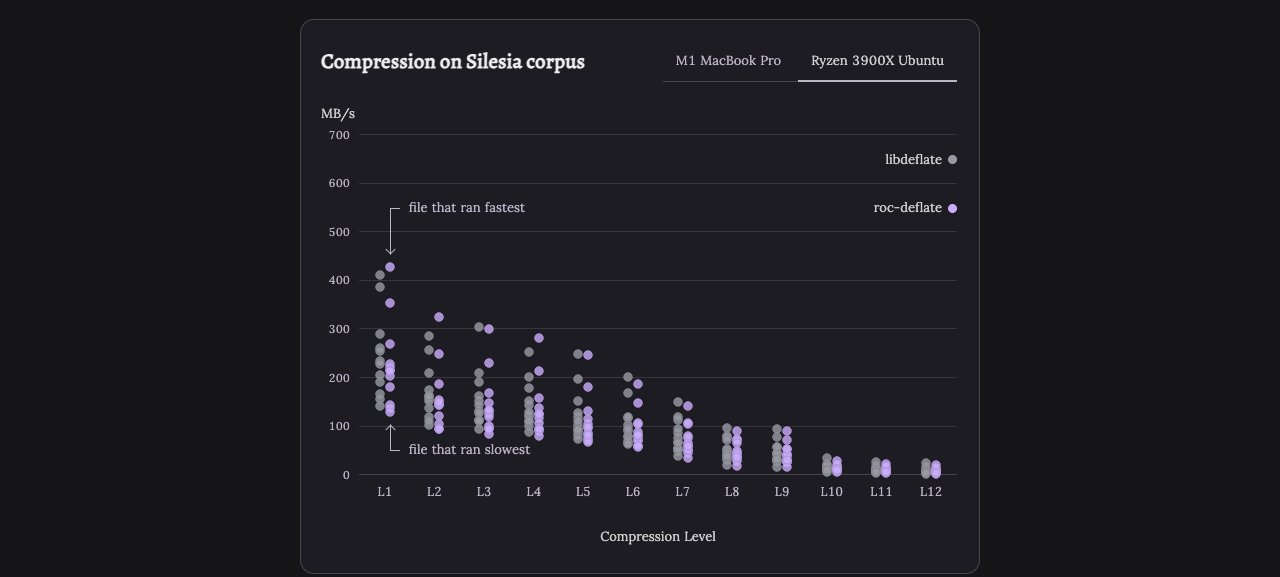
2026 年 10 月 22 日,Roc 语言作者 Richard Feldman 发布了一组基准测试结果:用纯函数式语言 Roc 实现的 DEFLATE 压缩库 roc-deflate,在 Silesia 语料库的 144 组测试中,中位数性能只比 C 语言写的手工调优库 libdeflate 慢 2.6%(M1 MacBook Pro)到 8.9%(Ryzen 3900X)。这个结果的意义不在数字本身,而在于它回答了一个悬置了三十年的问题:自动内存管理、无指针、强制边界检查的函数式语言,距离 C 的性能天花板到底有多远。答案比多数人预想的近得多。
先把三条基准线摆在一起
这篇实测有三个主角,理解它们的定位才能读懂数字:
libdeflate 是 DEFLATE 性能的"终点"。它是 C 写的压缩库,作者 Eric Biggers 是 Linux 内核加密子系统的维护者,库本身针对 x86 与 ARM 的 SIMD 指令集做了逐条汇编级调优。GitHub 上这个库有 1308 颗 star,在压缩领域的地位是公认的参照物:其他库测性能,都要跟它比。
lean-zip 是这次讨论的起点。2026 年 10 月,有人用 Lean 4(一种既是函数式语言又是定理证明器的语言)写了 DEFLATE 压缩库,性能超过了 crates.io 上下载量超过 10 亿次、Rust 生态最常用的 miniz_oxide:同压缩率下吞吐高 15%,输出还小 8.8%。Lean 赢了 Rust,这在几年前会被当成标题党,但数据摆在那里。不过 lean-zip 碰到 libdeflate 就完全不够看了,用原文的话说是被"blown out of the water",因为 libdeflate 的 SIMD 优化深度是 Lean 当前编译器碰不到的层面。
roc-deflate 是 Feldman 交出的答案。Roc 是一门纯函数式语言,目前还没有发布 1.0(第一个带编号的版本 0.1.0 还在路上),生态几乎没做过性能优化。Feldman 在 Niclas Ahden 写的 roc-deflate 包上做了数周的性能压榨,拿它对标 libdeflate,验证输出逐字节一致后跑完 Silesia 语料库全部 144 组基准。
结果:M1 MacBook Pro 上中位数差 2.6%,Ryzen 3900X 上中位数差 8.9%。分布上看,最差情况 roc-deflate 慢 18%,最好情况反而快超过 18%——不同输入下两个实现的胜负会翻转,所以平均而言 libdeflate 仍占优,但单个文件层面选 roc-deflate 并不一定亏。
没有 unsafe,性能从哪来
直觉上这结果不该成立。Roc 的代码是内存安全的:引用计数自动管理内存、数组访问强制边界检查、没有 Rust 那种 unsafe 块可以绕过检查。而 libdeflate 不用做任何边界检查。每一条都要付出运行时代价的语言,凭什么追平?
答案分两层。第一层是通用优化,任何语言都适用:把工作从内层循环挪出去、减少内存读写、用查表替代计算。Feldman 在文中专门推荐了 Casey Muratori 的 Performance-Aware Programming 课程,他自己的优化方法论主要来自这里。
第二层是 Roc 特有的,也是这篇实测最有信息量的部分:
机会主义原地修改(opportunistic mutation)。纯函数式语言的数据默认不可变,每次修改都产生新副本,这在直觉上意味着巨大的内存分配开销。Roc 编译器做了一个分析:如果一个值的引用计数是 1(没有其他人共享它),那"复制再修改"和"直接原地修改"在语义上无法区分,编译器就直接原地改。Koka 语言把同样的技术叫 FBIP(Functional but In-Place)。这基本抹平了不可变数据结构的分配开销,前提是你的代码不制造不必要的共享——Feldman 特别强调,保持值的唯一性是让这项优化生效的第一原则。
把边界检查搬到循环外。Roc 不允许像 C、Zig、Rust 那样关掉边界检查,但允许你帮编译器的忙。在循环前加一句 if collection.len() <= highest_index_used { return 0 } 这样的提前返回,看起来是冗余检查,实际是告诉编译器:循环里的所有索引都在合法范围内。编译器随即把循环体内每轮都执行的边界检查整体删除。一次便宜的检查换来删掉几百次昂贵的检查。
编译期构建查找表。DEFLATE 算法大量依赖霍夫曼表这类静态数据。Roc 的编译期求值可以在编译阶段把表算好,而且因为表长在编译期已知,Ok(entry) = lookup_table.get(5) 这样的模式匹配可以被编译器证明永远不会失败,连运行时的越界判断都省了。
绕过算术溢出。Roc 里 a + b 会展开成带溢出检查的 plus,而 CPU 的回绕加法只要一条指令。当编译器能证明不会溢出时两者生成同样的机器码,证明不了时可以用 plus_wrap 显式放弃检查换速度。这是语言层面留的唯一"后门",而且粒度控制在单个运算符。
那 2.6% 买到了什么
一个自然的反问:既然还慢一点,为什么不直接用 libdeflate?Feldman 给出的交换清单,信息量比性能差距本身更大。
内存安全的分量在于它是类型系统保证,超出了"尽力避免 bug"的工程承诺。Roc 代码不存在能绕过内存安全的语言原语,整条优化管线是在不破坏这个前提的情况下把检查优化掉的,不是靠关闭检查提的性能。对照现实:就在这篇实测发布的前一天,C 写的 Brotli 压缩库刚披露了一个由未检查内存操作导致的远程代码执行漏洞。压缩库是解析不可信输入的代码,恰恰是内存安全价值最高的场景。
纯度也有类型保证。Roc 的类型系统区分纯函数与带副作用的函数:Bool -> Bool 是纯函数,Bool => Bool 允许副作用。roc-deflate 的 API 全部是细箭头,这个包是 100% 纯函数,这是编译器证明的性质,不是文档声明。
供应链风险有结构性边界。Roc 没有任意 FFI,纯函数不可能偷偷做 I/O 或访问任意内存。一个被投毒的 Roc 包,危害上限是返回错误值、崩溃、浪费资源。对比:两个月前 Rust 生态的 arrayref 包就是通过构建脚本被成功投毒的,而 Roc 包根本不支持构建脚本。跨平台确定性是第四项:纯函数在所有目标平台上产生逐位相同的结果,这对压缩、哈希、编解码这类基础设施代码意味着可复现性。
把清单反过来看就是那句核心权衡:用平均个位数的性能差距,换内存安全、无副作用、跨平台确定性和无构建脚本供应链这四项保证。这个交换是否值得取决于场景——Roc 自己的编译器要榨干硬件,选极限性能;而对大多数解析不可信输入的基础设施代码,2.6% 很难说比四项编译器级保证更重要。
这个结果的边界
Feldman 自己把适用范围画得很清楚:这是单一包、单一算法、单一作者数周优化的结果,是至今投入优化精力最多的 Roc 包,它能到这个高度不代表任何 Roc 代码都能。函数式语言的性能上限普遍低于 C 这一点没有变——roc-deflate 能赢的那些输入,C 代码理论上都能追回来,反过来不成立。文中给出一组数据前也先声明了基准环境:全部测试在 2021 款 M1 MacBook Pro 和 Ryzen 9 3900X 上完成,x64 侧还有明显的优化空间没做完。
Roc 语言官网显示这门语言仍在 0.1.0 发布前的冲刺阶段,从 2019 年立项算起已经开发了八年。一个没有发布 1.0 的语言,生态零优化、编译器频繁崩溃、语法还在变的阶段,第一代压缩库就能贴住手工调优的 C 库,这件事对语言设计领域的含义比数字本身大:它把"函数式语言必然慢一个数量级"的经验判断,改写成了"差距在个位数百分比、且随着编译器优化管线成熟还在收窄"。
对基础设施开发者来说,可操作的信息有三条。选型层面,压缩、编解码、哈希这类解析不可信输入的组件,内存安全的纯函数实现已经是性能可接受的选择,不必再用"性能"当理由绑定 C。优化层面,边界检查外提和编译期查表这两招在任何有编译期求值的语言里都能用,opportunistic mutation 的思路(分析共享性、能原地改就原地改)也值得在别的 GC 语言里追问一句为什么做不到。观测层面,Feldman 公开了完整的基准复现脚本(Linux 侧,钉住编译器与依赖版本),roc-deflate 与 libdeflate 的代码分别在 GitHub 的 niclas-ahden/roc-deflate 和 ebiggers/libdeflate 仓库,144 组基准的原始数据在原文可查。性能声明能被独立复现,是这个领域少有的好习惯。
参考来源: