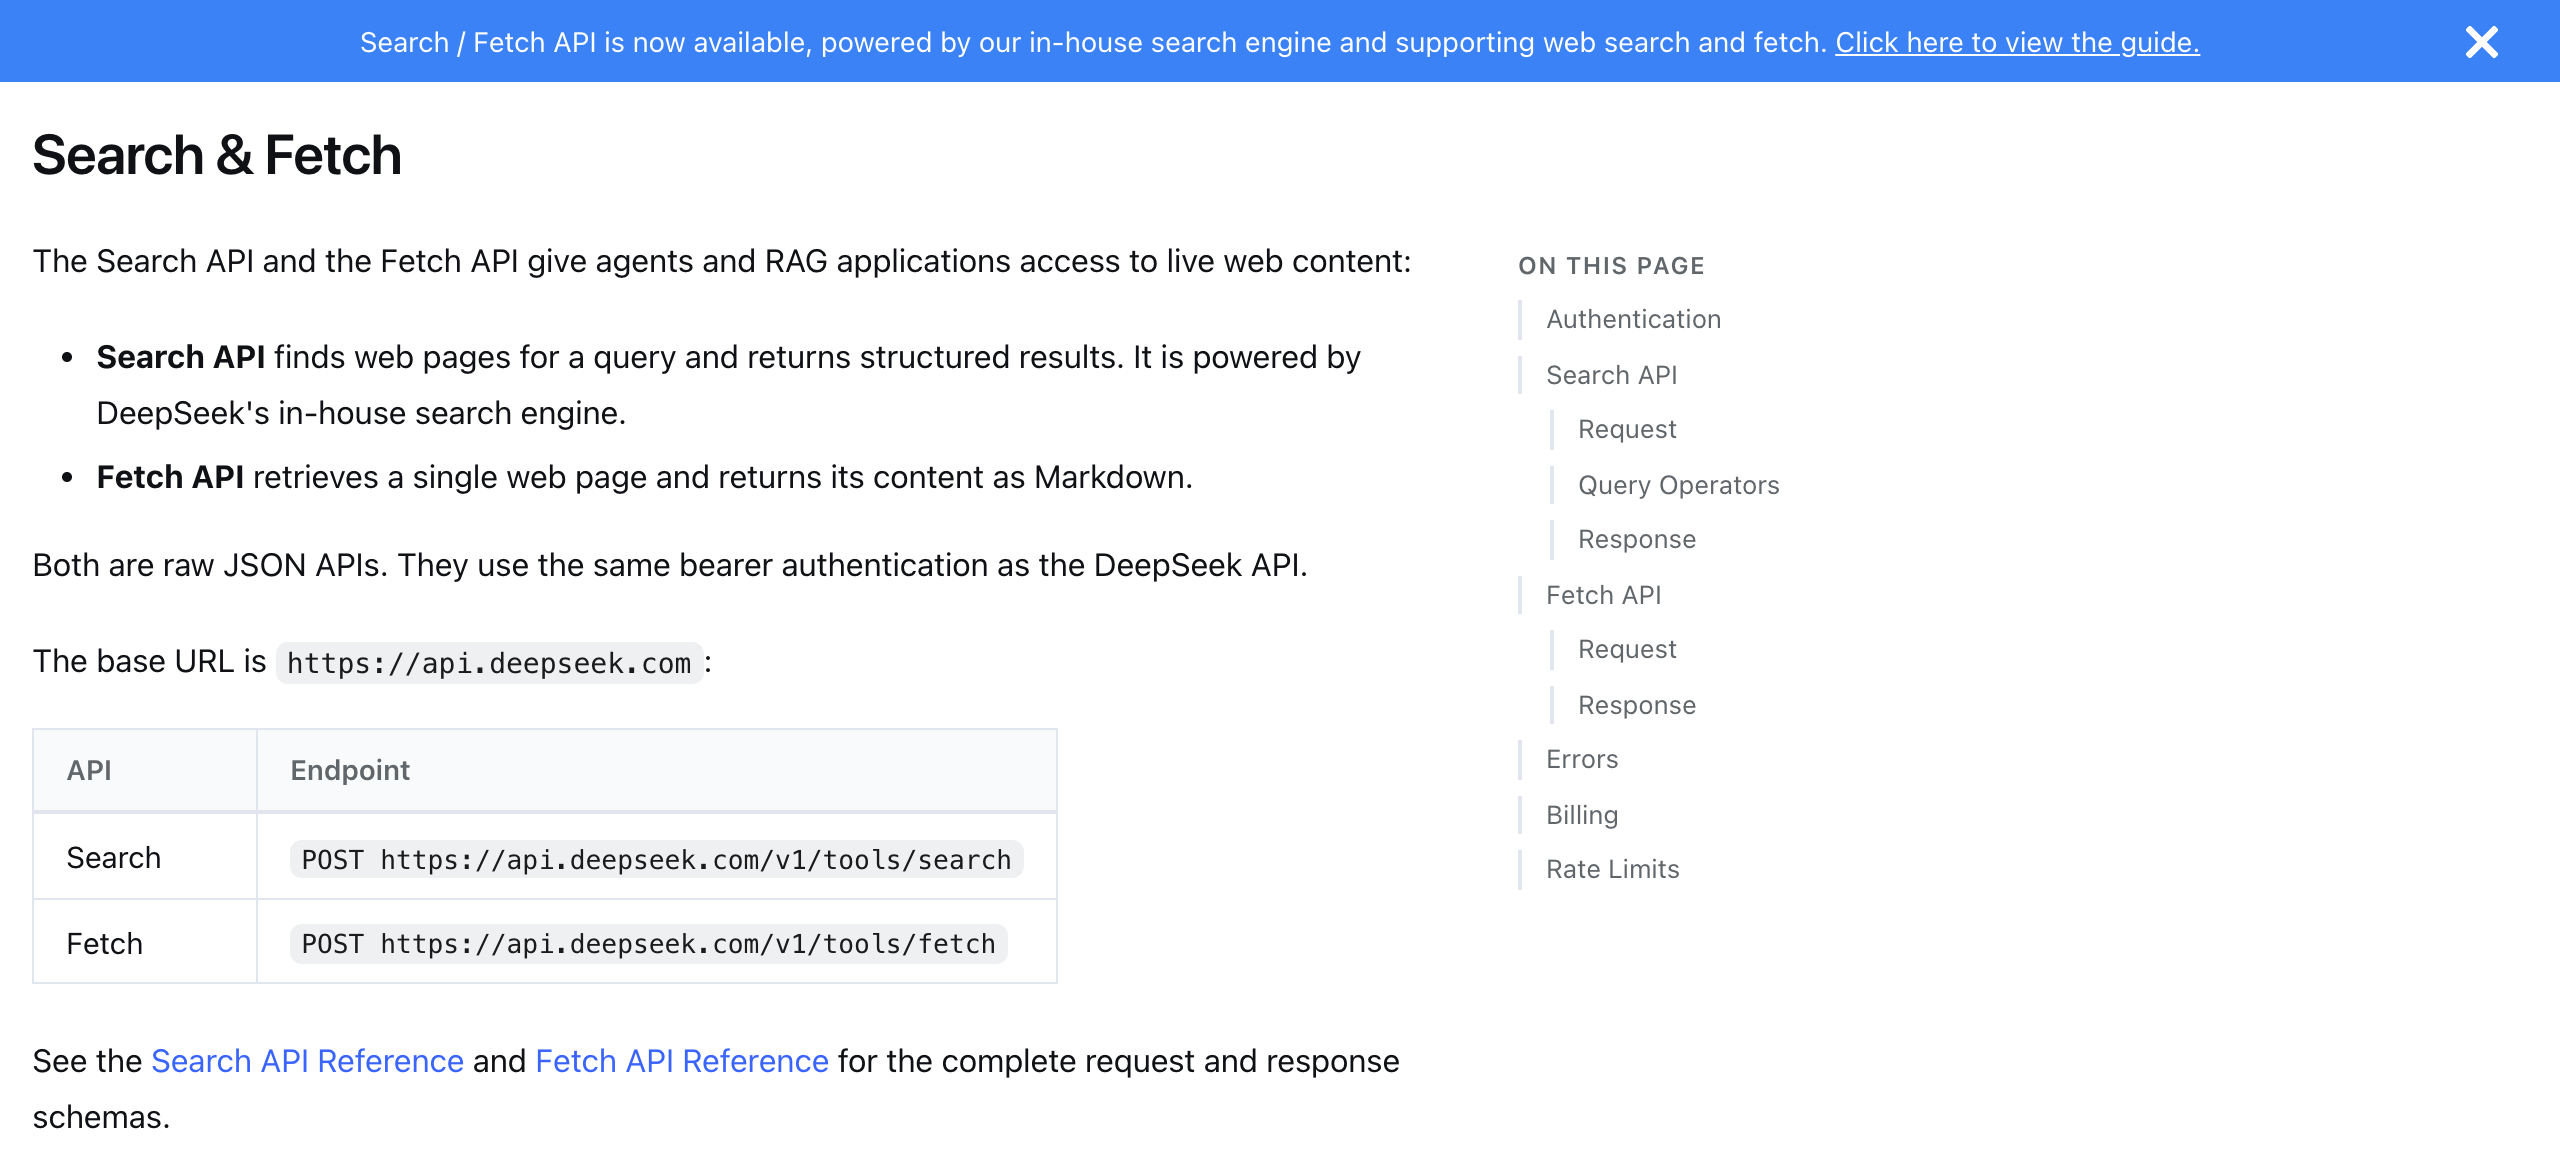
10 月 17 日,DeepSeek 在官方 API 文档更新中开放了两个此前只供内部模型使用的网络工具接口:Search API 与 Fetch API。前者按查询返回结构化网页结果,后者把单个网页正文抓取为 Markdown。两个接口的单价均为每 1000 次成功请求 0.75 美元(国内版 5 元人民币),2026 年 11 月 1 日 00:00(北京时间)起正式计费,此前通过 DeepSeek Harness、Claude Code、Codex 服务端工具发起的调用免费。
这不是接入第三方搜索供应商的转售接口。官方变更日志的表述是:DeepSeek 的网页端与 API 搜索能力由自研的 DeepSeek 搜索引擎驱动,该引擎每天在全球处理数亿次搜索请求;DeepSeek Search 是一个 AI 原生通用搜索引擎,索引数千亿网页,支持多语言搜索,实时返回高相关、高权威、时效性强的结果,并通过严格的检测机制过滤 SEO 垃圾、GEO 操纵(生成式引擎优化)与低质量 AIGC 内容。一句话概括:模型公司把支撑自家产品联网能力的搜索底座,直接做成了对外售卖的基础设施。
接口设计:两个 POST 端点,同一套 Bearer 认证
两个接口都是原生 JSON API,与 DeepSeek API 共用同一套 Bearer 认证,base URL 为 https://api.deepseek.com:
| API | 端点 | 功能 |
|---|---|---|
| Search | POST /v1/tools/search | 按查询返回结构化网页结果 |
| Fetch | POST /v1/tools/fetch | 抓取单个网页,正文转为 Markdown |
Search 请求的核心字段只有五个。query 必填,1 到 128 个 Unicode 字符;count 控制返回条数,默认 10,上限 50;need_content 决定是否在结果中附带页面正文;ori_question 是可选项,用于传入触发搜索的原始问题(同样限 128 字符),帮助引擎理解查询意图;localization 传入 IP 地址用于结果本地化。请求体中的未知字段会被忽略,这个设计让客户端升级时不会因多余字段报错。
Fetch 更简单:请求体只有一个 url 字段,要求 HTTP/HTTPS、必须带 host、不得含用户名密码、最长 8192 字符,返回 title 与 Markdown 格式的 content。
查询算子:搜索语法原样透传
Search API 的查询串支持一整套算子语法,并且查询会带着语法原样转发给搜索引擎,不做预处理。这意味着熟练用户可以在 API 层面做相当精细的结果控制:
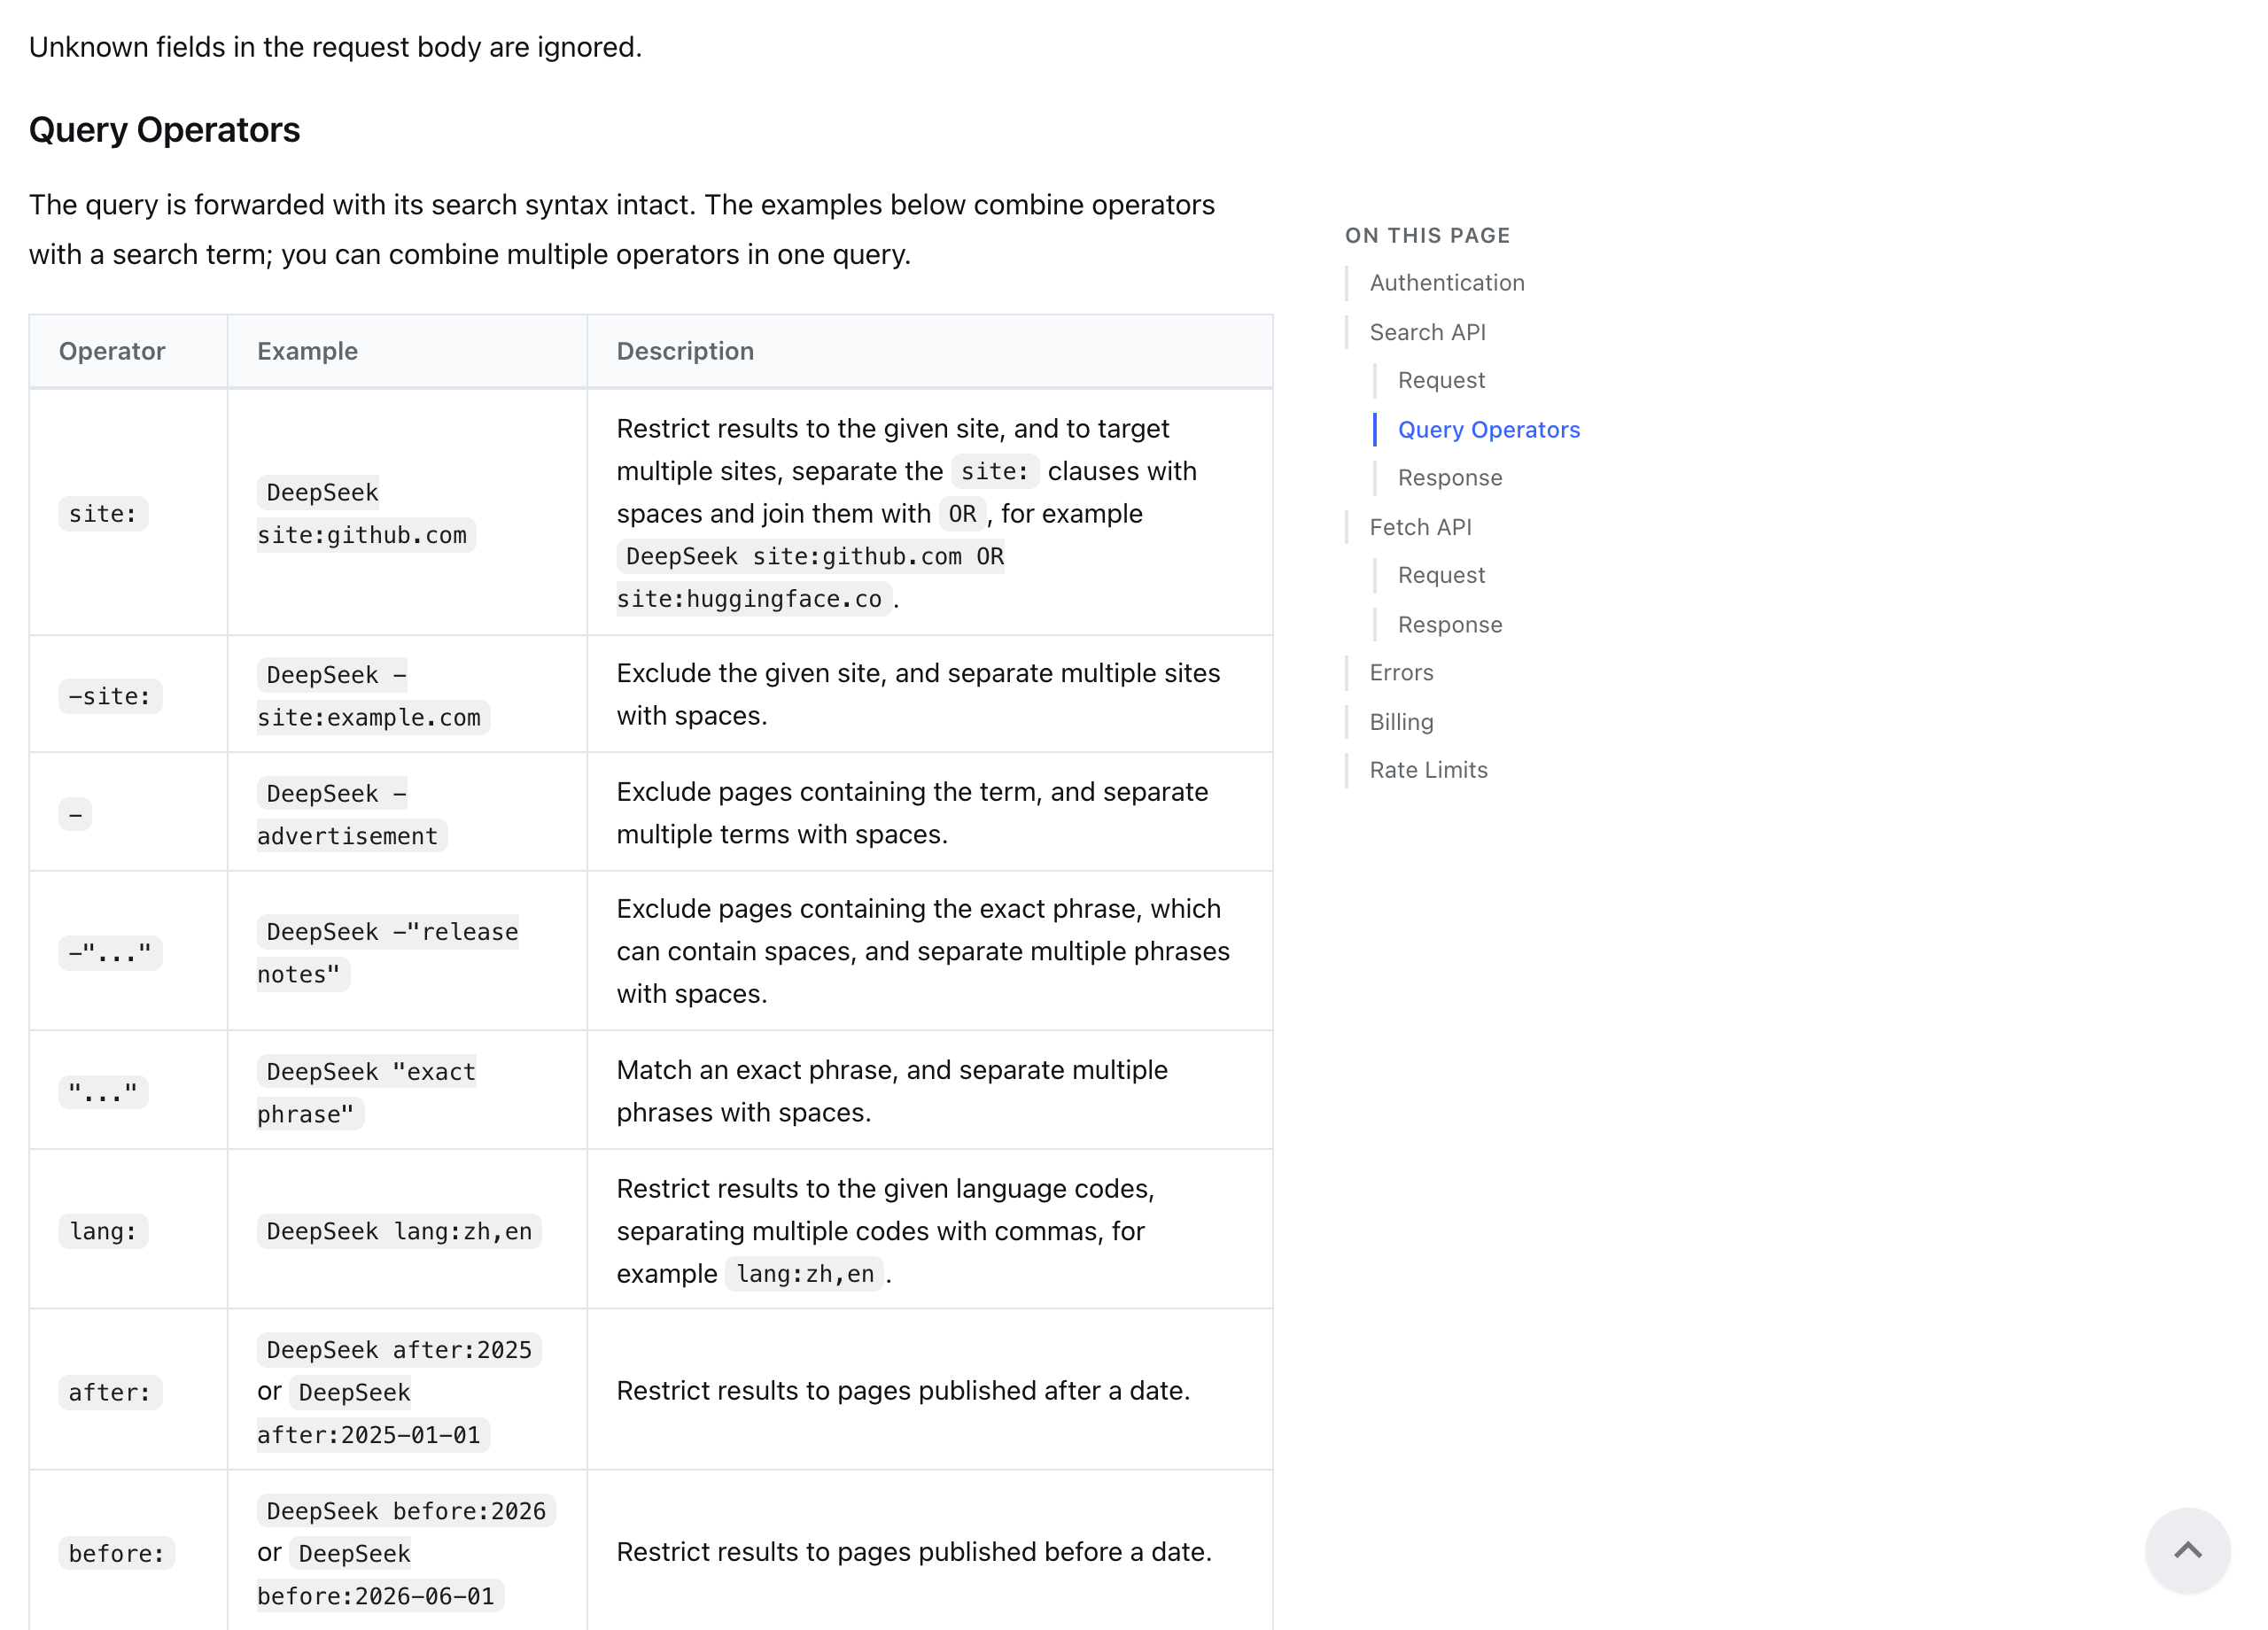
| 算子 | 示例 | 作用 |
|---|---|---|
site: | DeepSeek site:github.com OR site:huggingface.co | 限定站点,多站点用 OR 连接 |
-site: | DeepSeek -site:example.com | 排除站点 |
- | DeepSeek -advertisement | 排除含某词的页面 |
-"..." | DeepSeek -"release notes" | 排除精确短语 |
"..." | DeepSeek "exact phrase" | 匹配精确短语 |
lang: | DeepSeek lang:zh,en | 限定语言代码 |
after: | DeepSeek after:2025-01-01 | 限定发布日期之后 |
before: | DeepSeek before:2026-06-01 | 限定发布日期之前 |
对比主流搜索 API,这套算子覆盖了站点过滤、语言过滤和日期过滤三个维度,但缺少 Exa 那种按语义目标描述检索的能力。Exa 的搜索请求里可以传一个最长 4096 字符的 objective 字段描述检索意图,而 DeepSeek 的 ori_question 上限是 128 字符,两者的定位差异明显:DeepSeek 走的是传统搜索语法路线,把语义理解留给调用方的模型去迭代查询,Exa 走的是嵌入式语义检索路线。
返回结构:为模型消费设计的字段分层
Search 响应的每条结果包含 11 个字段,其中三个信号字段的设计有分层考虑:
rerank_score:0 到 3 的相关性得分,综合相关性、权威性、新鲜度信号,官方口径 1.5 以上算高质量结果authority:0 到 4 的页面权威度分层(-1 表示未知),3 以上为高权威来源date:页面发布时间,RFC 3339 格式 UTC,未知时为 null
其余字段按消费场景分了两层:snippet 是 100-200 字符的短摘要,给 UI 展示用;summary 是 600-800 字符的长摘要,明确标注「供模型阅读」。content 字段在 need_content=false 时恒为空串。这种字段分层把「给界面看的」和「给模型读的」拆开,调用方可以只拿摘要省流量,也可以拿全文做深度处理。
Fetch 的错误码设计也做了细分:403 表示请求被安全策略拒绝(目标站拦截),404 表示拿不到可用正文(站点不可用、被策略屏蔽、内容类型不支持或无 Markdown 可提取),这两个码对应了网页抓取最常见的两类失败。官方明确两个接口都是只读操作,408/429/5xx 建议等待重试,402 需要充值后重试,其余 4xx 不要在请求不变的情况下重试。
计费口径:按成功请求计费,失败不收钱
这是整个发布里对开发者最实际的的设计决策。计费单位是「每 1000 次成功请求 0.75 美元」,判断标准写得很清楚:请求返回 HTTP 200 且产出结果才算成功,Search 必须返回非空 results 数组,Fetch 必须返回页面内容。失败请求、空搜索结果、超时一律不计费。count 只控制返回条数,不影响单次请求价格,要 1 条和要 50 条同价。
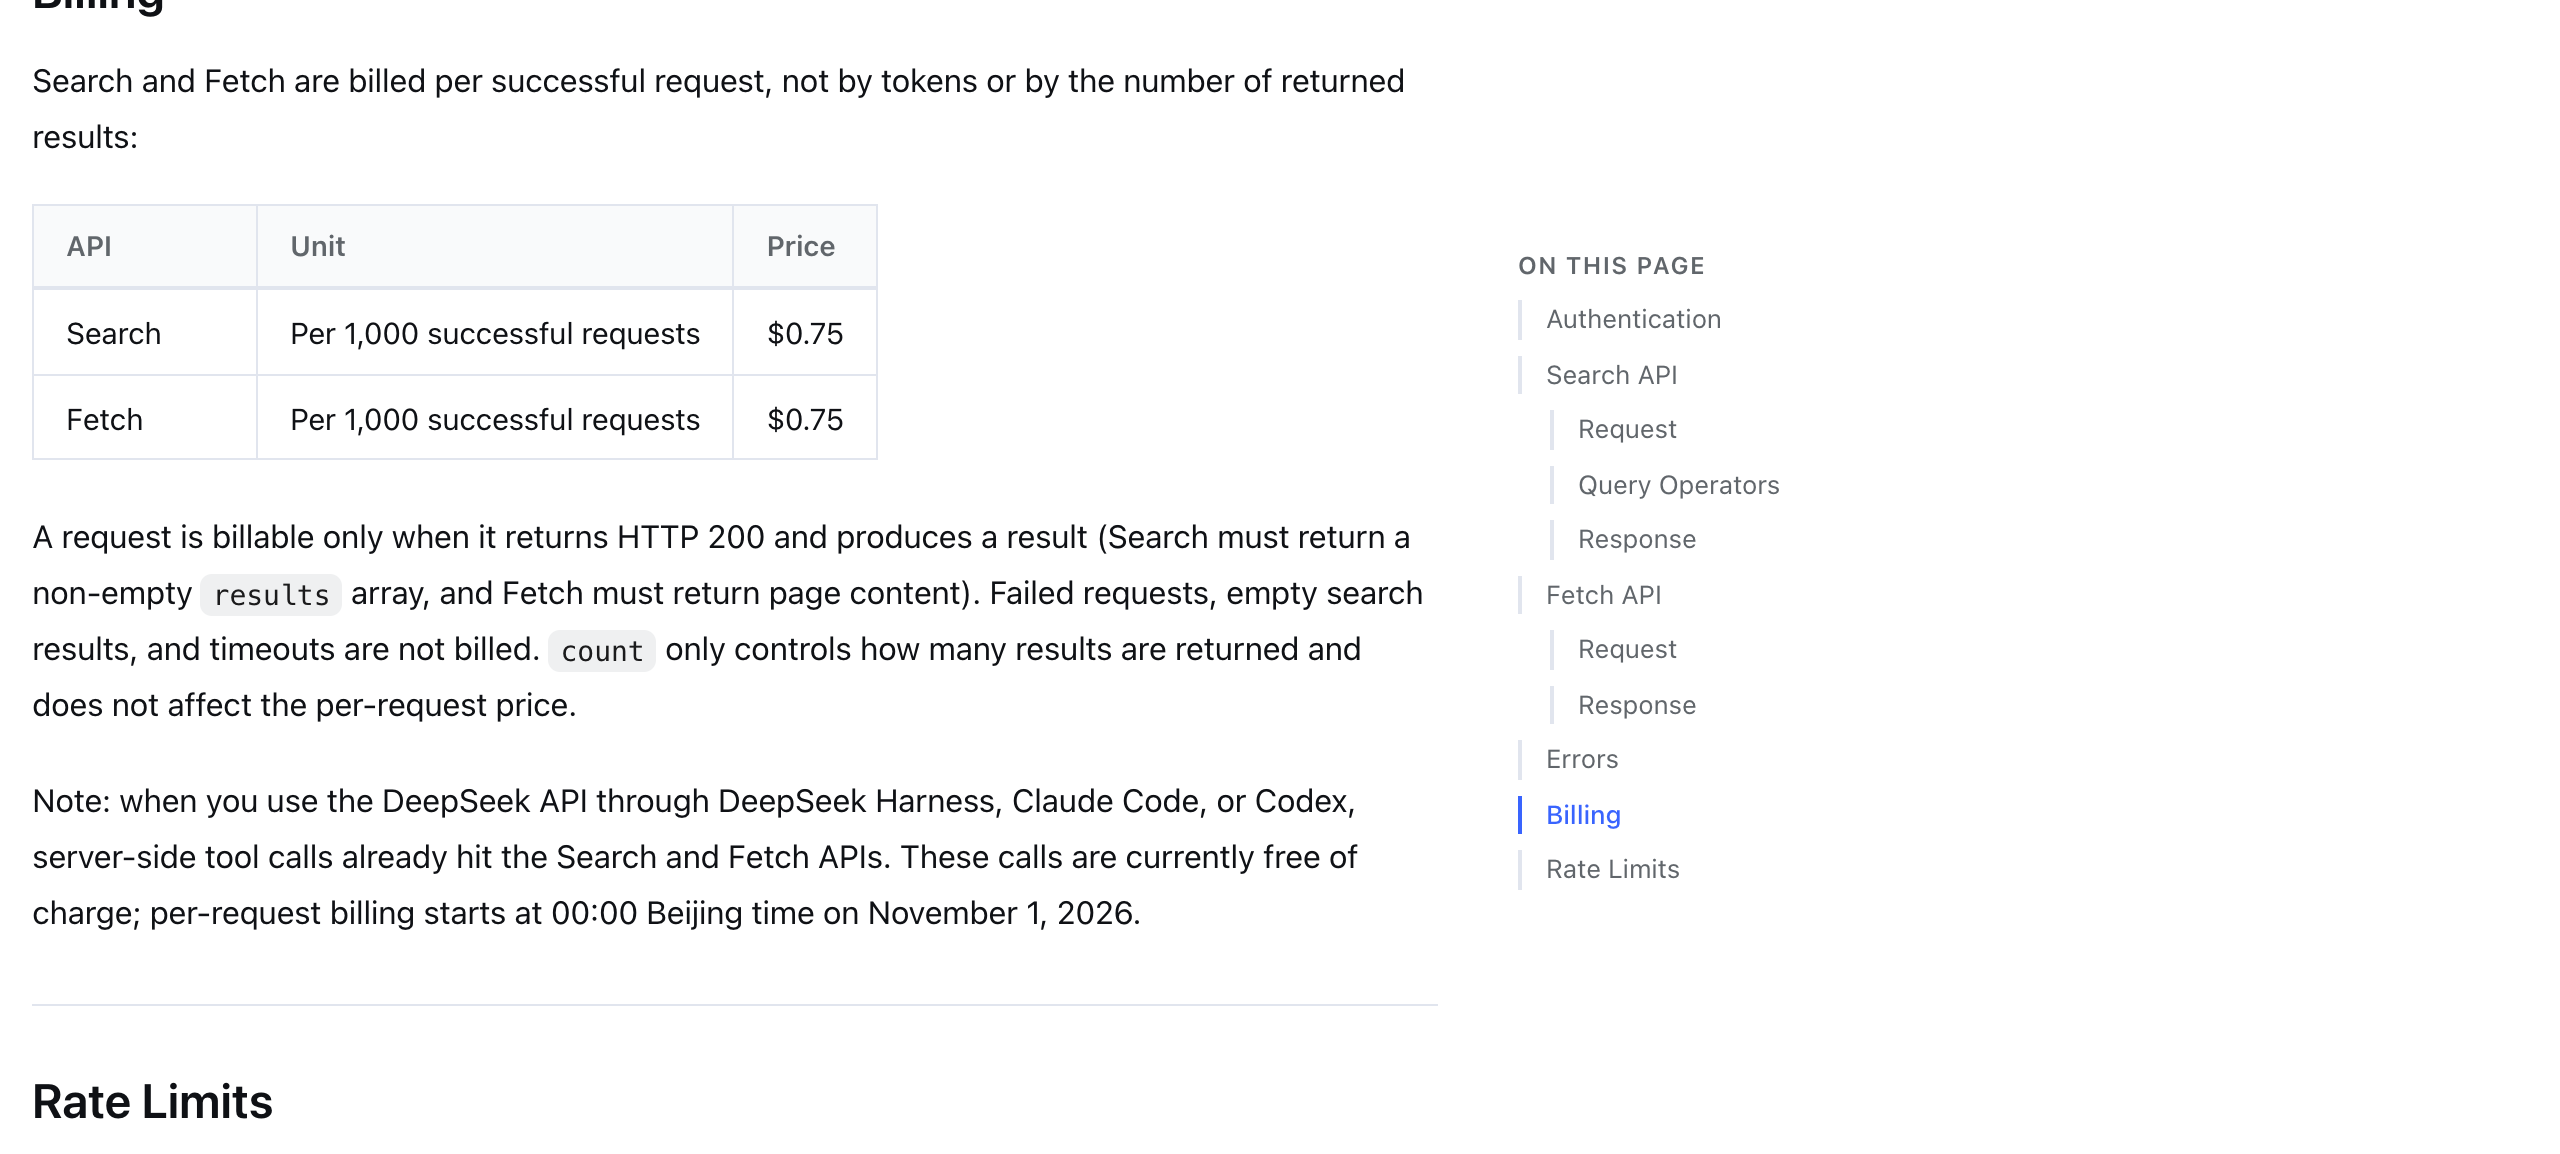
这个口径把搜索 API 最恼人的风险消掉了:传统按调用计费的搜索 API 里,空结果是照收费的,调用方要为引擎没找到东西买单。按成功计费意味着质量风险由 DeepSeek 自己承担,索引查不到东西就是白干。官方同时给出了时间表:通过 DeepSeek Harness、Claude Code、Codex 的服务端工具调用目前免费,2026 年 11 月 1 日 00:00(北京时间)起统一按次计费。
限流方面,Search 与 Fetch 各自独立限流,互不占用配额,账户级 QPS 上限各 5。QPS 按账户计算,与使用哪个 API key 无关,且与模型并发限制分离。Fetch 在账户级限流之外还有按目标域名的 QPS 限制。
横向比价:搜索 API 市场的价格坐标
HN 讨论区(520 分、250 评论)里开发者贴出了各家搜索 API 的实际报价,拼出一幅价格地图(以每 1000 次请求计):
| 服务商 | 价格(每千次) | 备注 |
|---|---|---|
| DeepSeek Search/Fetch | $0.75 | 自家索引,按成功请求计费 |
| Ceramic.ai | $0.25 | HN 用户反馈索引陈旧、仅词法匹配 |
| SERP API | $1.50 | Google SERP 抓取 |
| LinkUp | Fetch $1 / Search $5 | |
| Brave Search API | $5 | |
| Exa | $4 起 | 语义检索,objective 最长 4096 字符 |
| Mojeek | £2 | 自建索引(非 SERP 转发) |
| Kagi API | $12 | 含 MCP server |
价格之外,各家产品的索引来源不同。SERP API、LinkUp 这类走的是搜索引擎结果页抓取,Brave、Mojeek、DeepSeek、Kagi 是自建索引。自建索引意味着抓取、索引更新、反垃圾都是自己的成本,按成功请求计费模式下这个成本压力全部落在 DeepSeek 一侧。
争议:AI 抓取与反爬的军备竞赛
HN 讨论区里最激烈的争论不在价格,在抓取伦理。有站长反馈识别出的 AI 爬虫(按 UA 判断来自 Anthropic、OpenAI、Perplexity)占了其站点 99% 以上的流量,无视 robots.txt;也有开发者反驳 Claude 和 ChatGPT 的 UA 可以被站点直接屏蔽,新一轮 AI 爬虫普遍伪装成 Chrome 且不遵守 robots.txt。Anubis(开源反爬中间件)在讨论里被反复提及,它的一个设计动机就是拦截 AI 公司的海量请求。
这个背景下看 DeepSeek 的官方口径有其明确立场:引擎通过严格检测机制过滤 SEO 垃圾、GEO 操纵与低质量 AIGC。这说的是结果质量端的反垃圾,而抓取端的机器人礼仪(robots.txt 遵守、UA 透明、频控)官方文档没有展开。对做站点运维的读者,Fetch API 的 403/404 错误码语义提供了一个观测点:如果目标站部署了 Anubis 或 Cloudflare 挑战,Fetch 会返回错误而非内容,具体拦截行为取决于站点策略。
对开发者的实际影响
三个直接的判断:
第一,Agent 联网的最便宜正规军出现了。按成功计费加 $0.75 千次单价,一个日均发起 1 万次搜索的 Agent 应用,搜索成本约 $7.5/天。此前自建搜索工具链(ScrapingAPI/ScraperAPI 包一层)能做到更便宜,但要自己维护反爬、代理与解析,稳定性成本被低估。
第二,质量是未知数,价格不是。讨论区对索引质量的反馈两极:有人认为词法匹配加模型迭代查询的路线在 Agent 场景下够用(类比编码 Agent 用 grep 的成功),也有人实测后认为索引覆盖不足。DeepSeek 官方没有公布索引规模、更新频率、爬虫 UA 等运维细节,判断质量只能实测。
第三,11 月 1 日是个分界线。在 Harness、Claude Code、Codex 里用 DeepSeek 做后端的用户,服务端搜索工具调用从免费转付费,成本模型需要重算。对已在用 deepseek-flash(现由 DeepSeek-V4.1-Flash-1017 承载)跑 Agent 的团队,同一个 API key 同时覆盖模型与联网能力,接入成本为零。
从产品逻辑看,DeepSeek 把搜索引擎从模型配套做成独立产品线,与 OpenAI 的 SearchGPT、Perplexity 的 Sonar API 形成同场竞争。差异点在价格与计费口径:Sonar API 按 token 计费(搜索结果计入上下文),DeepSeek 按请求计费且失败不收费,前者成本随结果长度波动,后者成本可精确预算。对成本敏感的 Agent 开发者,这个区别比模型能力更实际。