华为开源 920 亿参数 openPangu-2.0-Flash 模型
华为 6 月 30 日正式开源 openPangu-2.0-Flash 模型,首批上线内容包括模型权重、基础推理代码和训推算子。 openPangu 2.0 发布会现场 openPangu-2.0-Flash 总参数量 920 亿,激活参数量 60 亿,采用 MoE(混合专家)架构,稀疏比达到 28:1,支持 512K 上下文窗口。该模型全链路基于华为自研昇…
华为 6 月 30 日正式开源 openPangu-2.0-Flash 模型,首批上线内容包括模型权重、基础推理代码和训推算子。 openPangu 2.0 发布会现场 openPangu-2.0-Flash 总参数量 920 亿,激活参数量 60 亿,采用 MoE(混合专家)架构,稀疏比达到 28:1,支持 512K 上下文窗口。该模型全链路基于华为自研昇…
DeepSeek 联合北大开源 DSpark:半自回归推测解码,推理速度提升 60% 至 85% 大语言模型生成文本时逐 token 串行计算,推理延迟随输出长度线性增长,这是 AI 对话系统响应偏慢的根本原因之一。推测解码是一条已知的加速路径:用轻量草稿模型快速生成若干候选 token,再由完整规模的大模型通过单次并行前向传播批量验证,接受符合目标分布的连…
K2.7 Code 解决的核心问题 K2.6 的长程编程任务有两个痛点:指令遵循在长上下文中衰减,以及过度思考导致 token 浪费。K2.7 Code 针对这两个问题做了定向优化——指令遵循能力提升,平均 token 消耗减少 30%。 Kimi K2.7 Code 发布并开源 基准测试表现 代码能力方面,K2.7 Code 相比 K2.6 全面提升:Ki…
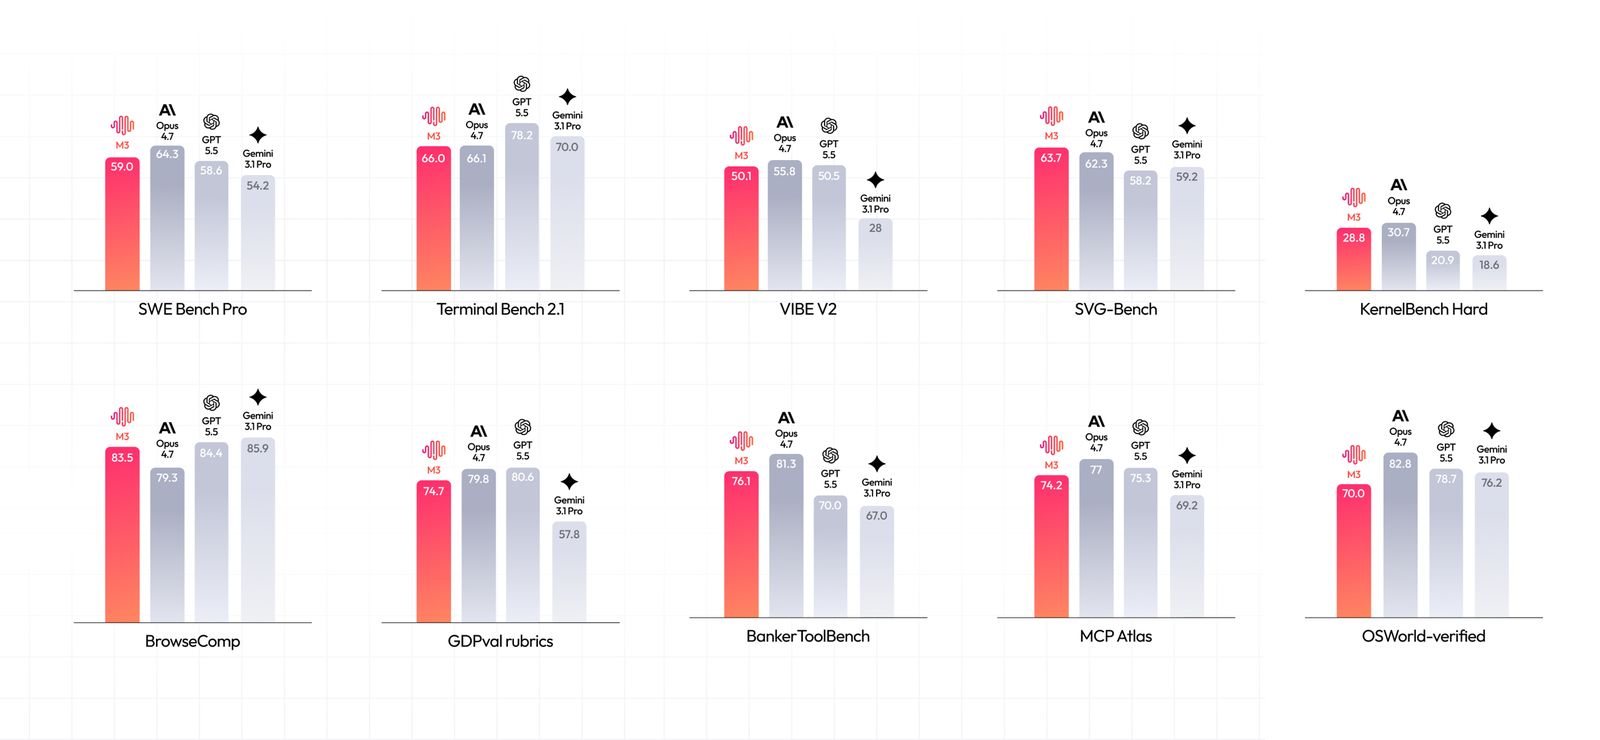
MiniMax M3 Benchmark MiniMax 今日正式发布 M3 模型。这是一个同时具备前沿 Coding 能力、百万级上下文和原生多模态的模型——国内第一个,也是目前全球唯一达成这一配置的开源模型。 M3 采用 MiniMax 自研的 MSA(MiniMax Sparse Attention)稀疏注意力架构,最高支持 1M 上下文窗口。在 10…
字节跳动发布 Lance,一个仅 3B 激活参数的轻量级原生统一多模态模型,在单一框架下同时支持图像理解、视频理解、图像生成、视频生成和跨模态编辑五种任务。模型使用 Apache 2.0 许可,权重已在 Hugging Face 开放。 Lance 模型概览