9 月 17 日,PrismML 发布 Ternary Bonsai 2 27B:一个三值量化的 27B 多模态模型,整个语言模型打包后只有 5.93 GB,在 20 项基准测试上保留原模型 98.2% 的平均成绩。权重以 Apache 2.0 协议开放在 Hugging Face,GGUF 版本发布当天就可以用 llama.cpp 直接加载。
5.9 GB 意味着什么
27B 参数模型的全精度(FP16)权重约 53.8 GB,这个数字决定了它的运行边界:消费级显存最大的 RTX 5090 只有 32 GB,装不下;16 GB 内存的多半笔记本,更装不下。社区常规做法是 4-bit 量化,把体积压到 17 GB 上下,勉强塞进 24 GB 显卡。要在 16 GB 内存上跑,只能选 2-bit 方案(如 IQ2_XXS,7.3 GB),而这类激进量化在推理、代码、长上下文上损失明显——PrismML 在白皮书里给出的对照数据是:同一套 20 项基准,Qwen3.8-27B 的 IQ2_XXS 量化版平均 75.2 分,比全精度的 85.4 掉了约 12%(保留 88.4%),其中 AIME26 从 95 以上掉到 78.6,LiveCodeBench 掉到 70.05。
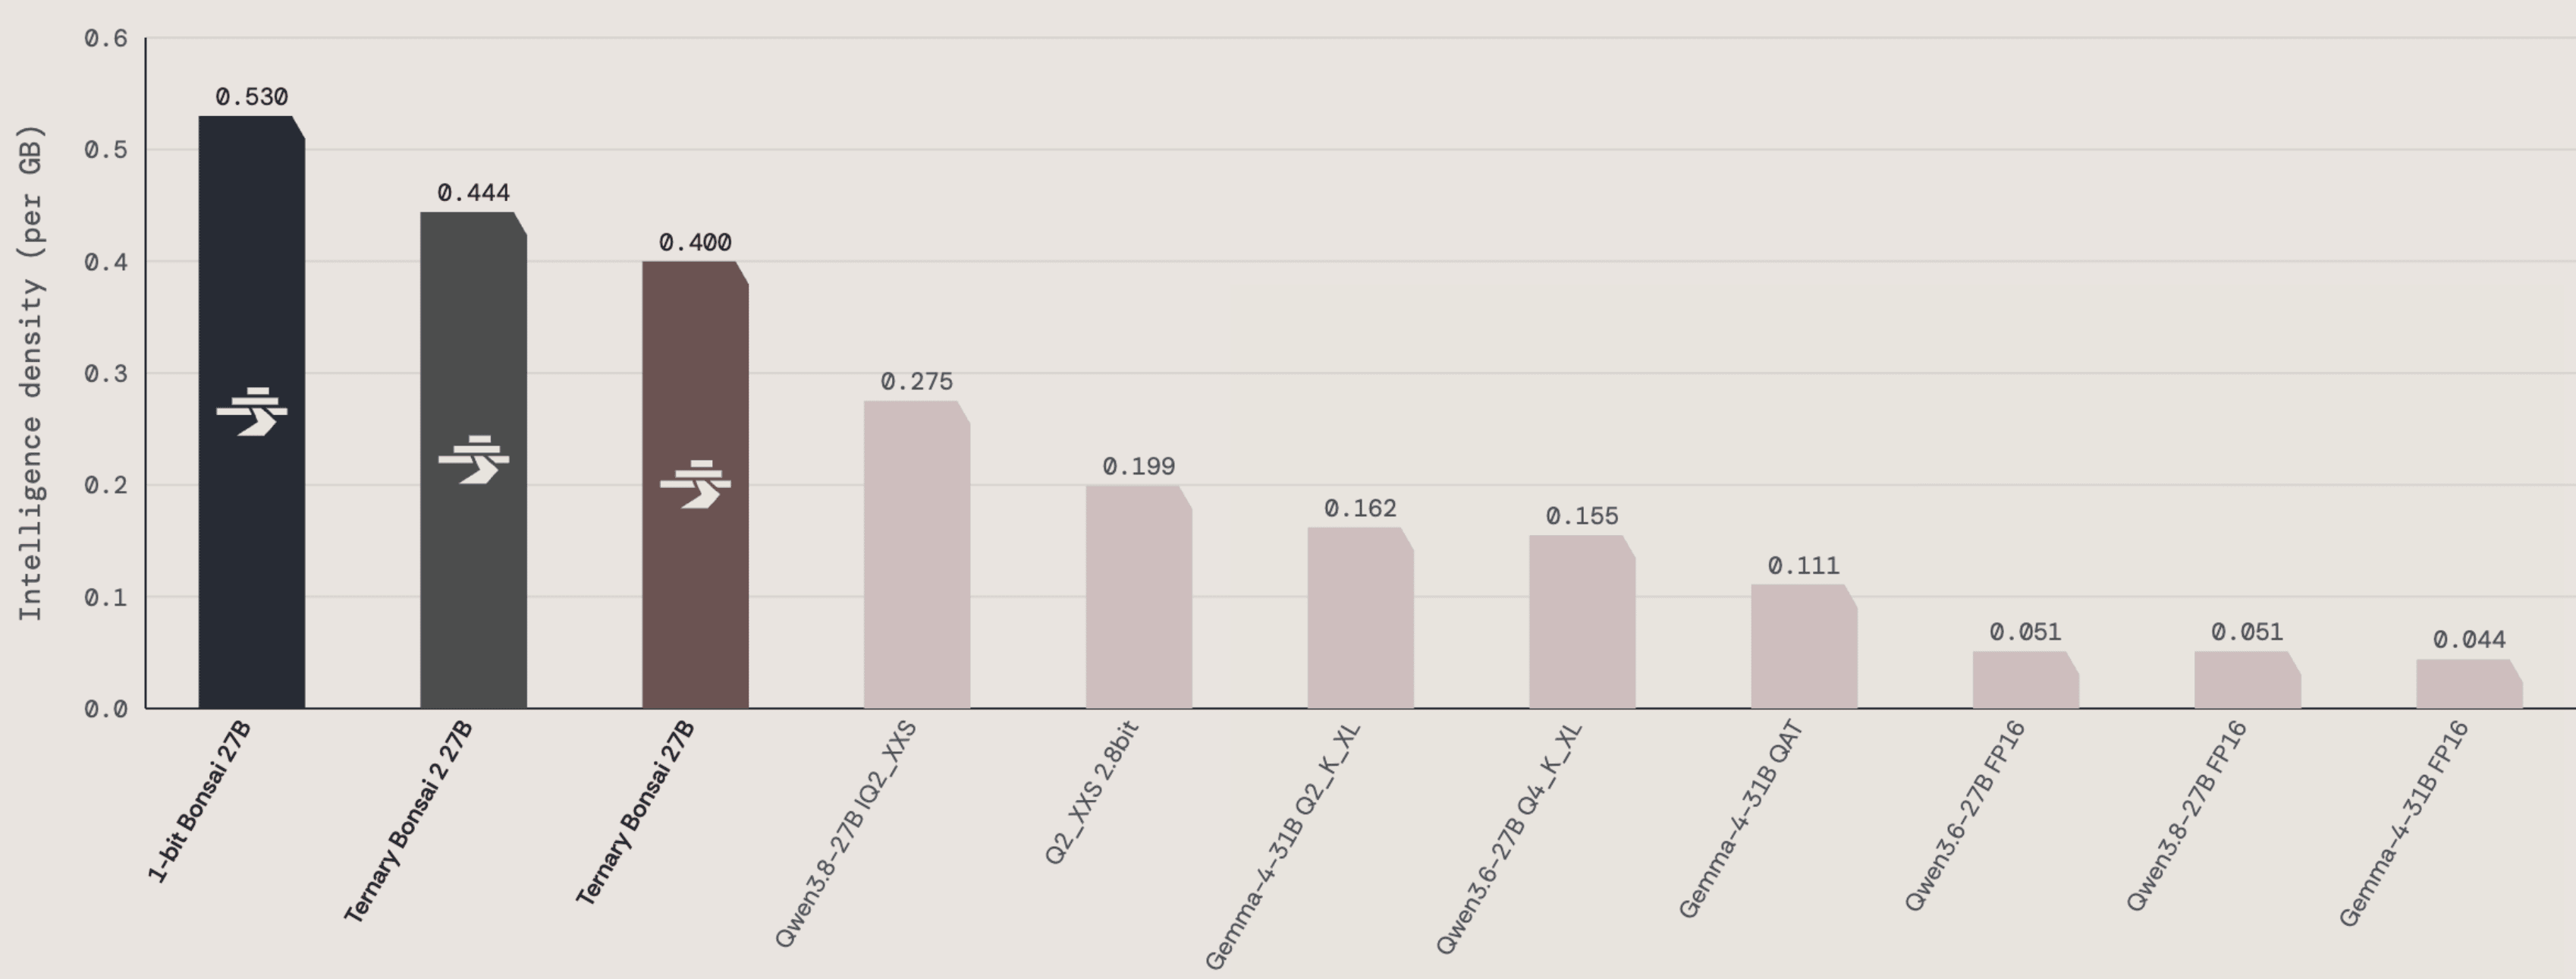
Bonsai 2 的三值方案在更小的体积(5.93 GB 对 7.3 GB)拿到了 83.9 的平均分,保留率 98.2%。
| 变体 | 位宽 | 体积 | 20 项基准平均 | 保留率 |
|---|---|---|---|---|
| Qwen3.8-27B FP16 | 16 bit | 53.80 GB | 85.4 | 100% |
| Qwen3.8-27B IQ2_XXS | 2.2 bit | 7.3 GB | 75.2 | 88.4% |
| Ternary Bonsai 2 27B | 1.76 bit | 5.93 GB | 83.9 | 98.2% |
体积差一个 GB,分数差 8.7 分。这是这份发布里最有信息量的一组对比:低比特量化的质量崩塌不是均匀的,长上下文推理和代码最先劣化,日常对话的流畅度反而最抗压缩——白皮书把这称为「qualitatively and unevenly」的失败模式, casual 测试里不容易发现,生产环境里才发现就晚了。
三值权重怎么压缩到 1.76 bit
三值量化把权重值域限制在 {-1, 0, +1} 三个值。用两个比特当然可以编码三个值,但信息论下限是 log2(3) ≈ 1.585 bit。Bonsai 2 做了三件事把实际位宽压到 1.76 bit:
第一,三值 + 分组缩放。 权重不再是任意浮点数,而是{-1, 0, +1},每 128 个权重为一组共享一个 FP16 缩放因子(g128)。组内方差由缩放因子吸收,三值编码只承担残差。按这个格式,理论位宽是 1.72 bit。
第二,保留 0.0976% 的全精度参数。 不是所有张量都三值化:线性注意力层的循环状态通路(in_proj_a/b、conv1d)、所有归一化层保持 FP16,共 2623 万参数。这些张量要么是数值敏感的统计量(归一化),要么是跨时间步传递的状态(循环通路),三值化对它们的破坏远大于对普通前馈权重。这部分开销计入 1.76 bit 的官方数字。
第三,固定旋转基(rotated basis)。 三值化之前,权重先被块状变换到固定的旋转基:R = (1/√n)·Hn·S,其中 Hn 是 1024 阶 Walsh–Hadamard 矩阵,S 是固定的 ±1 符号对角阵。推理时对激活做同样的变换 f(x) = W(Rx),让每个权重张量的能量分布更均匀,避免少数离群权重破坏三值网格。这是当前低比特量化研究里被反复验证的方向(QuaRot、SpinQuant 等工作的核心思路),Bonsai 2 把它用到了端到端三值上。
为什么端到端三值以前做不到?难点在运行时:现有低比特推理内核针对标准 full-attention transformer,而 Qwen3.8-27B 是混合注意力架构(约 75% 线性注意力 + 25% 全注意力)。Bonsai 2 为这套混合骨干写了定制内核,在 Apple Silicon(MLX)和 CUDA 上直接对打包后的三值权重做矩阵乘,解包和组缩放融合在 GEMM 内部,全程不物化 FP16 权重——三值的内存带宽优势因此才能兑现。
实测吞吐:16 GB 笔记本跑 27B
白皮书给的跨平台数据(tg128 = 生成吞吐,pp512 = 提示处理吞吐):
| 硬件 | 打包格式 | 生成 (tok/s) | 提示处理 (tok/s) |
|---|---|---|---|
| RTX 5090 (32 GB) | PQ2_0 | 142.5 | 4121 |
| M5 Max 笔记本 | PQ2_0 | 46.8 | 765 |
| M5 Pro 笔记本 | PQ2_0 | 27.7 | 397 |
| M4 Pro 笔记本 | PQ2_0 | 18.0 | 125 |
M5 Pro 的 27.7 tok/s 对应约 201 GB/s 的权重流量,解码瓶颈在内存带宽上——这正是一切低比特量化的理论收益来源:模型越小,每生成一个 token 需要从内存搬运的字节数越少,解码越快。
两种打包格式各有取舍:PTQ1_0 位宽 1.76、体积 5.93 GB,极限压缩;PQ2_0 位宽 2.16、体积 7.25 GB,格式更简单、解包更便宜,RTX 5090 上生成吞吐反而更高(142.5 对 134.4 tok/s),提示处理差距更大(4121 对 1901 tok/s)。白皮书明确说「Neither format is uniformly faster」,按硬件特性选。
能耗数据同样可观:RTX 4090 上 0.714 mWh/token,PrismML 的测量结果比全精度 8B 模型低 40%。M5 Pro 跑 PQ2_0 长窗解码实测 GPU 轨 27 W、CPU+GPU 合计 32.8 W,也就是一台普通笔记本的散热能力完全覆盖。
质量保留在哪些维度
平均分之外,分项数据更有看头(thinking 模式,xhigh 推理档):
| 能力维度 | 基准 | Qwen3.8-27B | Ternary Bonsai 2 27B | Qwen3.6-27B |
|---|---|---|---|---|
| 数学 | AIME26/25, GSM8K, MATH-500 | 97.06 | 96.57 | 94.64 |
| 代码 | HumanEval+, LCB v6, MBPP+, BigCodeBench | 82.17 | 81.58 | 82.57 |
| 指令遵循 | IFBench, IFEval | 81.25 | 82.66 | 74.53 |
| 智能体/工具调用 | τ²-Bench, BFCL v3 | 79.74 | 77.57 | 80.05 |
| 知识推理 | MMLU-Redux, GPQA Diamond, AA-LCR | 83.95 | 86.66 | 84.71 |
| 视觉 | CharXiv, A-OKVQA, OmniDocBench v1.6, RealWorldQA, OCRBench v2 | 81.64 | 78.59 | 79.82 |
| 总平均(20 项) | 85.4 | 83.9 | 83.6 |
两个细节值得展开:
指令遵循是唯一反超全精度基线的维度(82.66 对 81.25),也明显高于上一代 Qwen3.6-27B(74.53)。压缩通常不会带来能力提升,一个合理解释是三值约束起了隐式正则化作用,让模型输出更贴合指令格式——这在量化研究中偶有报道,但归因还未定论。
长程智能体任务是这次的重点升级项。SWE-bench Verified 60.8、Terminal-Bench 2.1 得 52.8,约为全精度基线的四分之三(80.6 和 69.7)。这个保持率在激进压缩里是罕见的:白皮书直言,这个体积级别的模型在长程智能体评测里通常「fail to make any meaningful progress」,常规低比特量化则可能让智能体性能直接崩塌。τ²-Bench 从上一代 Bonsai 27B 的 73.6 提到 80.2,是系列内提升最大的一项。对于一个 5.9 GB 的模型,能维持多步工具调用的连贯性,意味着本地编码智能体(Cline 之类的工具循环)第一次有了够用的本地大脑。
已知短板
白皮书没有回避限制:batch size 1 下,激活侧的 Walsh–Hadamard 变换是解码路径上除矩阵乘之外最大的开销项,Metal 后端把它列为优化重点,CUDA 后端用整线程块并行缓解。这部分是纯实现成本,不影响输出质量,也是端侧解码延迟最直接的剩余优化空间。
评估口径上要注意:20 项基准全部在 H100 + vLLM 上以 thinking 模式、xhigh 推理档测得,采样用 Qwen3.8 推荐参数(温度 1.0、top-p 0.95、top-k 20)。自己部署时的体感分数会随推理档位变化,附录 C 有 medium 档的完整数据。
部署速览
权重已开放:GGUF(PTQ1_0 / PQ2_0 两种打包 + 4-bit 视觉塔)和 MLX(2-bit 组打包,8.49 GB 完整包)都在 Hugging Face prism-ml 组织下,Apache 2.0。llama.cpp 官方版本已合入三值内核支持;MLX 侧需要 PrismML 提供的自定义内核(Python 和 Swift 运行时同一套打包格式)。
- 16 GB 内存笔记本(Apple Silicon):MLX 或 llama.cpp Metal 后端 + PQ2_0,生成 18-47 tok/s(按芯片档次)
- 24 GB 显存 NVIDIA 卡:PTQ1_0 + CUDA 内核,或等社区 GGUF 重打包
- 32 GB(RTX 5090):PQ2_0 生成 142.5 tok/s,已接近可用作日常主力
262K 上下文由混合注意力架构原生支持,线性注意力层让 KV 缓存随上下文长度的增长远慢于标准 transformer,长文档场景(OmniDocBench v1.6 视觉套件里实测)是这套架构的舒适区。
回头看这份发布真正值得记录的点:53.8 GB 到 5.93 GB,9.1 倍压缩,98.2% 平均保留率,其中数学 96.57 对 97.06、代码 81.58 对 82.17——当压缩造成的分数损失收窄到 1 分以内,27B 级模型第一次被塞进了 16 GB 内存的日常笔记本,而这一级别的模型此前的最低门槛是 24 GB 显存。三值量化从研究论文走到 Apache 2.0 权重开放,这条路线的部署窗口已经打开。
来源: