Hacker News 一条 543 分的帖子标题是「Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s」。发帖人 snehesht 在评论里给出了自己的配置:RTX 4090、128GB DDR5 内存、Ryzen 7950X3D,实测输出速度 124 tokens/s。1250 亿参数的模型,在一张游戏显卡上跑出了比人阅读快一倍的速度。
这件事的承载者是 Niko1221/Strata,一个 MIT 协议的开源推理引擎,2026 年 9 月 24 日建仓,11 天拿了 1.08 万 star。它跑的模型是 Qwen3.8-Flash-Next:125B 总参数,每次前向只激活 6B,外加 51B n-gram 嵌入和 4B MTP 投机层。官方给的安装门槛是一张 12GB 显存的显卡(RTX 20 系到 50 系,或 AMD RX 7900 系)、32GB 内存、80GB 硬盘空间。
12GB 显存装不下 125B 模型的权重,这件事的解题思路值得逐层拆开看。
四层存储:每个组件都放在该放的地方
Qwen3.8-Flash-Next 是一个 512 个专家的 MoE 模型,每个 token 只会路由到 10 个专家(外加 1 个共享专家)。这个架构特性是 Strata 整个方案的支点:既然每个 token 只需要 2% 的专家,就没有必要把 100% 的专家都塞进显存。
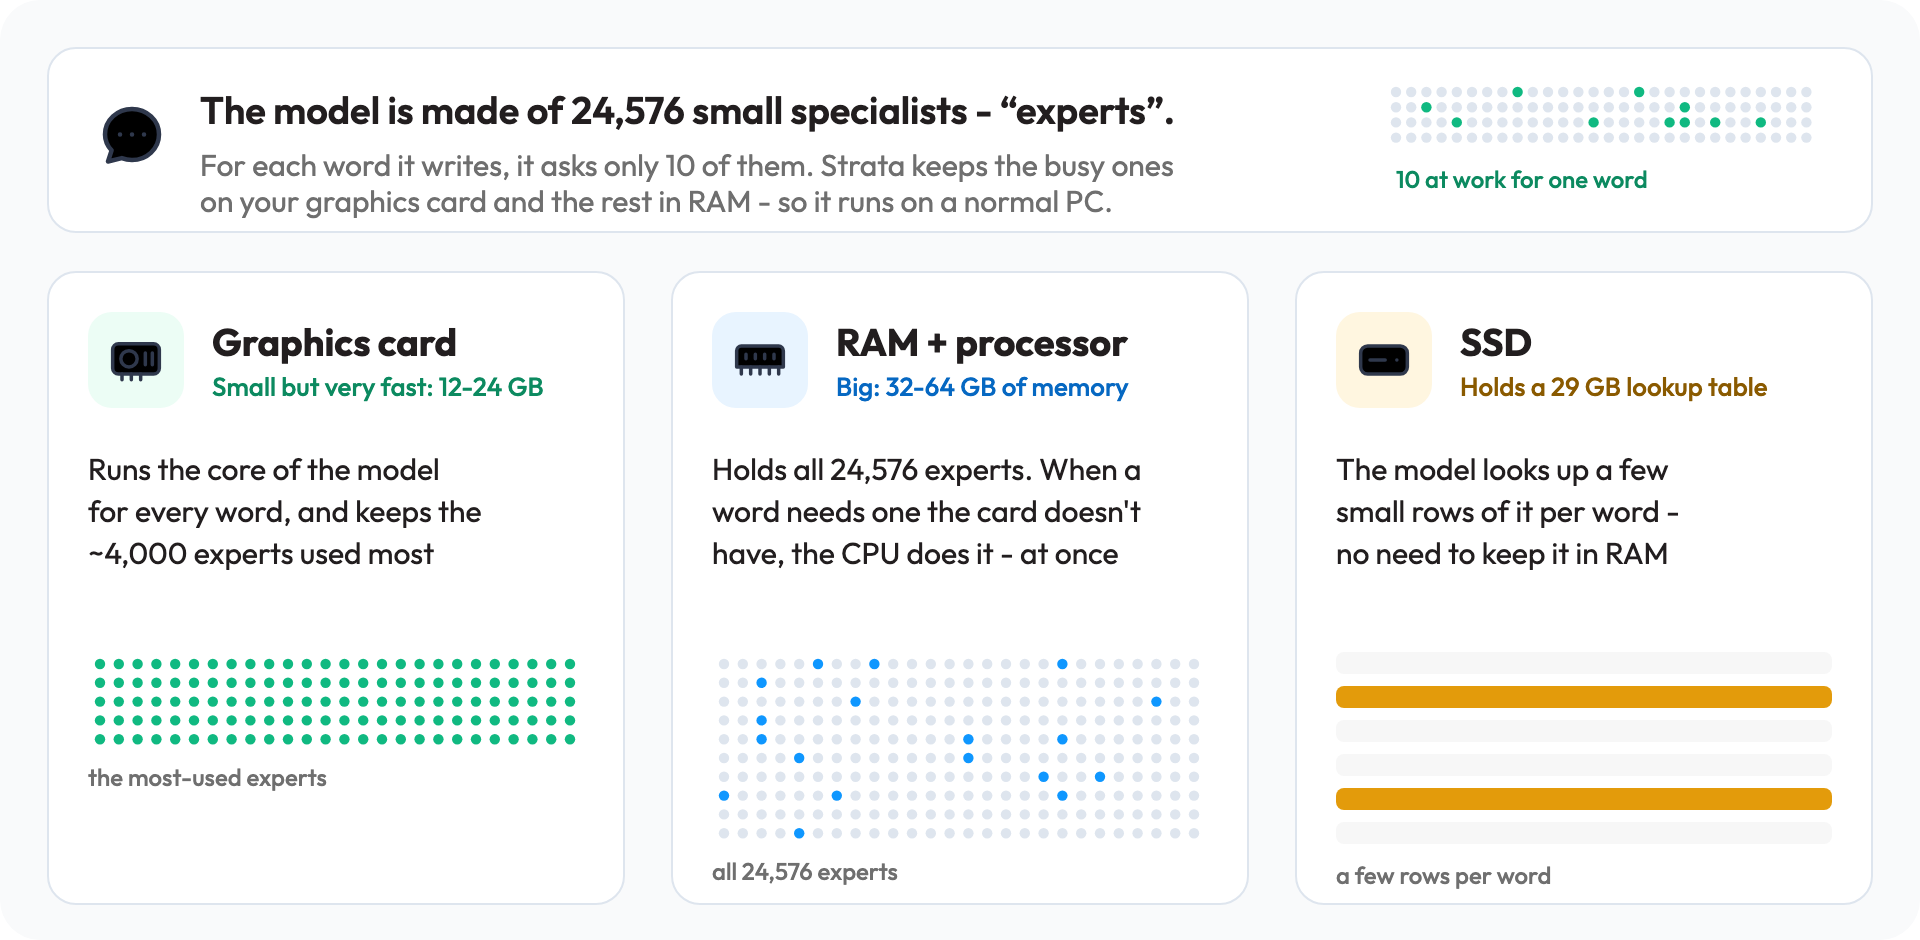
Strata 把整机当成一个分层存储系统来用:
| 层 | 放什么 | 为什么 |
|---|---|---|
| GPU 显存 | attention 与 DeltaNet 混合器、门控残差权重、路由器、共享专家、输出头、MTP 草稿层、KV cache,加上一个专家缓存(填充剩余显存) | 每个 token 都要过的计算放在最快的地方 |
| 内存 | 全部 24,576 个专家(pinned memory 锁页) | 保底:显存没命中的专家从这里读 |
| CPU | 就地计算内存中未被缓存的专家,与 GPU 并行 | CPU 算专家的同时 GPU 算别的,互不等待 |
| SSD | 28.8GB 的 n-gram 查找表 | 每个 token 只读几行 |
关键设计是专家缓存:显存里除了固定组件,剩余空间全部用来存「最近最常用」的几千个专家,并且在使用过程中持续学习当前会话的专家分布,动态替换。官方给出的数据是每多 1GB 显存,能多驻留约 700 个专家,而每一个驻留显存的专家,都是 CPU 不用算的一个。
CPU 侧用的是 AVX-512 / AVX2 内核(i-quant 量化格式用 ggml 的内核),内存中的专家就地计算,不做搬运。NVIDIA(CUDA)和 AMD(HIP)跑同一套引擎,分别编译。
速度从哪来:MTP 投机解码
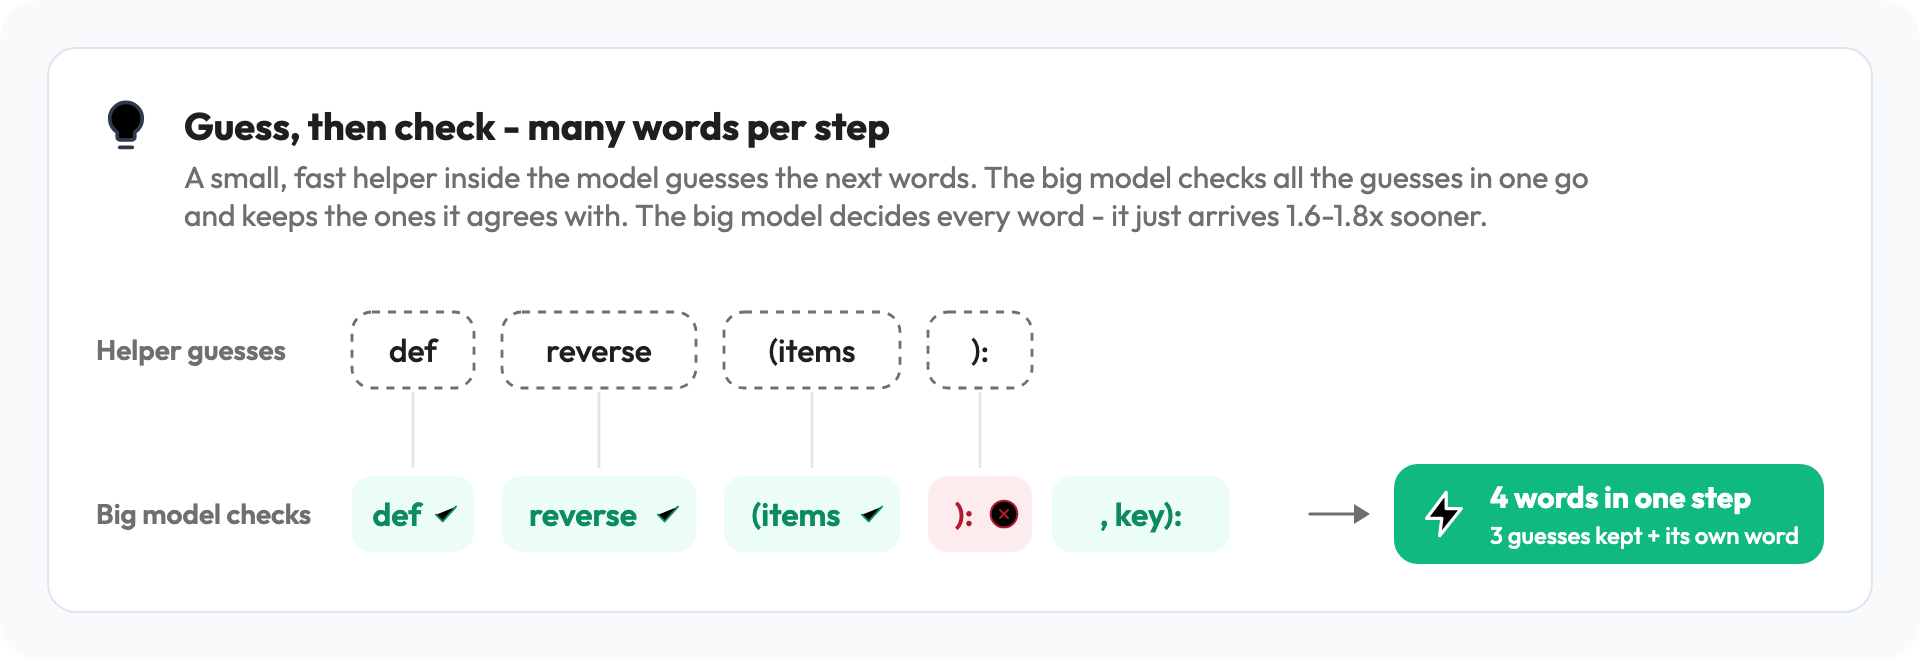
第二个速度来源是投机解码(speculative decoding)。模型自带的 MTP 层(multi-token prediction)一次起草最多 3 个 token,然后主模型对全部 48 层做一次前向,同时验证这 3 个草稿。平均每个前向产出 2.4 到 3.2 个 token。因为草稿的验收标准就是主模型自己的判断,拒绝草稿重写的输出与普通前向逐位一致,质量不变,速度提升 1.6 到 1.8 倍。
在代码编辑、引用原文这类「回复大量重复上下文」的场景,Strata 还启用了 prompt lookup:从上下文里找重复片段直接起草最多 5 个 token。这个策略按实测收益开关,只在代码编辑场景(提速 6-11%)启用,普通文本不开。
长文本的读入也有专门处理:prompt 按 8,192 token 一块分批处理(可手动调到 32,768),当前层的 attention 在 GPU 上跑的同时,下一层的专家经 PCIe 预取。32K 的文档读入速度在 1,600 到 2,600 tokens/s 之间(取决于量化档位)。
实测速度表
官方在两张「普通游戏 PC」上测了完整矩阵:RTX 5070(12GB)+ Ryzen 5 7600 + 64GB 内存,以及 RX 9070 XT(16GB)+ Ryzen 9 3900X + 47GB 内存。测试条件是代码 agent 类 prompt、256 个生成 token、MTP 开启:
RTX 5070 12GB 输出速度(tokens/s)
| 量化档位 | 1K 上下文 | 4K | 32K | 64K | 128K | 262K |
|---|---|---|---|---|---|---|
| Q2_0 | 87.3 | 93.0 | 81.8 | 76.2 | 73.7 | 60.3 |
| IQ2_XS | 79.6 | 78.6 | 76.3 | 63.7 | 62.7 | 52.8 |
| IQ3_XXS | 61.9 | 61.6 | 58.5 | 57.2 | 49.0 | - |
| IQ3_S | 52.4 | 53.3 | 48.3 | 46.3 | 45.5 | - |
| Coder | 58.9 | 55.1 | 54.9 | 53.2 | 43.0 | 42.8 |
RTX 5070 12GB prompt 读入速度(tokens/s)
| 量化档位 | 1K | 4K | 32K | 64K | 128K | 262K |
|---|---|---|---|---|---|---|
| Q2_0 | 536 | 1,299 | 2,171 | 2,126 | 2,107 | 1,304 |
| IQ2_XS | 534 | 1,256 | 2,092 | 1,754 | 1,752 | 1,181 |
| IQ3_XXS | 482 | 1,007 | 1,745 | 1,609 | 1,602 | - |
| IQ3_S | 427 | 913 | 1,624 | 1,640 | 1,443 | - |
| Coder | 656 | 1,583 | 2,177 | 2,236 | 2,208 | 1,034 |
拆掉营销滤镜看数字:Q2_0 档在 4K 上下文输出 93 tokens/s,实际使用中回复几乎是即时流出的;262K 满上下文(259,943 token 的 prompt)下 Q2_0 仍有 60 tokens/s 输出和 1,304 tokens/s 读入;AMD 卡速度约为 NVIDIA 的三分之二,可用性没有问题。
发帖人的 RTX 4090(24GB)+ 128GB 内存实测 124 tokens/s,与官方「RTX 3090(24GB)约 100-140 tokens/s」的估计一致。显存越大,能驻留的专家越多,CPU 的工作越少,速度越接近纯 GPU 推理。
量化选型:一张表对号入座
Strata 用的是 ISTA-DASLab 的 GSQ-RCO 量化系列,安装器按内存推荐档位:
| 你的内存 | 推荐档位 | 说明 |
|---|---|---|
| 32GB | Coder | 唯一能塞进 32GB 的选择,专攻代码 |
| 48GB | IQ2_XS 或 Q2_0 | 更大档位放不下 |
| 64GB | IQ2_XS(推荐)/ IQ3_XXS / IQ3_S | 全部可用,IQ3_S 质量最好也最慢 |
| 96GB+ | IQ3_S 或 Unsloth UD-IQ4_XS(约 4bit) | 富余 |
其中 Coder 是个特殊的变体:ISTA-DASLab 把每层 512 个专家剪到 256 个(保留 10 个激活/ token 的机制不变),用 RCO 方法在代码、agent 和视觉数据上选专家。作者报告它保留了完整模型 91.3% 的 SWE-bench Verified 成绩和 98.7% 的 LiveCodeBench v6 成绩,但换来了 32GB 内存可跑的准入门槛。代价是非代码能力(包括中文等 CJK 文本)明显变弱,仓库 issue #438 有记录。
另一个变体 Swift 1.5 是 UkisAI 的微调版,把思考 token 砍掉 63%,出答案快 1.8 倍。作者报告准确率损失不到 1%;Strata 团队自己做了个 8 题小测试:两版全对,Swift 1.5 用 1,234 个 token / 28 秒,原版 2,682 个 token / 46 秒。
使用形态:本地 API 服务器
装完之后 Strata 在 127.0.0.1:8080 起一个服务,暴露三种接口:
- OpenAI 兼容:
/v1(任意 API key、任意模型名都能过,对接各类客户端零改造) - Anthropic 兼容:
/v1/messages(Claude Code 设ANTHROPIC_BASE_URL即可接入) - OpenAI Responses API:
/v1/responses(Codex CLI 用)
还内置 MCP 服务器,让 Claude Code 这类 agent 直接管理 Strata 的启停和模型切换。README 甚至提供了一个反向安装:把仓库地址丢给你的 AI 编码助手,让它读 docs/AI_SETUP.md 替你装好。图片输入可选(AMD 卡在 Windows 上暂不支持视觉,Linux 走 CPU 路径)。默认单请求串行,"parallel": 2 可开并发,12GB 卡上并发会摊薄每个请求的速度。
第一次启动会把 35-55GB 权重加载进内存并锁页,期间机器卡顿 1-3 分钟,README 把这条写在了最显眼的位置。
HN 评论区的两个质疑
543 分的帖子自然有较真的声音。有人问「这些量化模型的有效智能有没有人算过」,认为量化版本的 benchmark 应该成为标配披露项。也有人直接怀疑「这类仓库是不是让 Claude 把 KV cache 偷偷量化到了 q4」——README 确实没写 KV cache 精度(DETAILS.md 提到 4K 以上用 8-bit KV,64K 以上只保留最常读部分在显存,其余从内存流式读取,但没有 Q4 字样)。在 AI 生成代码占比越来越高的当下,这类「引擎做了什么手脚才能跑这么快」的质疑会持续存在,官方论文(docs/paper/Strata-Paper.pdf)是回应这类问题的第一入口。
另一个务实的声音:与其关注 128GB 内存机器上的极限速度,不如看看 8GB 内存的 Chromebook 和手机能跑什么。这正好是 Strata 的边界:它的方案需要 32GB 内存起步,把 125B 模型送进游戏 PC,而不是送进所有设备。
与其他「大模型上小设备」路线的对比
本地推理社区这两年在「存储墙」上打出了几条不同的路线,本博客此前覆盖过几例:
- colibri(744B 模型喂一块 NVMe):把整卡赌在 SSD 直读上,适合极端参数量,速度受存储带宽硬顶;
- ESP32 菊花链跑 BitNet 1.58-bit:把模型量化到 1bit 量级换取端侧准入,牺牲的是模型能力上限;
- Strata:利用 MoE 的稀疏激活特性,把「常驻显存」换成「分层调度」,在 12GB 显存 + 64GB 内存的常见游戏 PC 配置上换到了最大的模型能力。
三条路线的公共前提是:模型的架构红利(MoE 稀疏性、1bit 权重、n-gram 参数)比推理引擎的工程优化更有杠杆。Qwen3.8-Flash-Next 官方 model card 里「51B n-gram 嵌入」这一行参数需要单独展开:把五分之二的总参数放进一个只需查表的嵌入结构里,既压了激活计算量,也让这部分参数天然适合卸载到最慢的存储层。Strata 的 28.8GB n-gram 查找表对应的正是这部分。
对有 12GB 显存游戏 PC 的人来说,这是一份可以今晚就跑起来的 125B:clone 仓库,双击 START-HERE.bat(Linux 跑 ./setup.sh),回答几个问题,等 70GB 下载完,localhost:8080 就是你的 Claude 兼容 API。
来源:Niko1221/Strata GitHub 仓库(README / docs/HOW_IT_WORKS.md / docs/DETAILS.md)· Qwen3.8-Flash-Next model card · Hacker News 讨论