标签: Kimi
清除筛选
Kimi K2.7 Code高速版上线:2倍价格换6倍速度
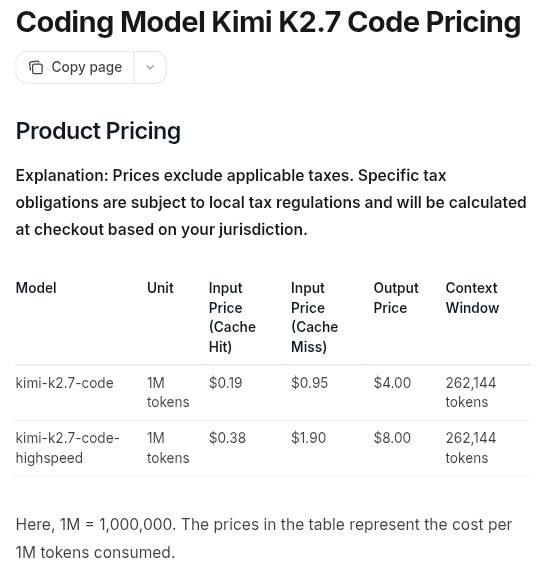
月之暗面(Moonshot AI)6月15日正式上线 Kimi K2.7 Code 高速版(HighSpeed)。同一个模型,输出速度提升5到6倍,价格翻倍。中位数长度输入下可达约180 token/s,短上下文场景最高约260 token/s。 Kimi K2.7 Code 定价 高速版定价 根据 Kimi API 开放平台的定价页面,两个版本的具体价格如…
Kimi K2.7 Code 开源:代码基准全面提升,token 消耗降 30%
K2.7 Code 解决的核心问题 K2.6 的长程编程任务有两个痛点:指令遵循在长上下文中衰减,以及过度思考导致 token 浪费。K2.7 Code 针对这两个问题做了定向优化——指令遵循能力提升,平均 token 消耗减少 30%。 Kimi K2.7 Code 发布并开源 基准测试表现 代码能力方面,K2.7 Code 相比 K2.6 全面提升:Ki…
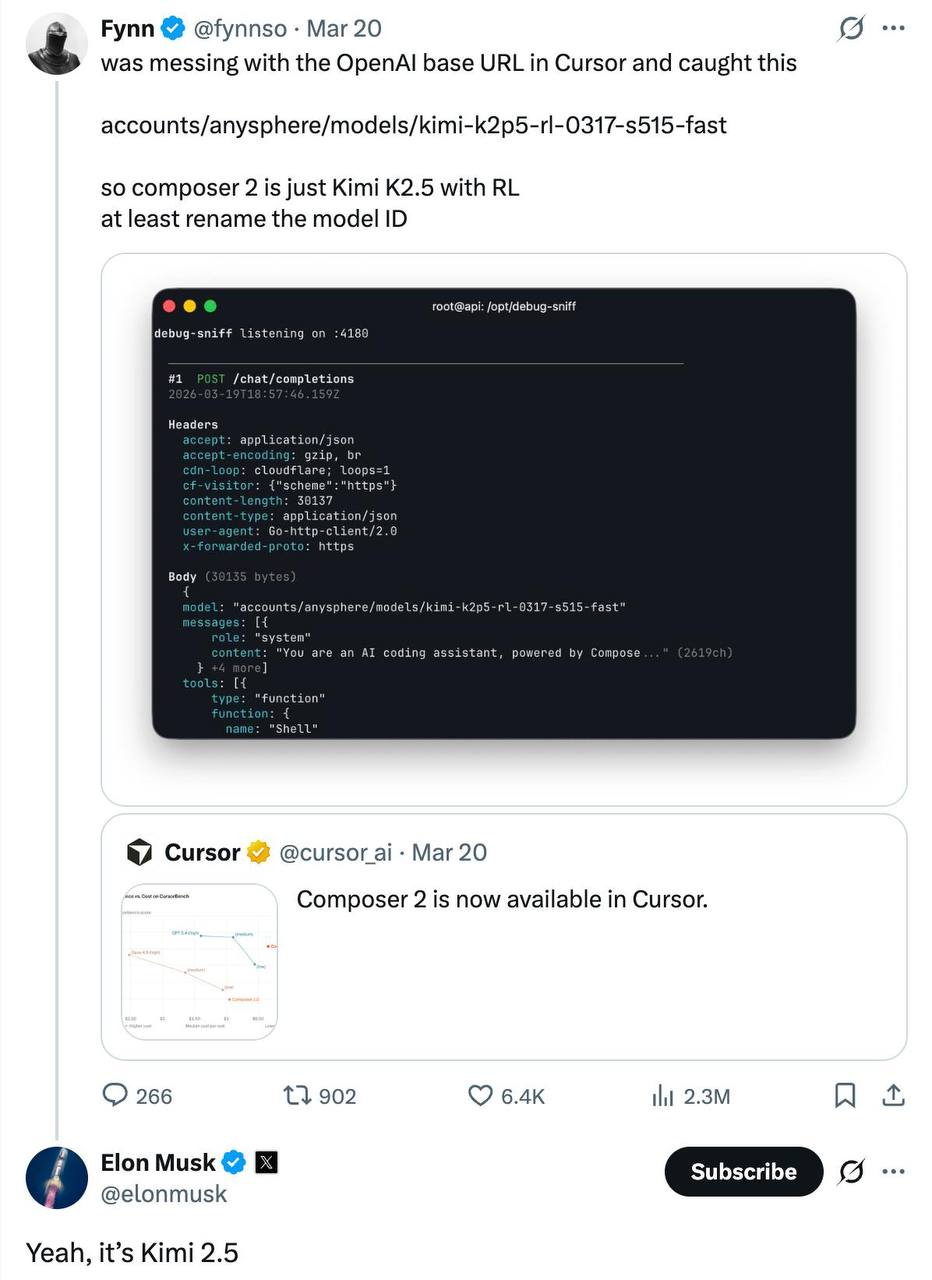
Cursor Composer 2 被扒出底座是 Kimi K2.5,署名争议随之爆开
Cursor Composer 2 与 Kimi K2.5 争议截图 3 月 19 日,Cursor 发布 Composer 2,主打前沿级编码性能,并把价格压到每百万输入 token 2.5 美元。官方公告的重点是性能、强化学习训练和更低成本,整篇都在把它包装成 Cursor 自家的新一代编码模型。 但这层包装没有撑太久。 开发者 Fynn 在调试 Com…
月之暗面改了 Transformer 的残差连接,48B Kimi Linear 跑出约 1.25 倍等效算力优势
月之暗面改了 Transformer 的残差连接,48B Kimi Linear 跑出约 1.25 倍等效算力优势 月之暗面最近放出的 Attention Residuals 技术报告,把注意力放回到了 Transformer 里一块更基础的结构:残差连接。它关心的重点,不是参数量和上下文长度,而是层与层之间的信息怎么传。 论文的核心做法,是把标准残差里“前…