2026 年 10 月 12 日,智谱发布法律专用模型 GLM-Legal。在 Harvey 出品的法律智能体基准上,它拿下 19.2% 的 all-pass 通过率,比基座模型 GLM-5.3-Flash 高出 12.5 个百分点;作为对照,Claude Opus 5.5 在同一个基准上的成绩是 4%。发布当天,这条消息在 Hacker News 上冲到 475 分、270 多条评论,讨论的焦点却不在分数本身,而在一个更根本的问题:一个只考出 19.2% 的模型,凭什么算前沿水平?
19.2% 是什么水平
Harvey LAB 是法律科技公司 Harvey 搭的智能体基准,从真实律所工作流里取材,覆盖 24 个执业领域。它的评分规则叫 all-pass:一份法律交付物要过全部检查项才算通过,任何一项不合格就是零分。这和常见 benchmark 里"每个小题给个分再加总"的算法完全不同,分数天然被压得很低。
官方公布的对比数据里,GLM-Legal 三项成绩分别是:Harvey LAB 19.2%,LegalBench 86.2%,PLawBench 77.3%。基座模型 GLM-5.3-Flash 对应为 6.7%、83.9%、73.8%。同一张官方图表上,Kimi K3 在三个基准上是 12.9%、86.2%、76.2%,Claude Fable 5 是 11.3%、88.6%、77.7%,GPT-6 Astra 是 5.4%、87.1%、69.1%。在 Harvey LAB 这一项上,GLM-Legal 的 19.2% 排在所有公开对比模型之前,领先第二名 Kimi K3 超过 6 个百分点。
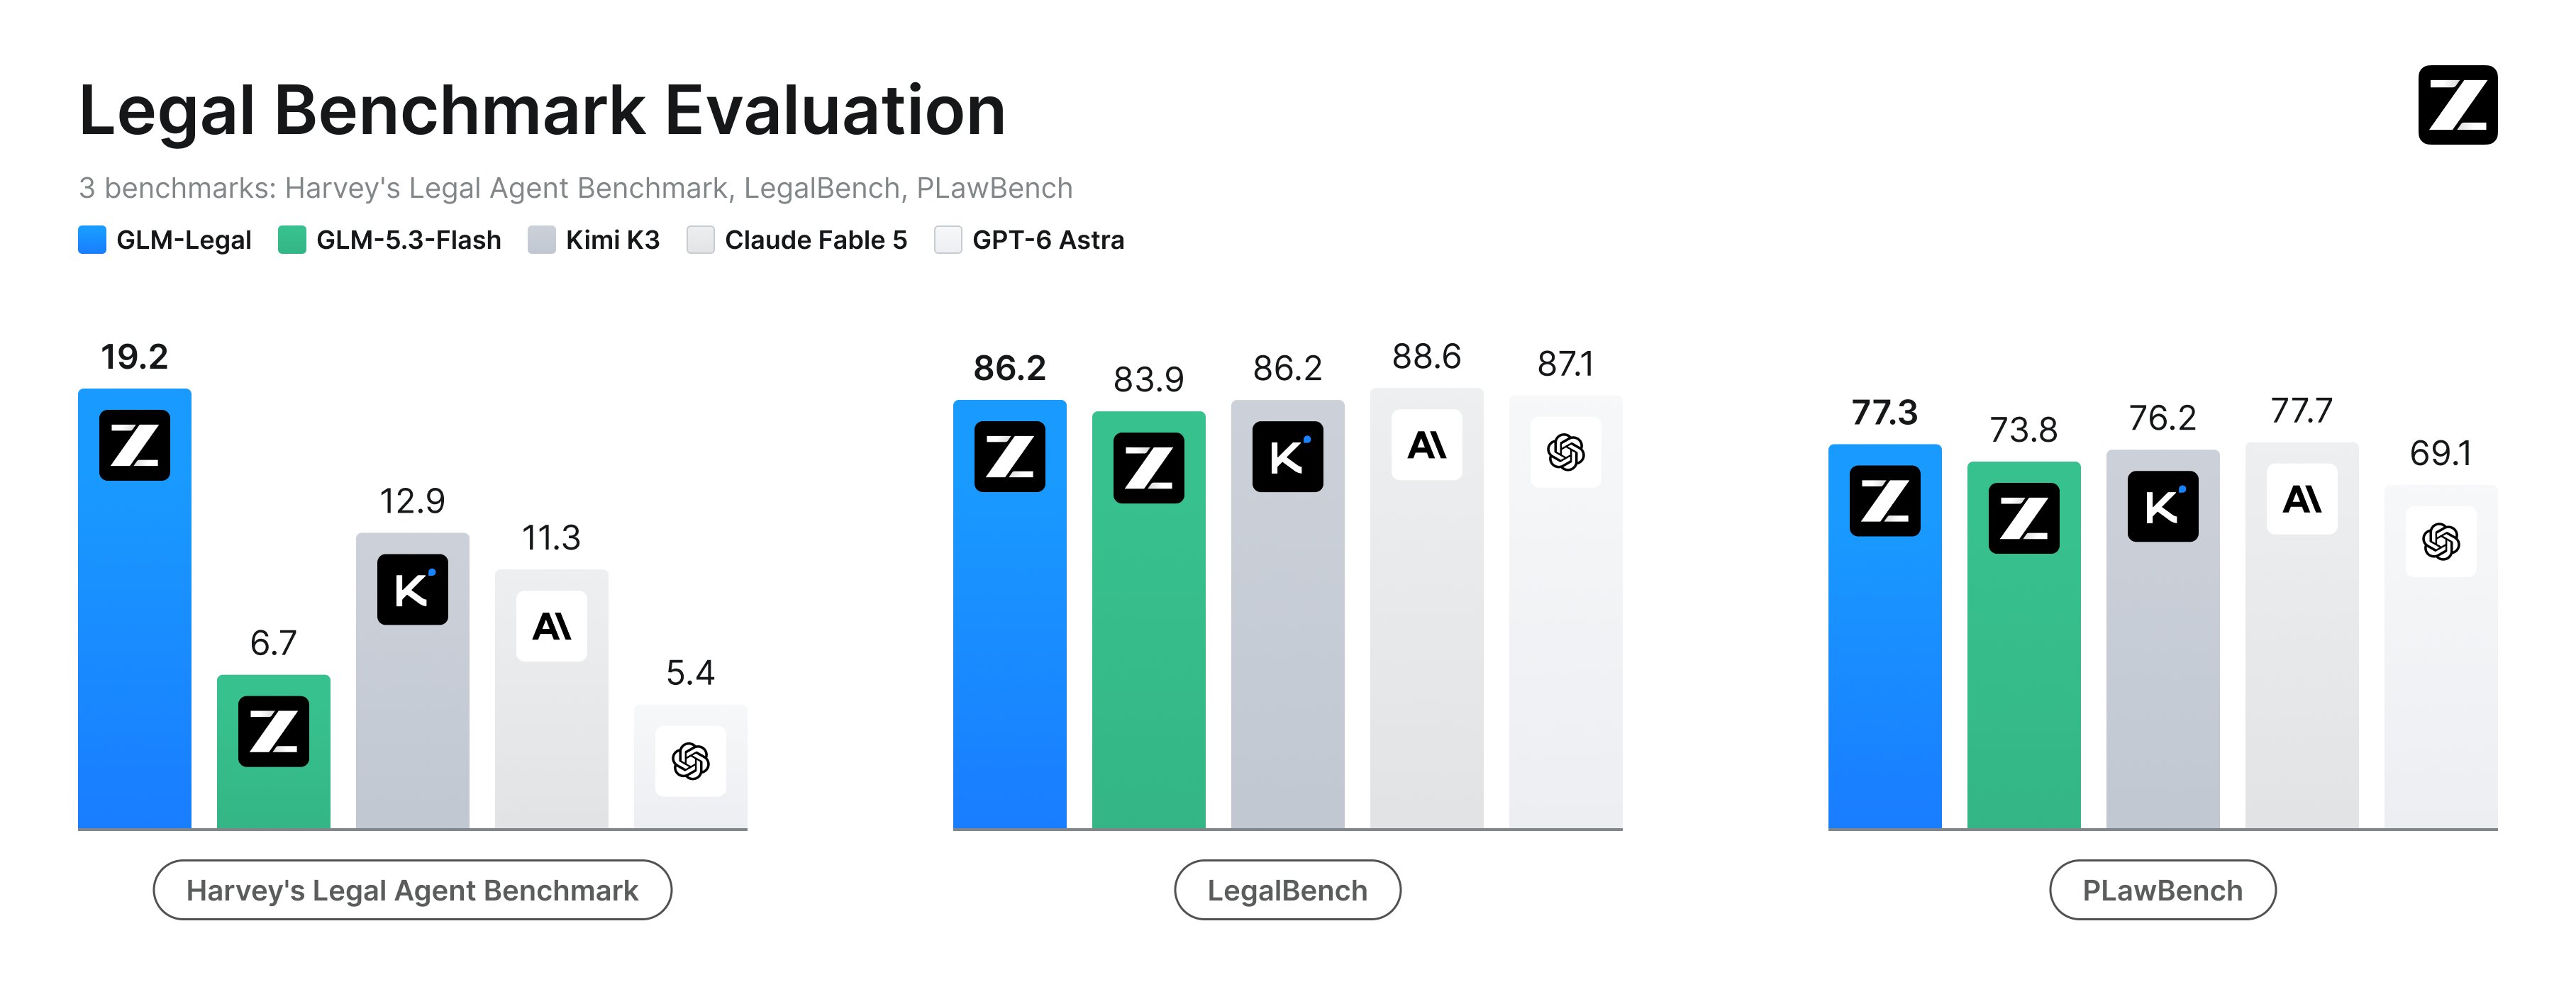
LegalBench 和 PLawBench 的格局则是另一番样子:四家模型的成绩挤在 76% 到 89% 的窄带里,差距以个位数计。这组对比透露出一个结构性信息:静态知识型考试(法条、合同条款、判例分析)对前沿模型已经接近饱和,真正的分水岭在多步智能体任务上,模型要读文件、建论证链、按交付规范产出成品,中间任何一步走偏都会被 all-pass 规则判零。
HN 上一位署名 otterley 的执业律师对 19.2% 这个数字不买账:"诉讼实务的关键是为新情况做准备,而不是重新打已经打过的官司。80% 的未通过率说明自动化还有很长的路。"另一位用户 ctolsen 补充了对照信息:在这个特定基准上,20% 几乎高于所有已有模型,同价位段里没有对手。两种说法都成立,分歧只在参照系:以人类律师的标准看,19.2% 很低;以机器过往的成绩看,这是第一次有模型在这个基准上过 15%。
垂直模型的三层训练管线
GLM-Legal 的基座是 GLM-5.3-Flash,一个主打推理效率的轻量模型。官方博客把训练拆成三层:
第一层是领域中期训练(mid-training)。在预训练完成之后、对齐训练之前,用扩量后的高质量法律语料再训一轮,让模型在密集的领域上下文里吸收法律概念、成文规则和解释框架,补齐事实、规则、结论之间的演绎链条。
第二层是强化学习后训练,环境是数万个模拟真实法律工作流的训练场景。模型在场景里练习规划分析路径、推进工作流、在具体约束下生成交付物。这一层的特别之处在于官方所称的 harness(运行时编排框架)与模型同步迭代:训练中暴露的边界案例反过来指认 harness 的架构瓶颈,harness 的改造又给模型制造更接近生产的执行约束。模型和脚手架互为对方的训练信号。
第三层是生产反馈回路。法律从业者按四条标准评估产出:关键问题和边界案例是否都覆盖、论证是否有依据且引用站得住、交付物是否严格遵循委托简报、下游团队能否不经返工直接使用。官方把这四条转成工程损失信号,出问题时沿整条执行管线排查,分离原始模型能力、上下文投喂和工作流逻辑各自的贡献,再把结论灌回下一轮训练的任务环境和评分细则。
这套写法的值得留意处在于顺序:先承认通才模型在专业任务上不够用,再把缺口归因到执行管线而非单纯的知识量。同样基于 GLM-5.3-Flash,只动 mid-training 语料和 RL 环境,Harvey LAB 就从 6.7% 涨到 19.2%,近三倍的提升没有换基座。垂直能力的增量主要来自数据和训练环境的组织方式,这是这篇技术报告里最可复用的结论。
官方案例里的能力差在哪
官方给了三组 GLM-5.3-Flash 与 GLM-Legal 的同题对比,恰好对应三种典型法律工作。
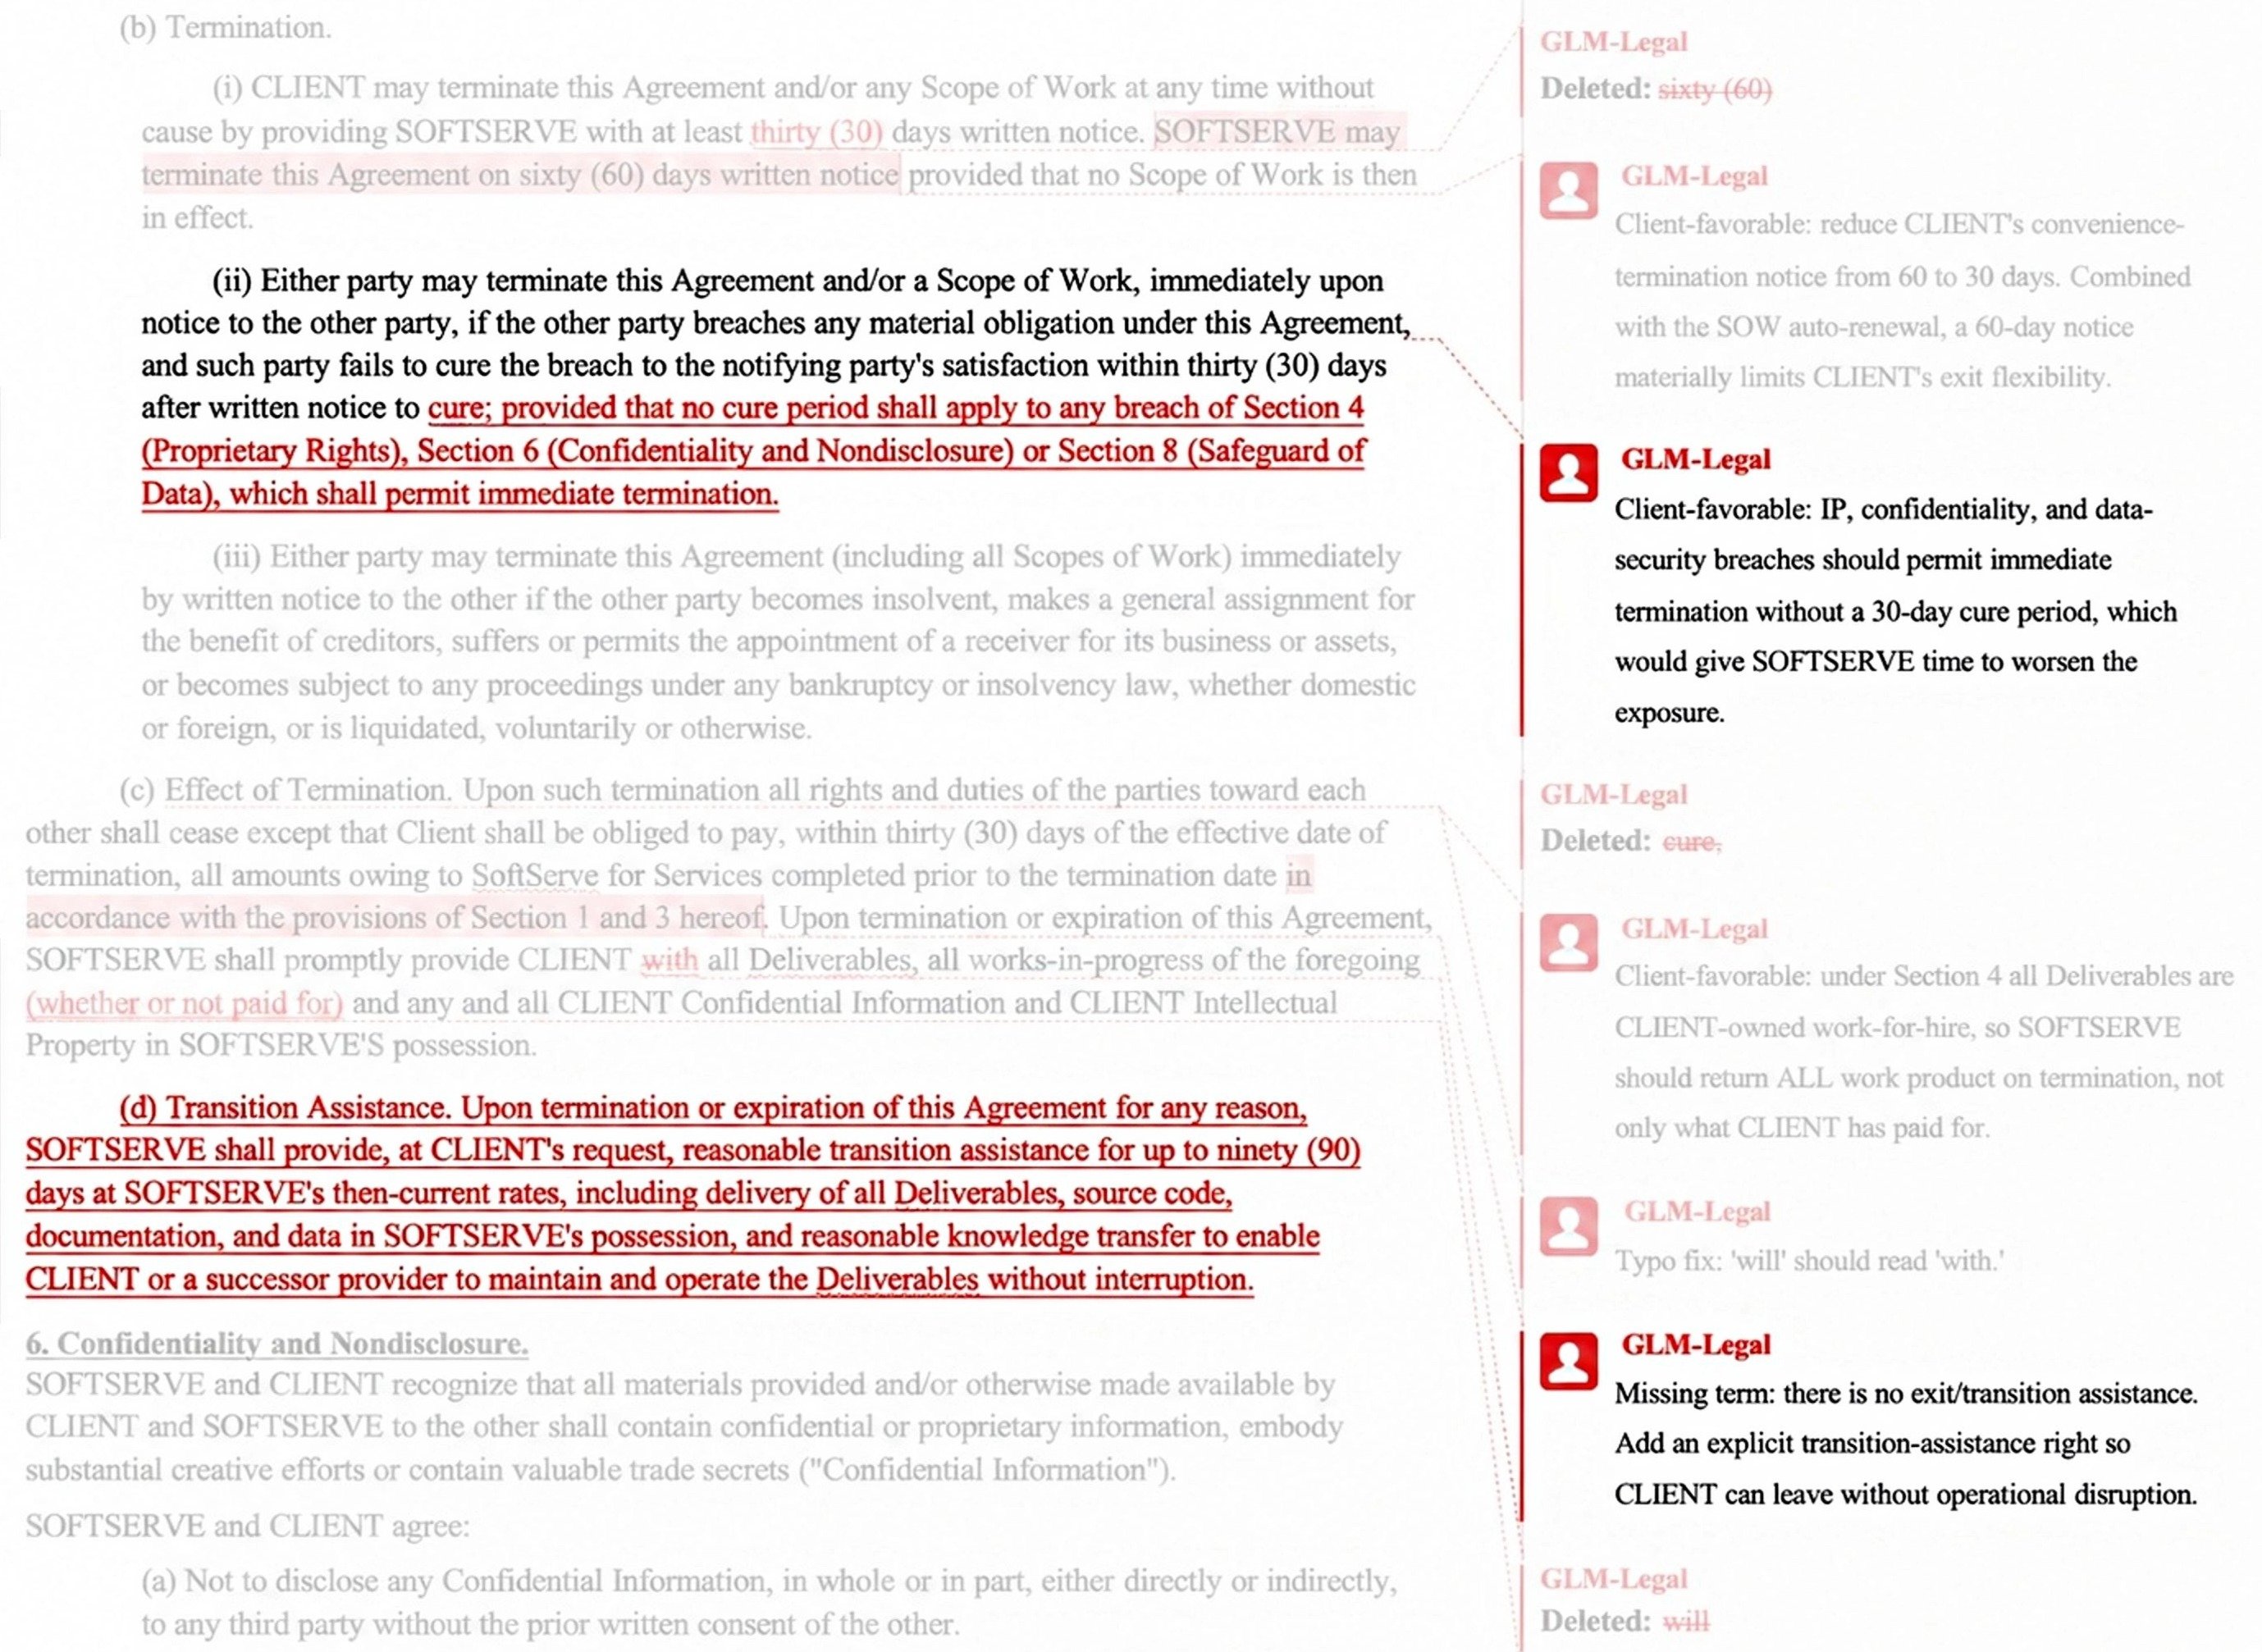
合同审查场景里,任务是从服务商更换的角度审一份软件服务合同,重点是终止与交接条款。基座模型给出的是通用建议:终止通知期 60 天偏长、可以考虑缩短,终止后应要回已付费的交付物。GLM-Legal 的输出直接落到改条款:把便利终止通知期从 60 天压到 30 天;删除知识产权、保密、数据安全违约情形下的 30 天补救期,实现即时终止;交付物返还范围从"已付费的"扩大到全部工作成果;新增最长 90 天的过渡协助义务,覆盖源码、文档、数据交接。从"建议方向"到"可直接写进修订稿的条款文本",两者隔着一整个工作流层级。
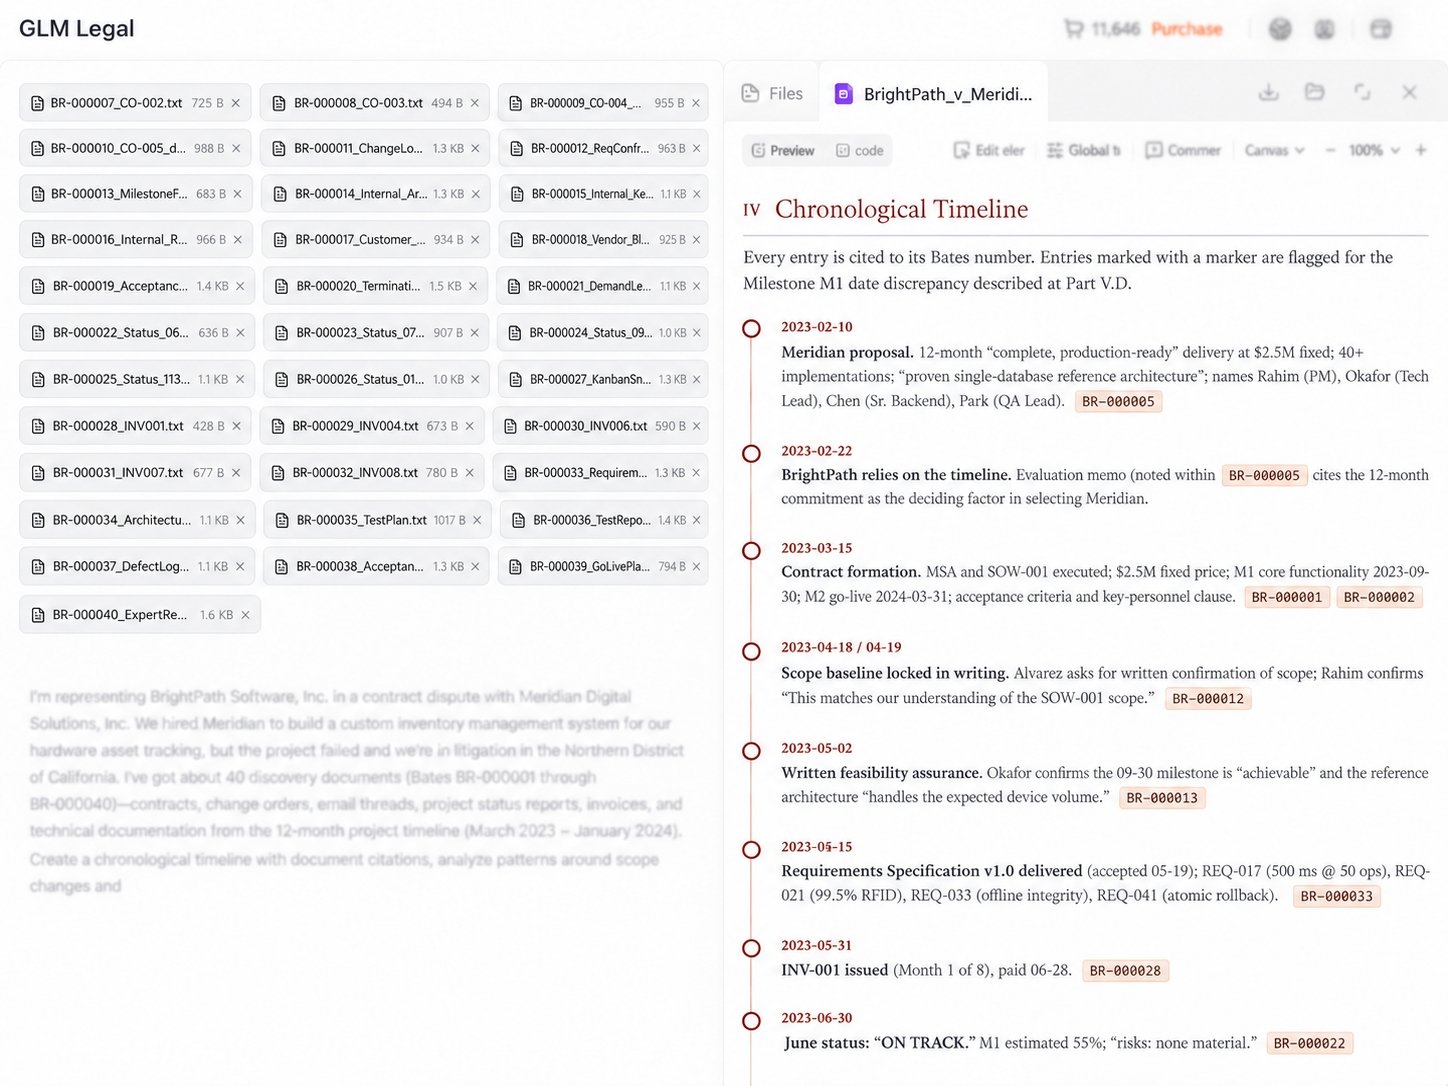
证据分析场景里,任务是读 40 份软件项目纠纷文件,找出进度报告里的矛盾。基座模型找到了矛盾:客户报告称进度 60%,内部快照约 41%。GLM-Legal 多做了三步:把 9 月 30 日的"按进度"报告与 9 月 8 日"里程碑无法如实达成"的内部预警并置;用 CEO"压下风险、继续开票"的指示把知情与披露决策连成因果链;引用主服务协议第 2、5 条说明继续付款不构成权利放弃,担保在付款后仍然存续。它给的是一个有文件编号引证的隐匿理论框架,还明确标注哪些是事实、哪些是待验证的推断。官方发布的运行截图里,这个流程是一个完整的工作台:左侧挂着全部 40 份带 Bates 编号的证据文件,右侧输出按时间线组织、每条陈述都挂引证标记的备忘录。
合规研究场景里,任务是为一个在新加坡、马来西亚、印尼三地上线的网站规划隐私合规。基座模型给的是通用清单:发布隐私声明、检查 Cookie 同意、营销邮件加退订。GLM-Legal 按 P0 优先级输出行动项,每条带具体法条引用:新加坡 PDPA 第 26 条、马来西亚 PDPA 第 129 条、印尼 PDP 法第 55 至 56 条,外加同意记录留存、营销许可与注册分离、退订请求进 suppression list、供应商数据目的地映射等可执行细节。
三个案例的共同点是输出形态的变化:从概述到带引证的操作文本。官方把这个方向称为 Professional Cowork:模型不再停在单轮问答,而是接手一条完整的专业工作流。
分数之外的争议
HN 上 270 多条评论,技术之外吵的是两件事。
第一件是闭源。多位用户确认 GLM-Legal 不开放权重,只提供 API。一条高赞评论算了一笔账:基座是 GLM-5.3-Flash,如果放权重,约 1.4 万美元的硬件就能自托管;不放权重,"对法律用途来说完全 DOA"。逻辑是行业性的:律所的客户保密义务和跨境数据规则,让"把合同传给境外 API"在采购环节就过不了关。也有用户反驳说 Meta 的旗舰模型同样只是"名义开放",开源与否不该是单一评价轴。这和 OpenAI、Anthropic 的路线其实是同一个趋势:能力垂直化的模型,商业上更倾向闭源。
第二件是基准本身的质量。有用户翻出 Harvey LAB 的公开 issue 列表,指出其 firm knowledge 任务子集存在多处有问题的任务和评分细则,并贴出了具体编号。还有人质疑训练集不公开带来的污染风险:如果训练任务里混入了与测试任务相似的内容,19.2% 的含金量就存疑。all-pass 评分制也被批评:一个模型可能满足了 93% 的要求,只因撞上几道有缺陷的题,all-pass 就把它压到 20% 以下。这些批评没有推翻结果,但把"19.2% 意味着什么"的解读区间收窄了不少。
垂直模型这条路的信号
把 GLM-Legal 放回更大的图景里看,它标志的是一条路线的验证:在通才模型竞争白热化的当口,用领域 mid-training 加场景化 RL,在轻量基座上做出单个专业领域超越旗舰的成绩。轻量基座意味着推理成本可控,专业能力意味着溢价空间,这对算力预算有限的团队是可复制的配方。
这条路线的边界同样清楚。法律场景的最终交付物需要执业律师签字背书,模型的输出停在"草稿质量高、引证可核查"这一层;官方自己的展示里,成品也是带着修订痕迹和批注交给人工审阅的。19.2% 的 all-pass 通过率既是营销亮点,也是现状的诚实刻度:每五份完整交付任务,模型能独立过全检的不到一份。垂直模型的商业逻辑建立在这两者之间:把律师从初稿劳动里解放出来,把签字权留给律师。
官方博客同时预告这些能力将进入 AutoClaw(其桌面智能体平台),API 走申请制。基准会随时间被更多模型刷过,但"专业工作流当作训练环境"这个思路,大概率会出现在后续各家实验室的下一份技术报告里。
来源:
- GLM-Legal: Advancing Agentic Legal Intelligence(z.ai 官方博客,2026-10-12)
- Hacker News 讨论(475 分,273 条评论)
- 数据核对说明:文中全部基准数字取自官方博客发布的对比图表;Opus 5.5 在 Harvey LAB 得 4% 的说法来自 HN 用户 ctolsen 的评论,官方图表未包含该模型