神经网络内部是打结的毛线团,还是摆放整齐的工具箱?这个问题在可解释性(interpretability)研究圈里争论了将近十年,结论决定了一整个研究方向的存在理由。2026 年 10 月 15 日,Goodfire 联合创始人 Nick Cammarata 发布长文 Neural Networks Are Already Clean,给出的答案是:网络内部本来就没有打结,过去十年被当作「黑盒证据」的经典案例,多数是工具、架构和误读造成的假象。这篇 65 分钟阅读量的长文在 Hacker News 上拿到 574 分,Techmeme 当天转载,作者本人就是十年前参与提出「叠加假说」的人之一——现在他亲手把这套假说从默认位置上拉了下来。
十年公案:多义神经元与叠加假说
争论的起点是 2020 年 Distill 上的 Zoom In: An Introduction to Circuits。这篇论文展示了一个 InceptionV1 神经元,它同时响应猫脸和汽车正面——两个看起来毫无关系的概念挤在同一个神经元里。研究者给这类现象起了名字:多义性(polysemanticity)。
多义性背后的解释是什么?主流解释是叠加(superposition):当网络要表达的特征数量超过神经元数量时,它会把互不相关的概念折叠进同一个神经元,因为这些概念很少同时激活、不会互相干扰。如果叠加假说成立,网络内部就是一团随机缠绕的结,想研究它必须先「解开」——具体做法是训练第二个模型(通常是稀疏自编码器,SAE)去近似「解开之后」的网络,然后研究这个替代品。
这条技术路线在过去四年吸引了大量资源。Anthropic 的 Towards Monosemanticity(2023)和 Scaling Monosemanticity(2024)、OpenAI 的 Scaling and Evaluating Sparse Autoencoders(2024)都属于这一脉。2023 年 Anthropic 的小模型实验里,按他们的评分标准,中位数神经元得分是 0(满分 14)——评分员连一个假设都提不出来。Cammarata 自己在 OpenAI 启动的自动化可解释性项目,用最宽松的标准也只找到约 1.7% 的可解释神经元。
这些数字构成了行业共识:神经元本身不可读,必须借助重构工具。Cammarata 的新论文要推翻的正是这个共识的地基。
证据一:InceptionV1 的末层不是死结,是 architecture 问题
论文的第一个证据来自对老案发现场的重访。InceptionV1 末层曾被估计「几乎没有任何可解释神经元」(有人估 5%,Cammarata 自己当时的记忆接近 0%)。作者用四种条件做了对照:
| 条件 | 末层可解释神经元比例 |
|---|---|
| 2014 年原版 InceptionV1(当时的工具) | ~0-5% |
| 同一网络 + 修复后的可视化工具 | ~50% |
| 同一架构 + 现代正则化重新训练 | ~70% |
| 参数量相同的 ConvNeXt | ~99% |
模型规模没变、训练数据没变,只换了残差连接、LayerNorm 这些为「学得更好」设计的普通架构改进,末层神经元就达到 99% 可读,而原版在同一工具下几乎完全不可读。这些改进的设计者对可解释性毫无兴趣——残差流是为了训练更深的网络,但它同时让深层概念结构变得清晰。
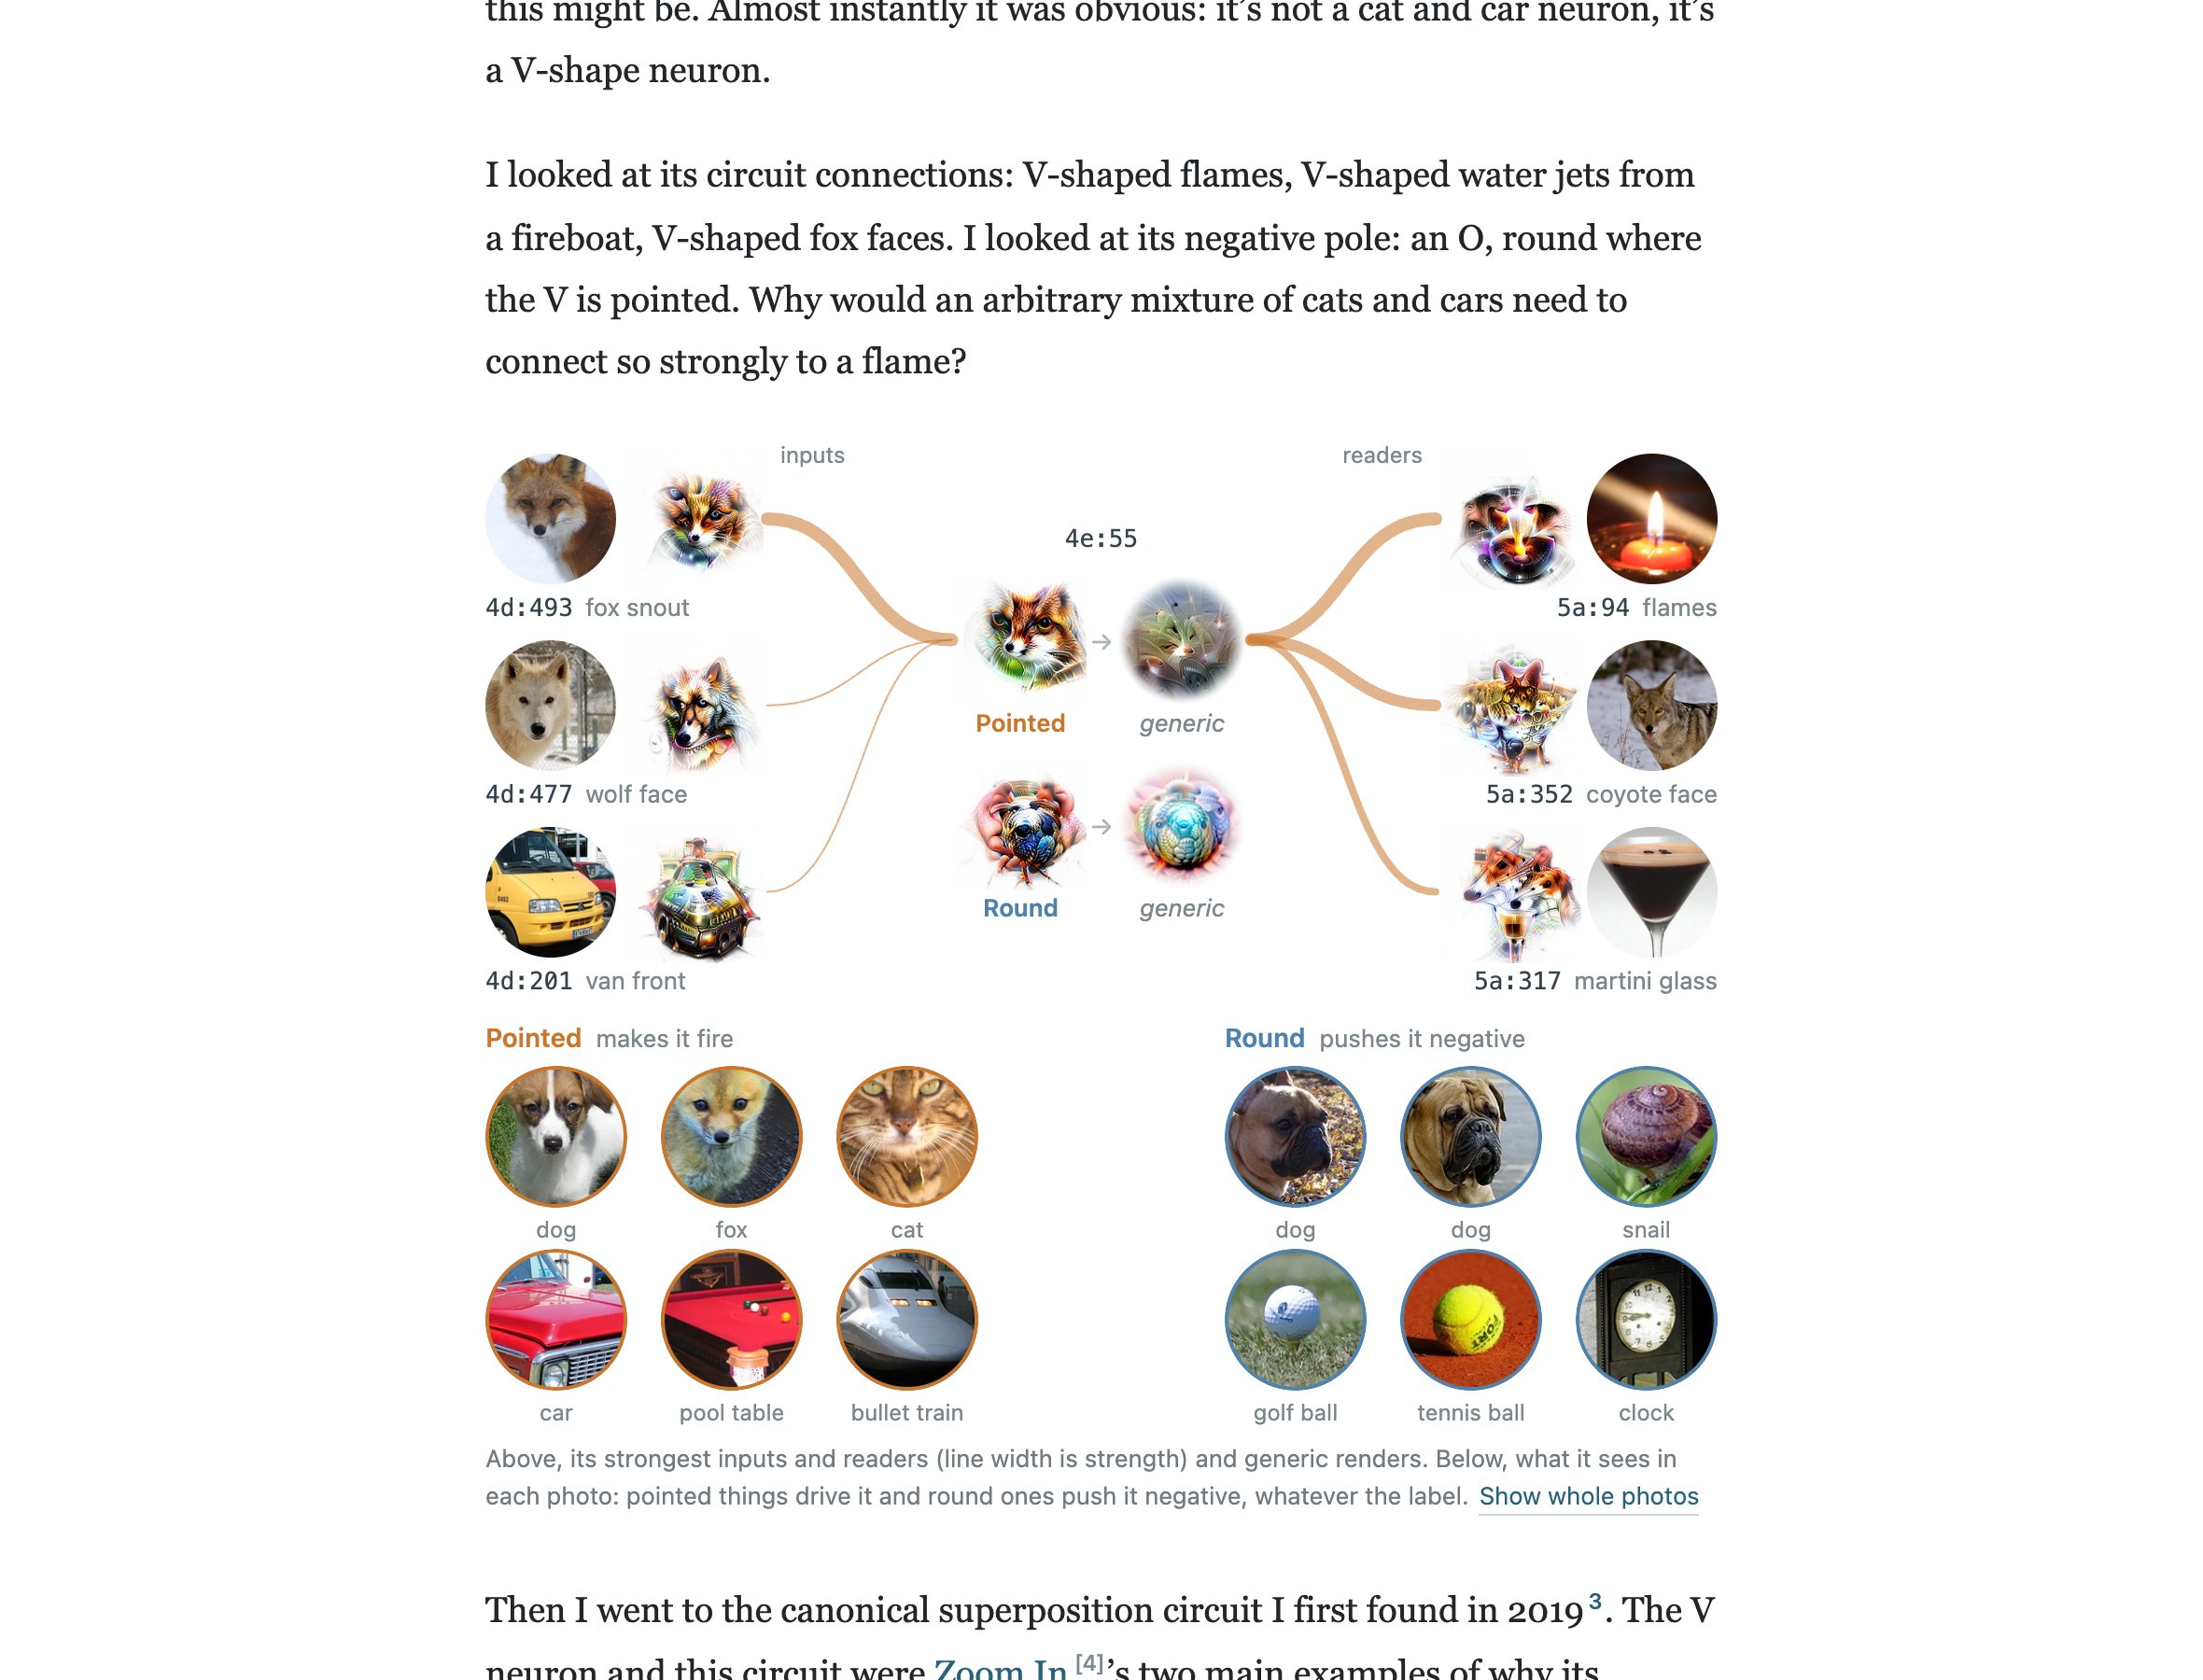
论文还重读了那个最著名的「猫+车」神经元 4e:55。结论:它其实是一个 V 形(pointed shape)检测器。它的上游输入是狐狸吻部、狼脸、面包车正面(都带尖锐的 V 形轮廓),下游读者是火焰、郊狼脸、马提尼杯(都含 V 形)。它对猫和车起反应,是因为猫脸和某些车头恰好有尖锐结构——「猫+车」是观察者的错误标签,网络内部并没有这样的存储单元。论文同时承认,2020 年展示那幅图的原始解读犯了两个错误:误读了一个广义姿态电路,加上特征可视化的 reward hacking 把狗画进了本来承载汽车信息的电路。
证据二:递归泛化——树枝不是乱麻
对剩下的「多义」神经元,论文提出的替代解释叫递归泛化(recursive generalization):神经元像树枝一样沿相邻概念分叉生长,每个分叉都局部可读,只是让神经元不再「单元义」。
最直观的例子是一个语言模型神经元:它最初响应字母组合「iy」(比如 Miyazaki 里的 iy),然后长出对「diy」的响应,最后长出对「do it yourself」的响应——第三步里「iy」这个字符串已经完全不存在了。另一个例子是地质学神经元,顺带响应 Cesium——一个地质学 JavaScript 库。这些分叉全都有清晰的语义路径可循。
对照假设是叠加:如果互不相关的概念真被随机打包进同一神经元,分叉之间应该没有语义联系。论文的训练过程显微镜显示,神经元生长全部是局部漂移——滑向相邻概念,从不跳向无关概念。作者重训 InceptionV1 并追踪末层最混乱的神经元,看到的仍是「向合理邻域过度生长」,不是任意混合。
证据三:弱激活消融——关键信息不在「暗物质」里
叠加假说还有一个退路:就算强激活是干净的,关键特征会不会藏在海量弱激活里?论文用消融实验直接测试了这一点。
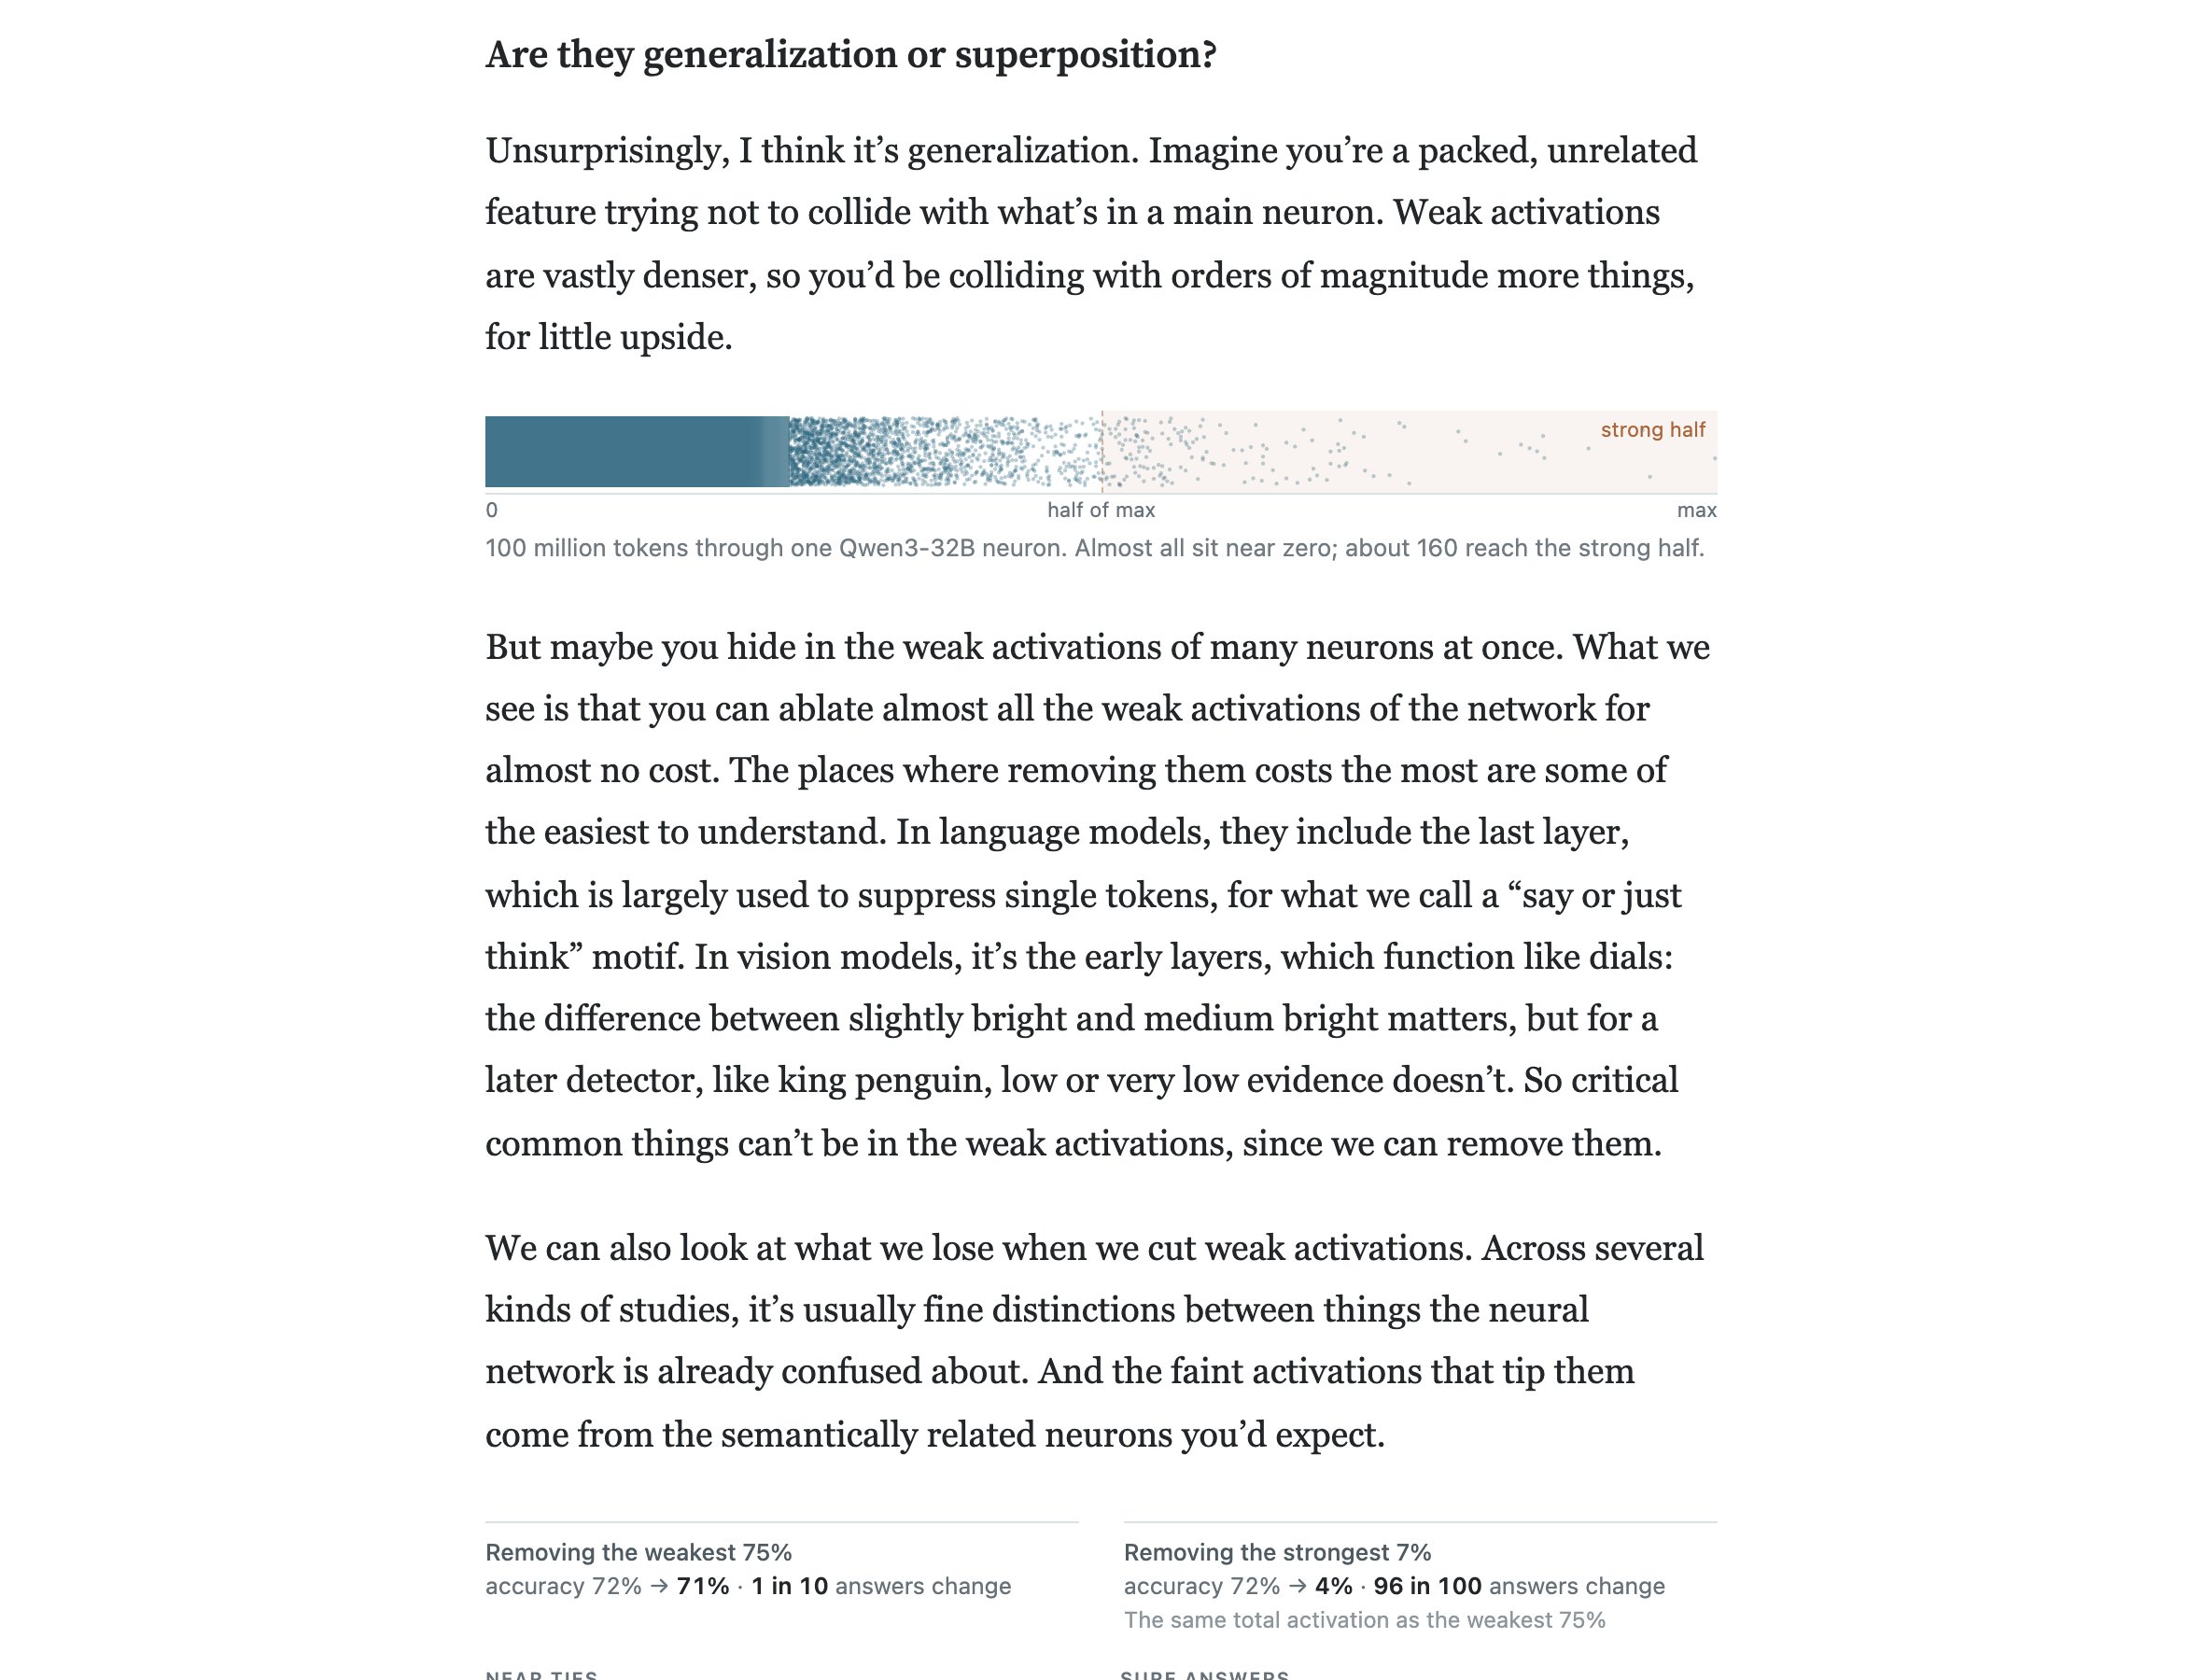
先看量级:让 1 亿个 token 流过一个 Qwen3-32B 神经元,几乎全部激活值接近零,只有约 160 个达到最大值的一半。弱激活在数量上占绝对主导。
然后是关键实验。把最弱的 75% 激活全部移除:模型准确率从 72% 降到 71%,每 10 个回答只有 1 个改变。把总激活量相同的最强 7% 移除:准确率从 72% 崩到 4%,每 100 个回答改变 96 个。同样多的「激活质量」,放在强激活里是模型的全部判断力,放在弱激活里几乎可以被整体删除。
被删除的弱激活改变了什么?论文逐例检查后发现,它们只影响模型本来就拿不准的近似判断(近义类别之间的贴边选择),而 tipping 它们的弱信号来自语义相关的上游神经元。作者手动追踪过数百个「看起来无关」的弱激活,几乎全部能沿合理电路追溯到关联——比如一个禅宗公案神经元在数学文本上弱激活,因为公案和数学共享自指结构。
证据四:前沿规模验证——从 Qwen3-32B 到万亿参数
这套方法在多大模型上验证过?论文给出的初步审计数字:Qwen3-32B 约 90% 的神经元「极只有一个主职」(常带小的相关分叉),另有约 7% 有两个相关职责,只有约 2-4% 尚未理解。稠密模型和 MoE 模型结果相近。他们在 Kimi K3(万亿参数级)上做出了首个公开发表的万亿参数模型 attribution graph:问模型「捡到装有 500 美元和失主证件的钱包怎么办」,图谱清晰显示失物与诚实相关神经元推动「归还」,而最强的单点干预来自反向 neurons——把负极相关神经元移除后,P(return) 从 0.83 升到 0.98。
方法上有一个精巧的设计:盲最大值(blind maximum)测试。一个 agent 只看神经元的文字解释(看不到激活数据),写出它认为最能激活该神经元的句子;这个句子再与语料库中 100 亿 token 里找到的最强真实激活对比。结果是 agent 写的句子通常更强。一个只凭解释工作的 agent 能命中比真实语料更强的激活点,说明解释抓住了神经元真正在检测的东西,而不是拟合了表面统计。
被误读的二十年与 SwiGLU 的工程细节
论文用相当篇幅解释为什么整个领域看错了方向。原因层叠:早期解释器模型无法运行「猜想-验证」循环;评估指标(模拟分数)奖励能复现激活数字的解释,而不是正确的解释——注意力把信息存在逗号等标点上(论文称之为 summary motif),模拟器被迫精确复现标点上的分布,但这与神经元本身的功能无关;研究者找错了东西,多数人预期神经元检测名词,实际上最常见的神经元检测的是微妙感受与社会语境,它们的激活峰值常落在标点或前一个词上。
还有一个纯工程层的发现:现代 SwiGLU 神经元计算 SiLU(gate) × value,当 gate 和 value 同时为负时输出为正,产生一个与负极相似的正信号。约 4% 的神经元里,这个「双负回声」占据了激活榜前列,让自动解释器把它们标成「多义」。论文给的案例是一个 Colossians(圣经书卷)神经元:top-k 看全是宗教引用,实际是「补全 Russia/Russian 词尾」的神经元,负值 gate 泄漏伪造了整个正激活榜单。作者建议架构设计者修复这个问题——消融这些双负神经元后多数 benchmark 反而上升,只有部分推理任务下降。
如果是真的,改变什么
论文的结论对两条路线都有影响。对 SAE 重构路线,它提出了成本质疑:如果网络自身的机制本来可读,用重构模型替换它可能拆掉那些尚未被理解的泛化结构——词典仍是网络的一种视图,但未必是必要替代。对 AI 安全路线,它是正面消息:如果机制可读,就可以做定点修改(比如移除一个被证明有毒的 RL 环境),而不用把梯度推过「我们用来观察的工具」本身。
Cammarata 在文末自评对核心论点约 85% 确定,同时承认标题夸大了证据(没有审计所有网络)又低估了含义(「干净」不等于每个神经元都匹配人类已有标签)。配套技术论文即将发布,将覆盖语言模型神经元的详细实验。
对关注这个方向的人来说,这篇长文的价值在于它把一个默认假设降级成了待检验假说:叠加不再是「网络为什么不可读」的默认答案,而是最后一个才该考虑的解释。验证或反驳它的实验——重训旧模型、消融弱激活、盲最大值测试、训练过程显微镜——都是描述清楚就可以复现的操作。
来源:
- Neural Networks Are Already Clean(Goodfire,Nick Cammarata,2026-10-15)
- Hacker News 讨论(574 分)
- Zoom In: An Introduction to Circuits(Distill, 2020)、Towards Monosemanticity(Transformer Circuits Thread, 2023)、Scaling and Evaluating Sparse Autoencoders(OpenAI, 2024)