998 美元训练 3.8B 模型:little-lm 反超 GPT-2 的完整账本
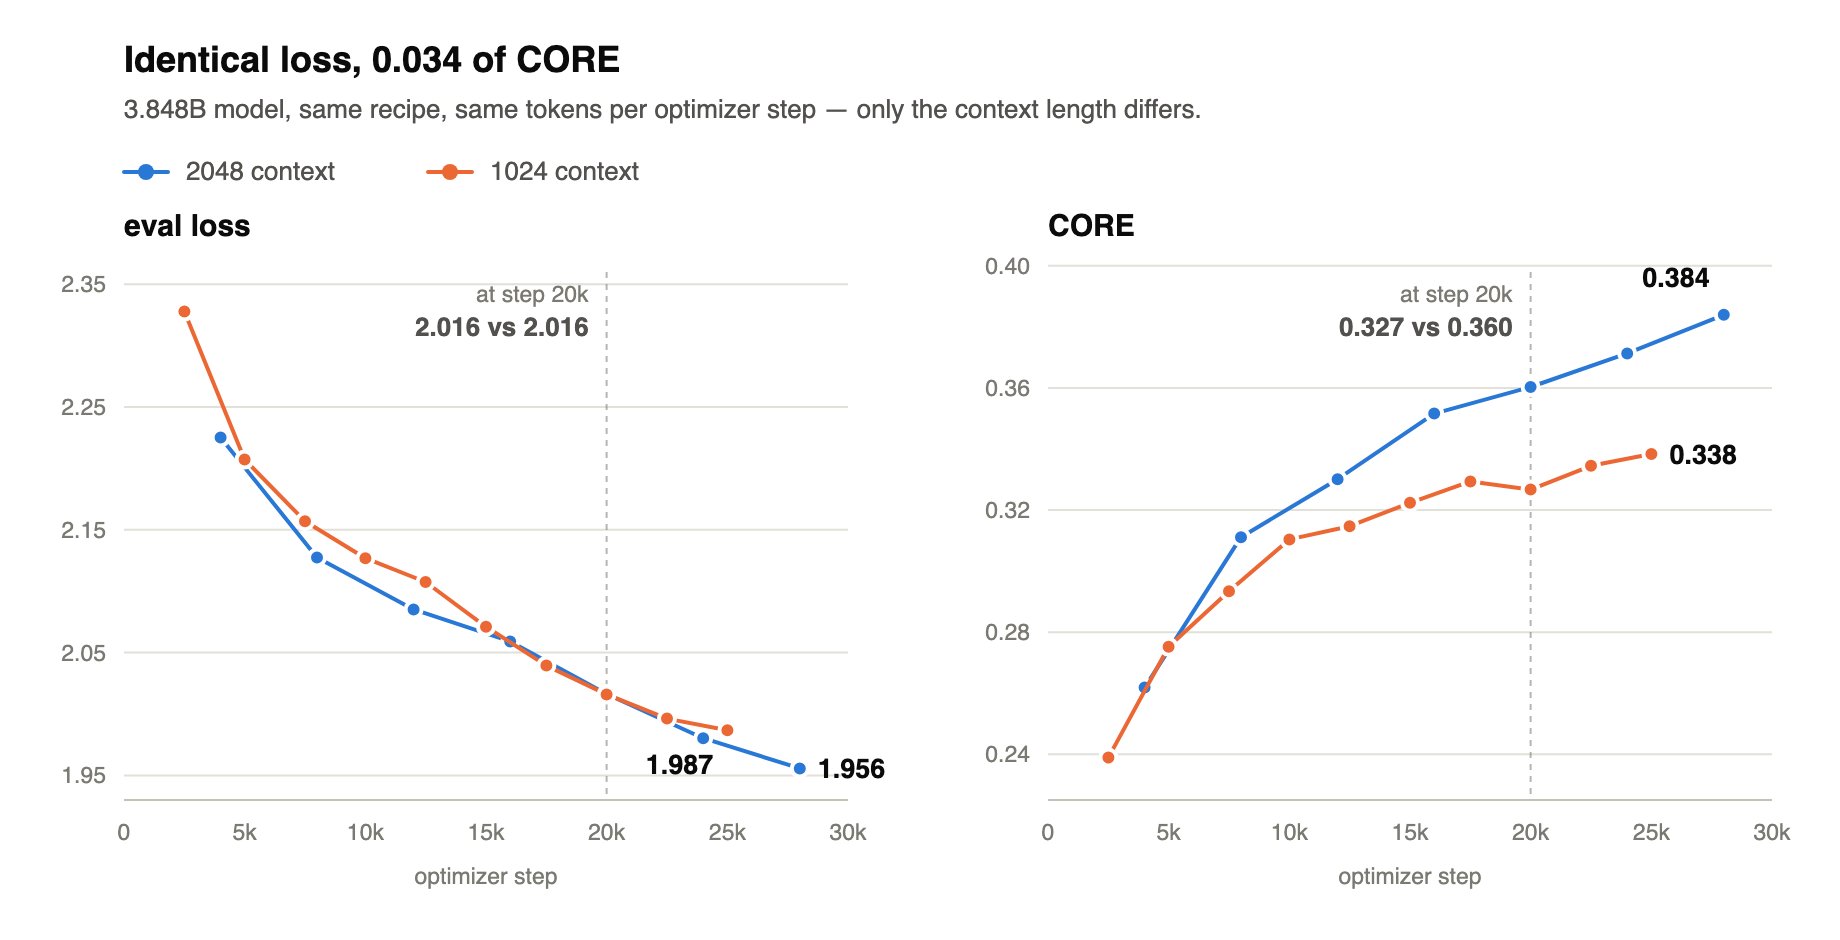
1000 美元能买到什么级别的语言模型?Hugo Vergnes 用一份可复现的答案更新了这个问题的基准线:3.8B 参数的自研模型 little-lm,在 8 张租来的 B200 上训练 43 小时,花费 998 美元,CORE 评测得分 0.384。这个分数比 OpenAI 2019 年动用整个实验室资源训练的 GPT-2 1.5B(0.2565)高出超…
1000 美元能买到什么级别的语言模型?Hugo Vergnes 用一份可复现的答案更新了这个问题的基准线:3.8B 参数的自研模型 little-lm,在 8 张租来的 B200 上训练 43 小时,花费 998 美元,CORE 评测得分 0.384。这个分数比 OpenAI 2019 年动用整个实验室资源训练的 GPT-2 1.5B(0.2565)高出超…
Anthropic 于 2026 年 9 月 1 日发布 Claude Fable 5.1,定位长时程智能体与复杂推理任务,同步推出仅限邀请的 Claude Mythos 5.1。这次发布有三个值得展开的信息点:1M token 上下文配合结构性降价(缓存读取价格降至四分之一)、对上一代 Fable 5 的全面 benchmark 提升,以及"同一个模型、两…
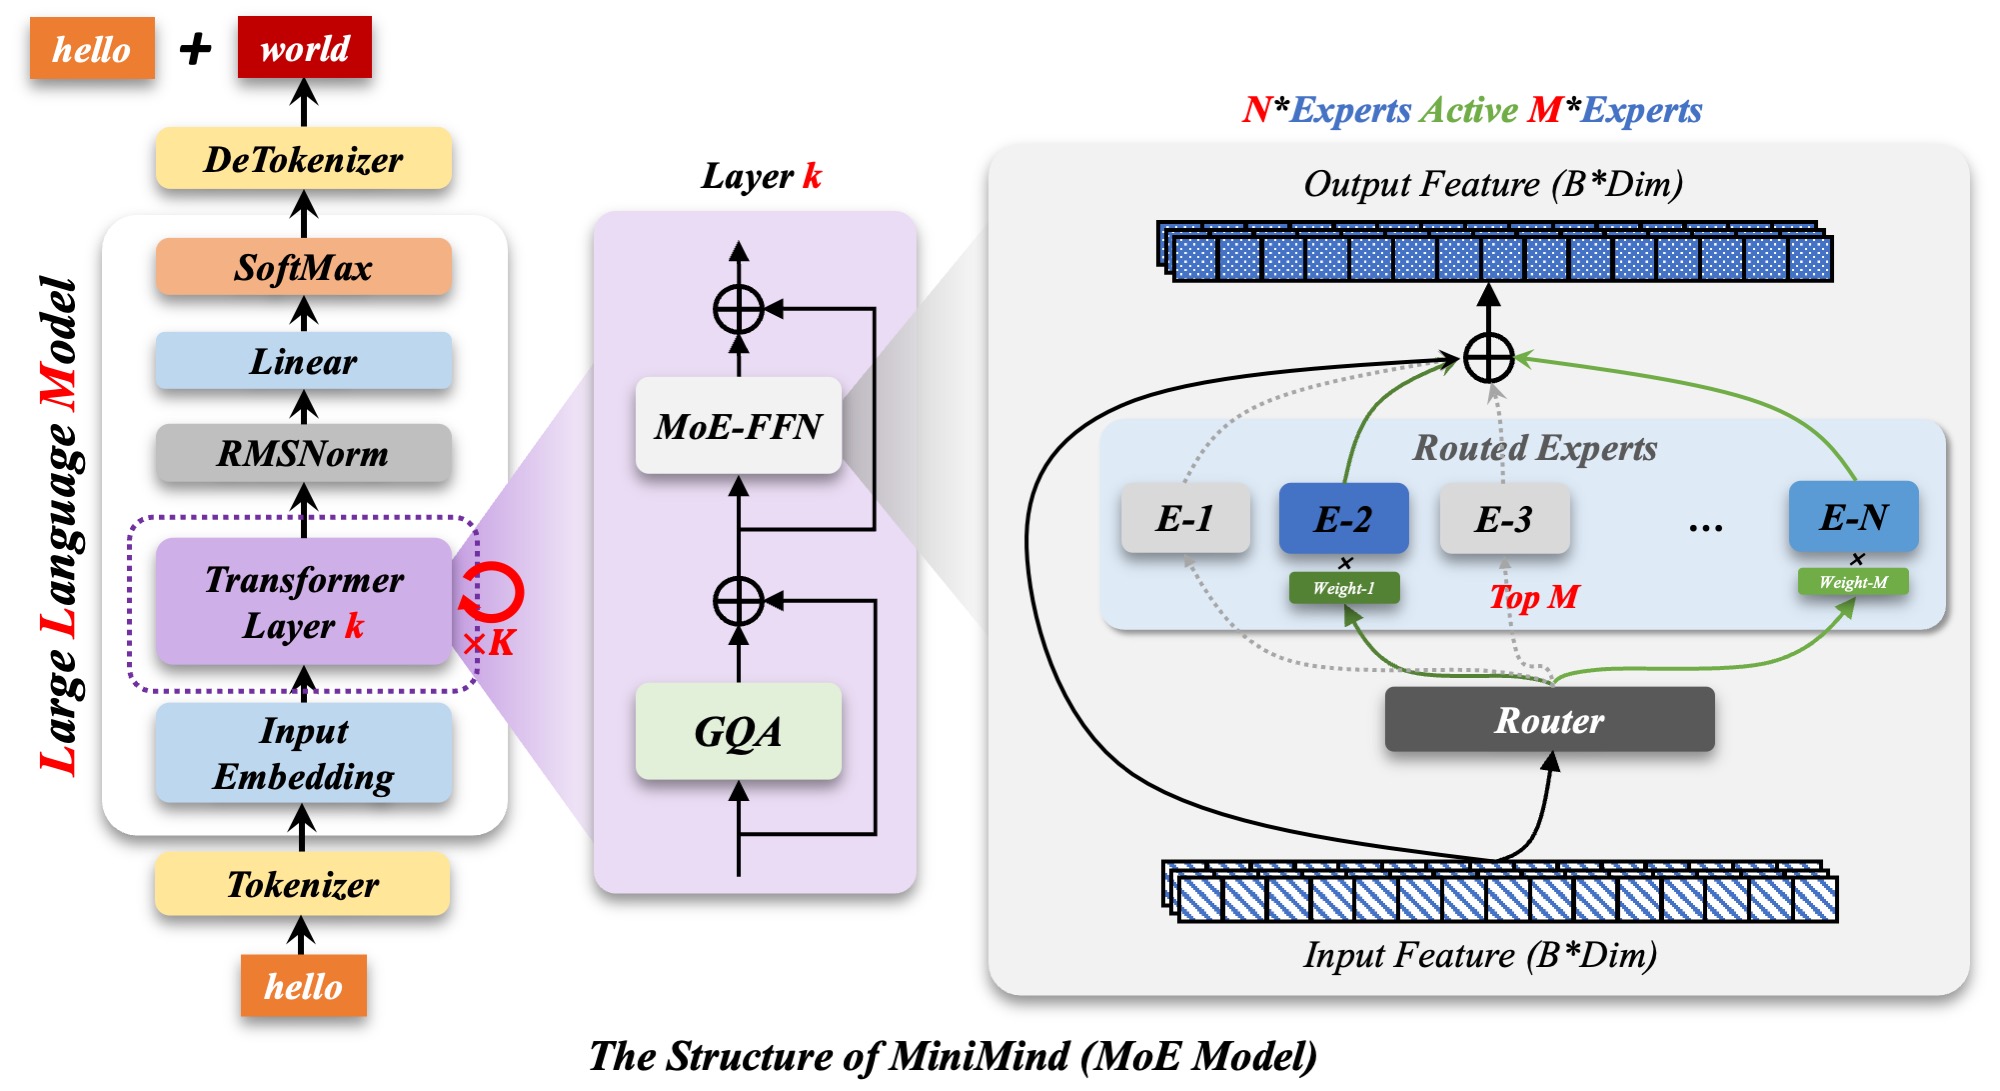
训练一个大语言模型要花多少钱?行业里公开的数字通常以百万美元计。GitHub 上的开源项目 minimind 给出了另一个量级的答案:单卡 RTX 3090,预训练加微调合计约 2.31 小时,成本约 3.0 元人民币,就能从零训练出一个可以对话的 64M 参数语言模型。这个仓库目前拿下 55,894 star、7,301 fork,采用 Apache-2.…
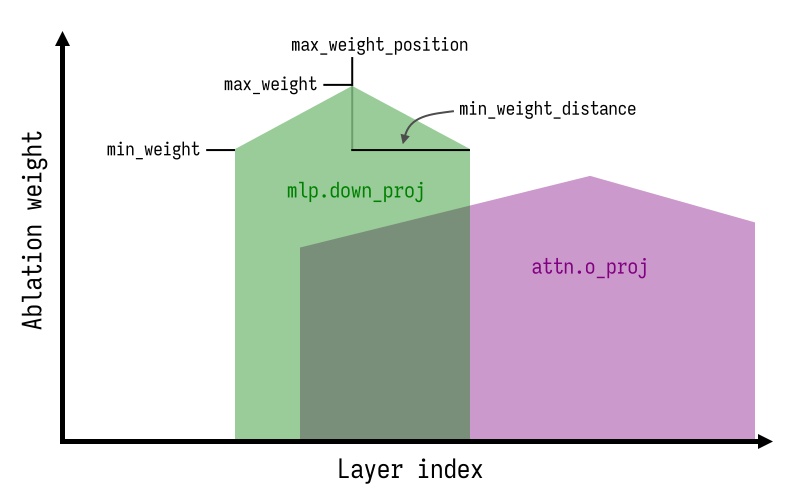
28.9k star 的 Heretic 把"去掉模型审查"做成了一键命令行工具,产出质量超过了多数人工调参的同类模型 大模型拒绝回答敏感问题的行为,在技术社区里有个专门的名词:safety alignment,安全对齐。2024 年以来,一类名为 abliteration(方向消融)的方法证明,这种拒绝行为在模型内部对应着一个可以定位、也可以直接移除的方向…
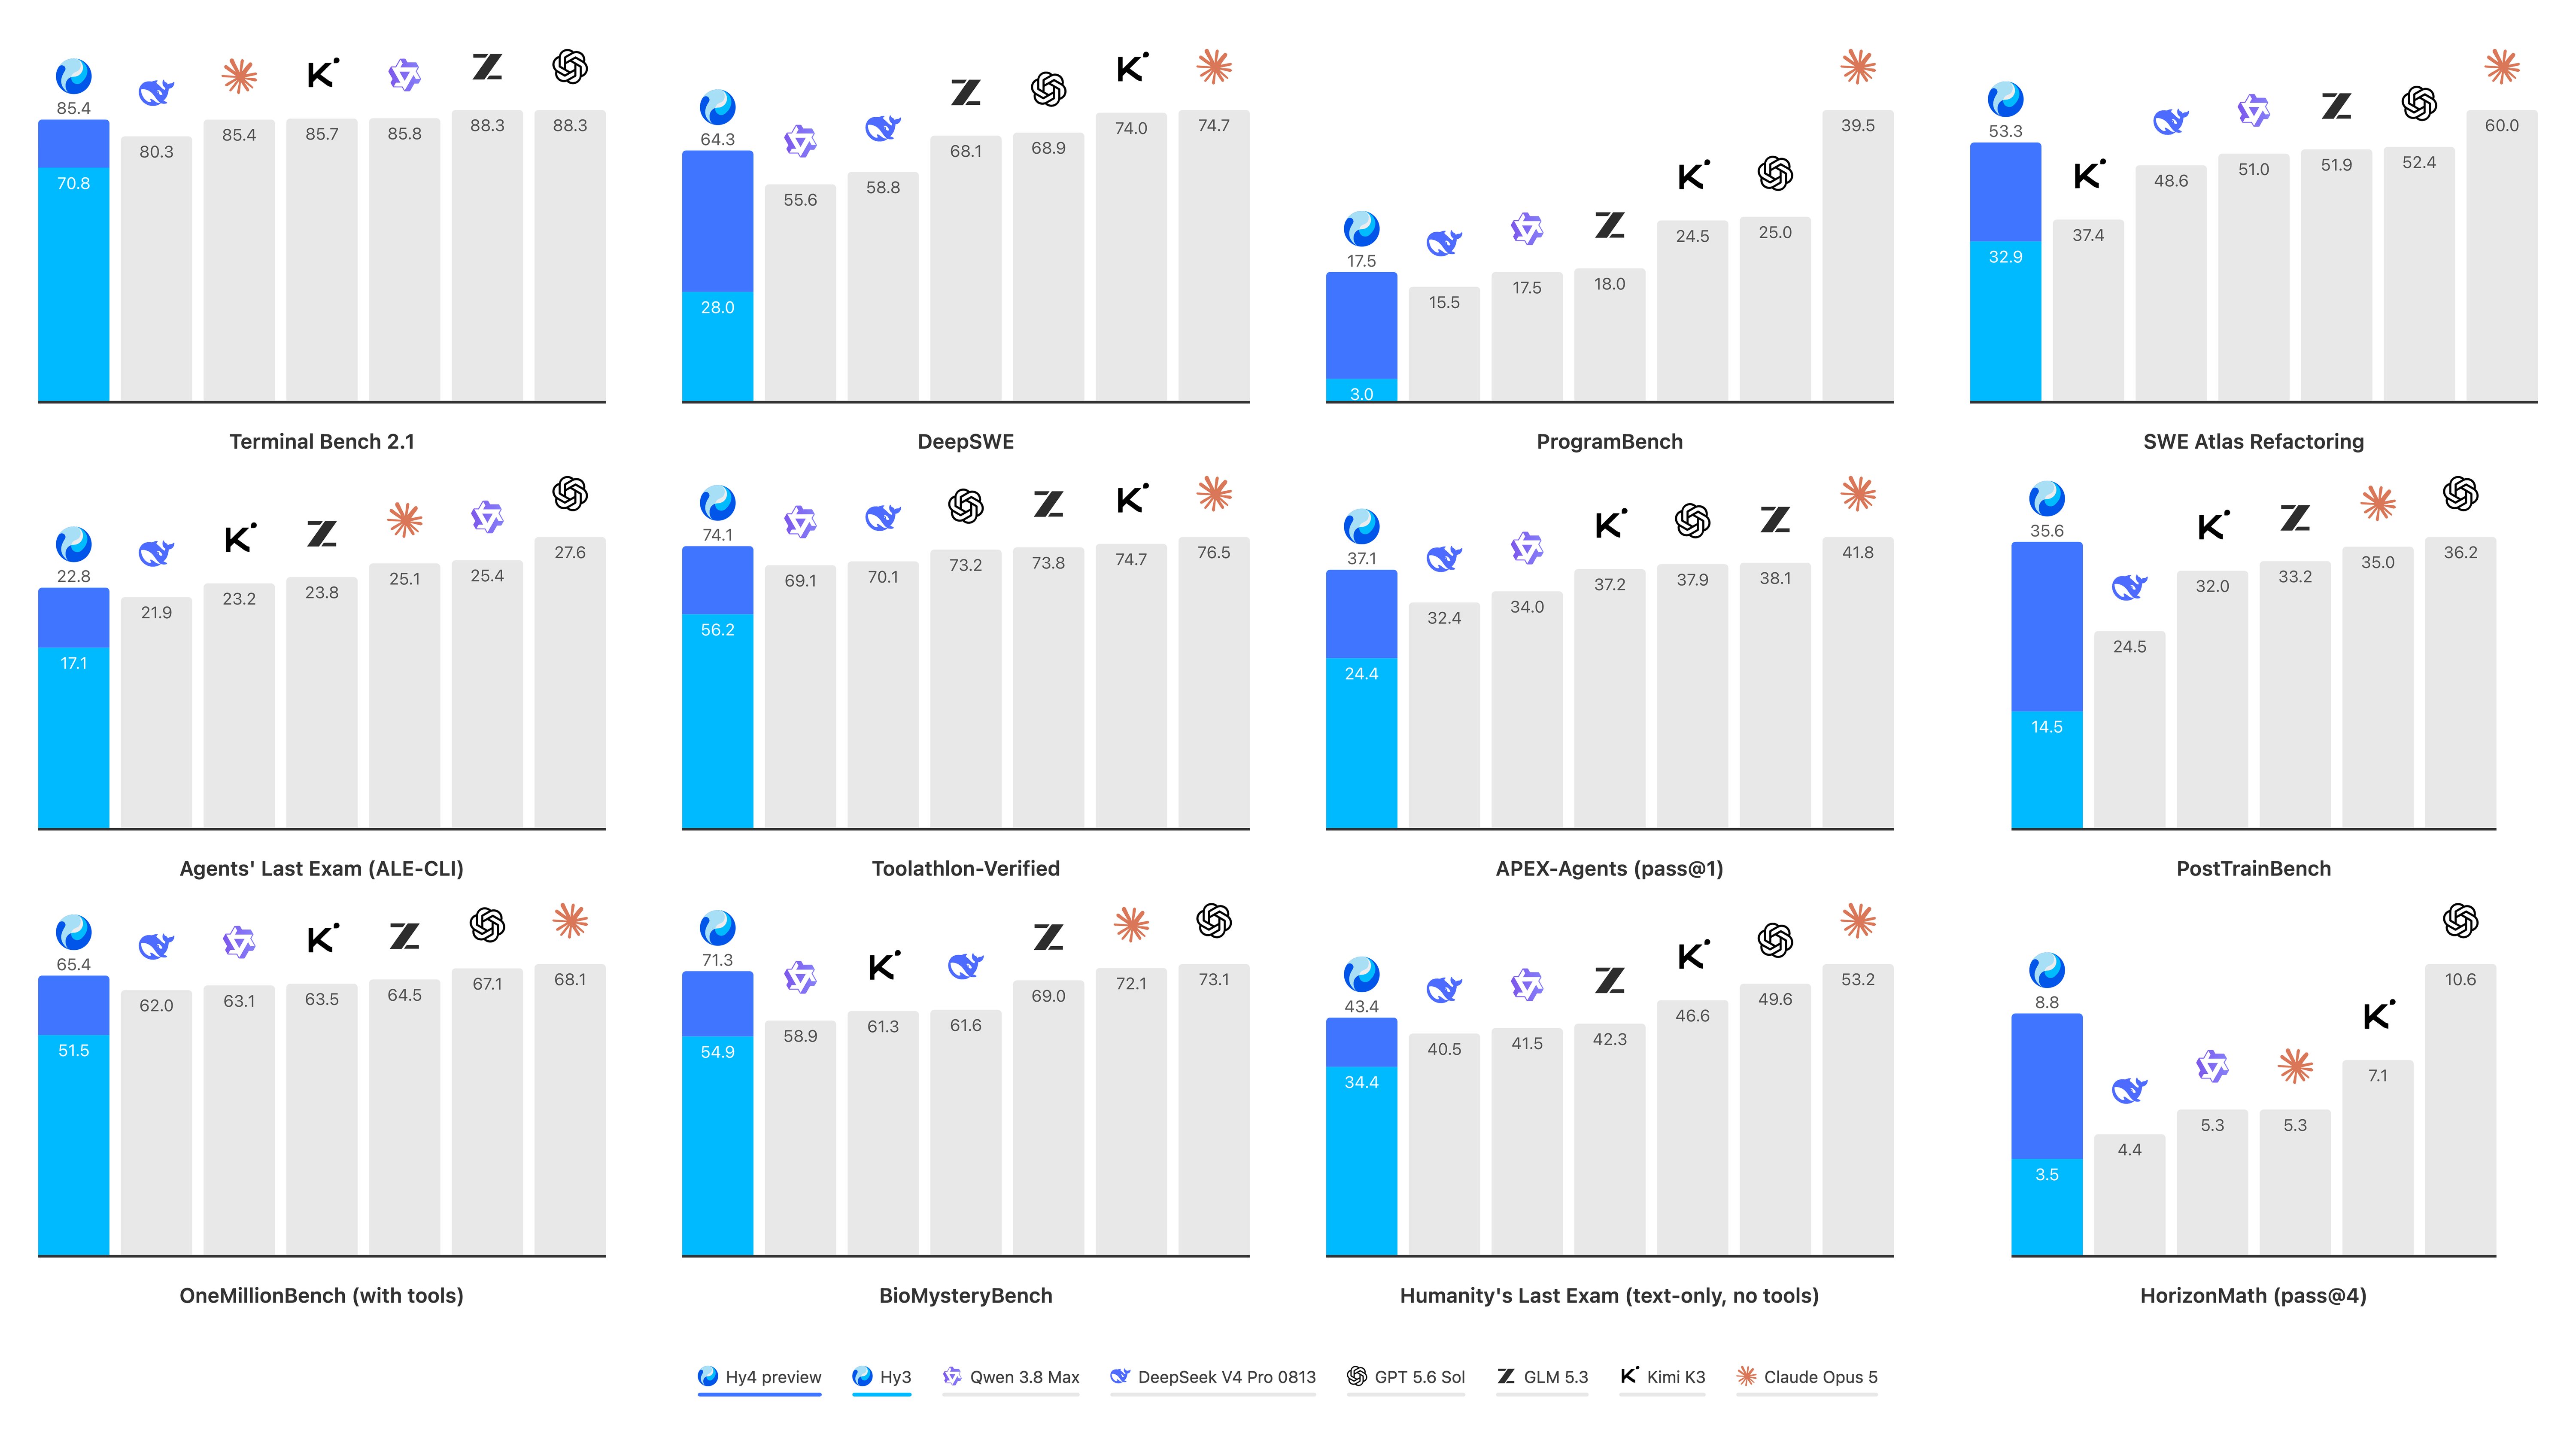
腾讯混元发布了新一代旗舰模型 Hy4 preview,主打一个「preview」:770B 总参数的 MoE 架构,每个 token 只激活 490 亿参数,上下文窗口拉到 100 万 token,权重按 Apache 2.0 协议在 Hugging Face 全量放出(131 个 safetensors 分片,含 1 个原生 MTP 投机解码层)。腾讯云…
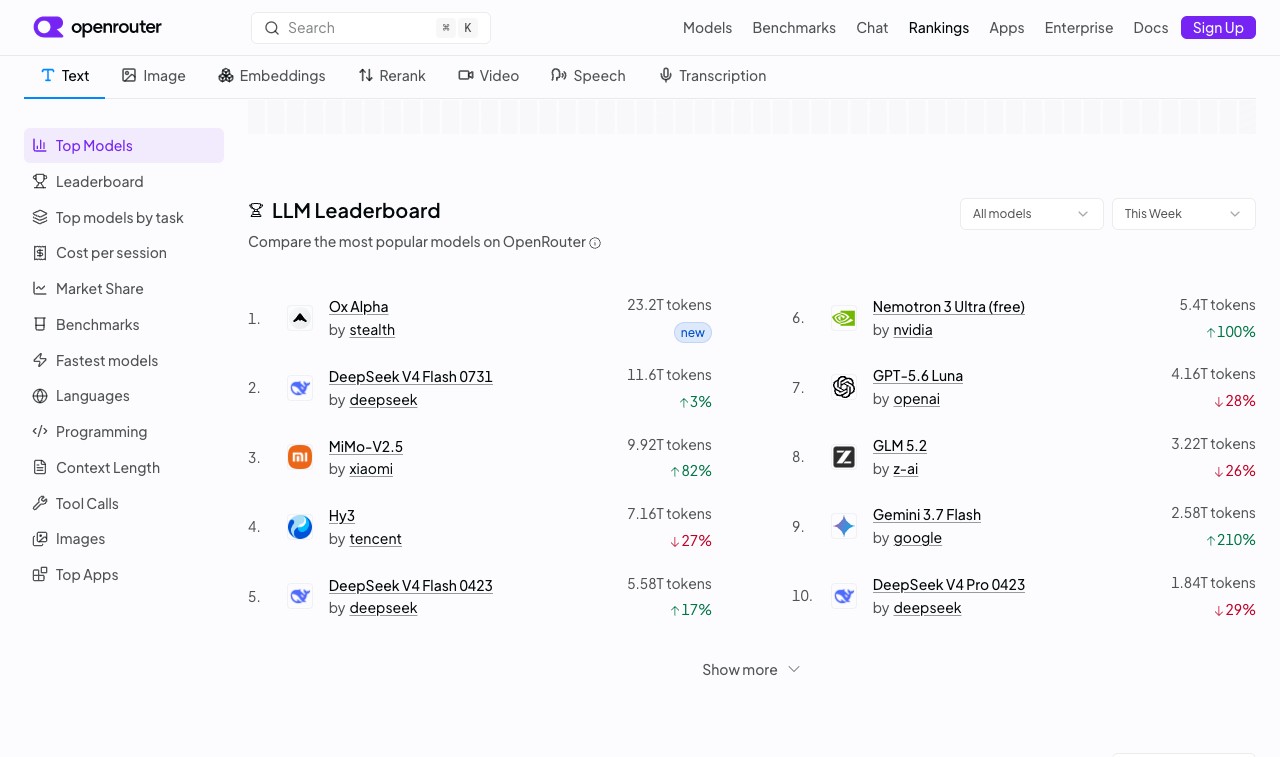
智谱确认 Ox Alpha 为 GLM 新迭代:OpenRouter 用量登顶,今晚开源权重 一周登顶:23.2T tokens 的匿名模型 OpenRouter 本周使用量榜单(数据截至 8 月 25 日)出现了一个此前没有过的情况:排名第一的模型没有厂商署名、没有定价、没有参数规模披露。匿名模型 Ox Alpha 本周处理了 23.2T tokens,排…
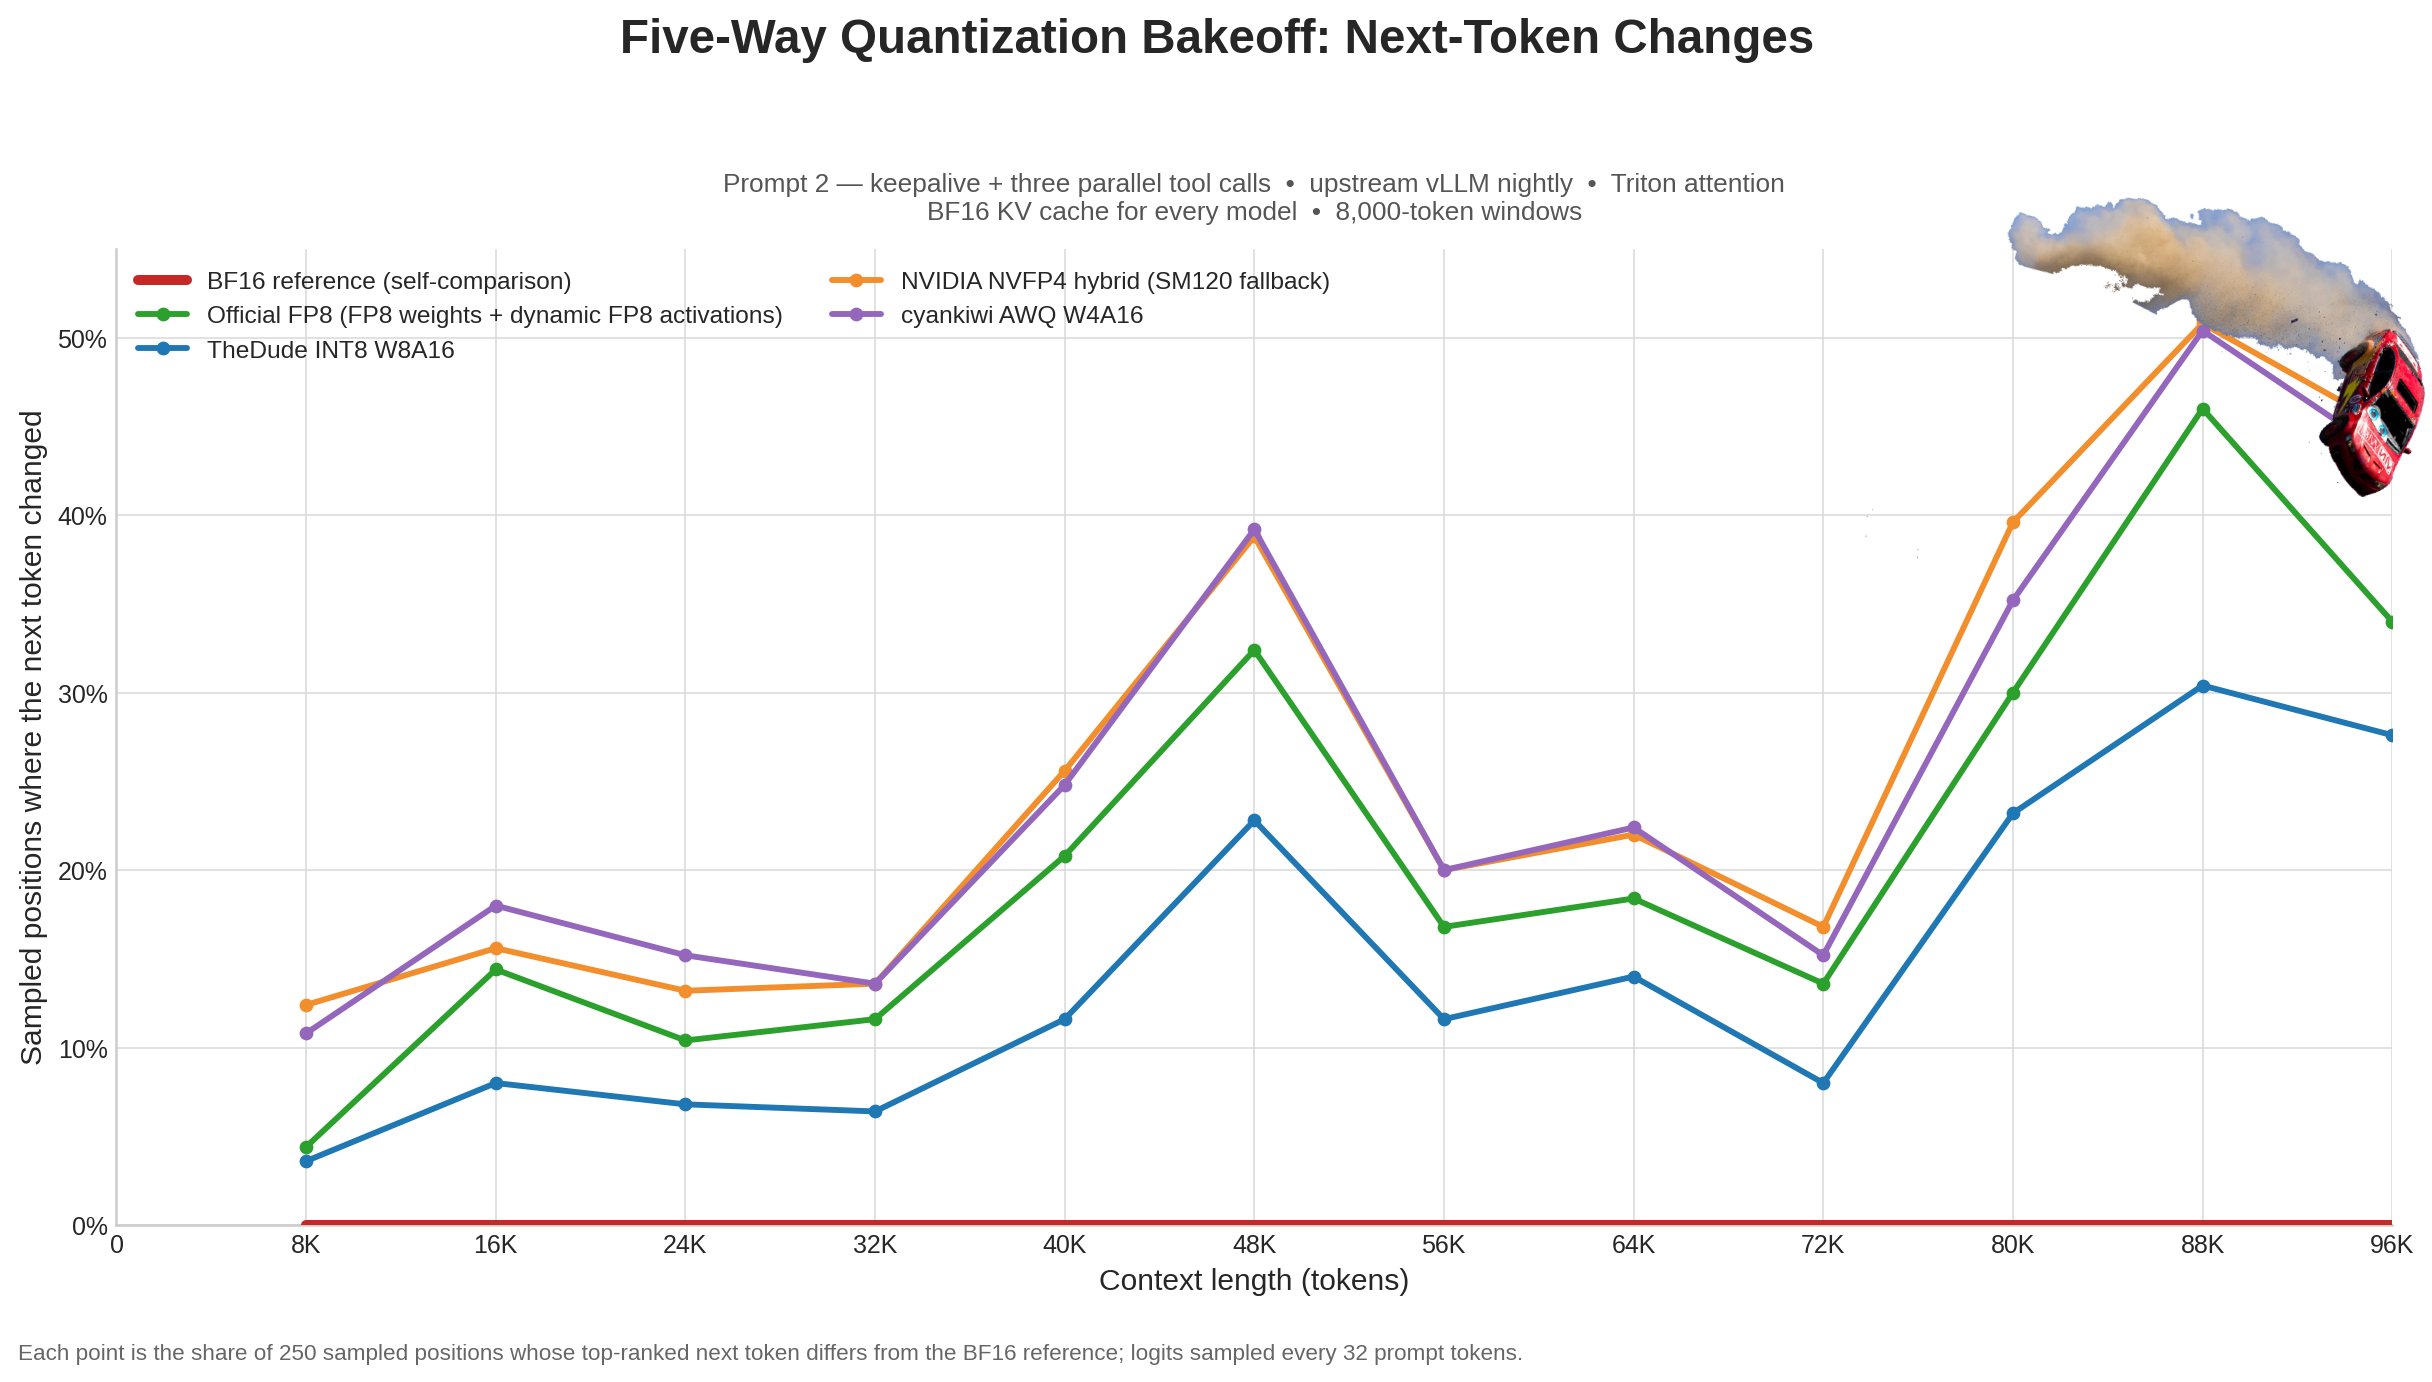
同一份模型权重,在官方演示里对答如流,部署到本地却频繁表现失常:长上下文读到后半段输出开始漂移,量化版本连工具调用都闭合不了。Level1Techs 论坛上一篇带完整数据的受控实验《Why your local LLM feels dumber than it is》把原因指向了推理软件栈:从注意力算子到量化 kernel,每一层都在改变下一个 token…
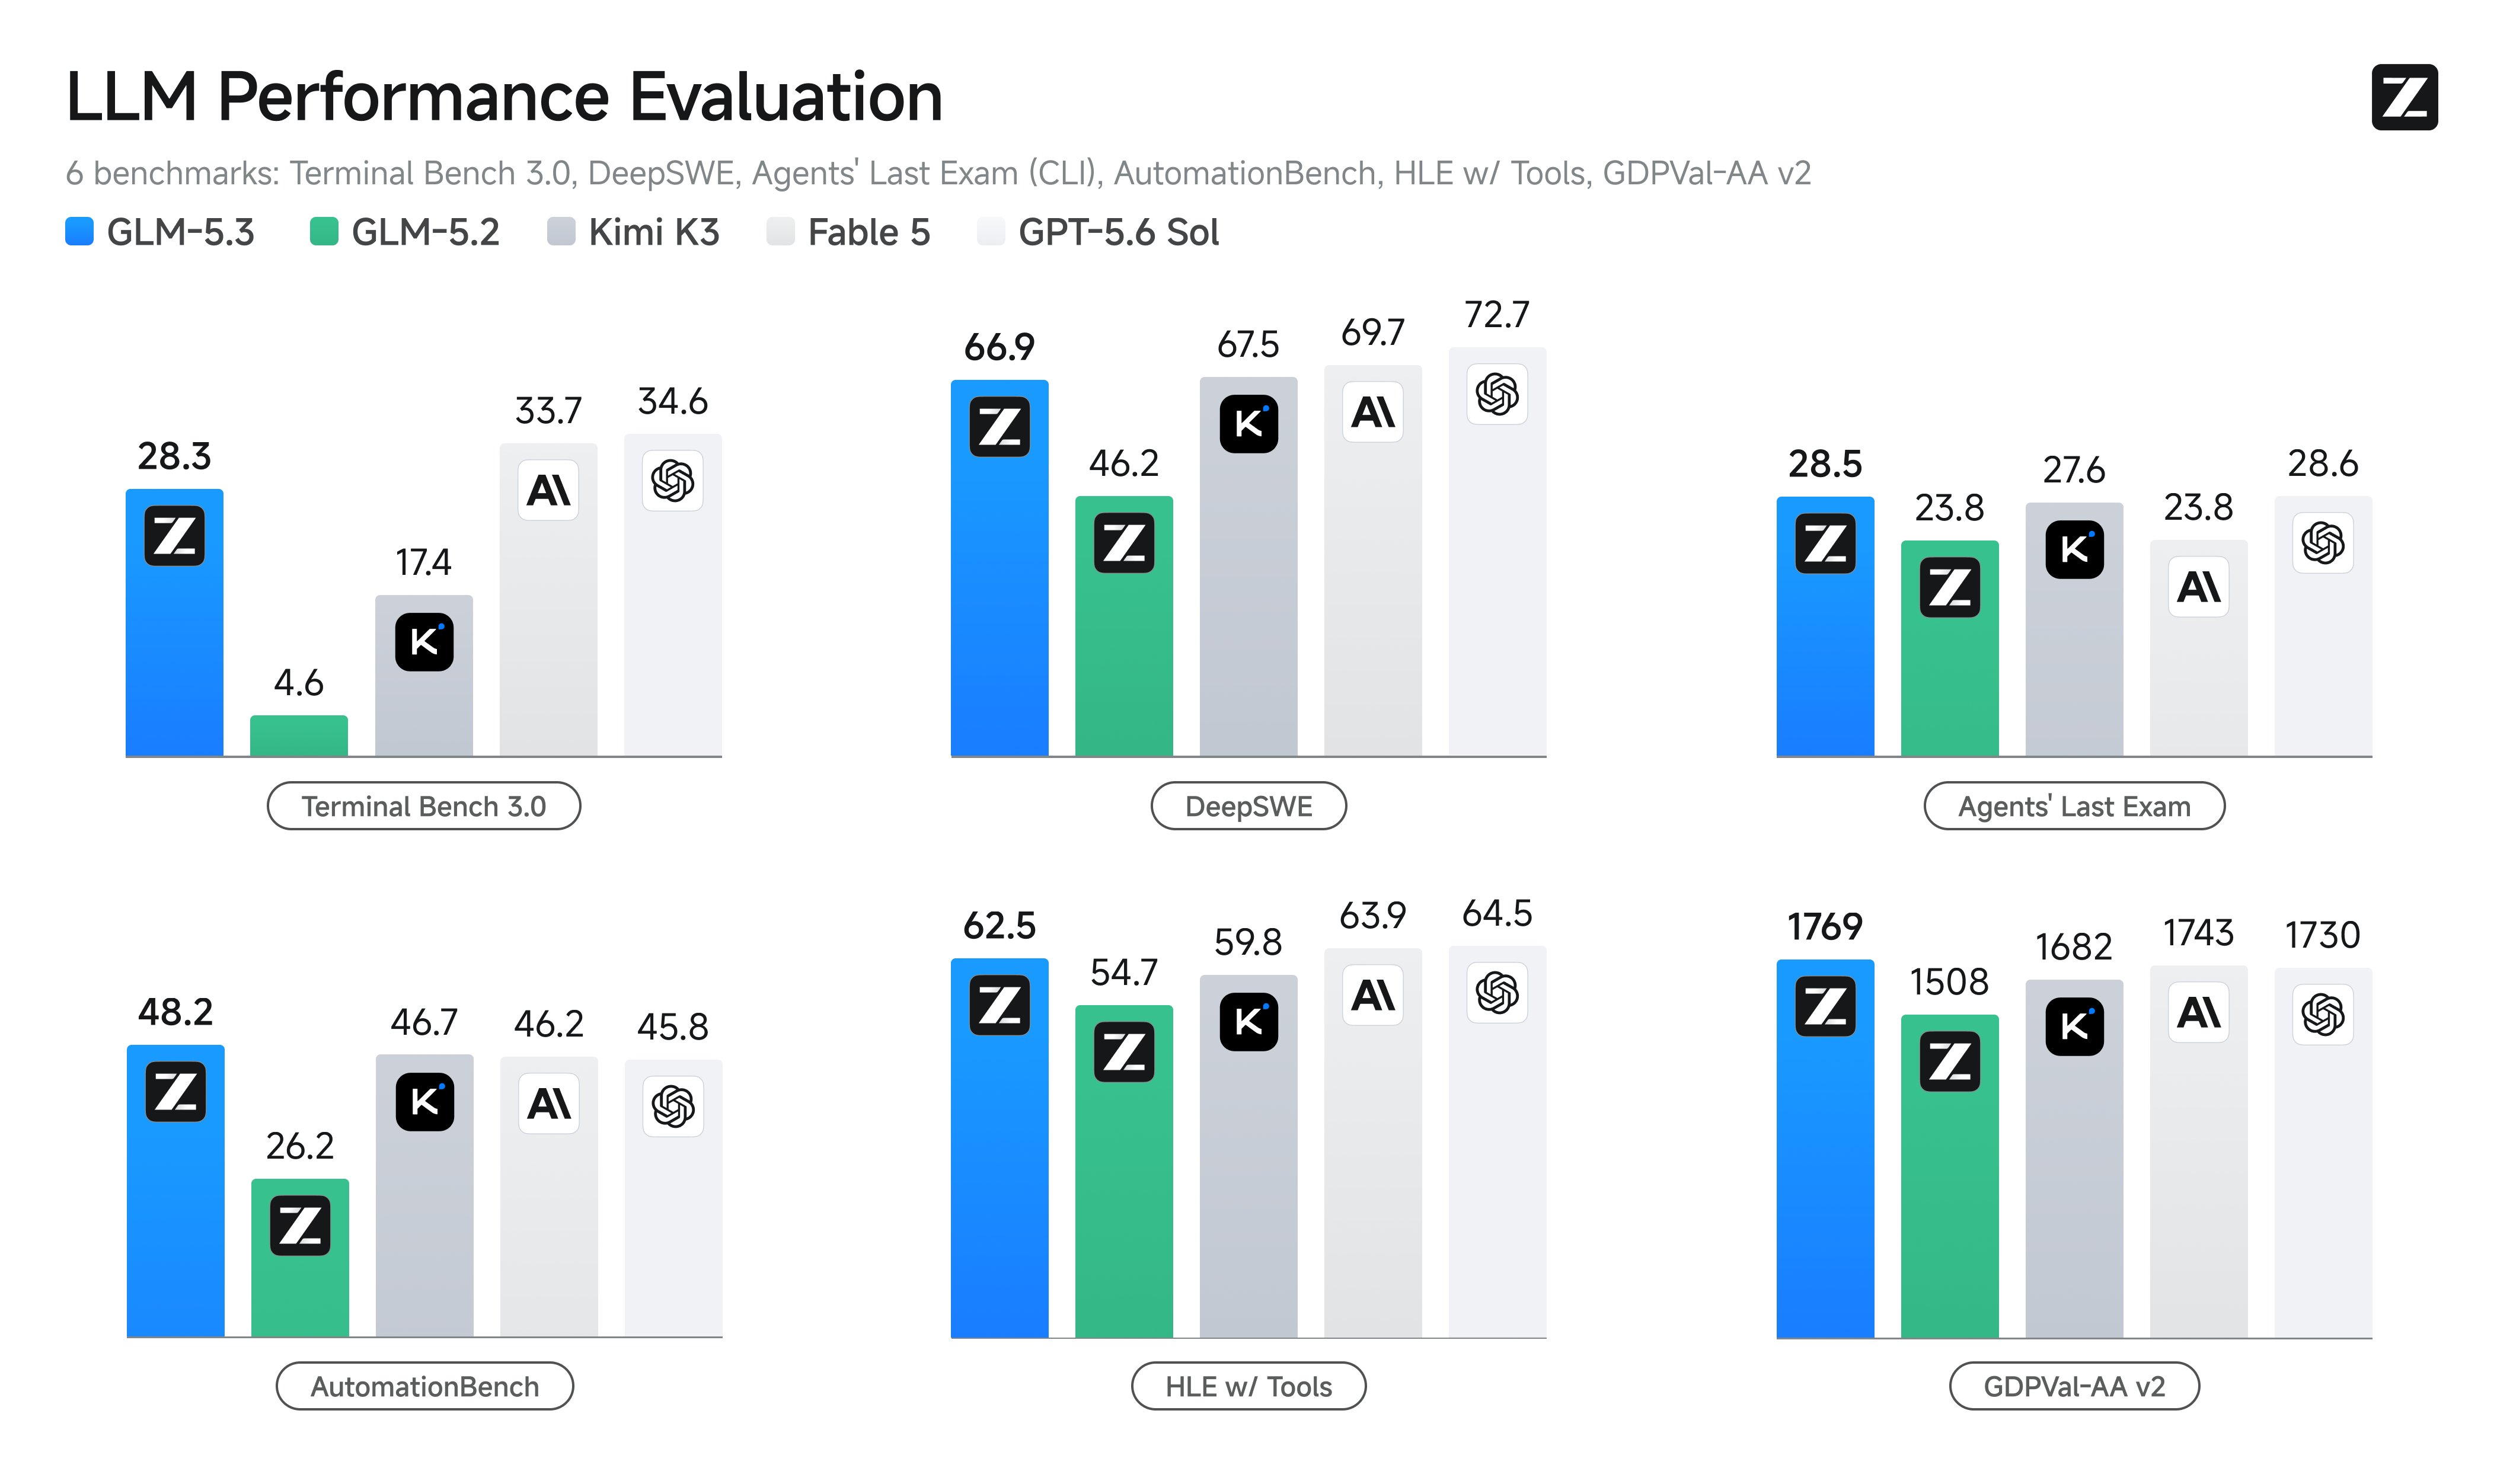
Z.ai 发布 GLM-5.3。这个模型沿用 GLM-5.2 的基座,所有提升来自后训练阶段,官方的表述是「Scaling post-training is all we did」。提升集中在两个方向:复杂编码与长程 Agent 任务的大幅进步,以及一份超出团队预期的安全能力答卷。Terminal Bench 3.0 上 GLM-5.3 从 GLM-5.2…
AirLLM 是一个面向 Hugging Face 大语言模型的推理库,项目的核心目标是降低推理阶段的显存占用。官方 README 给出的典型配置是:70B 模型使用单张 4GB GPU,Llama 3.1 405B 使用 8GB,DeepSeek-V3 671B 使用约 12GB。它依靠分层拆分、按需加载和权重释放完成这件事,模型参数总量与显存容量之间的关…