TurboFieldfare:在 2GB 内存跑 26B 模型的开源推理引擎
26B 参数模型塞进 2GB 内存跑,通常会被当作一个标题党。TurboFieldfare 把它做成了真事。这个开源项目用 Swift + Metal 从头搭建了一套推理引擎,在 8GB 内存的 M2 MacBook Air 上运行 Google 的 Gemma 4 26B-A4B 指令微调模型,常驻内存控制在 2GB 左右,解码速度 5-6 tokens/…
26B 参数模型塞进 2GB 内存跑,通常会被当作一个标题党。TurboFieldfare 把它做成了真事。这个开源项目用 Swift + Metal 从头搭建了一套推理引擎,在 8GB 内存的 M2 MacBook Air 上运行 Google 的 Gemma 4 26B-A4B 指令微调模型,常驻内存控制在 2GB 左右,解码速度 5-6 tokens/…
AI会让我们变笨吗?认知科学家的回答 用AI写邮件、做PPT、查资料、分析数据,已经成了很多人日常的一部分。方便是方便了,但一个越来越响的声音是:这样下去,我们自己的脑子会不会退化? 2026年7月,四位认知科学家在 Trends in Cognitive Sciences 上发表了一篇综述,标题直白得不能再直白:《AI会让我们变笨吗?》(Is AI mak…
当 AI Agent 可以自主调用工具、查询数据库、发送邮件甚至编写代码时,一个绕不开的问题浮出水面:怎么确保它不做不该做的事? 微软开源的 Agent Governance Toolkit(AGT)给出的答案是:别指望提示词约束,用确定性代码在应用层拦截每一次工具调用。 2026 年 3 月创建至今,这个项目在 GitHub 收获 5,392 个 Star…
大模型量化详解:从 FP16 到 Q4KM 该怎么选 本地部署大模型时,你一定会遇到一个问题:该下哪个版本?HuggingFace 上同一个模型往往有十几个文件——Q4KM、Q5KS、Q80、FP16……它们之间到底差多少?选错了要么跑不动,要么浪费内存。 这篇文章把量化的原理、各级别的真实区别、以及不同硬件该怎么选一次讲清楚。 量化在做什么 一个训练好的模…
你买了一本厚达 500 页的技术书,认真读完一遍,三个月后只记得大概的章节标题,具体概念和应用场景全忘了。这个场景对每个开发者都不陌生。 book-to-skill 试图用一种新方式解决这个老问题:把整本书"编译"成 AI 编程助手的技能(skill),以后遇到相关问题时,AI 直接从技能中调用对应的知识框架来回答你,不需要你翻书,也不需要把整本 PDF 塞…
MCP 协议最大更新:无状态架构、认证强化与扩展框架 2026 年 7 月 28 日,Model Context Protocol(MCP)发布了自 2024 年 11 月 Anthropic 推出该协议以来最大的一次架构更新。这次更新由 Linux 基金会旗下的 Agentic AI Foundation(AAIF)主导,核心变化是协议正式完成向完全无状态…
HuggingFace Speech-to-Speech 项目封面 HuggingFace 的 speech-to-speech 项目把语音 Agent 的四个核心环节——语音活动检测(VAD)、语音转文字(STT)、大语言模型(LLM)、文字转语音(TTS)——拆成了四个独立线程,用队列串联。每个环节都开放替换,LLM 槽位兼容 OpenAI 协议,整套流…
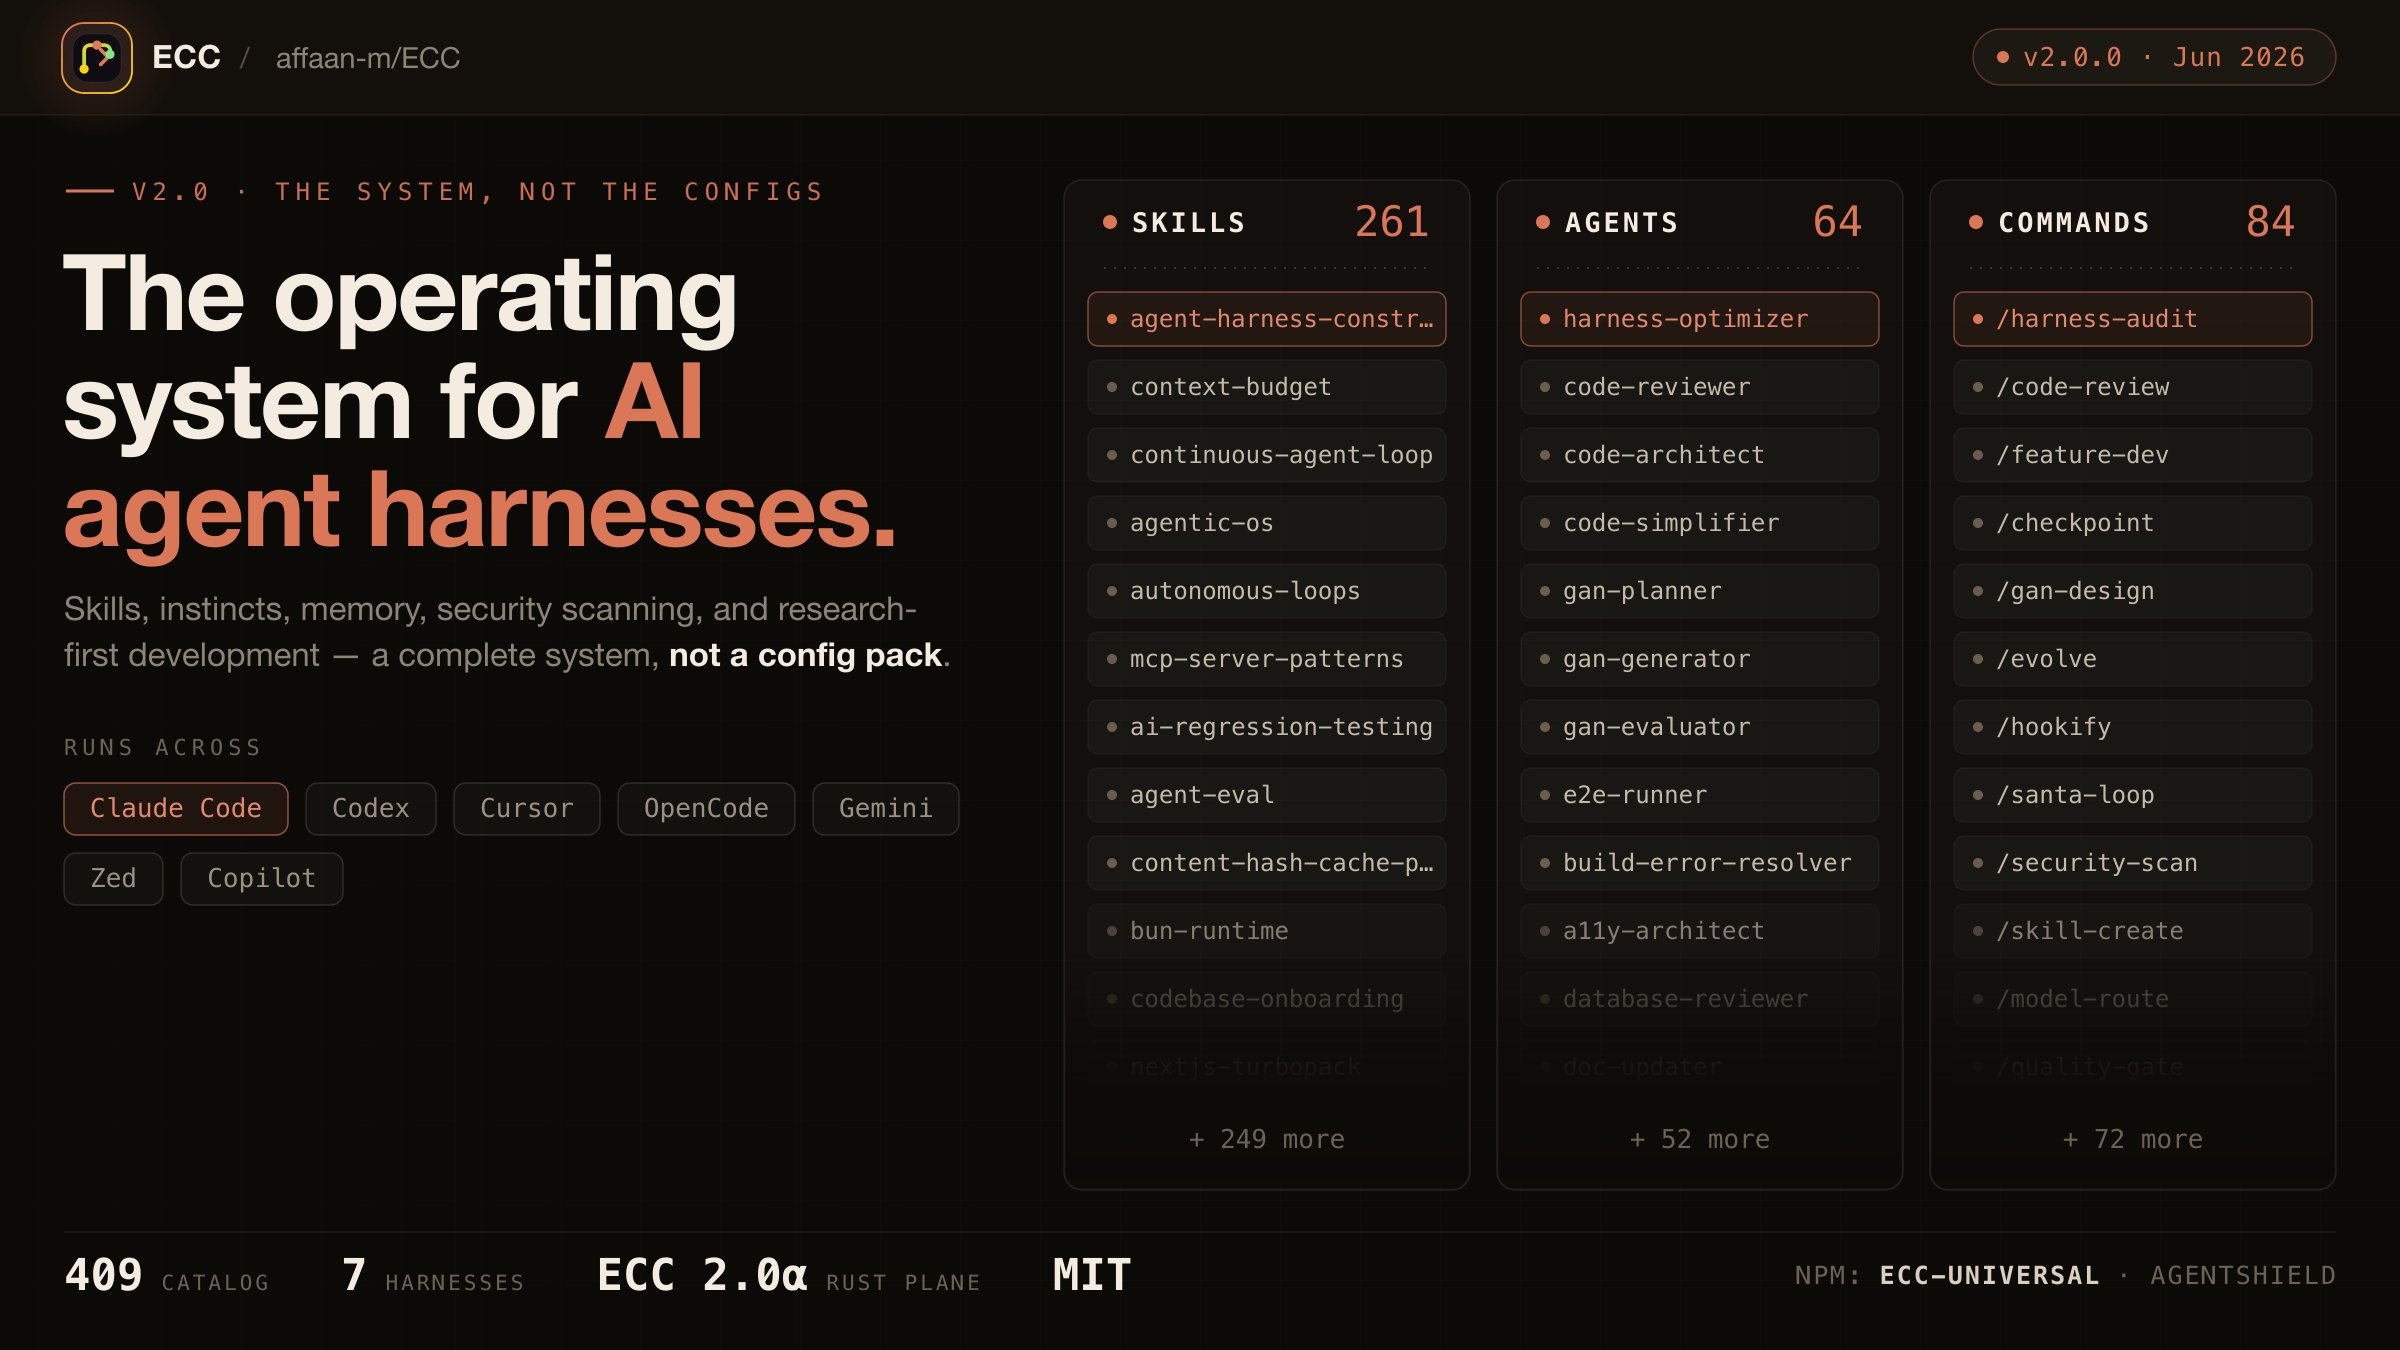
ECC:AI 编码 Agent 的操作系统 GitHub Trending 上一个名为 ECC 的项目正以每天新增近 700 颗星的速度增长,总 star 数已突破 23 万。它的定位是"AI Agent Harness 操作系统"(Agent Harness Operating System),为 Claude Code、OpenAI Codex、Curs…
"写对联都不止一句话,能做出啥?" 7月28日,Unity中国在团结引擎2.0发布会后,CEO张俊波对"一句话生成游戏"的说法泼了冷水。他的原话是:"我不大相信'一句话生成游戏'这种话。" 团结引擎2.0发布会现场 过去一年,AI公司不断展示"绕过游戏引擎"的可能性:输入自然语言就能生成角色、建筑甚至整个虚拟世界。沿着这条路线推演,未来还需要Unity、虚幻…
小模型与前沿模型的成本效率对比 一家名为 Fermisense 的 AI 工程团队用 2 块消费级 GPU、3.5 天训练时间、约 500 美元的成本,把一个 90 亿参数的开源模型微调到了超越 GPT-5.5、Claude Opus 4.8、Gemini 3.1 Pro 等所有前沿模型的水平。这个成绩来自真实的电商商品审核工作流,用同一套工具、同一批数据、…