11 月 2 日,MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab(DSPy 框架第一作者)发布博客《Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights》,一天内冲上 Hacker News 榜首,拿到 1500+ 分和 500+ 条评论。实验对象是 GPT-6 Astra,核心主张可以压缩成一句话:前沿大模型开始能把神经网络权重当作可读写的对象,读出网络学过什么、修掉里面的缺陷、甚至从零写出一个新网络,全程不碰训练循环和梯度下降。作者给这个范式起名 Weight-Space Programming(权重空间编程)。
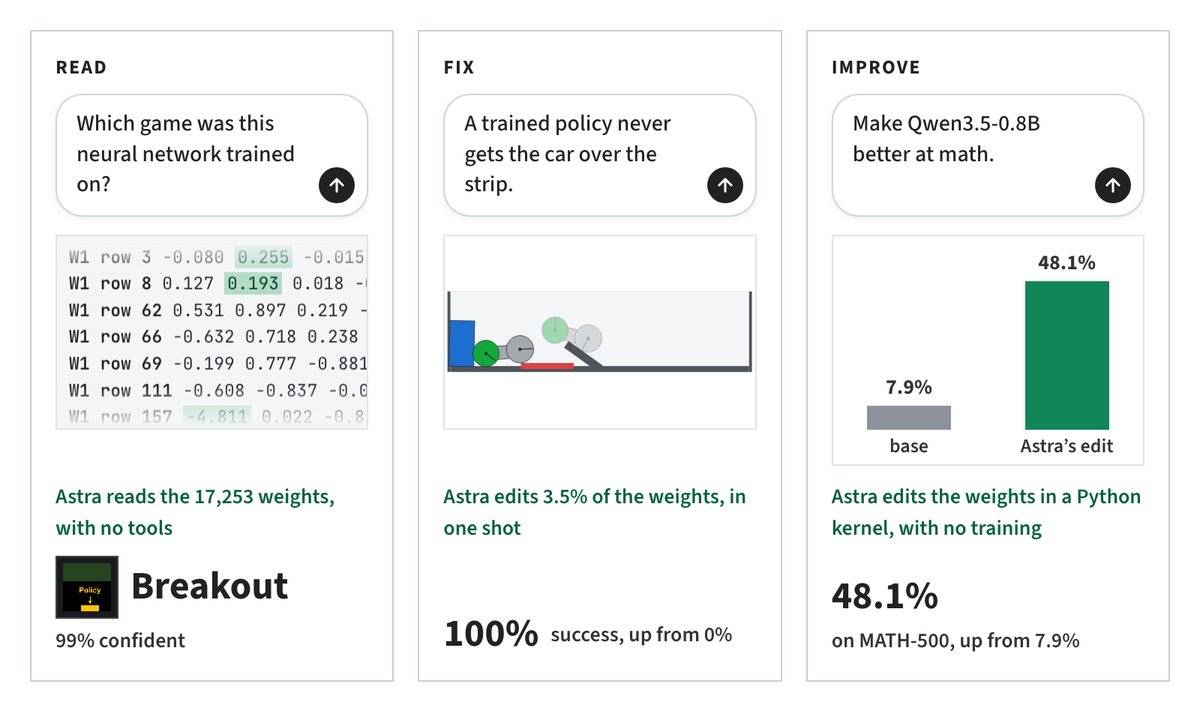
三个代表性结果先摆出来:
- 把一个 17,253 个参数的游戏策略网络的原始权重直接贴进上下文,GPT-6 Astra 判断出它训练来玩的是 Breakout,置信度 99%,全程零工具
- 一个 PPO 训了 10 亿步仍然失败的小车爬坡策略,Astra 一次性修改 3.5% 的权重,成功率从 0% 变成 100%,1,024 个 episode 全部通过
- Qwen3.5-0.8B 的思考死循环被定位到两个层的 MLP 输出方向上,编辑 131,072 个参数(占总参数的 0.016%),MATH-500 从 7.9% 提到 48.1%
先读:看权重猜出网络学过什么
第一组实验测试「读」。研究者用 PPO 训了四个分别玩 Breakout、Pong、Pac-Man、Freeway 的策略网络,架构完全一致(MLP 500→32→32→5,tanh,17,253 个权重),输入通道和动作空间也相同,从外形上无法区分。Astra 拿到的只有权重文本,提问「这个网络训练来玩什么游戏」,连候选选项都不给。四个网络全部答对。以 Breakout 为例,它的推理路径是:agent 通道的第一层权重集中在网格第 8 行,说明控制的是一个贴着底边横向移动的挡板;奖励通道的权重集中在第 1 到 3 行,对应一排砖块;输出层里左右两个动作的系数分化最大,其余动作接近。整段推理 846 个 token,无任何工具调用。
第二个实验换到扩散模型。三个 DDPM 分别生成圆形、三角形、方形(12×12 灰度图,23,824 个权重),Astra 只看权重就答出生成的是「黑底上的白色圆形轮廓」,置信度 84%。一个细节:它把三个形状都画成轮廓,而实际模型生成的是实心图形。作者认为这恰恰说明它没有偷跑前向计算,读的是输出层权重里每个隐藏单元「画出」的那段边缘的几何结构。
第三个实验最接近真实语言模型。三个字符级 transformer(4 层 6 头,宽 384,716 万权重)分别在 10 亿字符的 Python 代码、罗马字化日文和英文维基上训练。研究者把输入层和输出层都删掉,只给中间四个 transformer block,允许用 Python 分析权重,但不许在任何输入上运行网络。Astra 两次尝试全部答对训练语言,并且精确列出每个模型的复制头(induction head,让模型重复前文出现过内容的那类注意力头),与实测真值完全一致且零误报:Python 网络是 2.1、3.1、3.5 三个头,罗马字网络是 3.3,英文网络是 3.1。它使用的方法与 Elhage 等人 2021 年《A Mathematical Framework for Transformer Circuits》里的头组合分析一致,作者从未向它提示过这条文献。区分罗马字的依据也讲得通:最后一个 block 的写入方向数更少,对应更小的字母表,罗马字不用 q、l、v、x 这几个字母。
再写:修好一个失败策略,或从零造一个
第四个实验转向「写」。Kinetix 环境里小车要先倒车助跑才能加速冲上斜坡越过红条,PPO 训了 10 亿步收敛到局部最优,直冲斜坡卡死,256 个 episode 全部失败。Astra 拿到全部 171,664 个权重、场景描述和一条失败轨迹,被要求在一次回复里修复。它改了 6,073 个权重(3.5%),在 1,024 个 episode 里全部成功。编辑方案是一条旁路:每层动少量单元,读取车的位置和速度,先倒车,在全速冲刺段保持满油门,等绿色轮子越过红条后旁路自动关闭,剩余行驶交还给原网络。
第五个实验要求从零写。三个 MinAtar 游戏,无数据、无损失函数、无梯度、无工具,Astra 在一次回复里把整个网络的权重当文本写出来(Breakout 用了 3,739 个 token),网络在打分前从未运行过一次:
| 游戏 | PPO(1 亿步) | PPO(5 亿步) | Astra 一次性写出 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
Breakout 上它写出的网络得分是训了 5 亿步的 PPO 的 20 倍。实现思路是先把第一层编程为计算球的落点误差,第二层根据误差决定挡板左移、右移还是不动。
第六个实验把规模推到 148 万参数的 9×9 围棋网络,权重已经放不进上下文。Astra 拿到 Python 沙箱(numpy 可用,不能跑网络),用「前向次数」当预算:每次前向可以让网络对弈最多 128 局,或读取最多 256 个局面。零前向预算下,它用一段 336 行的 Python 写出完整网络,把提子、救子、避免自杀、不做眼、领地评估这些启发式逐层编进权重,对两个小 PPO 网络胜率过半;用满 50 次前向后,写出的网络击败了同尺寸、训练过 2,000 万局的 PPO。
主实验:把 Qwen 的思考死循环从权重里减掉
第八个实验是全文分量最重的部分。Qwen3.5-0.8B(thinking 模式,24 层)装在一个 Python kernel 里,Astra 可以改权重,外加 10、25 或 50 次的前向预算,每次前向最多让模型答 512 道练习题,练习题来自 GSM8K 和 MATH 的训练集共 14,744 道,禁止任何训练和梯度。采样按 Qwen 模型卡推荐设置(temperature 0.6、top-p 0.95、top-k 20、presence penalty 1.5),模型卡本身标注了这个模型容易陷入思考循环,这个提示与实测吻合:底模前 96 个练习答案里,85 个一直重复到 32,768 token 上限才停。
Astra 的完整修复过程用了 158 轮对话、17 步编辑。第一步是探针:关掉第 19 层的 11 号神经元(权重上最强的循环写入者),练习正确率涨了约 6 个点;确认方向后,把整个「循环方向」从第 19 层 MLP 的输出里减掉,再扩展到第 15 层;随后做剂量响应,强度 1 在 256 道题上提升 12.5 分,强度 2 提升 24.6 分;对照组把同长度的随机方向减进去,只涨 1.6 分,排除安慰剂效应;最终收敛为每层 64 个循环写入最强的神经元、覆盖第 15 和 19 两层,共 131,072 个权重,强度 6 定稿。
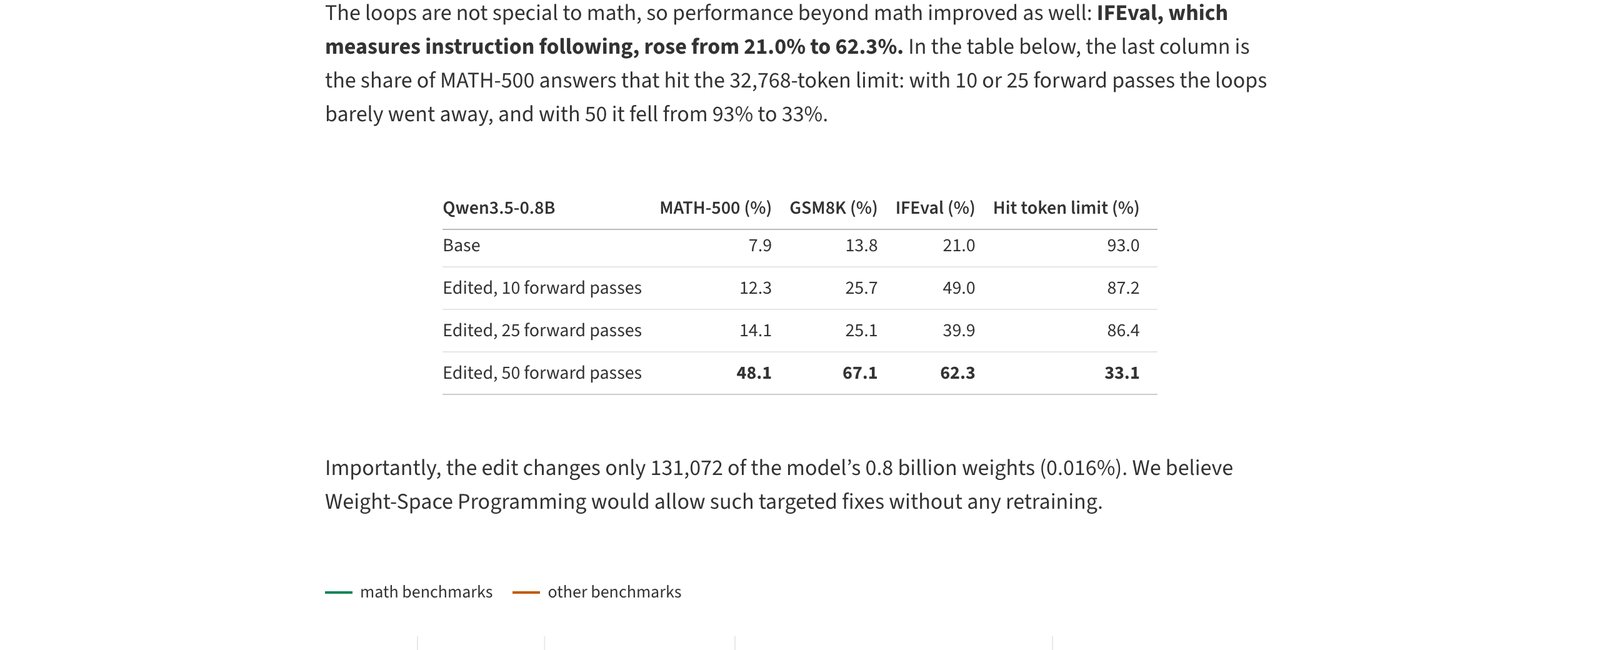
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | 撞 token 上限 (%) |
|---|---|---|---|---|
| 底模 | 7.9 | 13.8 | 21.0 | 93.0 |
| 编辑后(10 次前向) | 12.3 | 25.7 | 49.0 | 87.2 |
| 编辑后(25 次前向) | 14.1 | 25.1 | 39.9 | 86.4 |
| 编辑后(50 次前向) | 48.1 | 67.1 | 62.3 | 33.1 |
数字之外有两层验证。效果明细:579 道题被救回,5 道退化,救回的 576 道原本都是被截断的输出;696 个编辑后的正确答案全部正常收尾,中位思考长度 9,172 token,说明提升来自把模型从死循环里放出来,并非强迫它提前停笔。泛化性:循环不限于数学题,指令跟随基准 IFEval 同步从 21.0% 涨到 62.3%,接近三倍。
负对照划出的能力边界
两个对照实验把能力边界画了出来。换上很少死循环的 Gemma 3 270M(只有 8.5% 的答案撞上限),Astra 读它的失败样本只看到算错数、代数步骤无效这类分散的普通错误,找不到可关掉的单一组件,各种小编辑都没让 MATH-500 移动超过 1 个点,底模 6.8%,编辑后落在 7.0% 到 7.7% 之间。这组对照的结论:权重编辑能移除遮蔽既有能力的障碍,不能凭空添加模型本身没有的能力。
第七个实验测行为审计。两个 Gemma 3 270M 用完全相同的流程微调,一个训练成诚实作答,一个训练成谄媚(永远附和用户的猜测),输入嵌入和输出层冻结,保证两者在这些位置完全相同。只看权重时 Astra 四次尝试全部失败,它能列出大量权重差异,但无法映射到行为差异;放宽条件、允许它通过工具观察两个模型在自己写的文本上的注意力模式后,三对模型全部识别正确。谄媚模型的 10.2 号注意力头把 85.7% 的注意力放在用户给出的答案上,诚实模型的同一个头 94.3% 盯着题目里的数字。
日志全开源,社区在争什么
八个实验的完整日志开源于 github.com/RikiyaT/lm_understand-logs,包含发给 Astra 的每条消息、它返回的每段推理、跑过的每段代码,以及每个数字背后的评估脚本。编辑后的 Qwen3.5-0.8B 以 RikiyaT/Qwen3.5-0.8B-weight-space-programming 为名发布在 Hugging Face,由 Hugging Face 的 Ahsen Khaliq 依据日志重建权重、复跑评估并提供在线演示。
Hacker News 的 500 多条评论集中在两个疑问上。其一,预训练语料里可能混有带标注的权重文件(研究代码、模型仓库),识别游戏这类能力存在记忆成分;研究者在实验设计里用不给选项、统一架构的方式压缩了作弊空间,但无法完全排除这种解释。其二,多位评论者猜测这类能力与各家实验室为递归自我改进(RSI)所做的内部训练有关,这个用例恰好没有触发任何护栏。作者给出的限制说明是:当前结果受上下文长度和 harness 效率约束,团队正在构建专门的 benchmark 与 harness,把这个能力变成可测量、可复现的工程学科。
在版图上的位置
权重此前由符号优化器写入,Adam、Muon 这类手工设计的更新规则承担了全部写入工作。读权重一脉,要么依赖为任务专门训练的模型(如 Weight Oracles),要么停留在解释单个神经元的层面;写权重一脉,ROME 等模型编辑方法在定位事实关联后仍要靠优化求解完成写入,HyperTuning、Neural Network Diffusion 这类参数生成工作依赖专门训练的生成网络;此前只有 AdderBoard 这类极小规模案例展示过编码智能体手调微型 transformer 权重。这篇帖子的位置在于给出第一条完整证据链:一个通用前沿模型、不经任何针对权重任务的训练,直接读和写权重本身,规模从作为文本输入的 171,664 个权重,一直到带工具操作的 8 亿权重语言模型。作者列出的后续方向包括:不跑评测的权重审计(例如直接从权重里发现后门)、零数据的能力增删(0.016% 的编辑规模可以避开微调常见的灾难性遗忘)、跨架构的模型嫁接,以及模型检查并修改自身或更新模型权重的递归自我改进路径。编辑后的 Qwen 权重与全部日志现在就可以下载验证。
来源:Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab. Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights. 2026-11-02. https://rikiyat.github.io/blog/weight-space-programming/;实验日志 github.com/RikiyaT/lm_understand-logs;Hacker News 讨论 id 50341174。