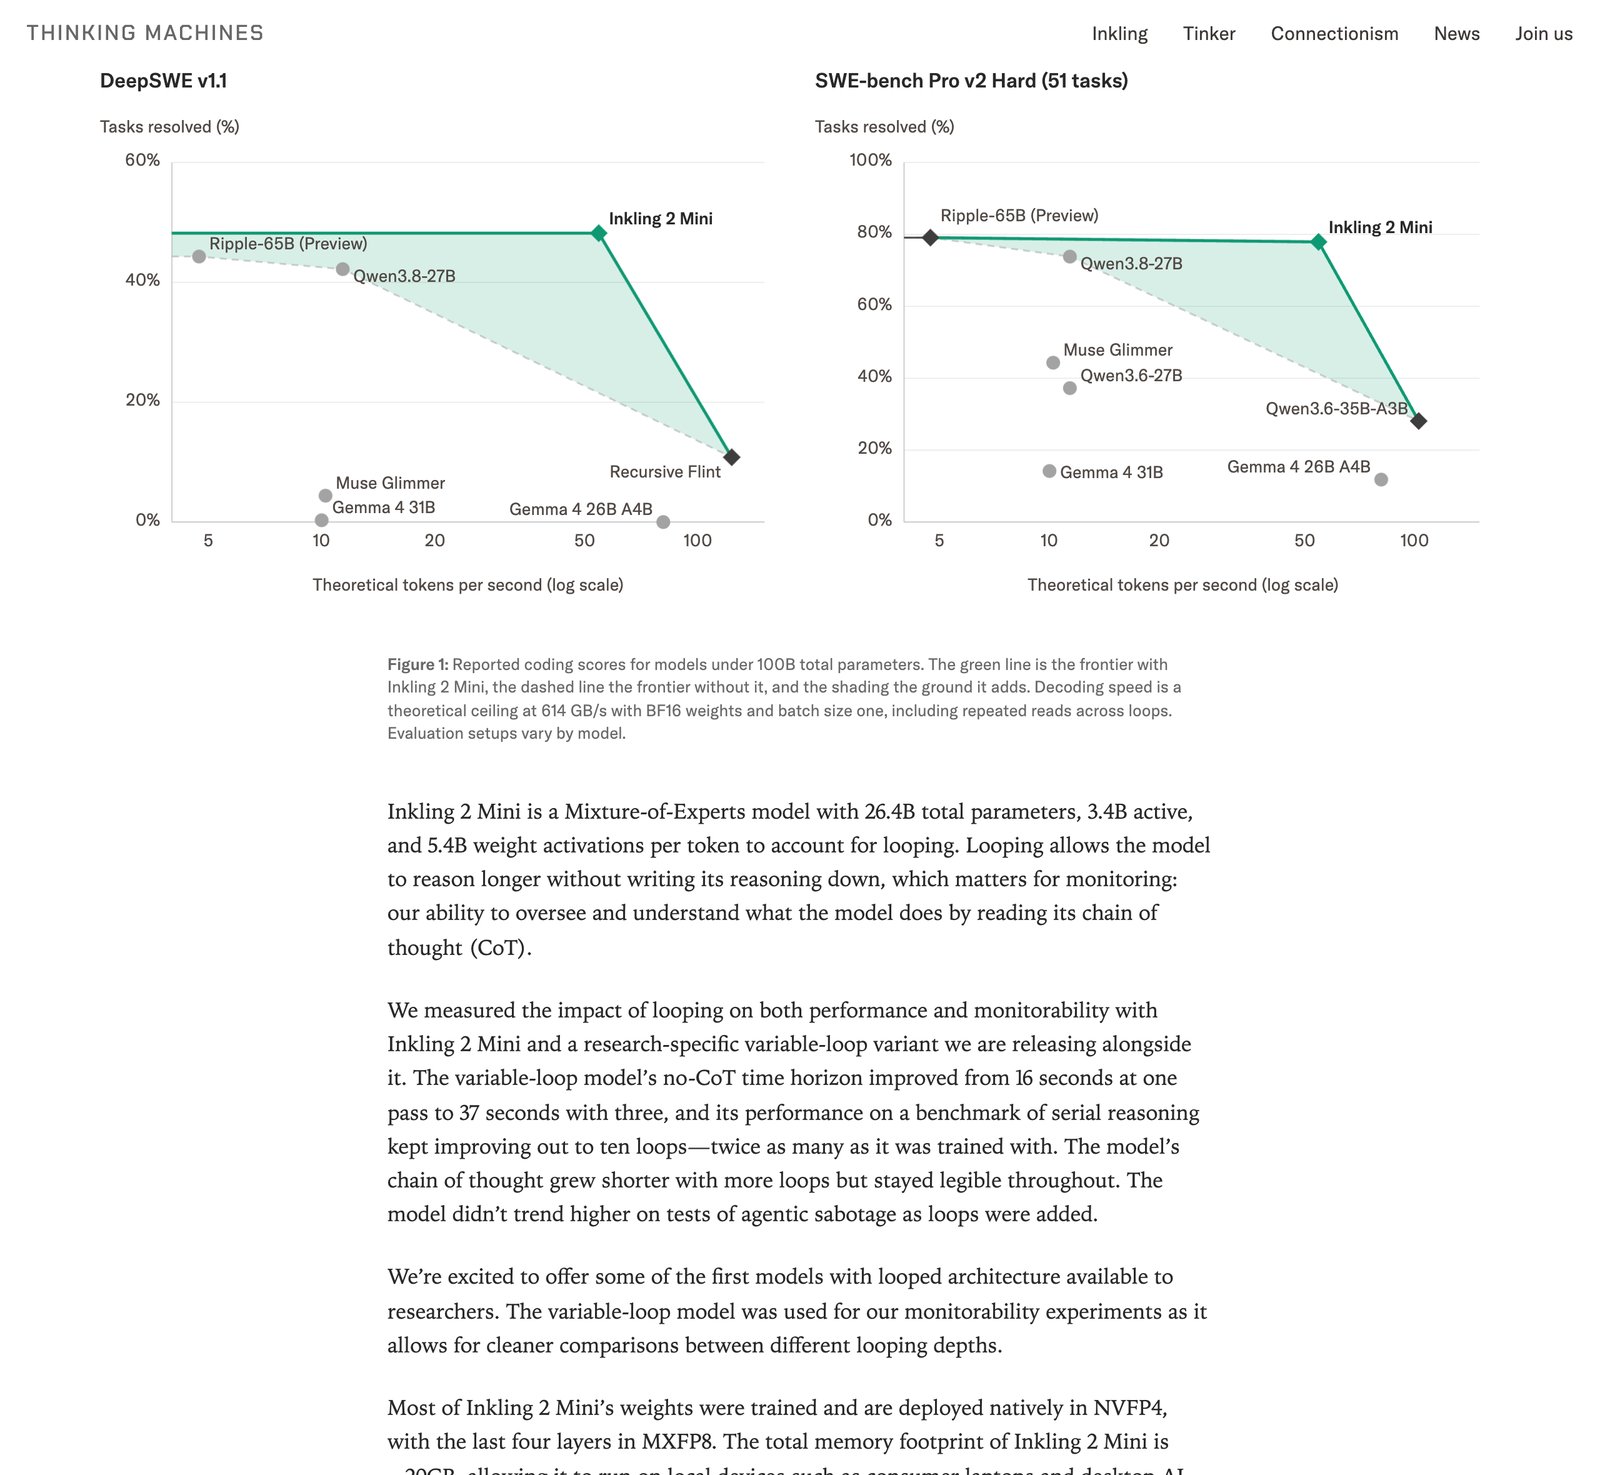
2026 年 11 月 20 日,Thinking Machines 发布 Inkling 2 Mini:26.4B 参数的循环 MoE 模型,官方口径总内存占用约 30GB,定位是笔记本可跑的开放权重模型。两天后,Hacker News 首页出现了另一个数字:3.85 GB。一个叫 LookAtMyQuant 的单人开源项目把这个模型的文本权重从 18.89 GB 压缩成六个体积档,最小一档装得进 8 GB 内存的 iPhone。这条帖子拿到 460 分、117 条评论,评论区吵的问题很集中:一个原生就用 4bit 精度训练和部署的模型,为什么还能再压掉 80% 的体积。
一个本来就在 4bit 里训练的模型,为什么还能再压
先把质疑讲清楚。Inkling 2 Mini 的权重从预训练到 RL 阶段全程跑在 NVFP4 精度上(专家层,NVIDIA GB300 平台有专门加速内核),最后四层用 MXFP8,发布的是一个约 20 GB 的混合精度单检查点。HN 评论区因此出现质疑:QAT(量化感知训练)出来的模型本身对量化误差已经有耐受性,对着它再做一次训练后量化,收益从哪来?
答案藏在设备谱系里。约 30GB 的占用意味着 32GB 内存的 Mac 才勉强够跑,16GB 机型直接出局,iPhone 连讨论资格都没有。LookAtMyQuant 做的事情超出现有检查点上省几个 GB 的空间:它把运行门槛从 32GB 一路铺到 8GB,先把权重还原成 BF16 参照,再重新编码到 1.18 到 3.92 bits per weight 的区间,配合全 MoE 的近端正则微调,让超低比特下的输出质量撑得住。
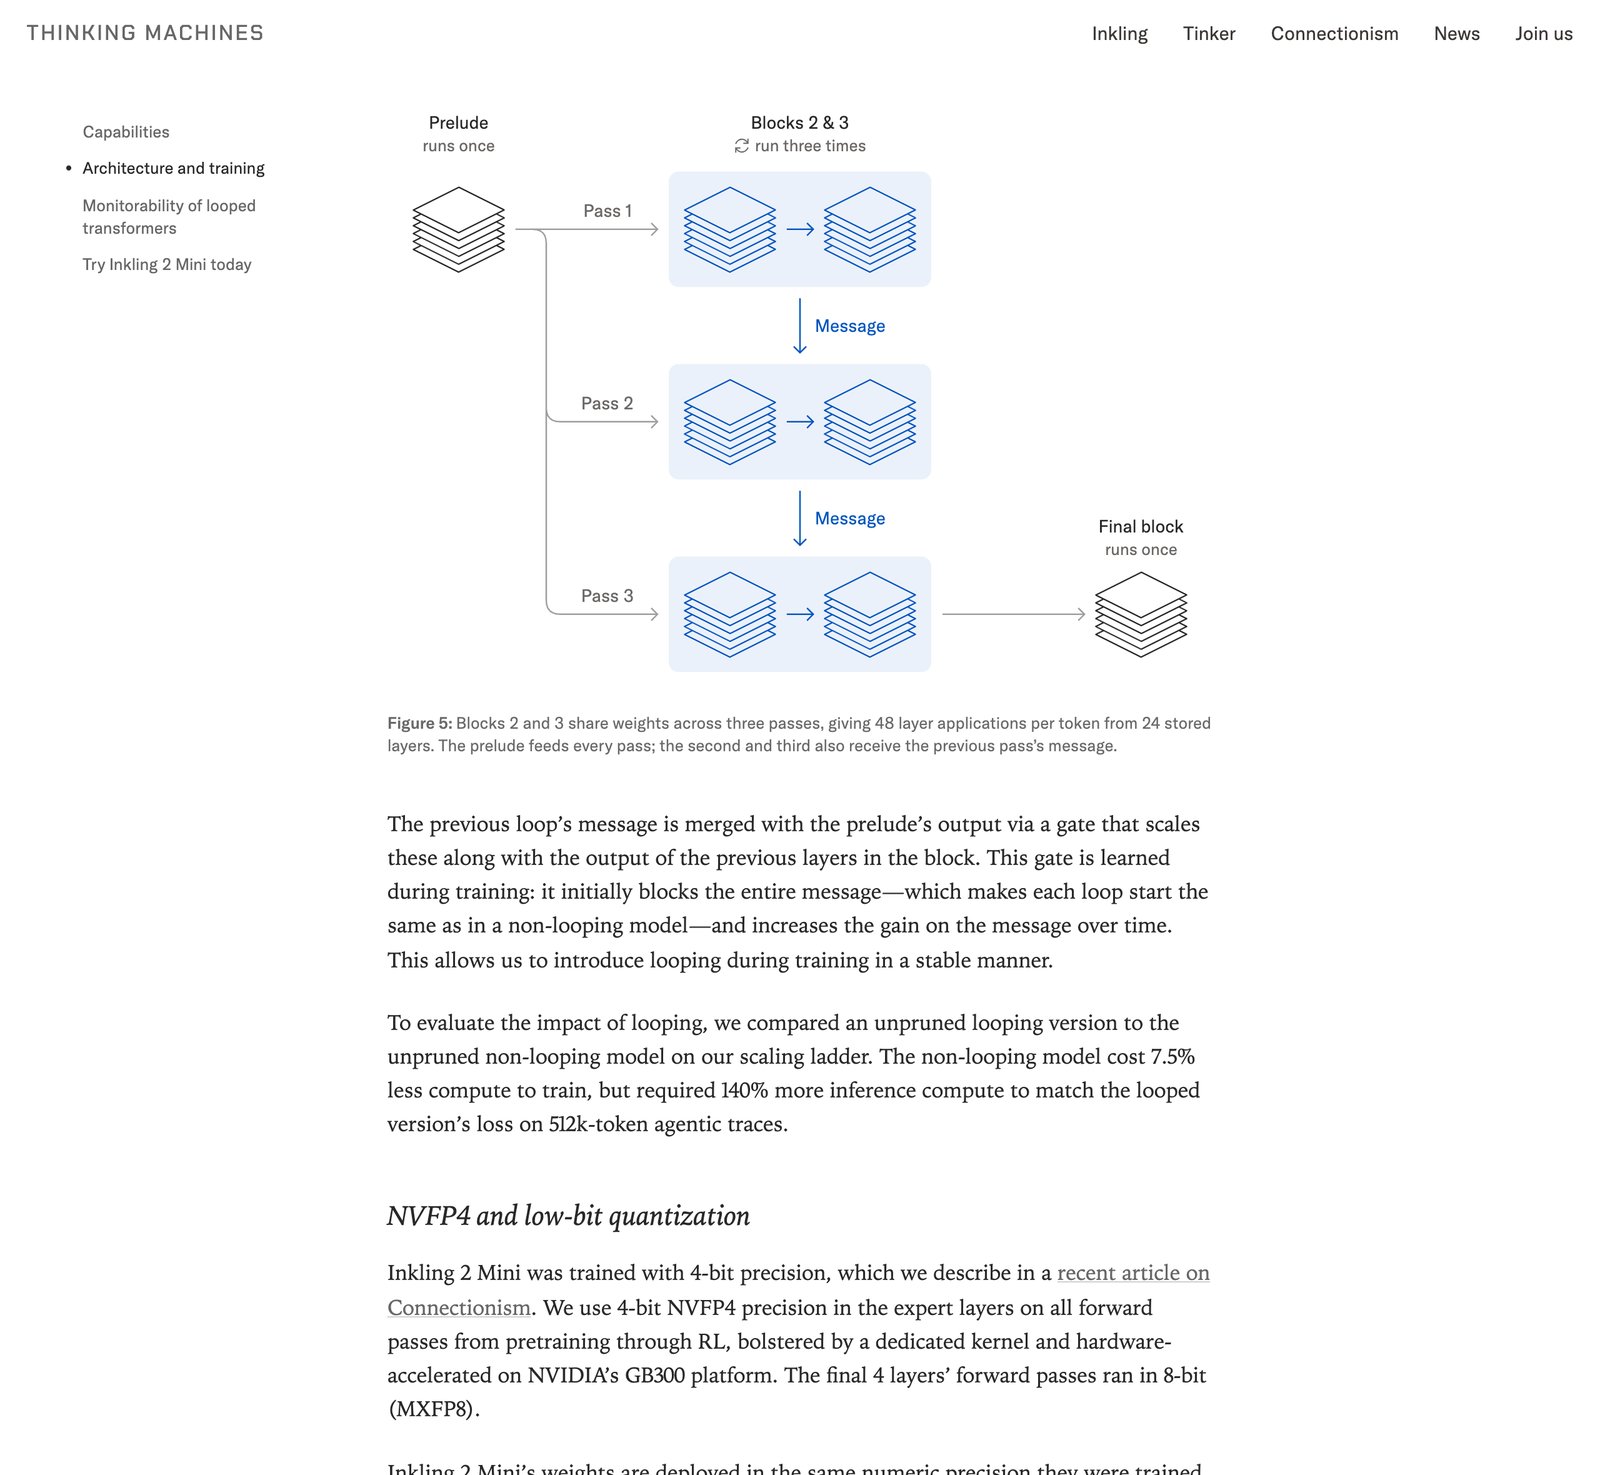
这个模型的结构也让压缩的性价比变高。Inkling 2 Mini 是循环 transformer:24 个存储层中,中间的 Blocks 2 与 3 每个 token 要跑三遍,全模型每个 token 完成 48 次层应用,上一轮循环的输出通过一个可学习的门控合并进下一轮。Thinking Machines 的对照实验显示,非循环版本训练算力省 7.5%,但要匹配循环版在 512k-token 智能体轨迹上的损失,推理算力要多花 140%。对本地部署来说,权重每读一次都算内存带宽:3× 循环意味着同一份权重的读取次数是普通模型的数倍,权重体积每压小一档,解码速度跟着受益。
编译器的工作方式:测量、分配、构建
LookAtMyQuant 自称量化编译器,工作流分三步。第一步测量:把模型拆成一个个存储单元,每次只压缩一个、其余保持精确,记录每个单元被压缩后对输出分布造成的 KL 散度伤害。仓库里 SmolLM2-360M 的完整测量是 2,312 次,在一张 L40S 上跑约 50 分钟。第二步分配:在给定体积预算内,为每个单元挑一个编码方案,使总伤害最小,这一步不需要 GPU。第三步构建:按计划逐矩阵量化,输出可运行的模型文件并报告困惑度和 KL。
编码方案本身是这个项目的核心。它用 trellis 码(格码)沿权重矩阵的行编码:ht2/ht3 是散列块向量格码,按 4 KB SRAM 的容量设计,解码时由自定义 Metal 内核执行;rtr1/rtr4 是行级格码,保证解码一个条目只读一行。比特预算按行分配,依据是 Fisher 信息——对输出更敏感的行拿到更多比特。在 Gemma 4 E2B 上,同体积的 trellis 方案 KL 比 llama.cpp 生态常用的 Q4_K_M 低 12 倍。
对 Inkling 2 Mini 这种 26.4B 物理 / 5.4B 有效激活的 looped MoE,编译器还留了一条后门:对最敏感的专家桶直接做原生 NVFP4 直通,一点误差不加。12.76 GB 档有 109/192 个专家桶、11.18 GB 档有 69/192 个专家桶保持 0.0 误差直通,注意力投影和 lm_head 尾桶另设精度下限。
六档体积,从无损等价到 iPhone
六个 MLX 构建档位的完整读数如下(评测口径:greedy 解码、max_new_tokens 1536、reasoning_effort 关闭,GSM8K 取 test 前 200 题,HumanEval 取全部 164 题严格执行;视觉塔 637MB BF16 原样保留,六档视觉测试全对):
| 构建 | 文本体积 | bpp | GSM8K | HumanEval 严格 | 三任务均值 | 定位 |
|---|---|---|---|---|---|---|
| BF16 教师 | 18.89 GB | 5.80 | 193/200 (96.5%) | 152/164 (92.7%) | 100.0% | 参照 |
| 12.76 GB | 12.76 | 3.92 | 193/200 (96.5%) | 152/164 (92.7%) | 100.0% | 无损等价 |
| 11.18 GB | 11.18 | 3.43 | 190/200 (95.0%) | 151/164 (92.1%) | 99.3% | 近无损 |
| 8.87 GB | 8.87 | 2.72 | 192/200 (96.0%) | 149/164 (90.9%) | 99.2% | 甜点位 |
| 5.38 GB | 5.38 | 1.65 | 174/200 (87.0%) | 117/164 (71.3%) | 89.0% | 16GB Mac |
| 4.72 GB | 4.72 | 1.45 | 165/200 (82.5%) | 110/164 (67.1%) | 86.0% | 12GB iPhone |
| 3.85 GB | 3.85 | 1.18 | 157/200 (78.5%) | 79/164 (48.2%) | 77.8% | 8GB iPhone |
12.76 GB 档在全部 349 个池化测试点上与 BF16 教师完全一致,内存少 32.5%。8.87 GB 档保留 99.2% 均值,与 Unsloth 同尺寸的 9.14 GB UD-Q2_K_XL GGUF 相比,英语/聊天/代码混合上的 KL 低 2.34 倍(0.0208 对 0.0486),13 种语言整体 KL 低 29.6%。5.38 GB 档把 GSM8K 保到 87.0%,HumanEval 严格执行仍有 71.3%,top-1 输出一致率 90.0%。
2bpp 以下:微调把静态量化的崩溃救回来
下表下半区的数字背后有一道技术分水岭。直接对 Inkling 2 Mini 做 1.18 bpp 的静态训练后量化,GSM8K 掉到 1.0%、HumanEval 掉到 1.8%,模型基本报废。撑住 3.85 GB 档 78.5% GSM8K 的是 SQYFR v2:一种全 MoE 近端正则微调,把 24.46B 专家参数和 130-144 个注意力格码投影一起训练,训练数据是 BF16 教师自己的推理轨迹回放,控制边界 token 加权 6.0 倍,训练中实时维护满秩 Hessian 投影,最后跟 250 步连续缩放与转向抛光。静态量化报废的区域,微调后每个档位都爬回了可用区间。
iPhone 档的体积选择也精确到系统约束。12GB iPhone 的 Jetsam 杀后台阈值在 5.99 GiB,4.72 GB 档把活跃内存压到 4.35 GiB、解码峰值 5.35 GiB,旁边还塞得下 179 MB 的推测解码草稿模型;8GB 设备用的 3.85 GB 档活跃内存 3.54 GiB、峰值 4.57 GiB。
跑起来的速度
权重体积直接换解码带宽。M5 Max 上的实测读数:
| 构建 | 预填 tok/s | 串行解码 | 带草稿模型中位数 |
|---|---|---|---|
| 12.76 GB | 2,016 | 60.5 | 112.7 |
| 11.18 GB | 2,032 | 62.4 | 103.7 |
| 8.87 GB | - | 63.5 | 106.0 |
| 5.38 GB | 1,807 | 75.3 | 124.4(数学 142.9) |
| 3.85 GB | - | 75.5 | 103.1 |
体积最小的档位串行解码反而最快(75.3 与 75.5 对 60.5),内存带宽限制下小权重的读取优势盖过了精度开销。推测解码用 178.9 MB 的 4bit DSpark 草稿模型,一次提出后续七个 token、主模型单次校验,采样过程保持精确无偏,文本与串行 greedy 逐字一致。
生态边界需要说清楚:六档发布件全部走 MLX 运行时和自定义统一 Metal 内核(M5 的 MetalPerformancePrimitives 预填、FlashAttention-2 SDPA),今天在 llama.cpp 里跑不了。仓库里留了 gguf_compiler.py,能在 llama.cpp 自身的张量类型上生成计划并直接运行,但 Inkling 系列的 trellis 码与草稿模型还没有 llama.cpp 内核。
复现成本
这套东西的可复现性写在仓库里。Qwen3.5-4B 压到 1.23 GB 的完整配方(校准、行重要性测量、构建、4,000 步蒸馏微调、评测)在 Modal 上一 GPU 一任务跑完,总花费约 34 美元;草稿模型用 SpecForge 训练花 42 美元。Gemma 4 E2B 的测量在 H100 上单任务 7 到 26 分钟。Inkling-2-Mini 六档的构建走同一条管线。代码 MIT 协议,Apple Silicon 上 pip install git+https://github.com/ShinMegamiBoson/lookatmyquant.git 装出 lamq 命令,lamq generate shinmegamiboson/Inkling-2-Mini-LookAtMyQuant-5.4GB 一行就能跑;Python 侧 runtime_mlx.load 返回兼容 mlx_lm 生成接口的模型与分词器。
这个项目由一个贡献者维护,og 卡片渲染时的星标数是 341。六档构建全部放在 Hugging Face 的 shinmegamiboson 名下。
来源: