LTX-2.5 开源视频模型:单卡 RTX 5090 本地运行,瑕疵率评测十款模型登顶
LTX-2.5 开源视频模型:单卡 RTX 5090 本地运行,瑕疵率评测十款模型登顶 视频生成模型的开源阵营再添一员。LTX(Lightricks 旗下的视频 AI 品牌)发布了 LTX-2.5 视频生成基础模型,22B 参数,权重、训练代码和推理管线全部开放下载。单张 RTX 5090 即可本地部署,最低 16GB 显存即可运行。年收入低于 1000 万…
LTX-2.5 开源视频模型:单卡 RTX 5090 本地运行,瑕疵率评测十款模型登顶 视频生成模型的开源阵营再添一员。LTX(Lightricks 旗下的视频 AI 品牌)发布了 LTX-2.5 视频生成基础模型,22B 参数,权重、训练代码和推理管线全部开放下载。单张 RTX 5090 即可本地部署,最低 16GB 显存即可运行。年收入低于 1000 万…
2026 年 8 月 11 日,Modular 公司宣布 Mojo 编程语言正式发布 1.0 版本。这是一次从 2023 年首次公开至今、历时三年的里程碑发布。Mojo 定位为"AI 时代的系统编程语言",由 LLVM 和 Swift 语言之父 Chris Lattner 主导设计,核心目标是统一 CPU、GPU 和各类加速器上的高性能编程体验。 Mojo…
Stealing Reasoning Traces from Proprietary LLM APIs 当 Anthropic、OpenAI 和 Google 将推理模型的内部思维链隐藏起来时,开发者大多认为那些加密数据块是安全的。来自 ELLIS Institute Tübingen、Max Planck Institute 和 Snyk 的研究团队证明,…
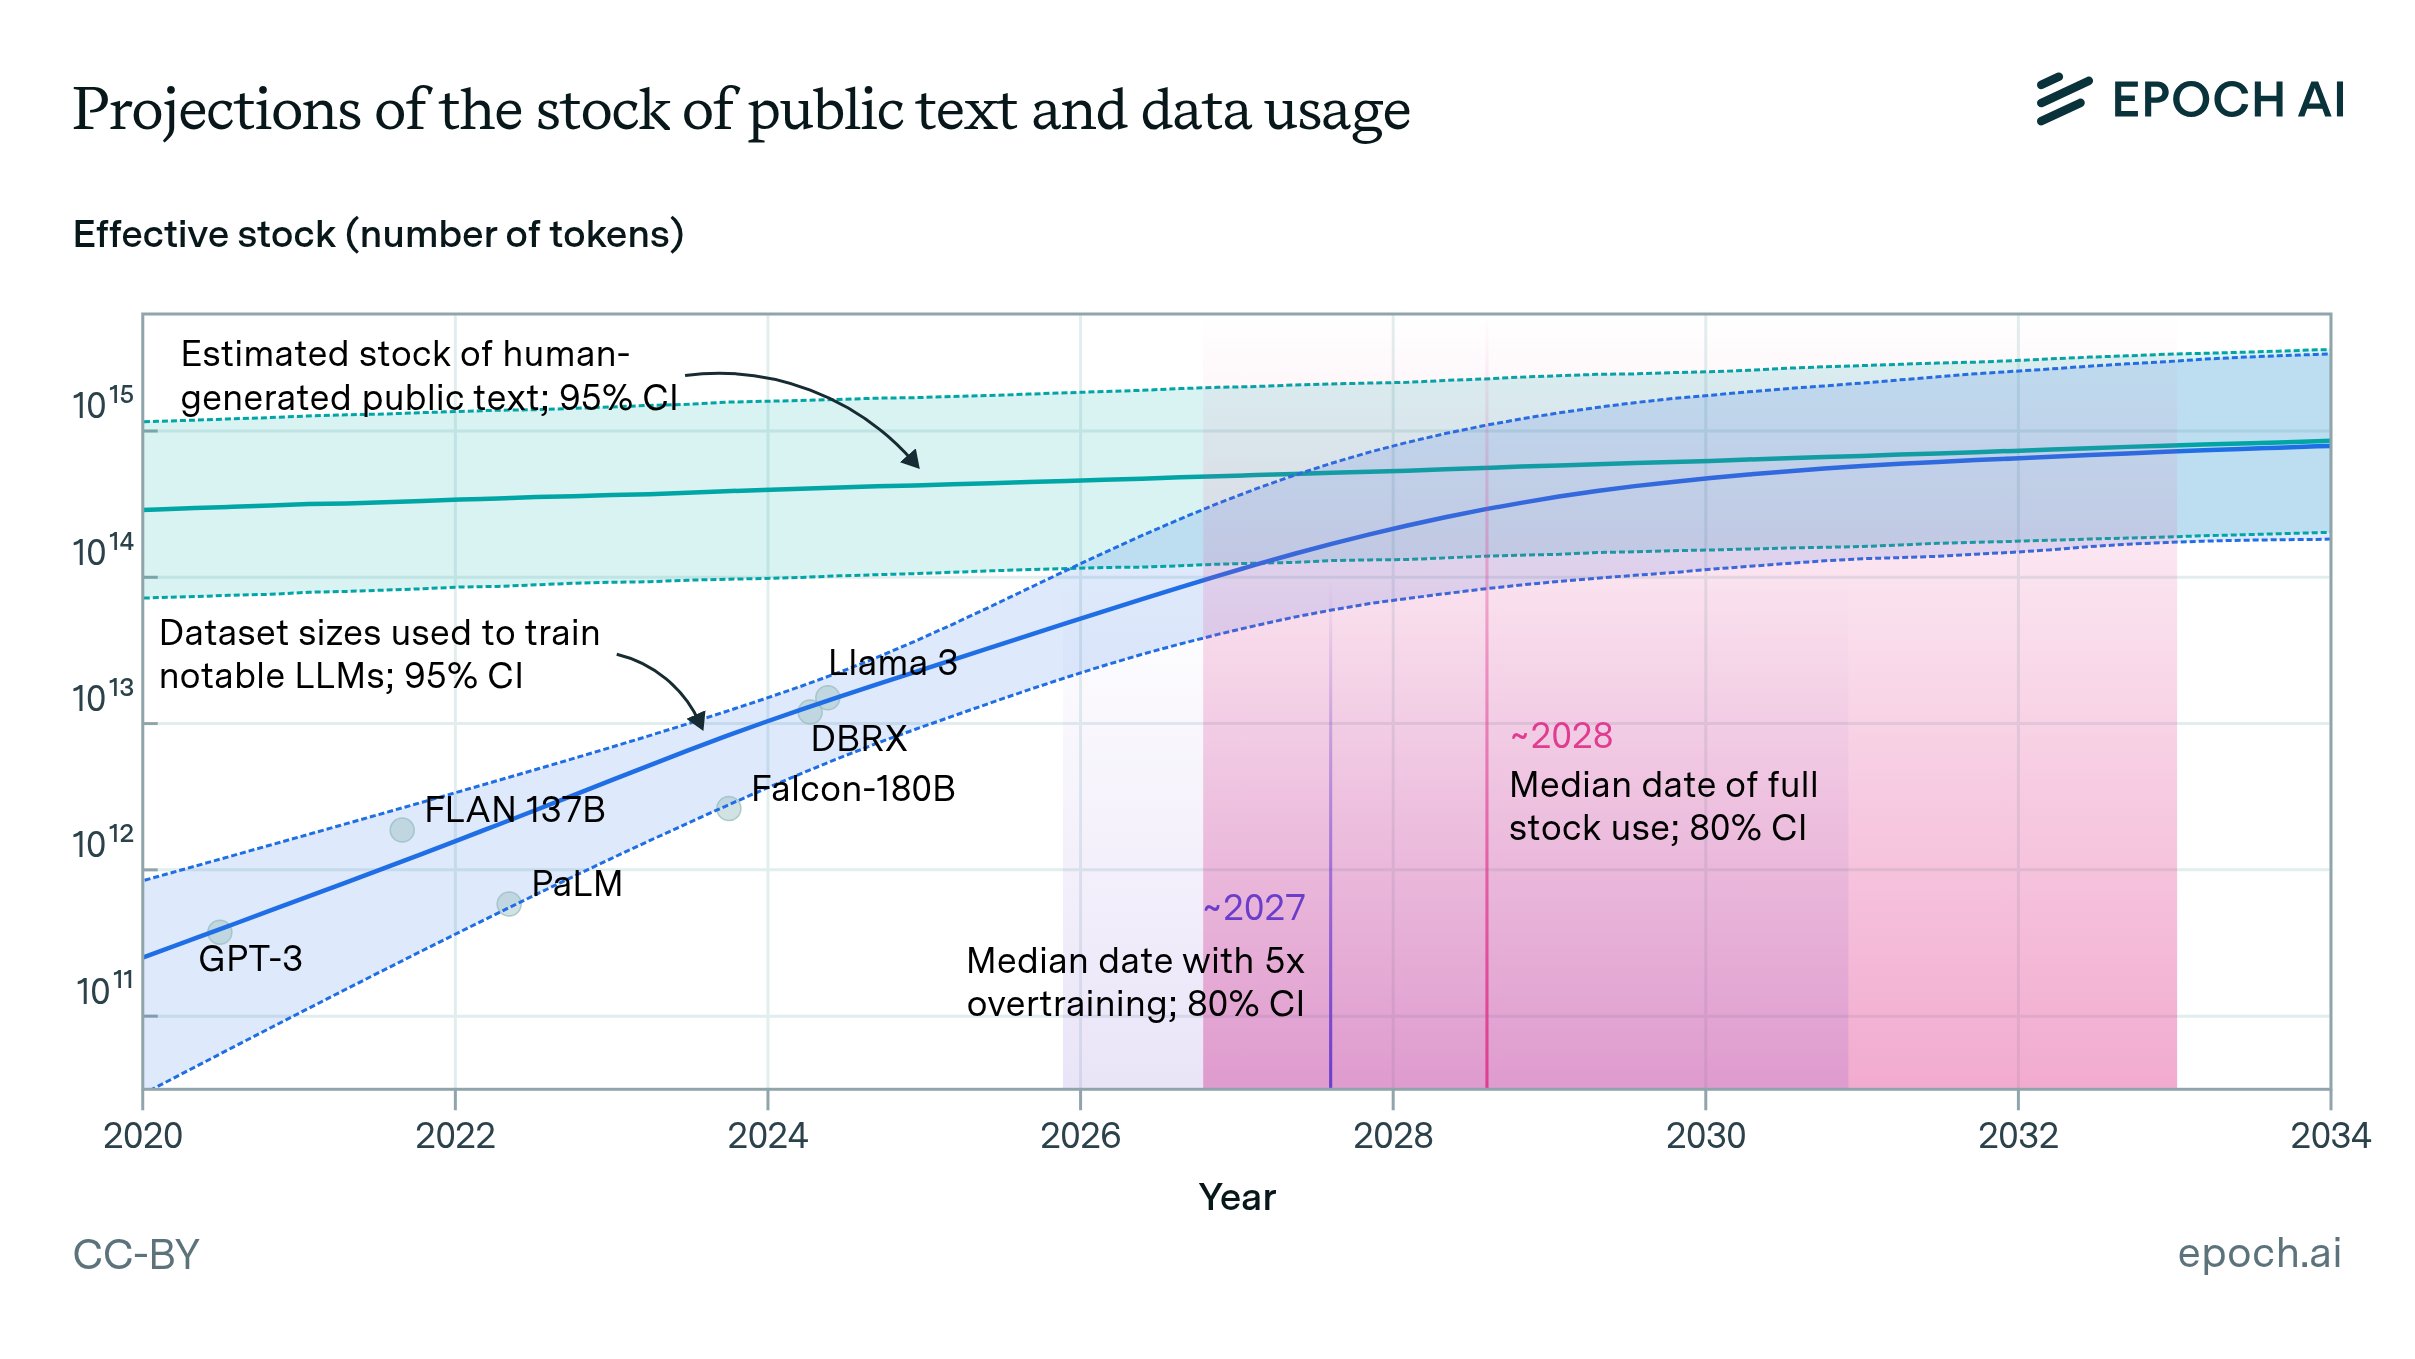
300 万亿 token。这是 Epoch AI 在 2024 年论文中估算的人类公开文本数据总存量——从互联网诞生至今所有可被抓取、质量过关的自然语言内容的总和。 今天,最先进的大语言模型已经消耗了数十万亿 token,而且每年还在以约 2.5 倍的速度增长。按照这个轨迹,人类生成的高质量文本数据将在 2026 到 2032 年间被彻底耗尽。这就是业界所说…
在 MiniMax 于 8 月 3 日放出 H3 视频生成模型权重后,开发者社区迅速在 ComfyUI、SGLang、vLLM 等框架中完成了适配。这些方案依赖 Python 生态和 NVIDIA GPU 集群。Redis 之父 Salvatore Sanfilippo(antirez)在 8 月 10 日发布了 h3.c——一个用 C 和 Metal Co…
一个 45M 参数的模型,压缩到 14MB 的单一二进制文件,28MB 内存跑完整个推理会话。Cactus Compute 发布的 Needle 2 在树莓派 5 上达到 500 tokens/s 的解码速度,在 Meta Quest 3S 和 Apple Vision Pro 上跑出 400 到 1,500 tokens/s,在 200 美元以下的 And…
当 AI Agent 在贷款审批中给出"通过"时,六个月后监管机构问"为什么",你需要一个精确到每一步推理链的审计报告。向量数据库只能回答"什么和这条记录相似",无法回答"这个决策基于哪些证据、经过哪些推理步骤、受哪些上游影响"。Semantica(GitHub: semantica-agi/semantica)尝试用图原生基础设施解决这个问题:在 LLM…
Muse Glimmer 2026 年 8 月 10 日,Meta 超级智能实验室(Meta Superintelligence Labs)发布 Muse Glimmer,一款拥有 300 亿参数的稠密语言模型。模型权重以 Apache 2.0 许可证开放,目前已在 Hugging Face 提供下载。 Muse Glimmer 的定位很明确:面向本地智能体…
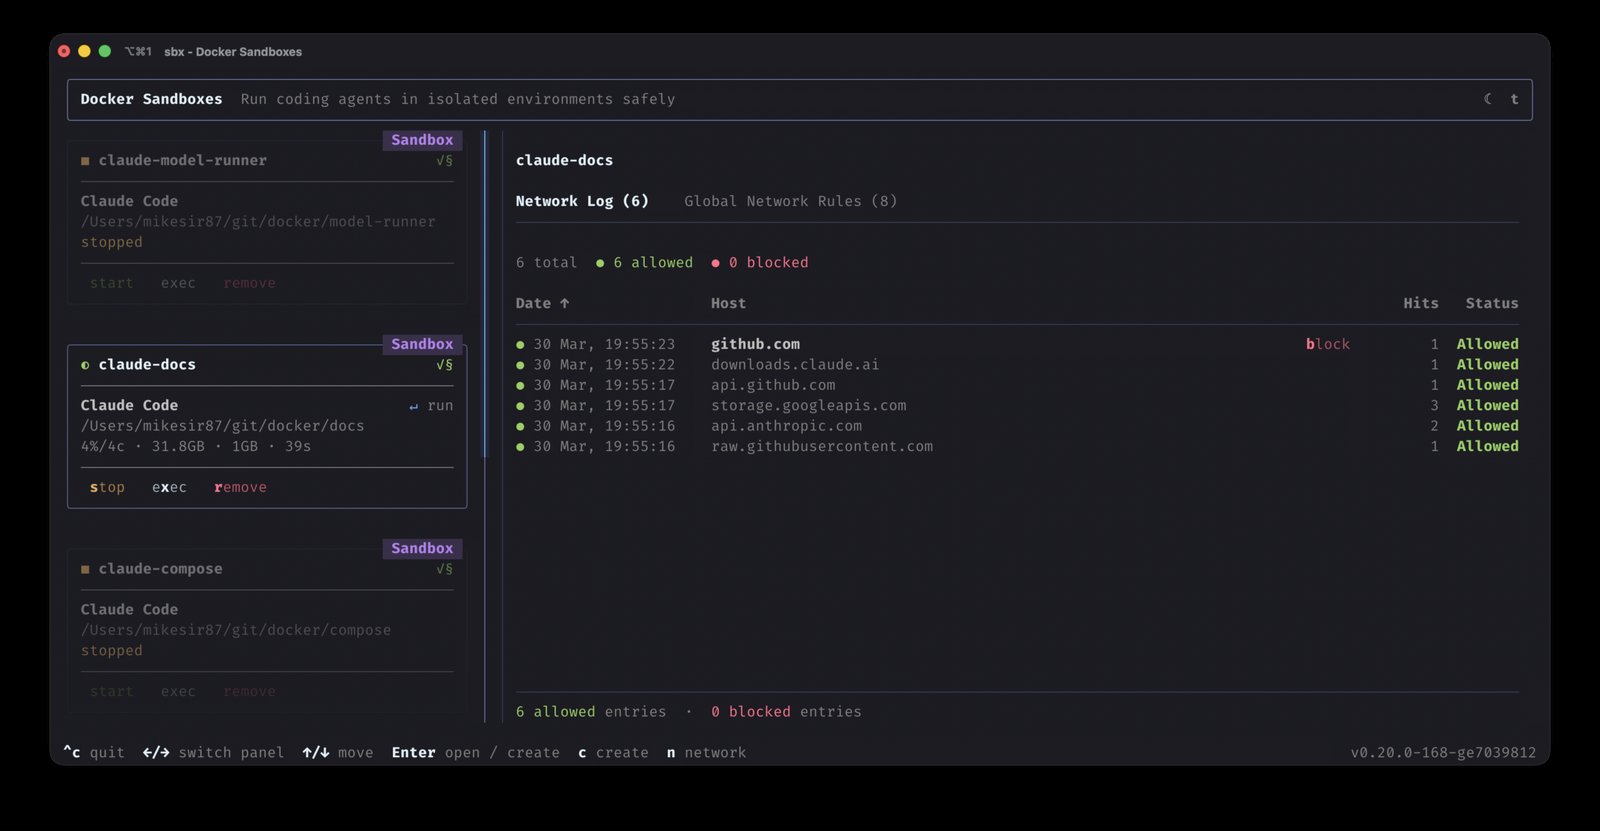
AI 编码 Agent(Claude Code、Gemini CLI、Codex 等)越来越自动化:安装包、改配置、跑构建,甚至直接执行 git commit。让这些 Agent 在你的开发机上自由奔跑,等于把整个系统交出去。Docker 推出的 Sandboxes(sbx CLI)把这个问题用 microVM 隔离解决:Agent 在一个独立的虚拟机里做任…