最新文章
MiniMax H3:全模态视频生成与开源权重本地部署
MiniMax H3 7 月 31 日,MiniMax 发布了第三代视频生成模型 H3。这不是又一个文生视频工具:H3 将文本、图像、视频、音频作为统一上下文输入,生成带原生立体声音轨、最高 2K 分辨率、最长 15 秒的视频片段。两天后,模型权重在 HuggingFace 上线,ComfyUI 完成首日适配。 核心规格 | 参数 | 规格 | |---|-…
PDF 转 Markdown:pdf-inspector 分类与 OCR 路由
PDF 处理系统经常把所有文件交给同一个解析器,遇到扫描件、图片型报告或混合文档时,再用 OCR 兜底。这样做会让本来带有文本层的 PDF 也进入高延迟流程。Firecrawl 开源的 pdf-inspector 把判断步骤独立出来:先识别文档类型,再决定哪些页面可以本地提取,哪些页面需要 OCR,最后把可提取内容整理为 Markdown。 pdf-insp…
英伟达 CMP 170HX 破解:矿卡的三道硬件限制为何能被软件绕过
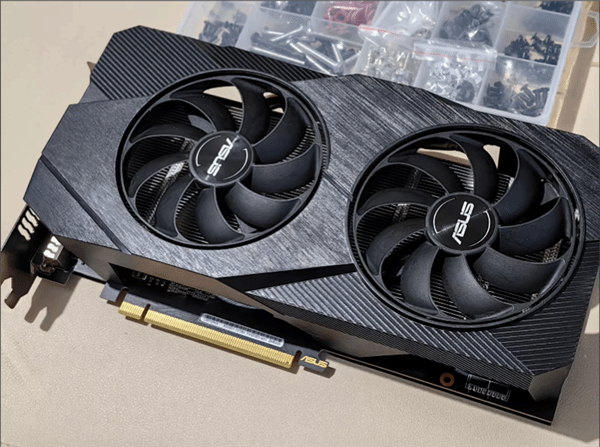
一张 2021 年面向加密货币挖矿的 NVIDIA CMP 170HX,最近重新进入 AI 硬件讨论。亚利桑那州立大学研究者 Jon Pry 在 Zenodo 发布论文,分析了这张卡的 GPU 安全协处理器,并展示了一条从主机侧触发 Falcon HS 模式漏洞的解锁路径。论文给出的结果包括:计算吞吐提升约 31 至 62 倍、可见显存容量提升 8 倍、PC…
CVE-2026-17583:美国法医DNA文件为何可能被无痕篡改
CVE-2026-17583:美国法医DNA文件为何可能被无痕篡改 美国犯罪实验室使用的一类法医 DNA 数据文件,近日被确认存在高危完整性风险。Thermo Fisher Scientific 在 2026 年 7 月 31 日发布安全公告,将问题编号为 CVE-2026-17583,CVSS 4.0 评分为 8.2,严重性为 High。 公告描述的对象是…
Agent Reach:AI Agent 互联网接入指南
Agent Reach 是一个面向 AI Agent 的互联网能力层。它负责选择、安装、检查和路由上游工具,真正读取网页、调用 GitHub、提取视频字幕的动作交给 gh、yt-dlp、OpenCLI、bili-cli、feedparser、Jina Reader 等工具完成。这个分工让项目保持轻量,也让每个平台的登录态、代理和风控差异集中在独立渠道文件中。…
AirLLM:4GB 显存运行 70B 模型的分层推理
AirLLM 是一个面向 Hugging Face 大语言模型的推理库,项目的核心目标是降低推理阶段的显存占用。官方 README 给出的典型配置是:70B 模型使用单张 4GB GPU,Llama 3.1 405B 使用 8GB,DeepSeek-V3 671B 使用约 12GB。它依靠分层拆分、按需加载和权重释放完成这件事,模型参数总量与显存容量之间的关…
TencentDB Agent Memory:给 Hermes 加上分层记忆
Agent 的记忆问题,常见表现是两种:长任务里工具日志不断膨胀,跨会话后又丢掉项目背景、操作习惯和输出要求。TencentDB Agent Memory 试图用同一套分层模型处理这两类压力,并提供了 OpenClaw 插件和 Hermes Gateway 适配。 TencentDB Agent Memory 的 L0-L3 分层架构 L0 到 L3:记忆先…