Spaghettifying DRAM:一条 XOR 指令解锁 CPU 上的一切
Spaghettifying DRAM: 一条 XOR 指令解锁 CPU 上的一切 Christopher Domas 在 Black Hat 安全会议上以挖掘 x86 架构盲区闻名。2015 年他展示了 Memory Sinkhole,通过利用 x86 处理器的设计缺陷实现通用提权;2017 年他用页故障分析穷举 x86 指令集,挖掘隐藏指令;2025 年…
Spaghettifying DRAM: 一条 XOR 指令解锁 CPU 上的一切 Christopher Domas 在 Black Hat 安全会议上以挖掘 x86 架构盲区闻名。2015 年他展示了 Memory Sinkhole,通过利用 x86 处理器的设计缺陷实现通用提权;2017 年他用页故障分析穷举 x86 指令集,挖掘隐藏指令;2025 年…
Stealing Reasoning Traces from Proprietary LLM APIs 当 Anthropic、OpenAI 和 Google 将推理模型的内部思维链隐藏起来时,开发者大多认为那些加密数据块是安全的。来自 ELLIS Institute Tübingen、Max Planck Institute 和 Snyk 的研究团队证明,…
2026 年 8 月,安全工程师 Joel Margolis 发布了一篇长文,标题是 "What Happened to HackerOne?"。文章从 2012 年 HackerOne 创立讲起,梳理了这个全球最大的漏洞赏金平台如何在 14 年间演变为以销售为导向的企业级 SaaS——其黑客社区驱动的创业基因在这个过程中逐渐消失,以及 AI 技术如何加速了…
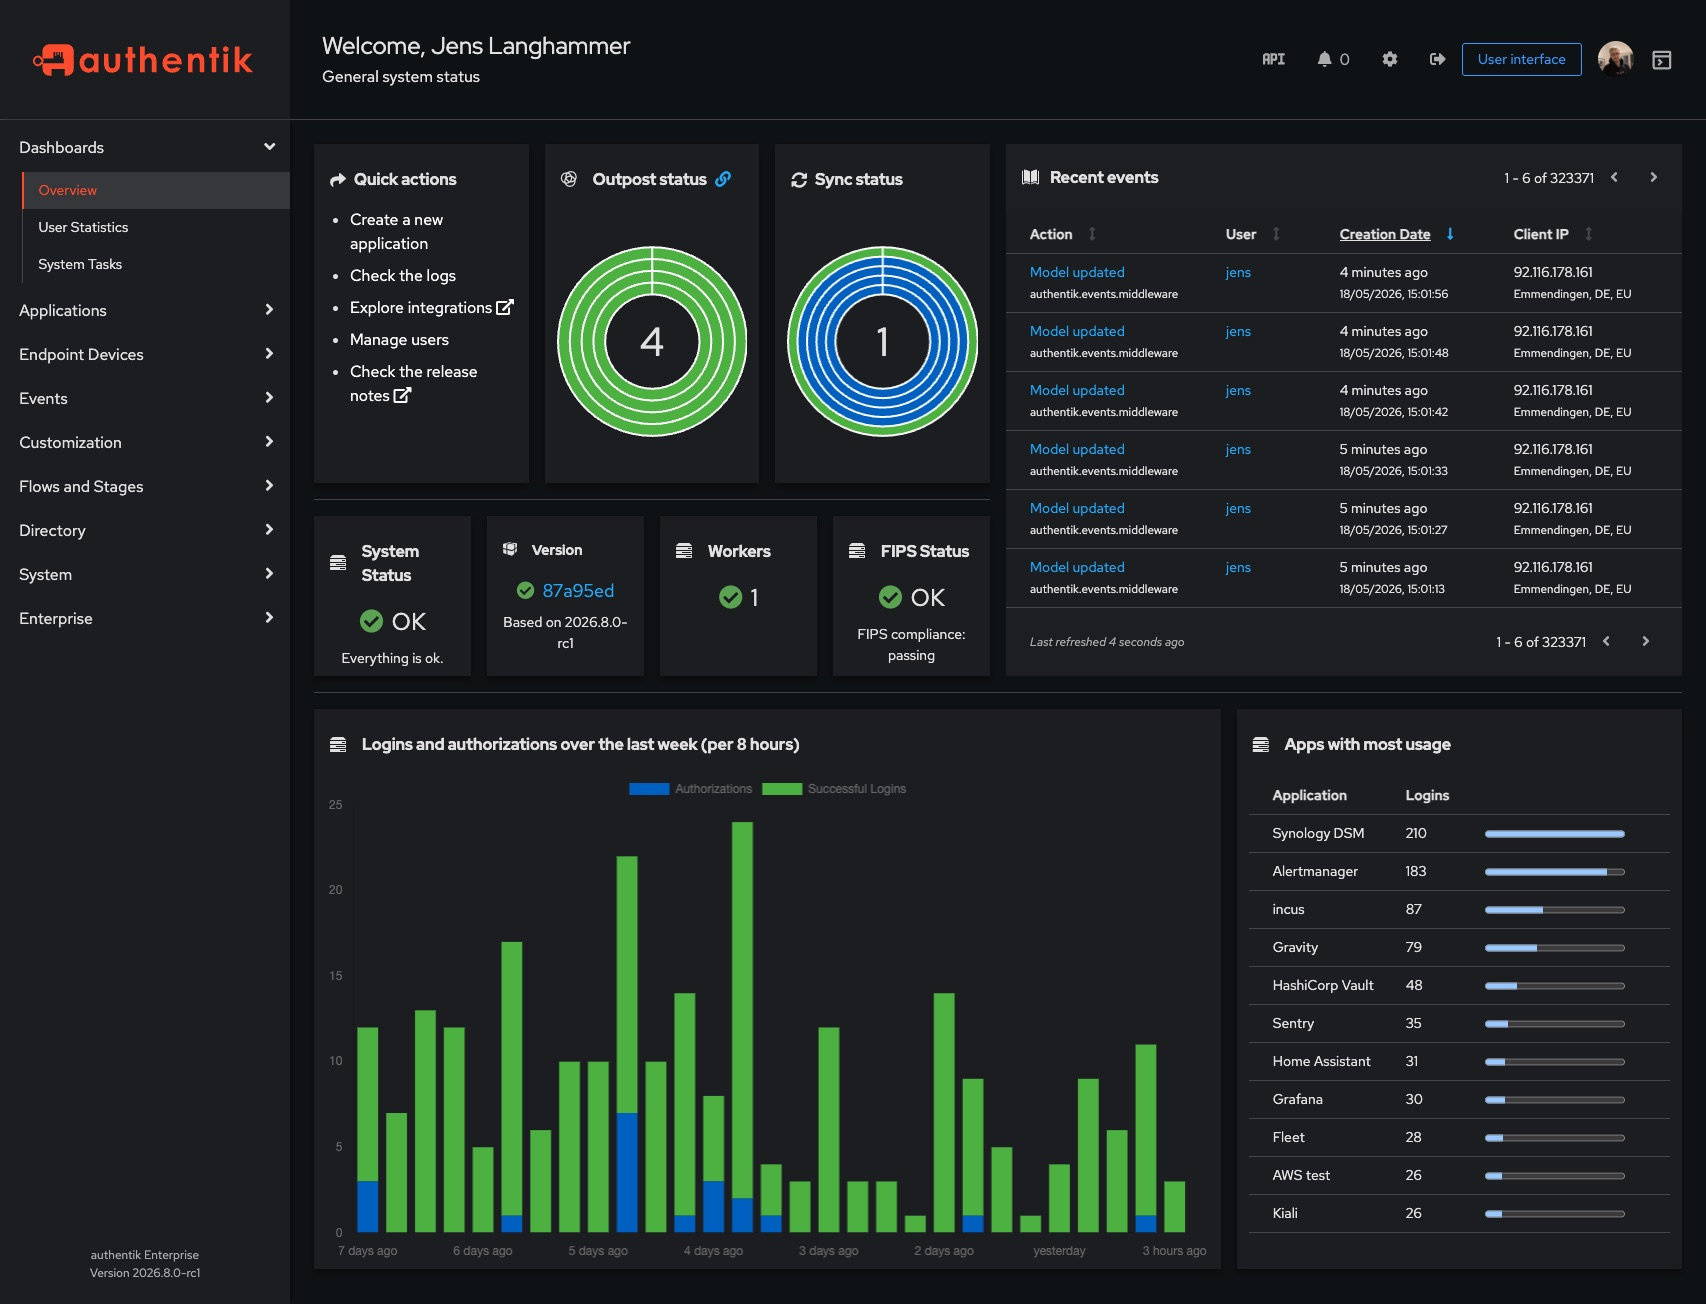
authentik 应用仪表盘 当你管理超过三个需要登录的内部服务时,统一身份认证就有了硬性需求。每个应用各搞一套用户数据库,密码策略不一致,MFA 支持参差不齐,离职员工账号散落在十几个系统里没法统一清理。authentik 就是为解决这个问题而生的开源身份提供商(Identity Provider,IdP),在 GitHub 上积累了超过 24,000…
AI 产品上线前必须回答一个问题:用户输入和模型输出的内容是否安全?但「安全」的定义取决于产品定位、受众和使用场景。同一段文字在网络安全研究工具中完全合规,到了心理健康平台就成了有害内容。传统护栏模型(guardrail model)把固定的伤害类别烘焙进权重,想换个部署场景就得重新训练。 Mistral 在 2026 年 8 月 4 日发布了 Shield…
当 AI Agent 可以自主调用工具、查询数据库、发送邮件甚至编写代码时,一个绕不开的问题浮出水面:怎么确保它不做不该做的事? 微软开源的 Agent Governance Toolkit(AGT)给出的答案是:别指望提示词约束,用确定性代码在应用层拦截每一次工具调用。 2026 年 3 月创建至今,这个项目在 GitHub 收获 5,392 个 Star…
一位用户在 Reddit r/ClaudeAI 社区发布了对 Claude Code 的逆向分析,声称自 2026 年 4 月发布的 v2.1.91 起,Claude Code 在启用代理时会隐蔽检查用户环境信息,并将结果编码进发往 Anthropic API 的 system prompt。 Claude 这段代码检查两项内容:系统时区是否匹配 Asia/…
Linux 内核曝 DirtyClone 高危漏洞,本地用户可静默提权至 root DirtyClone CVE-2026-43503 JFrog 安全研究团队披露了 Linux 内核本地提权漏洞 DirtyClone(CVE-2026-43503),CVSS 评分 8.8。该漏洞属于 DirtyFrag 家族的新变种,因 pskbcopyfclone()…
Anthropic 工程师季度代码产出变化 6 月 4 日,Anthropic 在官网发布了一份题为《When AI Builds Itself》的长篇报告,由联合创始人 Jack Clark 和内部研究所负责人 Marina Favaro 联合署名。报告首次披露了一批此前从未公开的内部运营数据,核心结论是:AI 正在加速参与自身的开发过程,最快可能在两年内…