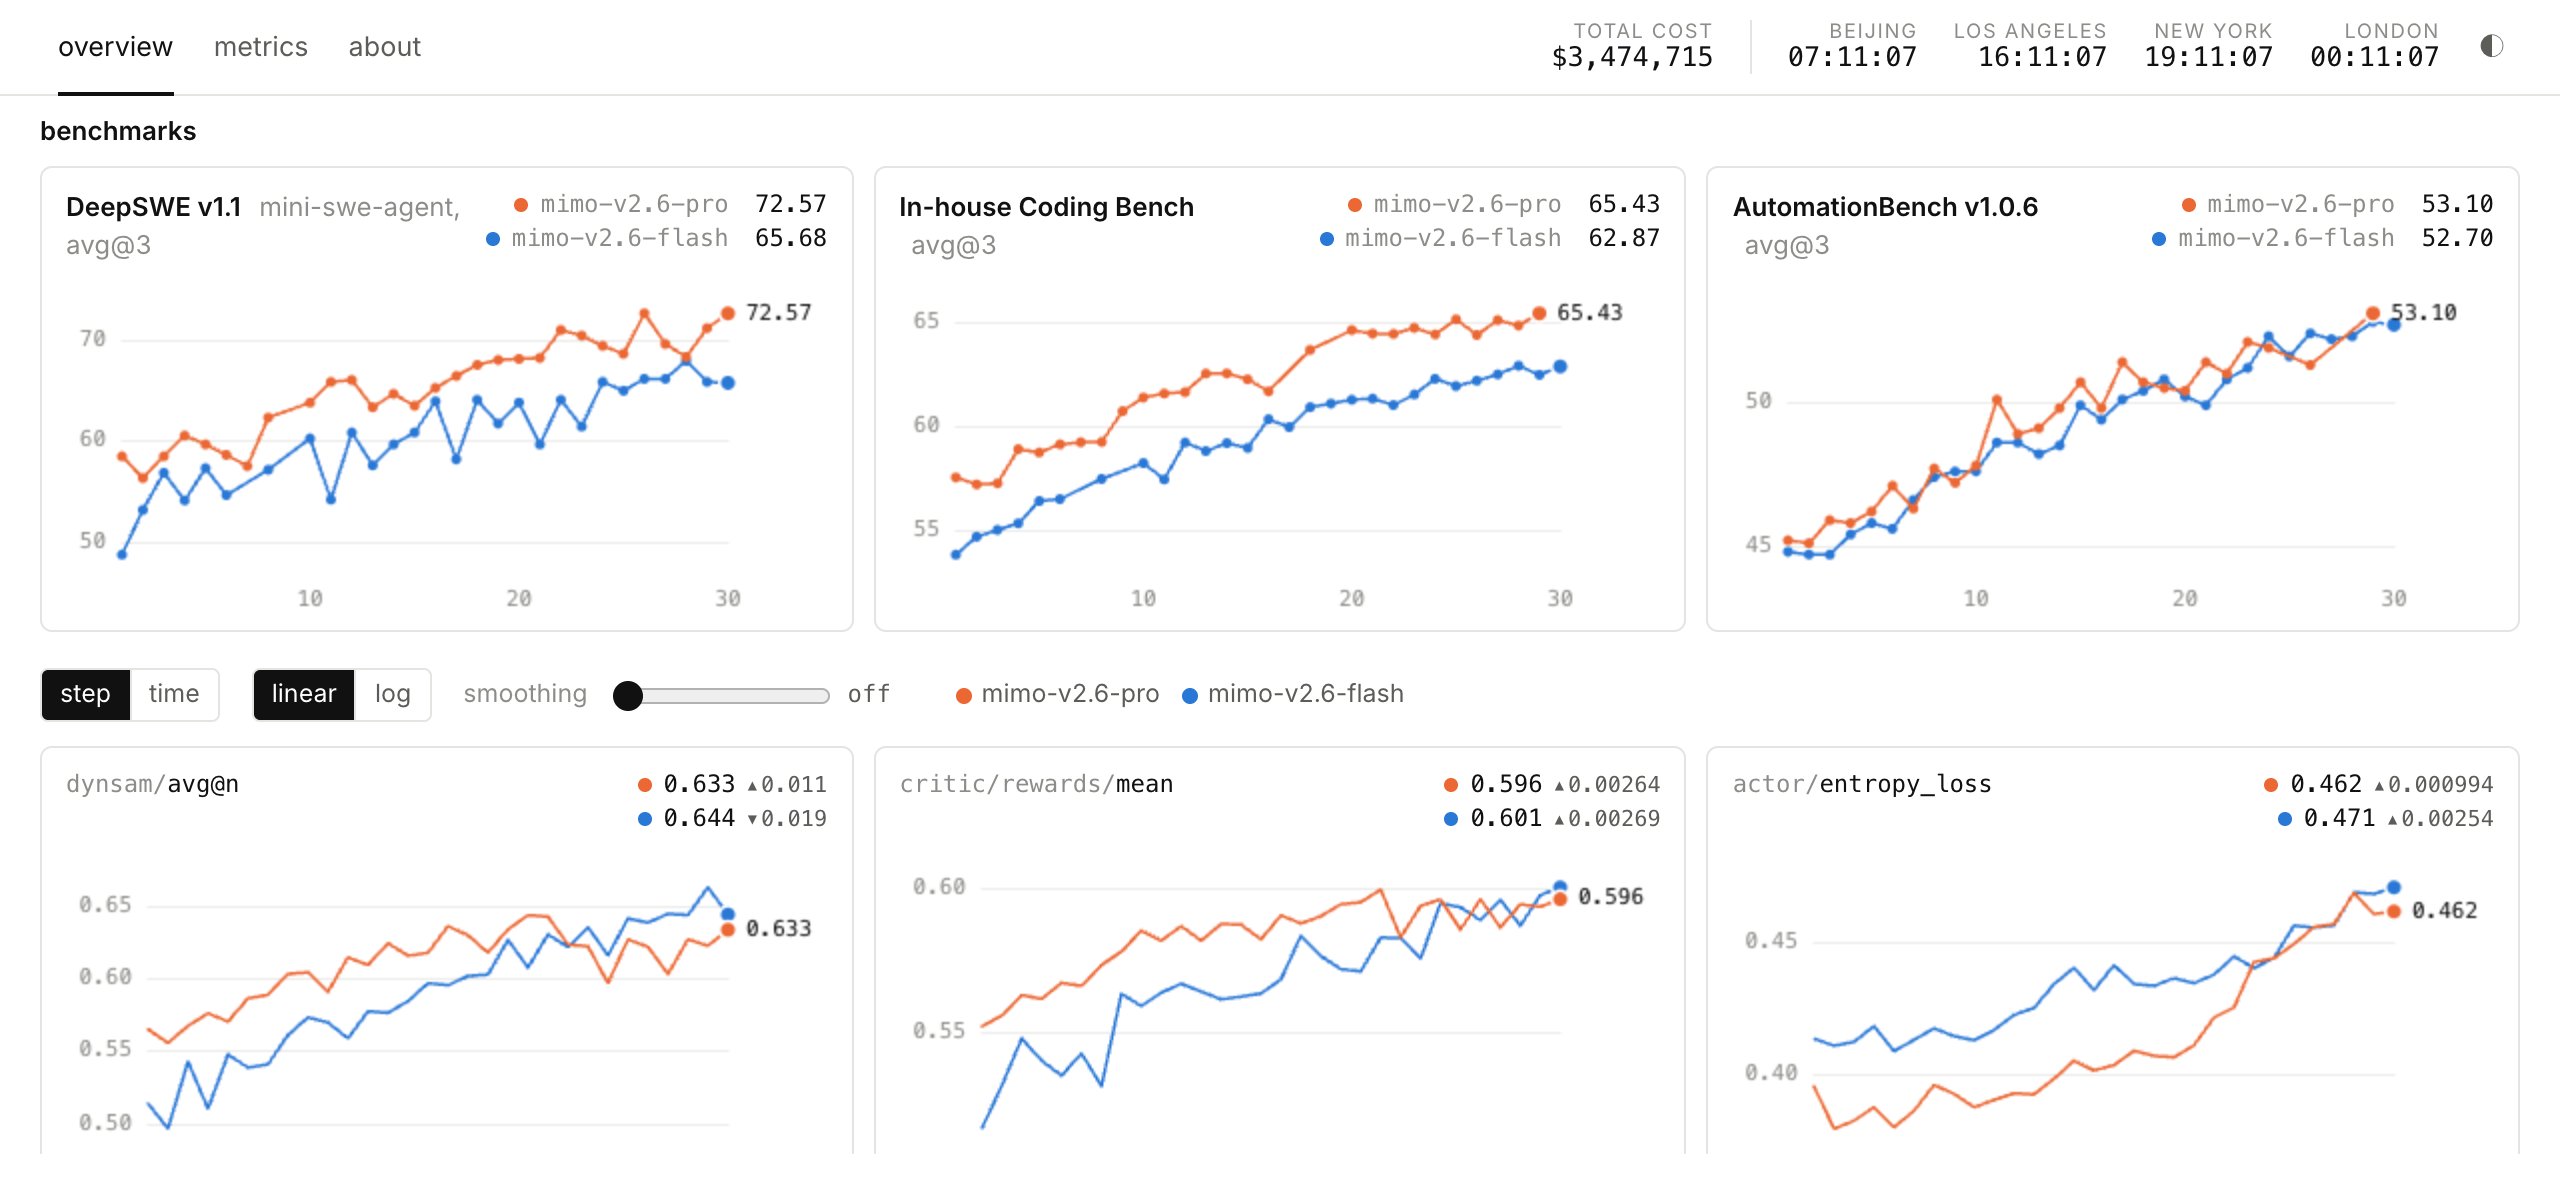
小米 MiMo-V2.6 开源解读:一份 347 万美元的 RL 训练公开账本
9 月 21 日,小米 MiMo 团队把三个新模型放上 Hugging Face:MiMo-V2.6-Pro-RL、MiMo-V2.6-Flash-RL 和一个 9B 的蒸馏模型 MiMo-V2.6-Distill-Qwen-9B。同一时间,一个平时只有大厂内部才能看到的页面对外开放了——mimo.xiaomi.com/rl,支撑这批模型发布的强化学习训练全…
9 月 21 日,小米 MiMo 团队把三个新模型放上 Hugging Face:MiMo-V2.6-Pro-RL、MiMo-V2.6-Flash-RL 和一个 9B 的蒸馏模型 MiMo-V2.6-Distill-Qwen-9B。同一时间,一个平时只有大厂内部才能看到的页面对外开放了——mimo.xiaomi.com/rl,支撑这批模型发布的强化学习训练全…
9月15日,一家名叫 TypeSafe 的 AI 公司发布了第一个公开模型 Jev。它的特别之处在于不生成任何文字:输入一段文本或一份数据,返回的是一个选项、一个分数或一个是/否判断,每个答案都附带可信度概率。发布当天,Jev 冲上 Hacker News 首位,讨论区涌入数百条评论;TypeSafe 同步宣布拿到 DCVC 领投的 4000 万美元种子轮。…
9 月 10 日,DeepSeek 正式发布 V4.1 Flash。按官方公告的定位,这是全新模型结构系列中目前最小的型号,552B 参数的 MoE 模型,原生支持多模态视觉理解,上下文长度 1M token。真正让它成为话题的,是官方给出的一组对比结论:经内部和外部多方测试,V4.1 Flash 在性能、费用、速度、总用时等指标上全面超越自家的旗舰 V4…
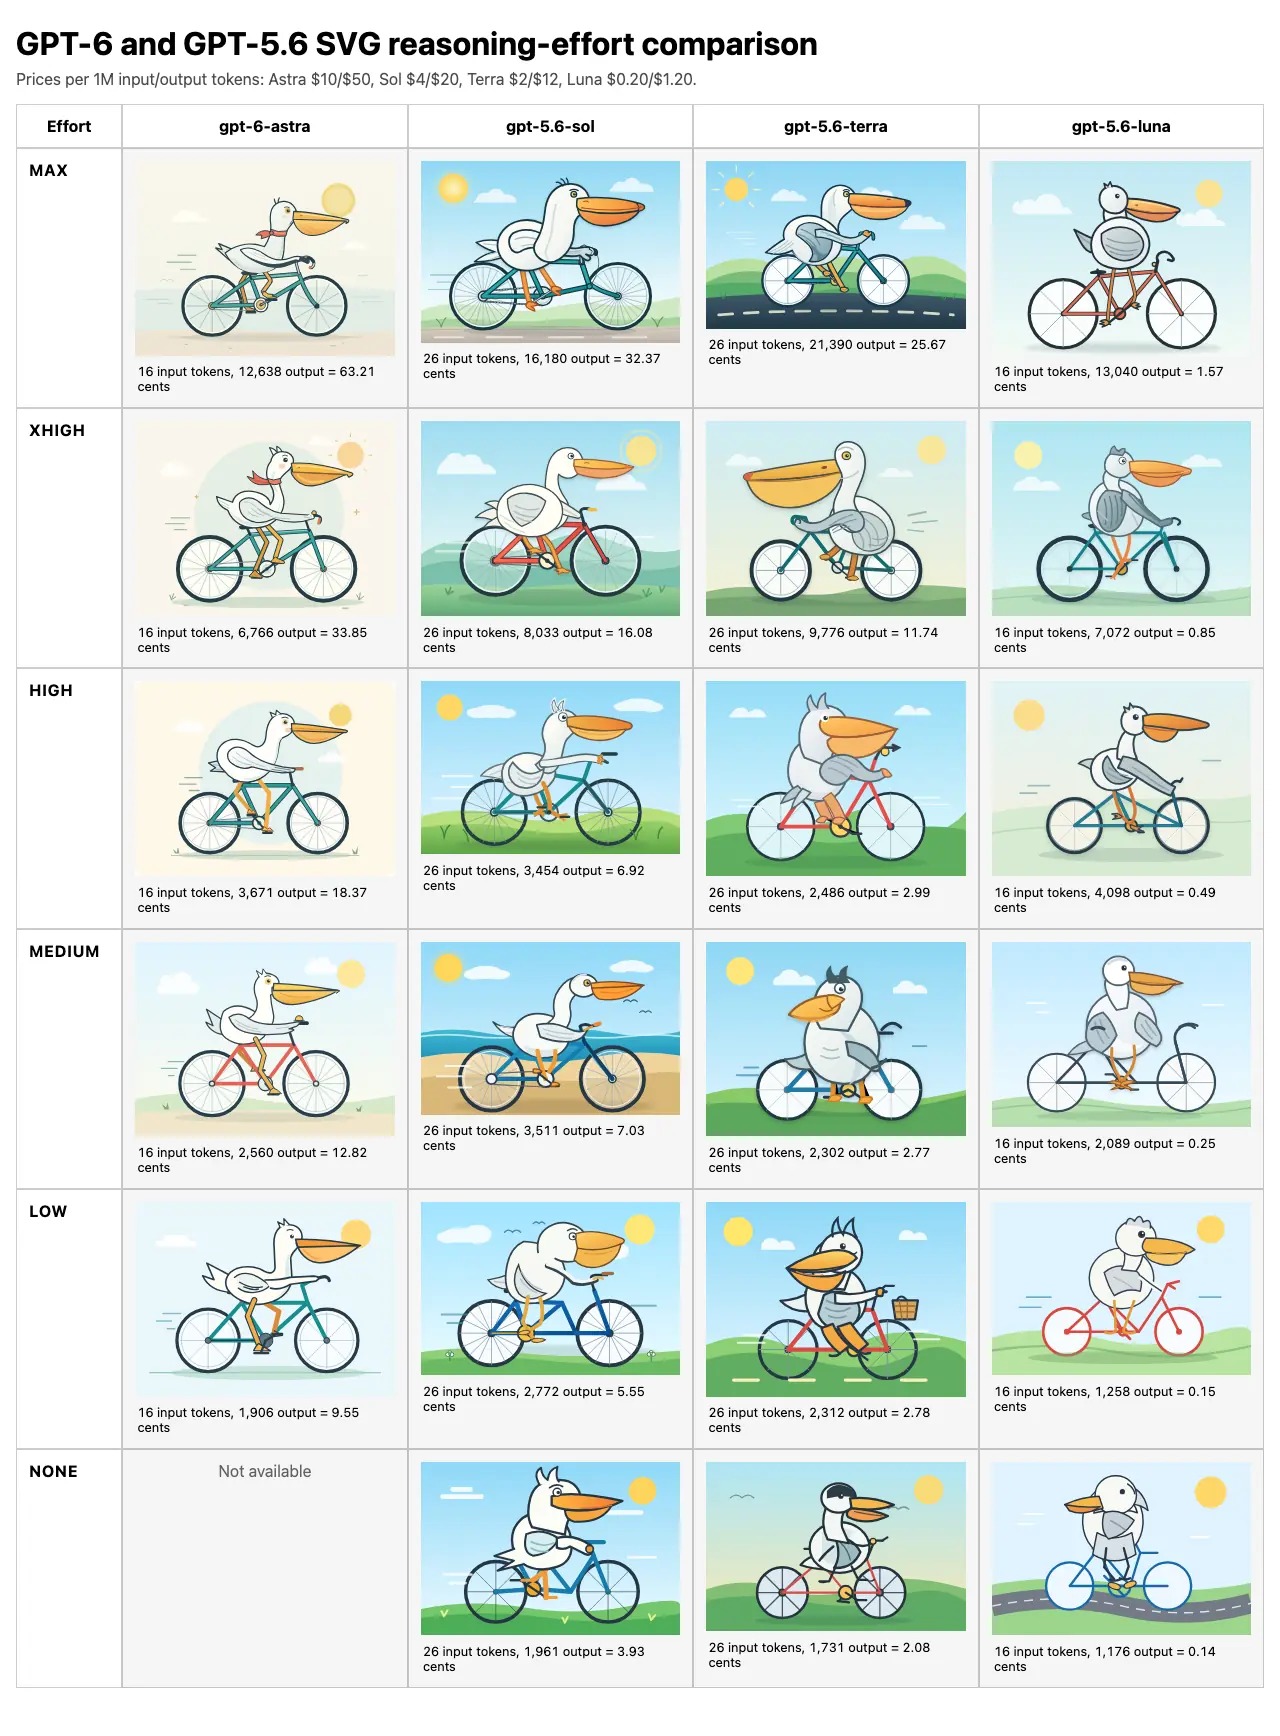
画一只骑自行车的鹈鹕,能测出大模型的什么?这个问题没有标准答案,但过去二十个月里,几乎所有值得关注的语言模型都被迫回答过它。出题人是 Simon Willison(Datasette 作者,SQLite 的联合共同作者之一),题目只有一句英文提示词:Generate an SVG of a pelican riding a bicycle。模型交出的画作以…
2018 年图灵奖得主 Yoshua Bengio 在 9 月 11 日发表了一篇博客文章,标题是一个问句:AI agent 为什么在撒谎、作弊和互相协调?文章发布三天内登上 Hacker News 首页,拿到 210 点和 276 条评论。这位深度学习奠基人给出的答案,指向当前训练 AI 的方法本身。 Yoshua Bengio 官方肖像(摄影:Richm…
2026 年 9 月 10 日,Insilico Medicine 生成式生物药产品经理 Andrew Aiginin 在 X 上宣布:在该公司运营的 DDD Benchmark 独立评测中,OpenAI 的 GPT-6 Astra 成为抗体可开发性预测表现最好的前沿模型。OpenAI 总裁 Greg Brockman 随后转发了这条消息。Astra 在这个…
Cognition 发布了新一代编码模型 SWE-2:FrontierCode 1.1 Main 得分 50.0%,距 Fable 5.1 的 50.9% 只差 0.9 个百分点,官方公布的单位任务成本便宜 64%。这次发布的技术细节比「又一个模型发布」多得多:Cognition 第一次把强化学习扩展到万亿参数规模的基座上,并公开了整套训练方法。本文拆解它的…