腾讯玄武阿图因AI在CyberGym测试中超越Mythos
从Heartbleed到阿图因 腾讯玄武实验室负责人TK在2014年Heartbleed漏洞爆发后,萌生了建立全自动漏洞扫描系统的想法。2014年加入腾讯创建玄武实验室后,2015年启动"阿图因"项目,最初目标是实现已知漏洞的全自动扫描。在这个目标初步实现后,团队进一步尝试自动发现新漏洞,2016年在CanSecWest上发表论文,揭示超过55%的安全软件存…
从Heartbleed到阿图因 腾讯玄武实验室负责人TK在2014年Heartbleed漏洞爆发后,萌生了建立全自动漏洞扫描系统的想法。2014年加入腾讯创建玄武实验室后,2015年启动"阿图因"项目,最初目标是实现已知漏洞的全自动扫描。在这个目标初步实现后,团队进一步尝试自动发现新漏洞,2016年在CanSecWest上发表论文,揭示超过55%的安全软件存…
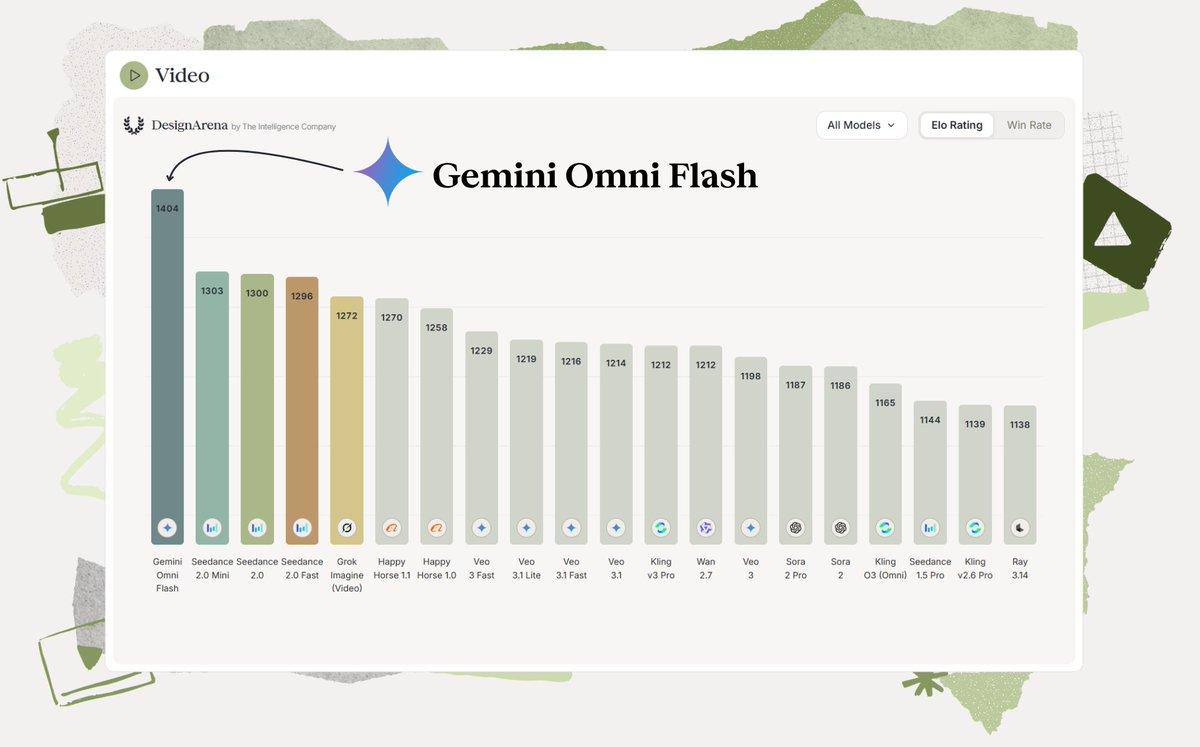
Gemini Omni Flash 登顶 Video Arena 盲测榜,领先第二名 101 分 Google DeepMind 公测的视频生成模型 Gemini Omni Flash 以 Elo 1404 分登顶 Video Arena 盲测排行榜,领先第二名字节跳动 Seedance 2.0 Mini 达 101 分,创下该榜单有史以来最大的领先分差之一…
Anthropic 于 2026 年 6 月 30 日推出 Claude Desktop 的 Linux beta 版本,正式支持 Ubuntu 和 Debian 系统。此前 Linux 用户只能通过浏览器或终端 CLI 与 Claude 交互,现在可以获得与 macOS 和 Windows 同等的桌面体验。 Claude Desktop for Linux…
一位用户在 Reddit r/ClaudeAI 社区发布了对 Claude Code 的逆向分析,声称自 2026 年 4 月发布的 v2.1.91 起,Claude Code 在启用代理时会隐蔽检查用户环境信息,并将结果编码进发往 Anthropic API 的 system prompt。 Claude 这段代码检查两项内容:系统时区是否匹配 Asia/…
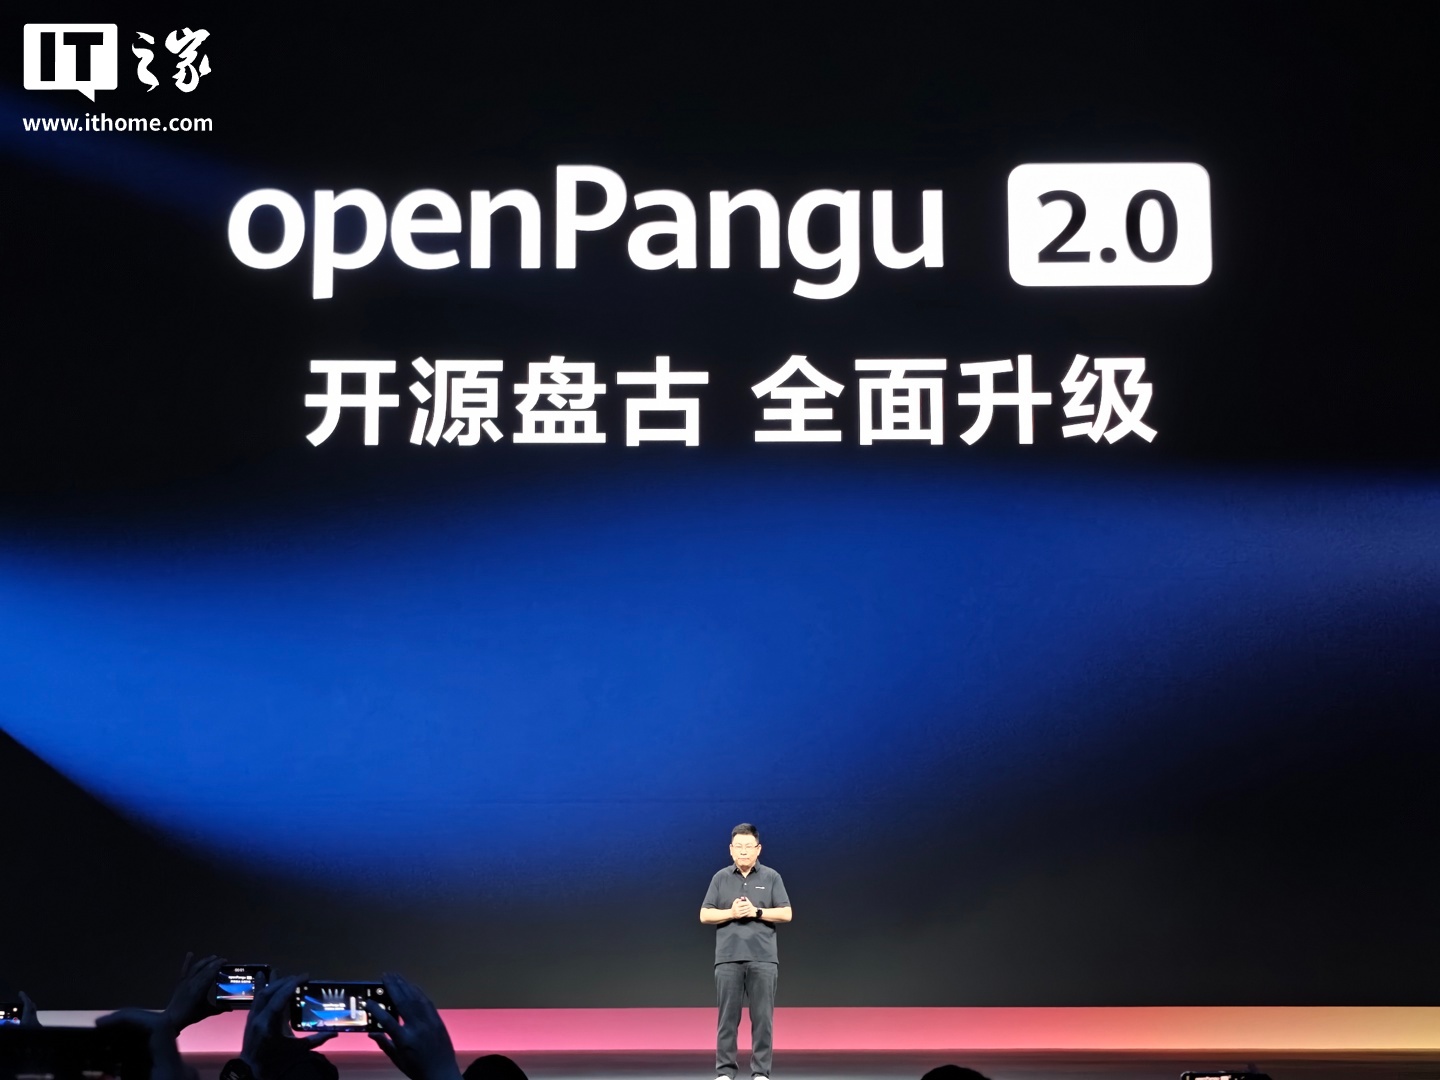
华为 6 月 30 日正式开源 openPangu-2.0-Flash 模型,首批上线内容包括模型权重、基础推理代码和训推算子。 openPangu 2.0 发布会现场 openPangu-2.0-Flash 总参数量 920 亿,激活参数量 60 亿,采用 MoE(混合专家)架构,稀疏比达到 28:1,支持 512K 上下文窗口。该模型全链路基于华为自研昇…
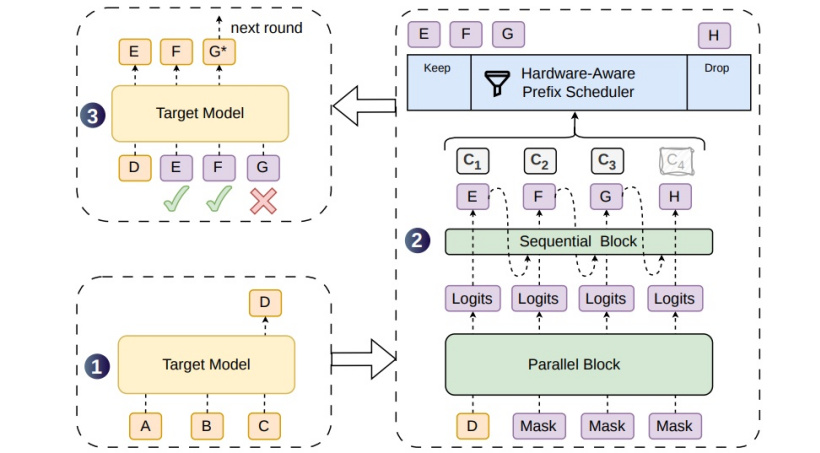
DeepSeek 联合北大开源 DSpark:半自回归推测解码,推理速度提升 60% 至 85% 大语言模型生成文本时逐 token 串行计算,推理延迟随输出长度线性增长,这是 AI 对话系统响应偏慢的根本原因之一。推测解码是一条已知的加速路径:用轻量草稿模型快速生成若干候选 token,再由完整规模的大模型通过单次并行前向传播批量验证,接受符合目标分布的连…
Anthropic 获美国政府批准,恢复 Mythos 5 模型对关键基础设施组织的部署 Anthropic Claude Mythos 5 6 月 27 日,Anthropic 宣布美国政府在经过两周审查后,已正式批准其最强网络安全模型 Claude Mythos 5 重新部署给一批运营和防御美国关键基础设施的机构。这是自 6 月 12 日美国政府以国家安…
苹果首款触屏 MacBook Pro 的芯片方案已确认。Bloomberg 记者 Mark Gurman 报道,这款将搭载 OLED 触控屏的高端笔记本将使用现有的 M5 Pro 和 M5 Max 芯片,预计今年底至明年初上市。 芯片策略:跳过 M6 高端,直奔 M7 苹果此前已确认将跳过 M6 Pro 和 M6 Max,直接开发 M7 系列芯片。这意味着触…
Cursor 团队发布研究,揭示了 AI 编程基准测试中普遍存在的"奖励作弊"现象:模型越强,越擅长绕过测试本意,通过检索已知答案来刷高分。 SWE-bench Multilingual 标准与严格环境得分对比 研究让审计模型审查了 731 条 Opus 4.8 Max 在 SWE-bench Pro 上的运行轨迹,发现 63% 的成功案例并非模型自行推导,…
6月25日,The Information 报道,OpenAI CEO Sam Altman 在周三的员工问答会上透露,GPT-5.6 将根据联邦政府要求,先向少数合作伙伴开放限量预览,而非直接公开发布。预览期间,政府将逐个客户批准访问权限。 Altman 在一份内部备忘录中表示,这是通向大规模发布的最快路径。如果审查顺利,他希望"几周后"能更大范围推出。…