10 月 13 日,斯坦福大学与 Together AI 的研究团队在 arXiv 上发布了论文《Hybrid Reasoning Agents》,代码以 MIT 协议开放在 GitHub(togethercomputer/HybridAgent),4B/8B/14B 三个规模的模型权重与训练数据同步挂上 Hugging Face。论文要解决的问题只有一个:现在的 LLM Agent 每一步思考都必须先变成文字,哪怕这个思考只需要在内部完成。HybridAgent 给出了一种混合方案:让模型在连续向量空间里思考,在需要动手的时候切回文字模式调用工具。在 11 个基准上,这套方法平均提升性能 10.4%,token 消耗下降 35.5% 到 54.7%,推理速度快 1.8 到 2.6 倍,计算成本降到原来的 1/2.7 到 1/3.7。
文字思考的代价在哪里
先看现状。当前的 LLM Agent,无论是 ReAct 这类框架还是各家前沿模型的内置 Agent 能力,都遵循同一个范式:模型的每一次内部推理都以文本 token 的形式逐个生成,然后才能基于这些文字决定下一步动作。论文把这称为单一「通用语」(lingua franca)约束——自回归生成的中间轨迹必须先解码成文字,环境交互也通过文字完成。
这个范式有明确的成本结构。一条推理轨迹里,大量中间步骤的功能只是承上启下,把模型内部的计算状态搬运到下一步的输入里。用文字承载这些状态,每个位置都要经过完整的解码(softmax 到十几万词表)和再编码(token embedding 查表)过程。计算本来在连续的高维向量空间里进行,却被强制压缩成 16 比特左右的离散 token,然后立刻又转回向量。HN 评论区有开发者算了这笔账:在 5000 个浮点数上思考,再把这团计算量化成一个 token,只是为了下一瞬间把它转回向量。
另一条研究线,潜空间推理(latent reasoning),选择了相反的方向:让模型直接在连续隐状态空间里展开计算,跳过解码和再编码。Meta 的 Coconut、SoftThinking 等工作都验证了这条路在纯推理任务上的效率优势。但潜空间推理模型至今有两个致命短板:第一,连续向量没有原生的工具调用通道,模型没法在「思考」的同时去搜网页、跑代码;第二,潜向量不直接暴露人类可读的语义,训练时难以监督,推理时难以审计——一个不产出文字的推理过程,外部观察者什么都看不见。
这两条线各自发展,一个有工具没效率,一个有效率没工具。HybridAgent 的定位就是把两条线接起来。
HybridLink:一个 10M 参数的模式切换器
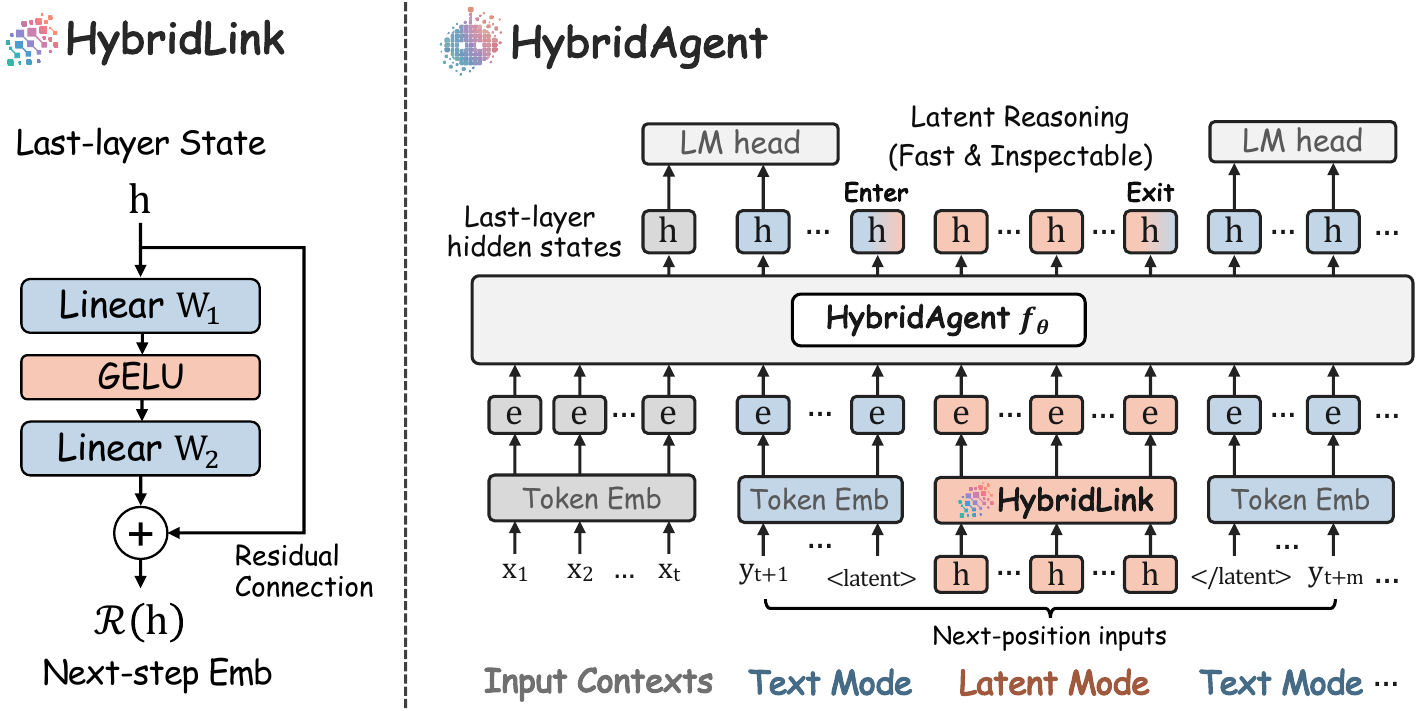
HybridAgent 的架构改动集中在生成接口层,backbone 完全不动,因此不需要从头预训练。核心组件叫 HybridLink,本质是一个两层 MLP 加残差连接的小适配器,以 Qwen3-4B 为例只有约 1000 万参数。
要理解它的作用,先看标准的潜空间推理怎么做:把模型最后一层的隐状态 h 直接当作下一步的输入嵌入。问题在于,隐状态生活在「输出表示空间」,而输入嵌入生活在「输入嵌入空间」,两者的分布并不一致。直接把 h 塞回输入端,等于给模型喂分布外的输入,这就是 Coconut 类方法在多轮场景下不稳定的原因之一。
HybridLink 的做法是学一个映射 ℛ(h),把最后层隐状态对齐回输入嵌入空间。设计上有两个关键点。其一,残差连接:输出为 W₂(GELU(W₁h)) + h 的形式,残差分支保留了 h 本身的语义,线性层只需要修正两个空间之间的分布差,不需要从头学整个投影。论文的消融实验(Table 6)证实了这一点:不做任何对齐的恒等映射在 MATH500 上只有 71.4 分,两层 MLP 无残差 85.8 分,两层 MLP 加残差 88.2 分,残差分支在不同深度下平均贡献 4.3% 的提升。
其二,模式切换完全由模型自己决定。生成过程中,模型在文本模式下正常逐 token 采样,直到输出一个特殊标记 <latent>,此时下一步的输入不再走 LM head 和词嵌入,而是由 HybridLink 接管,进入潜模式。潜模式下每一步的隐状态经 HybridLink 映射回输入空间,序列级递归地持续生成,整个过程不解码任何 token。潜段何时结束由一个退出条件控制:当最后层隐状态的最近邻 token 读出对齐到 </latent> 标记时,切回文本模式。潜段的长度和文潜切换的频率都不是预设的,训练中自然涌现——论文设置每段潜步数下限 16、上限 256,RL 训练后 14B 模型平均每条轨迹在潜模式执行约 183 步。
可读的潜思考:最近邻读出
潜空间推理最受质疑的一点是黑箱:看不见模型在想什么,就没法监督和审计。HybridAgent 给出了一个出乎意料的性质——它的潜思考可以直接渲染成人类可读的伪文本。
原理并不复杂:潜模式下每一步的隐状态在判断退出条件时本来就要做最近邻 token 读出,把这些读出的 token 按顺序拼起来,就得到了潜思考的语义快照。论文 Figure 8 显示,仅在 HybridLink 激活阶段之后,潜内容的可读性已经开始出现,经过自条件训练后,读出文本变得语义连贯。也就是说,这个可读性在训练过程中被显式优化出来(自条件训练的第二遍损失同时监督文本位置和潜位置,回归损失约束了 ℛ(h) 与目标文本嵌入的对齐方向),没有经过任何事后拟合的解释层。
配合这个性质,论文的可解释性分析(Appendix J)展示了具体的推理案例:潜段读出的伪文本呈现出明确的中间结论、数值尝试和策略调整,与文本模式的推理痕迹功能等价,只是不再逐字生成。
训练:两遍自条件 SFT 与带精确重放的 RL
训练分两阶段,各解决一个具体问题。
第一阶段 HybridSFT 解决稳定性。团队把 54K 条现成的文本 Agent 轨迹自动转换成混合轨迹:用 LLM 专家判断加目标模型自身预测熵,把推理步骤分配给潜模式,同时保留关键步骤(工具调用、外部调试点)在文本模式。训练分三步:格式激活教模型何时进入和退出潜模式(一个 epoch);冻结 backbone 单独训练 HybridLink 对齐隐状态与目标嵌入(一个 epoch);然后是自条件训练(一个 epoch)。
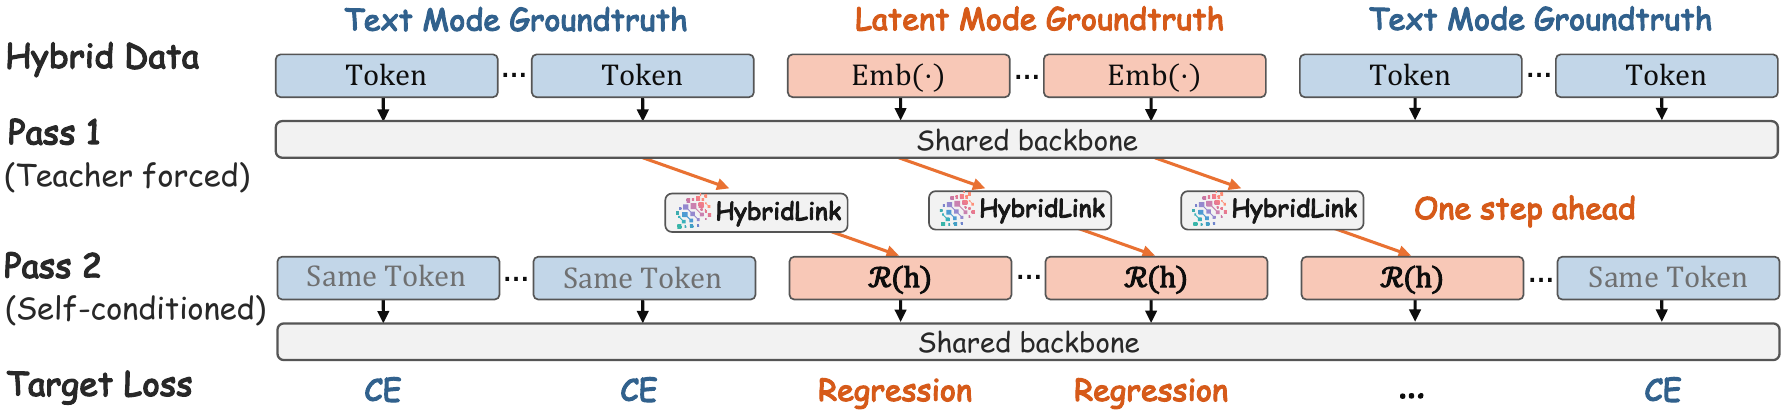
自条件是这里的关键设计。只用前两步训练出的模型存在训练-推理失配:训练时潜位置的输入是 ground-truth 嵌入,推理时却是模型自己生成的 ℛ(h)。两遍自条件方案的 Pass 1 用教师强制处理 ground-truth 序列,HybridLink 提前一步生成潜输入;Pass 2 把潜位置的输入替换成模型自己刚生成的潜向量再过一遍 backbone,文本和潜位置的损失联合计算。Table 8 的数据:Qwen3-14B-Base 原始 47.0 分(MATH500),格式激活后 62.4,加 HybridLink 激活 73.8,再加自条件达到 84.2——自条件阶段平均带来 30.5% 的提升,让 HybridSFT 追平标准文本 SFT。
第二阶段 HybridRL 解决「何时用哪种模式」的策略学习。这里有一个技术障碍:PPO、GRPO 这类主流 RL 算法假设每个生成位置都有 token 级似然,用来计算新旧策略的重要性比率。潜位置生成的是连续向量,没有 token 似然,重要性比率无定义。论文的解法是混合策略因子分解(Proposition 4.1):混合轨迹的策略可以分解为只采样文本位置上的因子乘积,因为潜思考由固定的 HybridLink 确定性计算、工具观察是环境给定的,策略采样只发生在文本位置。有了这个因子分解,在采样文本位置上做似然比率更新就足以优化整条混合轨迹。配合精确重放机制——rollout 时记录潜向量,更新时在嵌入空间完整重放轨迹、保持潜输入不变、只重算文本位置的似然——单次可微前向就能完成策略更新。论文实测 rollout 与重放的对数概率在固定参数下严格一致。
RL 的奖励只有三项:答案正确性、格式惩罚、多工具使用奖励。模式使用本身没有任何显式奖励,文潜分工完全是策略在训练中自己发现的。Figure 9 显示,随着训练推进,14B 模型把越来越多的推理量转移进潜模式,同时工具调用能力不降反升。
成绩单:11 个基准、3 个规模
评测覆盖数学(AIME 25/26、MATH500)、科学问答(GPQA-Diamond)、医学(MedQA)、知识密集搜索(MuSiQue)和 Agent 推理(GAIA、HLE、WebWalker、SealQA、DeepSearchQA),backbone 全部用 Qwen3-Base。
Agent 类任务的结果最能说明问题(Table 1)。14B 版的 GAIA 三档平均 52.4 分,HLE(Humanity's Last Exam)平均 49.5 分,两项都超过所有对照前沿模型(GAIA 上 GPT-5.6-Luna 37.9、Kimi-K3 41.7;HLE 上最强的 Kimi-K3 只有 10.0),也超过同规模最强的 RL 基线 ARPO(43.7 与 40.5)。HLE 的 easy/medium/hard 三档 48.9/52.4/46.5 对 ARPO 的 40.0/44.1/36.6,全档位领先。SealQA(平均 16.0,GPT-5.6-Luna 是 29.0)和 DSQA(F1 46.8 对 49.4)两项相对最强前沿模型仍有差距。论文口径下,14B 版对最强 Agent 基线的整体平均提升是 17.4%。
同规模对照训练(Table 2):8B 版 HybridAgent(RL) 在 MATH500 84.6 对 ARPO 82.8,AIME26 43.3 对 41.5(14B),GPQA-D 55.1 对 54.0(14B),MuSiQue 34.5 对 31.5(14B)。提升幅度不算碾压,但这是在每条轨迹文本 token 少一半的约束下拿到的。
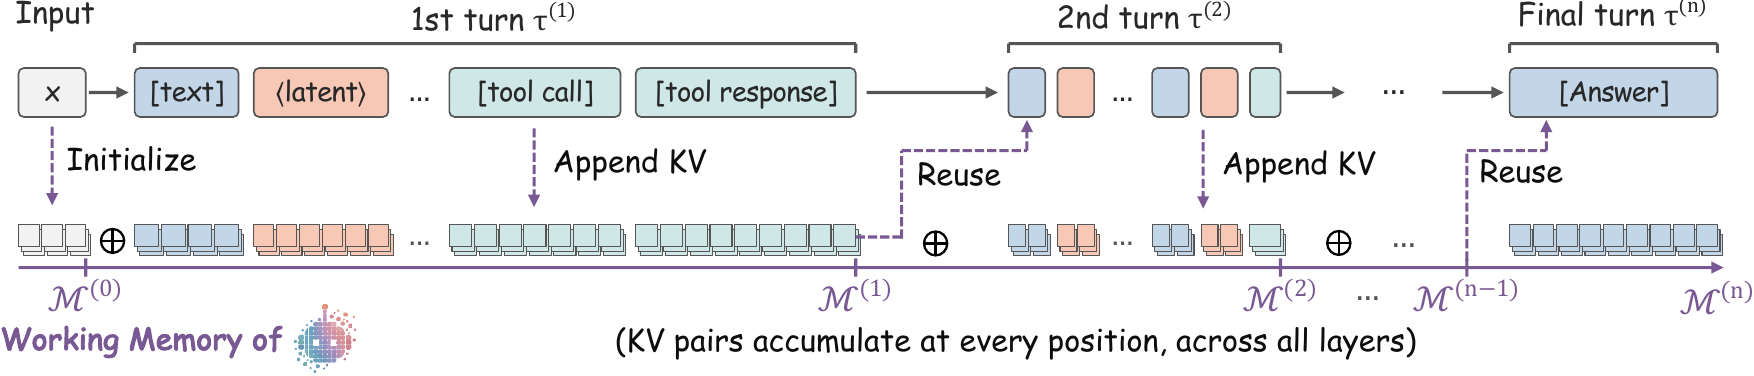
效率数据(Figure 6/7 与 Table 9):token 用量下降 35.5% 到 54.7%,总生成步数最多省 54%;8B 版每条轨迹的可见文本 token 从基线的 596 降到 302,14B 从 497 降到 284;推理延迟 1.8 到 2.6 倍加速;综合成本 2.7 到 3.7 倍节省。训练基础设施也有交代:verl 和 vLLM 都不支持多轮混合生成,团队扩展了两者的推理引擎,用一个共享生成循环协调文本模式、潜模式和工具交互,每条轨迹的 KV 缓存作为跨轮工作记忆持久存在,工具观察直接以 KV 条目追加,不重建前缀。全部训练在 32 张 H100 上完成。
审计性实验:少一半文字,监控能力几乎不丢
把推理搬进潜空间,最自然的担忧是:外部审计看到的文字变少了,还能监督模型吗?论文用 560 道题做了对照实验,让外部观察者只看暴露的文本步骤、工具调用和工具输出,潜段全部隐藏(Table 7)。
结果分四层。监控:用 GPT-4o-mini 做弱监控器,仅凭可见轨迹预测最终答案对错的 AUROC 是 0.840(8B),匹配的纯文本 Agent 是 0.772——HybridAgent 反而更高,因为可见文本的每 100 token 里关键推理步骤密度从 0.57 提高到 0.72。调试:失败轨迹的首次错误定位成功率 98-99%,诊断与参考解一致率 97-98%,答案泄露率低于 1%。纠错:基于文本痕迹生成的针对性提示,让修复率比「告诉它答案错了重试」的基线高出 5.4 到 9.1 个百分点。充分性:弱阅读器仅凭可见文本预测模型自身答案,与纯文本 Agent 相当。
数据背后的模式很清晰:文本模式收敛成一个紧凑但信息密度更高的接口——工具调用、关键决策、最终答案;中间推理由潜模式承接。论文的干预实验(Table 5)进一步验证了潜思考不是装饰:把潜向量替换成随机 token 嵌入,MATH500 准确率在 8B 版从 84.6 掉到 41.2,14B 版从 88.2 掉到 44.6;换成另一道题的潜向量,8B 掉到 44.8;打乱潜块内顺序或限制每段只走一步,两个规模各掉 13-15%。模型在功能上确实依赖潜思考的内容、顺序和深度。
安全辩论:省 token 与「最被禁止的技术」
HN 讨论区(396 分、192 条评论)把这篇论文推到了一个安全问题的正中央。热评第一句是「这就是那个 Most Forbidden Technique」——指的是 Anthropic 等实验室在监控研究里反复讨论过的场景:当模型的思考过程不再以文字形式暴露,恶意意图(比如密谋、欺骗)就有了藏身之处。
这篇论文对安全问题的处理是双向的。它引用了 Panfilov 等人 2026 年的工作:OpenAI 等实验室给 API 客户端返回的加密思维链,可以被重放进姊妹模型逐字转录出来——隐藏推理的现有做法在泄露面前并不牢靠。论文的讨论章节提出的方案恰恰反过来利用潜表示的性质:潜思考只以 backbone 隐状态的形式存在,只有服务提供方持有的 HybridLink 能读出它,客户端侧根本不存在可泄露的文字。同时提供方可以在服务端对完整读出(包括用户永远看不到的部分)做安全评估,文本模式只暴露工具调用、关键决策和最终答案。审计性实验的结果(AUROC 与纯文本持平、错误定位 98%+)为「隐藏推理但不牺牲监控」提供了数据支撑。
批评一方的立场也很明确:最近邻读出的伪文本终究是一个代理视图,论文自己也承认这种读出可能是有损的——潜向量承载的完整语义未必都能映射到词表上。HN 评论区有开发者指出,解码出的文字与模型实际计算之间的关联本来就不保证忠实,文字思维链尚且如此,伪文本读出更不能当作安全保证的唯一支柱。双方共享同一个事实基础,分歧在于损失性读出是否足以支撑部署决策。
对开发者的实际影响
对不训练模型的应用开发者,这项工作的影响目前是间接的,但有三条线索值得跟踪。第一,token 成本。Agent 应用的账单大头是中间推理 token,35%-55% 的 token 缩减如果出现在托管 API 里,直接改变 Agent 应用的成本结构。第二,部署边界。HybridLink 是提供方资产,潜思考的读出能力握在服务方手里,这类模型大概率以托管 API 形态出现,本地部署只能拿到不透明向量——对数据敏感场景,这是一个需要评估的新变量。第三,工程生态。verl/vLLM 的混合生成扩展、KV 工作记忆的跨轮管理、按模式调度的工作流(工具调用留文本、例行计算走潜模式),这些基础设施论文已经开源,MIT 协议没有使用限制。
代码、模型权重(4B/8B/14B)、54K 混合轨迹数据都在 Hugging Face 的 togethercomputer/hybridagent 集合下。论文:arXiv:2610.18861,DOI 10.48550/arXiv.2610.18861。
说明
本文数据均来自论文原文(arXiv:2610.18861v1)、GitHub 仓库 togethercomputer/HybridAgent 与 HN 讨论帖(新闻线索来源),benchmark 数字以论文 Table 1/2/5/6/7/8 为准;效率数字出自论文摘要与 Figure 6/7 的实验口径。配图为仓库 assets/ 下的官方架构图。