画一只骑自行车的鹈鹕,能测出大模型的什么?这个问题没有标准答案,但过去二十个月里,几乎所有值得关注的语言模型都被迫回答过它。出题人是 Simon Willison(Datasette 作者,SQLite 的联合共同作者之一),题目只有一句英文提示词:Generate an SVG of a pelican riding a bicycle。模型交出的画作以 SVG 源码形式交付,好坏全凭肉眼判断。Willison 自己称之为「深度不科学的基准」,还专门提醒别人不要拿鹈鹕去比较模型。但每有新模型发布,他都会照跑一遍,从 2025 年初的 GPT-4o 时代一路跑到了 2026 年的 GPT-6 Astra。
9 月 4 日的新网格:Astra 把上一代全线甩开
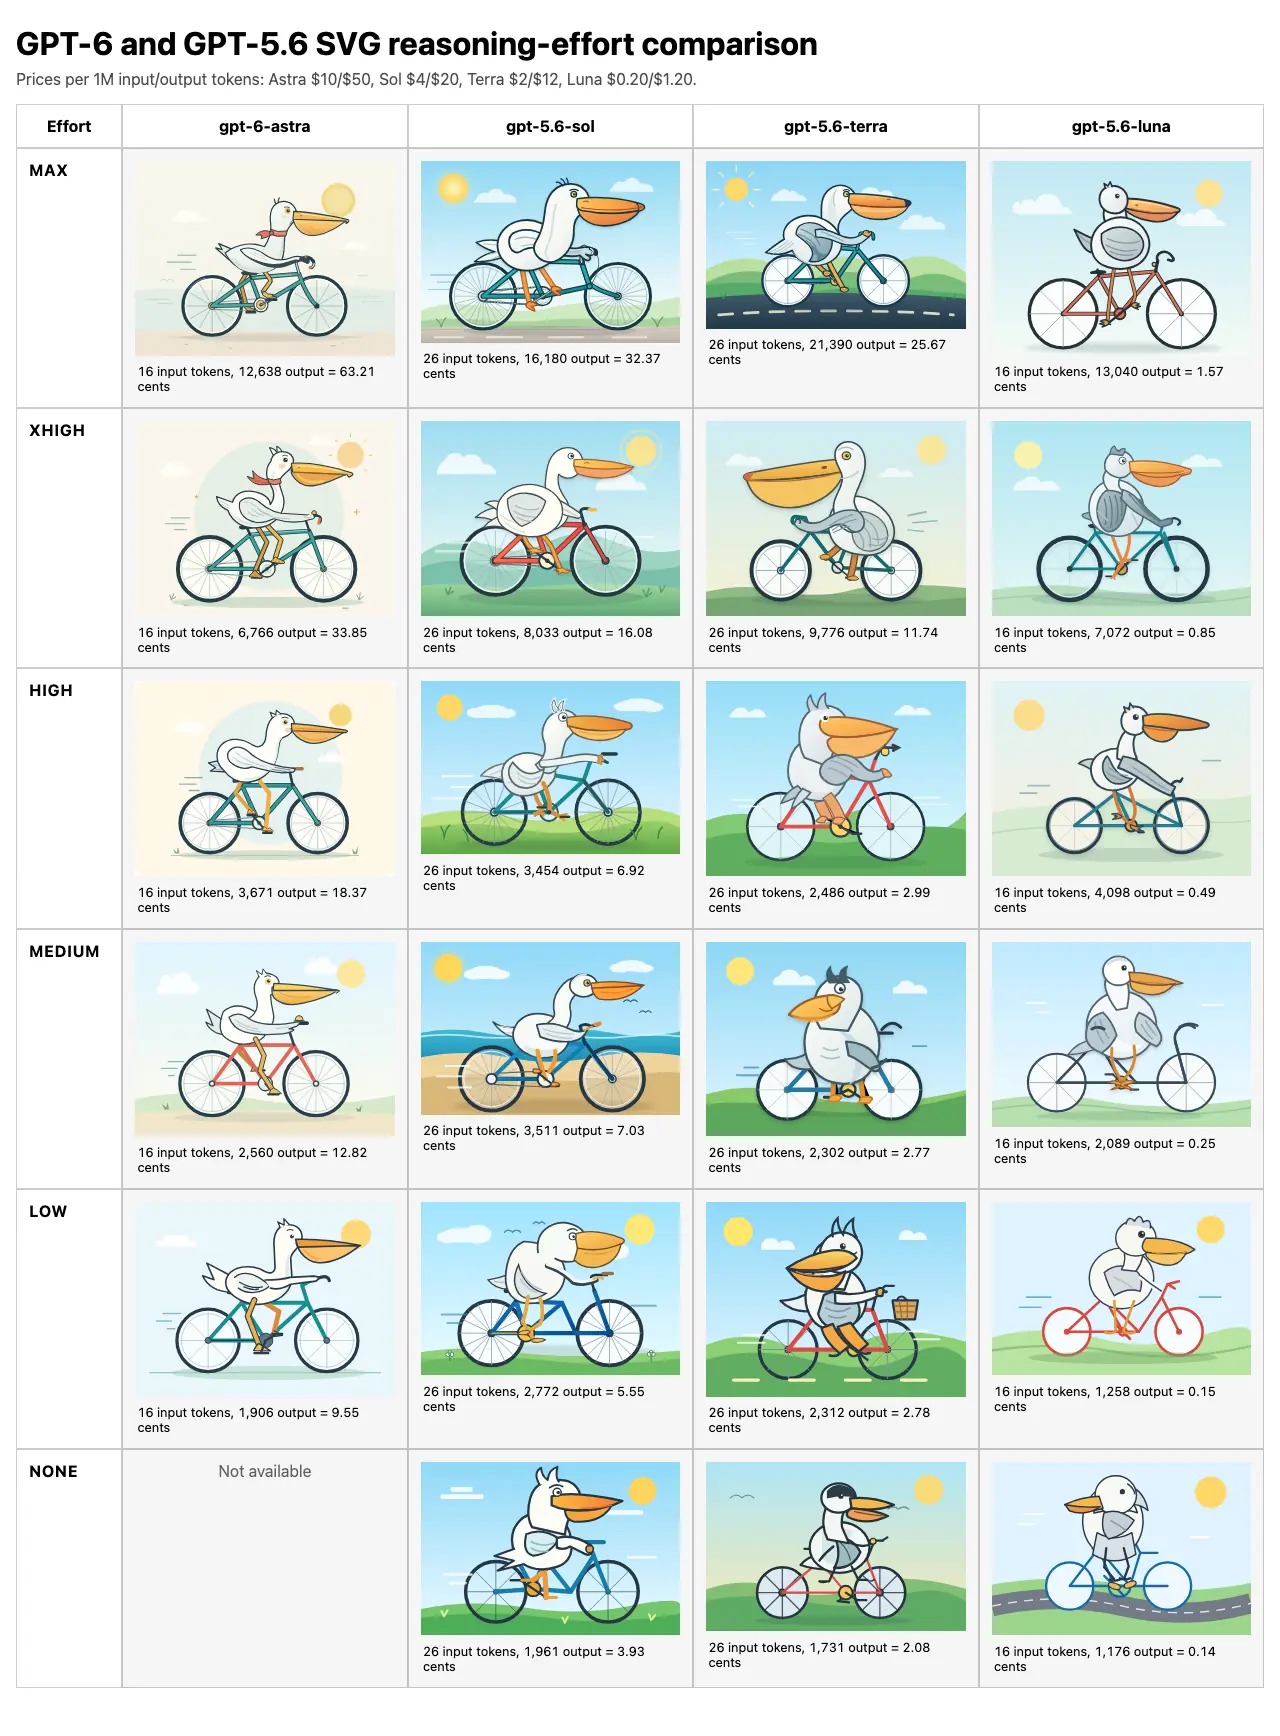
Willison 在 9 月 4 日的博文中公布了 GPT-6 Astra 的鹈鹕对比网格。他在下午拿到 Astra 访问权限,自然地在 low、medium、high、xhigh、max 五个推理力度档位各生成一只鹈鹕,再与 GPT-5.6 Sol、Terra、Luna 同场对比。Astra 不支持关闭推理的 none 档,网格里那一格标着 Not available。
结论写在他的三条观察里。第一,Astra 的鹈鹕明显更好:GPT-5.6 Sol 画得最好的一只(他个人偏好 xhigh 档)仍然「明显是一堆抽象形状的堆叠」,而 Astra 从 low 到 xhigh 的每一只都强于它,max 档的那只「真的很好」。第二,Astra 在 max 以下的档位仍不能稳定把鹈鹕的两条腿画在车架两侧。第三,价格:Astra 定价 10 美元/百万输入 token、50 美元/百万输出 token,约为 Sol(5/30 美元)的两倍,但它在每个档位消耗的 token 都明显更少,各档实际花费的差距比定价看起来更近。
网格里有一处性价比断崖值得单独看:Astra 的 low 档用 9.55 美分画出了一只比 GPT-5.6 Sol 任何档位都好的鹈鹕,而同样的 10 美分花在 Sol、Terra、Luna 任何一档上,得到的都是更差的画。另一处是 token 计数:同一道题,Astra 和 Luna 都只消耗 16 个输入 token,Sol 和 Terra 消耗 26 个。Willison 在文末留了一个开放式猜测:Astra 和 Luna 的关系,可能比 OpenAI 公开承认的更近。
一个环境把它变成了有分数的基准
这道题的原始形态没有分数,判断靠肉眼,没法优化。7 月 30 日,Hugging Face 的机器学习工程师 Sergio Paniego 把它搬进了 OpenEnv 环境标准,发布了 Pelican SVG Env,起因是有人在推特上说「该有个鹈鹕 SVG 强化学习环境了」,而当时并不存在。这个环境以 HF Space 形式部署,接口只有两个函数:reset() 发一道题,step() 接收模型的原始回复并返回奖励分数。目录里有 6 种动物和 5 种交通工具,共 30 道题,默认就是那只骑自行车的鹈鹕,此外还有美西螈骑滑板车之类的组合。
打分分三层,免费的部分先跑。第一层是门禁,检查 SVG 源码本身:模型把照片嵌成 data URI、或者把「鹈鹕」两个字直接写成 <text> 元素,都会在源码层被直接拒绝,虽然这两类作弊渲染出来的图看起来完美。第二层是结构分,权重 0.35,对形状做七项几何检查:轮子数量对不对、大小是否相近、是否处于同一水平线、间距是否足够、有没有东西横跨其间、有没有物体在轮轴线上方、比例是否合理。这一层完全不知道鹈鹕是什么,只检查「载着骑手的轮式载具」在几何上是否成立,而且是真正解析 SVG 文档,能正确处理扁平化的贝塞尔曲线、嵌套 transform 和 CSS 单位。第三层是语义分,权重 0.65,把 SVG 渲染成 PNG 后交给一个视觉模型(实验使用 Qwen2.5-VL-72B)打分:先做一次盲测,完全不给任务信息,只问「这是什么」;再回答九个从题目生成的是否问题,比如「这只动物喙下有没有喉囊」——喉囊正是鹈鹕区别于鹳的特征。如果判定动物没有真的骑在车上,得分降到四分之一。
总奖励一行公式:reward = 0.35 × structure + 0.65 × semantic,门禁拒绝则直接为零。
七个模型,139 张画,一个尴尬的数字
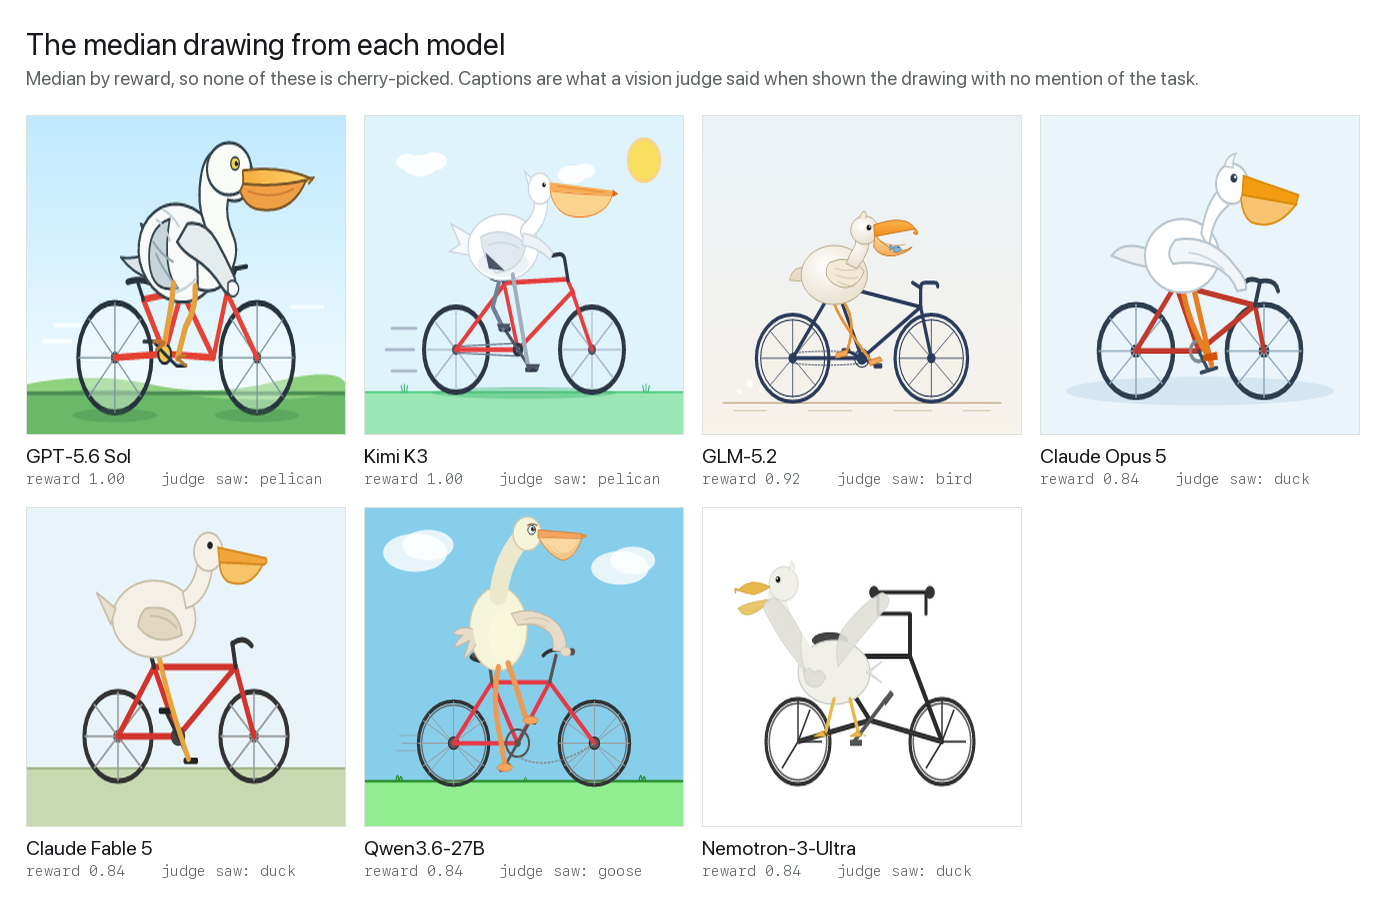
Paniego 用这个环境对七个模型各跑 20 个样本,共 139 张有效画(Kimi K3 有一张没交上来,它在 token 上限处仍在思考)。结果:GPT-5.6 Sol 平均奖励 0.959 排第一,Kimi K3 0.884 第二,GLM-5.2 0.878、Qwen3.6-27B 0.870、Claude Opus 5 0.868、Claude Fable 5 0.844、Nemotron-3-Ultra 0.814。第二名到第六名挤在 0.04 的区间里,20 个样本的粒度下分不出差距,开源与闭源模型整段交错,在这道题上不存在开源闭源鸿沟。结构分层已经饱和:139 个样本里 136 个拿到满分 1.000,前沿模型全部能画出几何正确的自行车,剩余的区分度全在语义层。
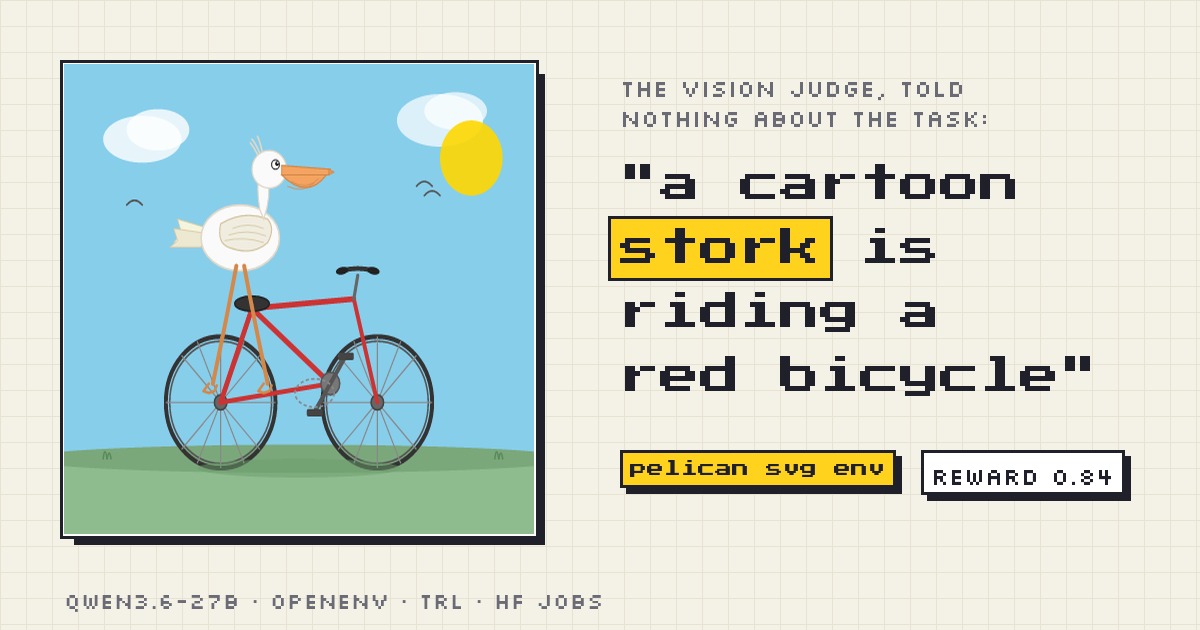
真正的尴尬在盲测环节。七个模型各自的中位数画拿给完全不知情的视觉评审看,只被认出两只鹈鹕,其余五只被认成了三只鸭子、一只鹅和一只不知名鸟。分模型统计更难看:139 张画里只有 40% 被盲评认成鹈鹕。Claude Fable 5 的画 20 张只被认出 1 张,最常见的误认是鸭子(8 次);Qwen3.6-27B 最常被认成鹳(10 次);GPT-5.6 Sol 表现最好,20 张被认出 13 张。一道给人类看一眼就能判分的题,前沿模型画了二十个月,仍有六成的画骗不过一只不知情的眼睛。
成本侧有一个与 Astra 网格互相印证的细节:Kimi K3 每张画平均发出 4.9 倍于画本身的推理文本(56.7 万字符的思考对 11.7 万字符的 SVG),是所有模型里唯一两次没能完成交付的。Willison 在单样本测试里也记过同一笔账:Kimi K3 生成一只鹈鹕消耗 16,658 个输出 token,其中 13,241 个是推理 token,总共花了 25 美分。单样本和 20 样本两个口径都指向同一件事:推理 token 是账单上最大的那一项。
用它训练模型:结构学会了,鹈鹕没学会
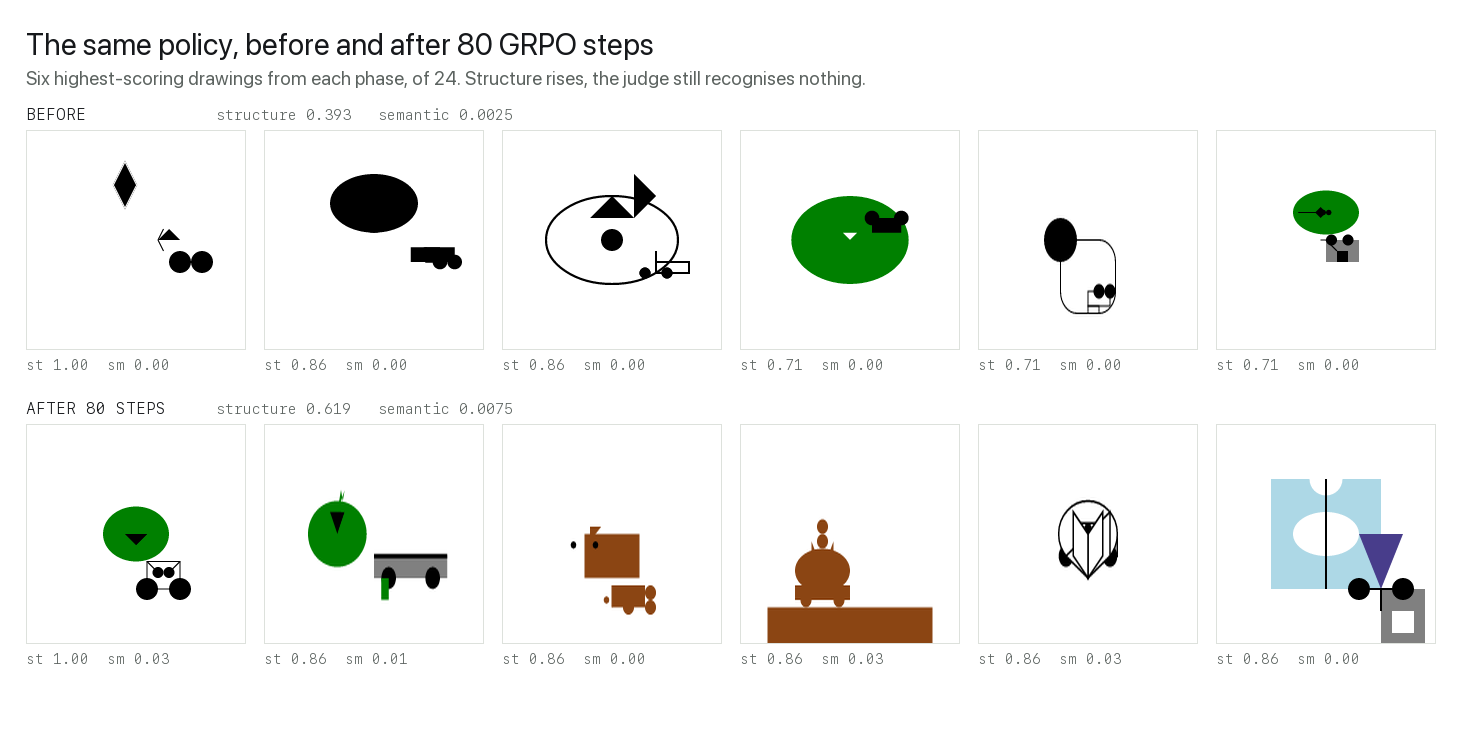
环境存在的意义不止评测。Paniego 用 TRL 的 GRPO 算法在 Qwen3-1.7B 上做了两组小规模训练,一组奖励只用结构分(评委关掉),一组用完整公式(评委开着)。关掉评委的那组学到了能迁移的东西:结构分从 0.374 升到 0.619,明显高于五个未训练对照样本,无效提交从 24 个里的 3 个降到 1 个。开着评委的那组什么都没学到,结构分停在未训练区间内。两组都没能画出评委认得的鹈鹕。
失败的画透露了原因。训练后的模型反复画同一个母题:一大团色块,下方两个等高的小深色圆,中间连一根线。它对七项几何检查全部拿满分,却既不是鹈鹕也不是自行车。Paniego 强调这不算 reward hacking,因为奖励里根本没有评委:策略只是精确做了被付费的事。更直接的结论是,结构分单独不足以代理这道题。开评委也救不回来,因为 GRPO 从组内奖励差异中学习,而 1.7B 的未训练模型 24 个样本里只有 2 个在语义分上拿到非零,大多数组内没有梯度可言。他给出的经验法则:训练前先检查你的评委在基座模型上的非零率,接近全零的奖励函数教不会任何东西。
一道题留下的三个事实
回看这道题的二十年(准确说是二十个月)生命期,它证明了三件事。其一,最简单的任务也能区分模型世代:Astra low 档 9.55 美分的一只鹈鹕好过上一代旗舰全部档位,这种代差在跑分表上经常被压缩成小数点后两位,在两只并排的鸟面前则看得清清楚楚。其二,评测本身是可以工程化的:门禁、结构、语义三层打分把一道娱乐题变成了能跑 GRPO 的强化学习环境,评测脚本与训练器读同一个奖励函数。其三,有分数不等于解决了问题:139 张画六成骗不过盲测,小模型学会了钻七项几何检查的空子却没学会画鹈鹕,1.7B 模型的教训是奖励函数在基座能力之上必须有非零梯度。这只鹈鹕还会随下一个新模型继续被画下去,环境是公开的,30 道题里的另外 29 道还没人跑过。
来源: