GTC Berlin 2026 前后,NVIDIA 把 Agent Toolkit 扩成一套面向企业的 Agent 栈,其中一名新成员在 GitHub 上快速升温:auto-ontology。仓库 2026 年 4 月 27 日创建,11 月初公开后几天内冲到 8100+ star(GitHub Trending 抓取时日增约 2700),Hacker News 讨论 289 分。它做的事一句话能说完:在 Agent 与企业数据库之间,放一层经过人工认证的业务语义。
查得快不如查得对
README 开篇给出的判断是:Agent 检索文档、查询数据库都不难,真正卡住企业数据分析的是可靠性。一个收入指标,回答得再快,数字错了就没有价值。Agent 需要一个上下文层,说明数据在哪里、含义是什么、能不能用、该怎么用、从哪里来、与哪些概念相似。
text-to-SQL 场景里这类错误很常见:问「上月收入」,销售库里有发票口径、回款口径、含税口径三种算法,schema dump 只告诉模型列名,不告诉它公司认哪一种;跨表查询要经过桥接表,模型猜错 join 路径,SQL 语法完全正确,结果集却是错的。Auto-Ontology 把这些信息提前写成可人工审核的定义,模型推理时按定义取用,不再自行猜测。
本体只装三类定义
这个「本体」比传统知识工程的 OWL 本体轻,核心只有三类对象:
- 术语(Terms):Customer、Invoice Line 这类业务概念,每个带描述和同义词,映射到实际持有数据的列;
- SQL 属性(SQL attributes):挂在术语下面、经过审核的 SQL 表达式,例如毛利率、滚动总和。Agent 复用这些表达式,保证同一个指标每次算法定义一致;
- 关系(Relationships):表之间怎么 join,包括桥接表,从主键、外键和数据本身推断出来。
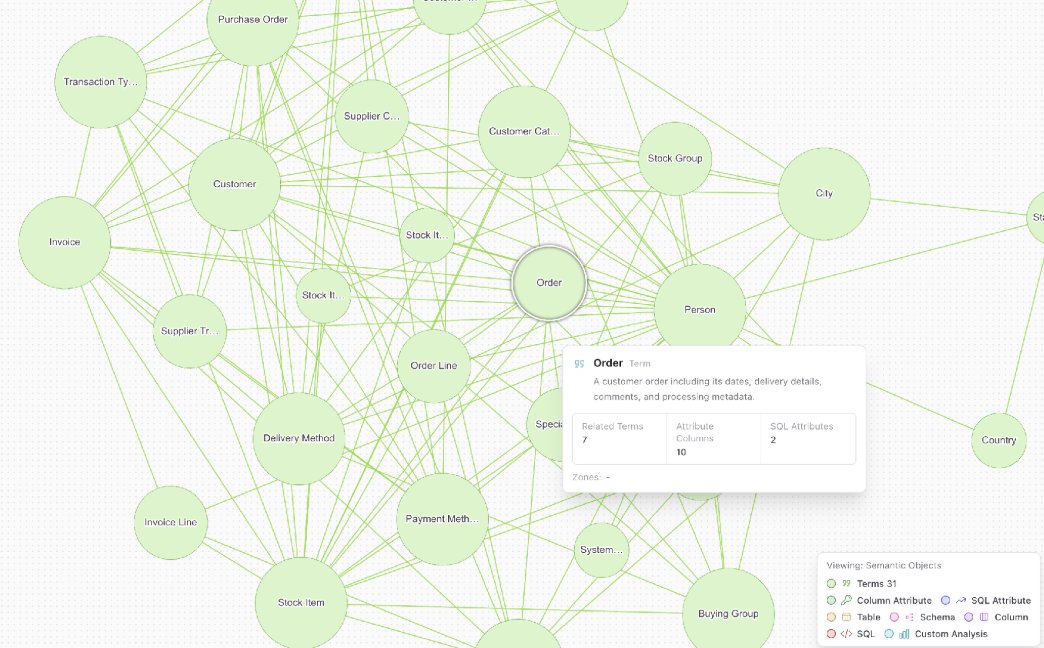
对微软示例库 Wide World Importers 做一次编译,产出 31 个术语。界面上选中 Order 术语,能看到它的描述(包含日期、配送明细、备注和处理元数据的客户订单)、7 个关联术语、10 个映射列和 2 个 SQL 属性。
从元数据到认证答案的三段流程
生成。 摄取服务对源数据库做四步:读出 schema、给列做画像、抽样值写入目录;逐表提取术语并映射到列;推断表间 join 与桥接表,并从查询历史里建议 SQL 属性;最后把术语、关系、SQL 属性写进 Postgres,嵌入向量存进 pgvector 供检索。
认证。 人来把草稿变成可信版本:在 Chat 里用真实问题测试,或在 MCP 通道上调 check_answerable 和 ask_question;在界面里修正术语、描述、SQL 属性;确认无误后逐项标记认证。
回答。 Agent 对每个问题走五步:分类意图、抽出实体;用嵌入检索候选术语、列、SQL 属性;据此写 SQL;把过滤值和整条查询对数据库做校验,失败就修复重写;执行后连同 SQL 与步骤一起返回。
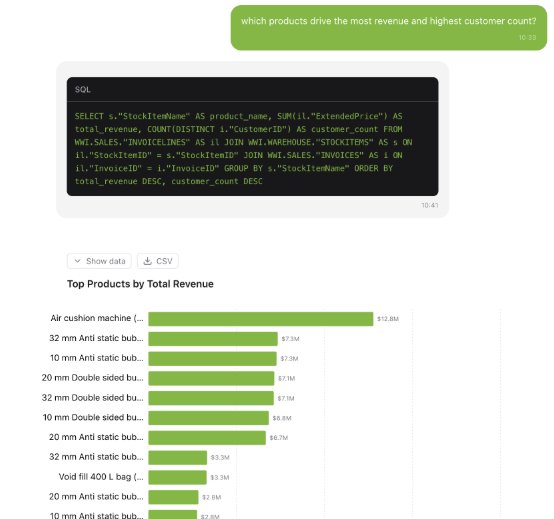
README 里的完整示例可以看这条链路:问「2015 年 6 月宾夕法尼亚州 USB 食物造型 U 盘(寿司卷)的收入是多少」,Agent 把 revenue、product、state 解析到本体里的 Invoice Line、Stock Item、State Province 术语,沿关系找出需要的 join(invoice line → invoice → customer → city → state province,加上 stock items 共 6 张表),校验过滤值后执行,返回 588.80 美元、来自 3 条发票行,SQL 与解析步骤一并附上。
数据答不了的问题,先说答不了
这个项目有个设计点值得单独说:answerability 检查。Wide World Importers 里没有广告投放数据,问「这个产品的广告支出回报率」时,连接进来的 Agent 先调 check_answerable,得到覆盖率 0.5、没有术语覆盖 ad spend 的结论,然后向用户反问:可以查这个产品 2015 年 6 月的收入,要不要改问这个,或者广告支出在另一个数据源里、需要先接入。
这对应的正是企业场景里最贵的那类错误:模型对着不存在的数据编一个看起来合理的数。能不能答,在本体层就有明确边界,不用等 SQL 跑完再猜。
部署形态与信任边界
整套栈的组件与端口如下:
| 组件 | 技术 | 职责 | 端口 |
|---|---|---|---|
| Frontend | Next.js 16(React 19、TS、Tailwind 4)、Better Auth、Prisma | Web 界面、认证、API 网关 | 3000 |
| Backend | FastAPI(Python 3.12+)、LangChain | text-to-SQL Agent、目录与本体 API | 3001 |
| 摄取服务 | FastAPI | 摄取与语义编译 | 3002 |
| MCP server | FastMCP | 对外提供只读 Agent 工具 | 3003 |
| Postgres 17 + pgvector | PostgreSQL | 目录、本体、应用数据、向量库 | 5432 |
| Vault | 可选 | 连接凭据存储 | - |
README 明确写了信任边界:3001 和 3002 两个端口应留在私网,摄取服务的 ingest/delete/reset/compile 端点自身没有鉴权,FastAPI 层信任前端转发的 x-auto-ontology-user-id 头,客户端一律走 3000 端口的 Web 应用。
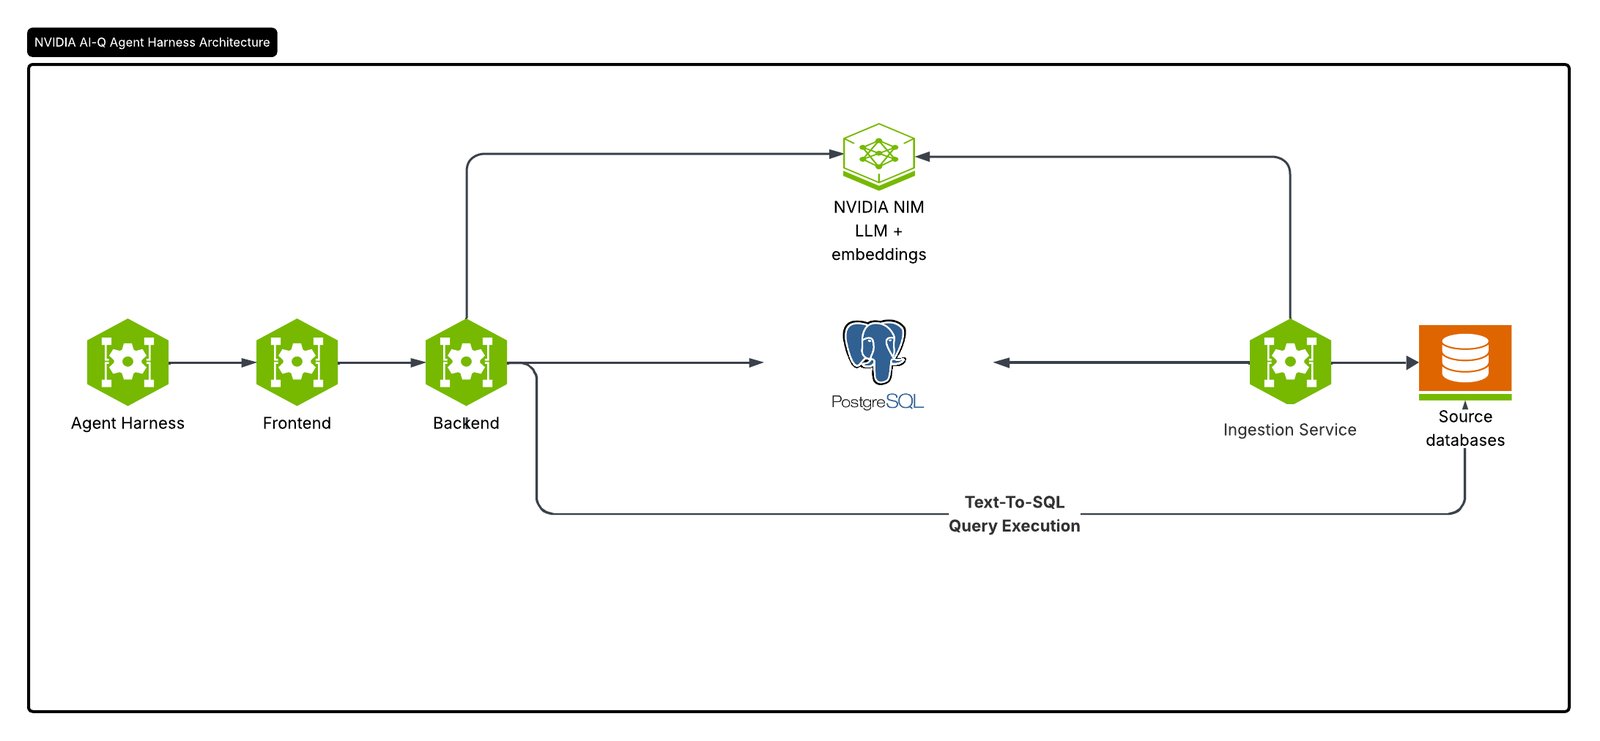
模型侧分四个角色,默认指向 NVIDIA NIM 端点,也支持任意 OpenAI 兼容端点:
| 角色 | 默认模型 | 用途 |
|---|---|---|
| REASONING | nemotron-3.5-lightning-30b-a3b | 构建本体、写答案 SQL、判定可答性 |
| NON_REASONING | nemotron-3.5-lightning-30b-a3b | 意图分类、实体抽取、SQL 校验修复 |
| EMBED | nemotron-3.5-embed-1b | 术语/列/SQL 属性的向量化与匹配 |
| RERANK | nemotron-3.5-rerank-8b | 编译桥接表 SQL 属性时的候选排序 |
数据源支持十种引擎:PostgreSQL、MySQL、Databricks、Snowflake、ClickHouse、Trino、Apache Kyuubi、HeavyDB、DuckDB、SQLite。预测类问题(下季度销量这类)在配置 KumoRFM 密钥后路由到 KumoRFM,会把已连接的表上传给它,默认上限 20 张表,README 提醒启用前先过组织的数据审查。
评测仓库:两臂对照,确定性判分
配套的 ontology-sql-eval 仓库专门回答「这层本体到底加了多少分」。设计是同一模型跑两臂:对照组只拿 schema dump 一次成 prompt;实验组让 Auto-Ontology 的 Agent 自己从本体检索上下文。两臂跑在 NeMo Gym 上,判分用确定性 verifier 执行双方 SQL 与标准 SQL 后比对结果,按各基准官方规则(BIRD 执行准确率、BEAVER 用 ex_acc),全程没有 LLM 裁判。
| 数据集 | 题量 | 引擎 | 形态 |
|---|---|---|---|
| BIRD | 1534(Dev)+ 500(Mini-Dev) | SQLite | 单轮 |
| BEAVER | 100(dw 抽样) | MySQL | 单轮 |
| FDABench-Lite | 169 | SQLite | 单轮 |
| Wide World Importers | 41 | Postgres | 单轮 |
| BIRD-Interact | 约 300(Lite)/ 600(Full) | Postgres | 多轮澄清 |
两处细节说明评测设计是认真的:超过 5% 的题目没有得到模型输出时,比对结果会拒绝给出 headline 数字(限流跑崩和模型太弱在原始准确率上长得一样);另外两个只喂给实验组的输入(相似题的 SQL 范例、指明关键词所在列的 value anchors)默认关闭,开了之后公布的差值要连同这些输入一起解释。README 本身没有给出公开基准上的 headline 数字,想引用具体提升幅度需要自己跑评测。
接入面与生态位
给 Agent 挂载的通道有三个:MCP server(check_readiness、search_terms、get_term、describe_table、check_answerable、ask_question 等只读工具,每个用户走自己的权限);REST API(POST /api/chat/completions,SSE 流式返回);三个面向编码 Agent 的 skills(setup、management、query)。本体定义支持 Apache Ossie 标准的 YAML 导入导出,转换器维护在 apache/ossie-converters 仓库。
在 NVIDIA 官方博客的叙述里,Auto-Ontology 属于 Agent Knowledge Foundation 的一部分,与 cuDF、cuGraph、cuML、cuOpt、cuVS 这些 CUDA-X 库并列;生态位是互补而非替代:NVIDIA 自己的供应链组织在通过 Palantir Foundry/Ontology/AIP 使用这套能力,Databricks 把 Kumo Anomaly 与自家 Genie Ontology 配对,Snowflake 在 Notebook 环境里接 Kumo 引擎。仓库采用 Apache 2.0 许可,每个源文件带 SPDX 头,团队自己维护代码、不接受外部 PR,集成需求走 issue 模板。
HN 上的质疑
289 分的 HN 讨论里,质疑集中在方法论:最高赞批评认为这是「用更多不可靠的 Agent 修不可靠的 Agent」,LLM 对训练记忆的权重高于眼前数据,叠一层 Agent 不解决根子问题。反驳者举 TCP 的例子:可靠传输正是建在不可靠的 IP 之上,组合不当会放大错误率,组合得当可以降低它。另一条讨论问这与「记忆系统 + 收集企业 API/CLI 的 skills」有何区别,回复给出的区分是:记忆系统由 RL 训练出的行为管理,这类系统用明确的 prompt 与常规软件把策略写死,牺牲一些效率换来可改进、可复现。
评论区吵的是方向,仓库给出的答案很具体:定义人可读可改、回答带 SQL 和步骤、答不了的问题先说答不了、提升幅度用确定性判分的对照实验来量。这套东西对企业数据团队的价值,跑一遍 WWI 示例库和两臂评测就能有自己的判断。
来源: