一台虚拟机上同时运行 1500 万个 Web 服务器,每个服务器都能独立响应 HTTP 请求。这个数字来自一篇发布在 kapteko.com 上的工程复盘,作者是 Artyom Yarulin,实验代码开在 GitHub 的 artemyarulin/AI10M 仓库。实验的起点是个玩笑:全球 80 亿人每人分一个 Web 服务器,「供给过剩,需求归零,网络安全问题从此一次性解决」。玩笑归玩笑,通往 1500 万的路上,每一道墙都是 Linux 网络栈里真实存在的工程约束,这篇文章把撞墙和翻墙的过程完整记录了下来。
先明确预算
实验的全部资源是一台 1 核 CPU、10GB 内存的虚拟机。10GB 摊到 1500 万个服务器上,每个分不到 700 字节。这个数字决定了后面所有技术选型的走向:任何一个按 KB 计的固定开销,乘上 1500 万都会直接爆掉预算。
第一道墙:门牌号只有六万个
Web 服务器监听在一个端口上,端口号是 16 位整数,上限 65535。Linux 默认的动态端口范围由 ip_local_port_range 控制,通常是 32768 到 60999,可用数量约 2.8 万。文章逐条列了这个范围之外的空间去哪了:端口 0 被保留;1-1024 需要 root 权限;1024-32768 留给各类服务端程序常驻,避免动态分配撞上 MySQL 的 3306;60999-65535 是 IP 伪装(Masquerade)时代留下的历史习惯。
把范围改到 1-65535,再叠加 TCP 和 UDP 可以共用同号端口,也就 13 万个监听位。要靠堆硬件解决,按文章的算式 15M/32k=450,需要插约 450 块网卡、用 450 个 IP。买一个容纳 1500 万地址的 IPv4 子网,市价约 2.5 亿美元。
软件解法是 AnyIP。VPS 服务商常送整个 IPv6 /64 前缀,一条命令就能把它整个挂到回环设备上:
sudo ip -6 route add local 2001:db8:1234:5678::/64 dev lo一个 /64 前缀对应 2 的 64 次方,约 1.8×10^19 个地址。监听位的问题到此解决。
第二道墙:每个进程 1.5MB
端口够用之后,最直觉的做法是启动 1500 万个进程。实测一个最小的 C Web 服务器进程占 1.5MB 内存,1500 万个需要 20TB。作者的解法来自他此前的两篇实验:把所有「服务器」装进同一个进程,用 LFI 做内存隔离,所有系统调用被拦截替换成宿主进程自己的实现,调度也由自建的用户态调度器完成,单个进程变成一个小型操作系统。
这个运行时里每个服务器要保留多少状态?那个 C 服务器的主循环只依赖两个变量:监听 socket 和客户端 socket 的文件描述符。调度器挂起一个服务器时,需要保存的只有返回地址和这两个整型:
struct Context {
    pc: u64,        // 恢复执行时的指令地址
    fd_server: i32, // 监听 socket 的文件描述符
    fd_client: i32, // 客户端 socket 的文件描述符
}
16 字节一个服务器,1500 万个共约 220MB。作者还提到用位压缩可以再压到 8 字节。剩下的内存按「100 万活跃连接、每个约 5KB」估算占 5GB,总账对得上。
这里出现了全文最诚实的一段。那个「空闲连接零内存、活跃连接约 5KB」的参数是问 LLM 得到的,作者照着写了验证代码:循环创建 1400 万个只监听不干活的 socket,期望内存占用为零,结果直接 OOM。他为此写了一段自我检讨:LLM 对学习是强力加速器,但照单全收它的答案而不自己验证,代价会在 dmesg 里等着。这个翻车把实验推向了真正的对手。
内核一个 socket 的账本:3384 字节
Linux 内核里,socket() 系统调用会分配约 3300 字节,不区分这个 socket 是在传输数据、在监听还是完全闲置。文章给出了明细:
| 结构体 | 大小 | 用途 |
|---|---|---|
| struct tcp_sock | 2240B | TCP 状态机、队列、定时器、序号、拥塞控制、重传簿记 |
| struct socket_alloc | 768B | 128 字节的 socket 结构与内嵌等待队列,加 608 字节的 sockfs inode |
| struct file | 184B | 打开文件的操作表、标志、引用计数 |
| struct dentry | 192B | sockfs 伪文件系统的目录项与生命周期管理 |
| 合计 | 3384B |
每个服务器一个内核 socket 就是 3384 字节起步,是每个服务器 700 字节预算的五倍。想省掉这笔开销,内核网络栈自身没有留出优化空间,那就不在内核里玩了。
往下三层走:状态都在 TCP 里
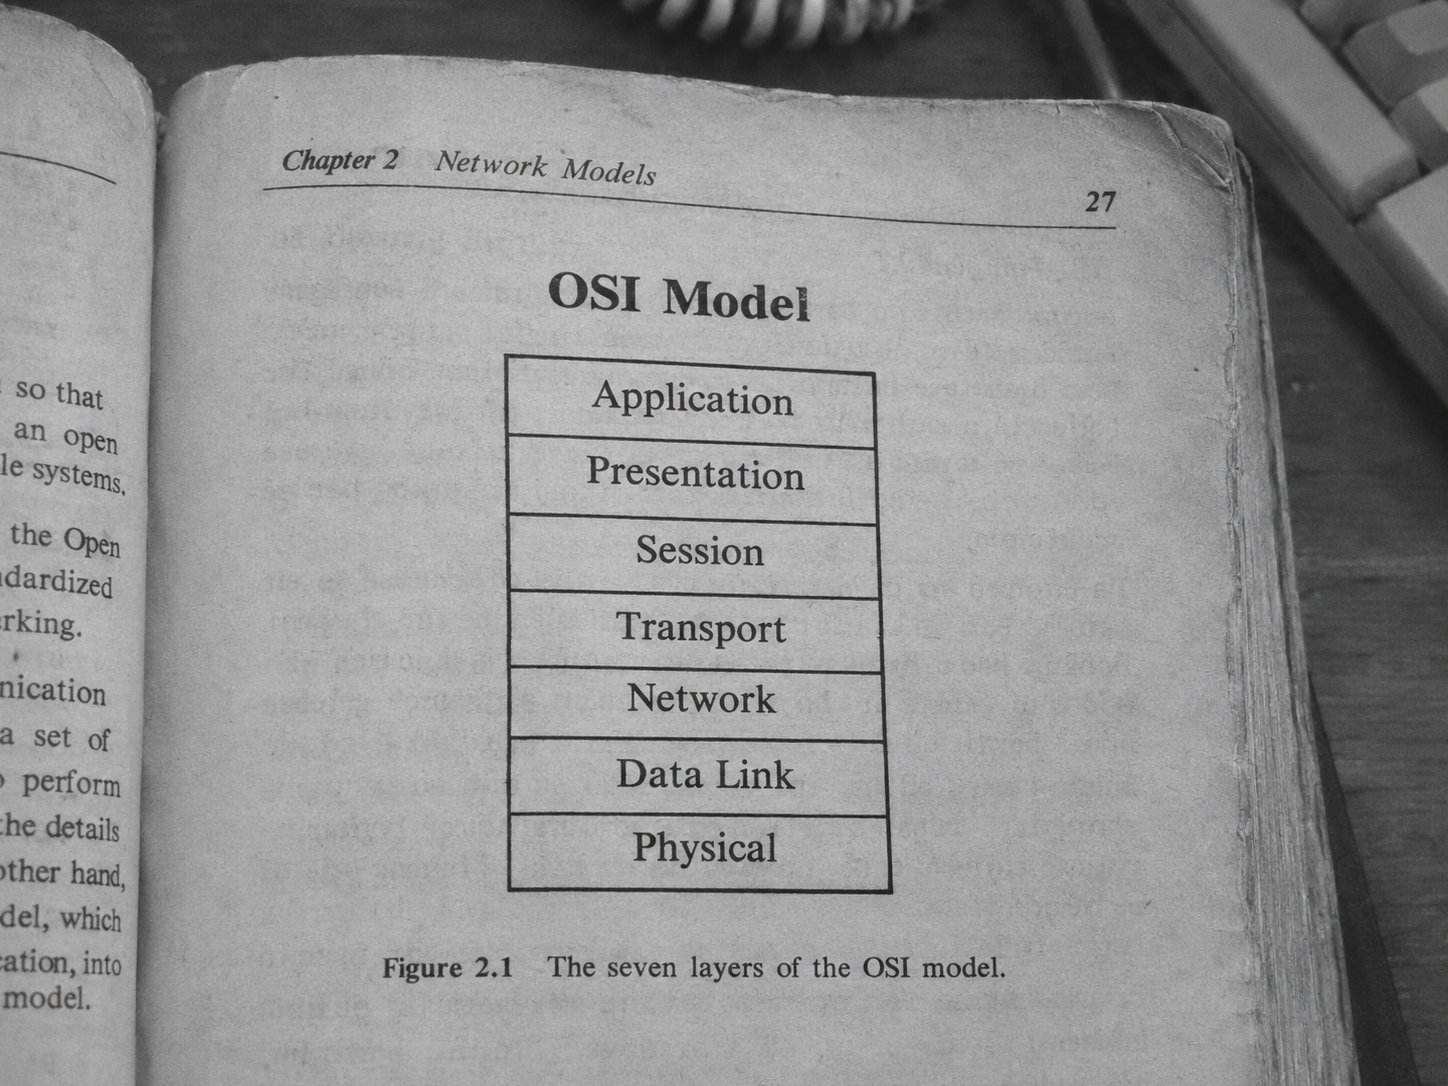
OSI 模型里,应用层的 HTTP 跑在传输层的 TCP 上。TCP 是有状态的,序号、确认、重传都要记账;而它下面的网络层和数据链路层是无状态的,IP 包和以太网帧只管搬运载荷。这留出一条路:只要自己实现 TCP 和 IP,底层自己收发帧,内核网络栈就可以整个绕开。嵌入式领域早有先例,Adam Dunkels 的 Miniweb 把自制 TCP/IP 栈和 HTTP 服务器加在一起只要 28 字节内存。成熟一些的实现有 gVisor(重写了整套 OS 含网络栈)、ScyllaDB 团队的 Seastar、C 的 lwIP、复用 FreeBSD 栈的 F-Stack。
作者选了 Rust 的 smoltcp。官方描述里有三个关键属性:独立、事件驱动、面向 bare-metal 实时系统,并且完全不需要堆分配。无堆分配这一点对 1500 万个实例的场景是决定性的,每省一次分配就少一类内存碎片。
smoltcp:会解析,不做 I/O
smoltcp 本质是一个协议解析器,自己不做任何 I/O,与外界网卡的通信要自己实现 Device 接口,三条通路:TUN 是内核提供的虚拟接口,工作在 IP 层;TAP 再往下一层,工作在以太网层;DPDK 直接用以太网帧与网卡对话,完全绕开内核。smoltcp 内建支持前两条。
往下的账用纳秒计:一次系统调用约 500 纳秒,内核向用户态拷贝数据再花约 1000 纳秒。高频交易场景把 400Gbps 网卡打满时,每秒约 6 亿个包,摊到每个包只有约 1.7 纳秒。这个量级下,每包一次系统调用不可接受,这正是 DPDK 和 AF_XDP 存在的理由。
DPDK 与 AF_XDP:两条绕过内核的路
DPDK 让程序通过内存映射缓冲区直接读写网卡,收发都不经过系统调用。它还免疫中断风暴:普通路径下每个到达的包都会触发一次中断,包速率高到一定程度,CPU 的时间全花在中断处理上,应用代码几乎得不到执行,这个状态有个正式名字叫 livelock。DPDK 用一个占满整核的忙循环自己搬运数据,代价有两个:独占一整颗 CPU 核心;网卡驱动接管设备后,网卡会从操作系统里消失,如果通过 SSH 远程启用 DPDK,会话当场断掉。
AF_XDP 是 Linux 内建的折中方案。内核仍然持有设备、中断照常发生,每个到达的包先过一个 eBPF 过滤器,由它决定是直接送进用户态缓冲区、绕过内核网络栈,还是走常规路径处理。SSH 不会断,管理成本大幅降低。它还有一个 SO_PREFER_BUSY_POLL 模式,打开后更接近 DPDK 的忙循环形态,代价同样是一个 CPU 核心。基准测试里 DPDK 最强,AF_XDP 紧随其后。实现层面,给 smoltcp 接上这两条通路只需要实现三个方法的 Device trait,社区另有 rust-dpdk-net 和 xsk-rs 两个 crate 可用。
结果:255 万对 1600 万
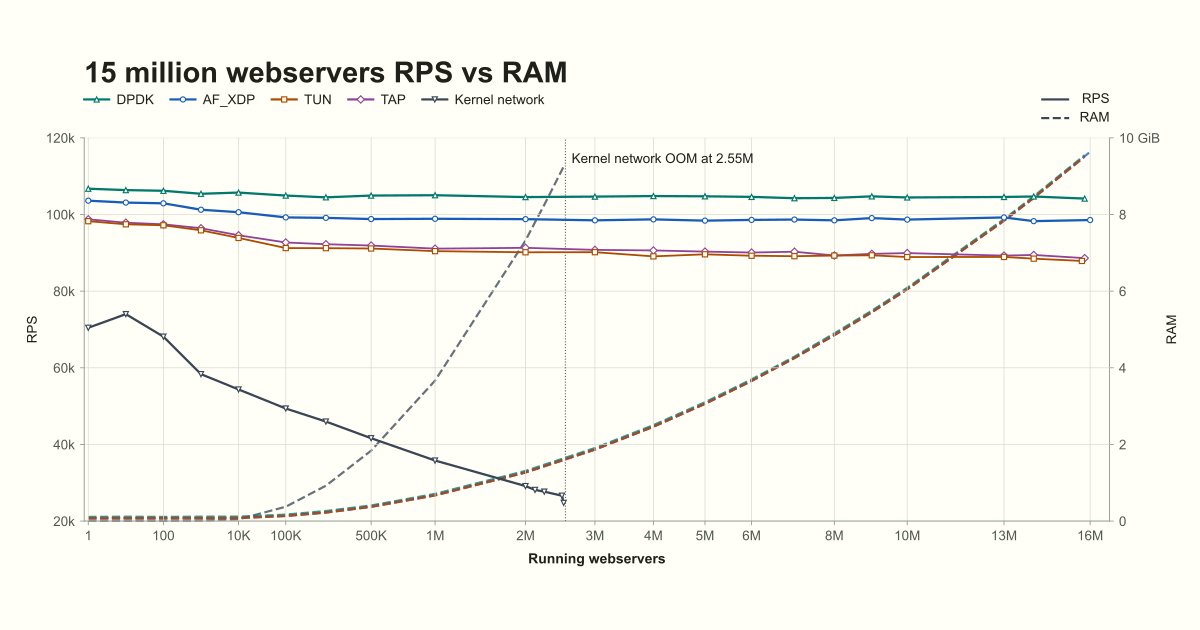
最终的基准图上有五条曲线:内核网络栈、TUN、TAP、AF_XDP、DPDK。内核网络栈在约 255 万个服务器处撞上 OOM,图上有一条垂直虚线标着这个位置,此前它的 RPS 已经从约 7 万一路掉到 2.5 万,服务器越多性能衰减越明显。四条用户态路径的 RPS 全程平稳:DPDK 稳在约 10.5 万,AF_XDP 在 10 万上下,TUN 和 TAP 略低。内存侧,smoltcp 把一个空闲服务器压到 620 字节、活跃的约 1KB,实验最终跑到了 1600 万个服务器,超过 1500 万的既定目标,此时整机的内存用量仍在 10GB 预算之内。
剩下的问题
作者在结尾把边界画得很清楚:把网络栈搬进用户态,换来的是内存用量的完全控制权,这是这次实验成立的全部原因;但跑通一个概念验证和做一个 100% POSIX 兼容的运行时是两件事,后者要把所有系统调用重新实现一遍,那是下一篇文章的篇幅。顺带一提,给全人类每人分配一个 Web 服务器的宏愿,在 10GB 内存的机器上已经验证了可行性,剩下的只是把全球 RAM 供应量的问题留给读者。
来源:kapteko.com – 15 million web servers on one VM;实验代码 artemyarulin/AI10M;DPDK 文档、内核 AF_XDP 文档