11 月 6 日,Meta FAIR 团队放出了 k-means 的新实现 e-means:论文挂在 arXiv(编号 2611.09501),代码直接合进了 FAISS 仓库的 contrib/e_means 目录。作者名单里有 Hugo Touvron、Matthijs Douze、Hervé Jégou 这批 FAIR 老兵。结果分三层:
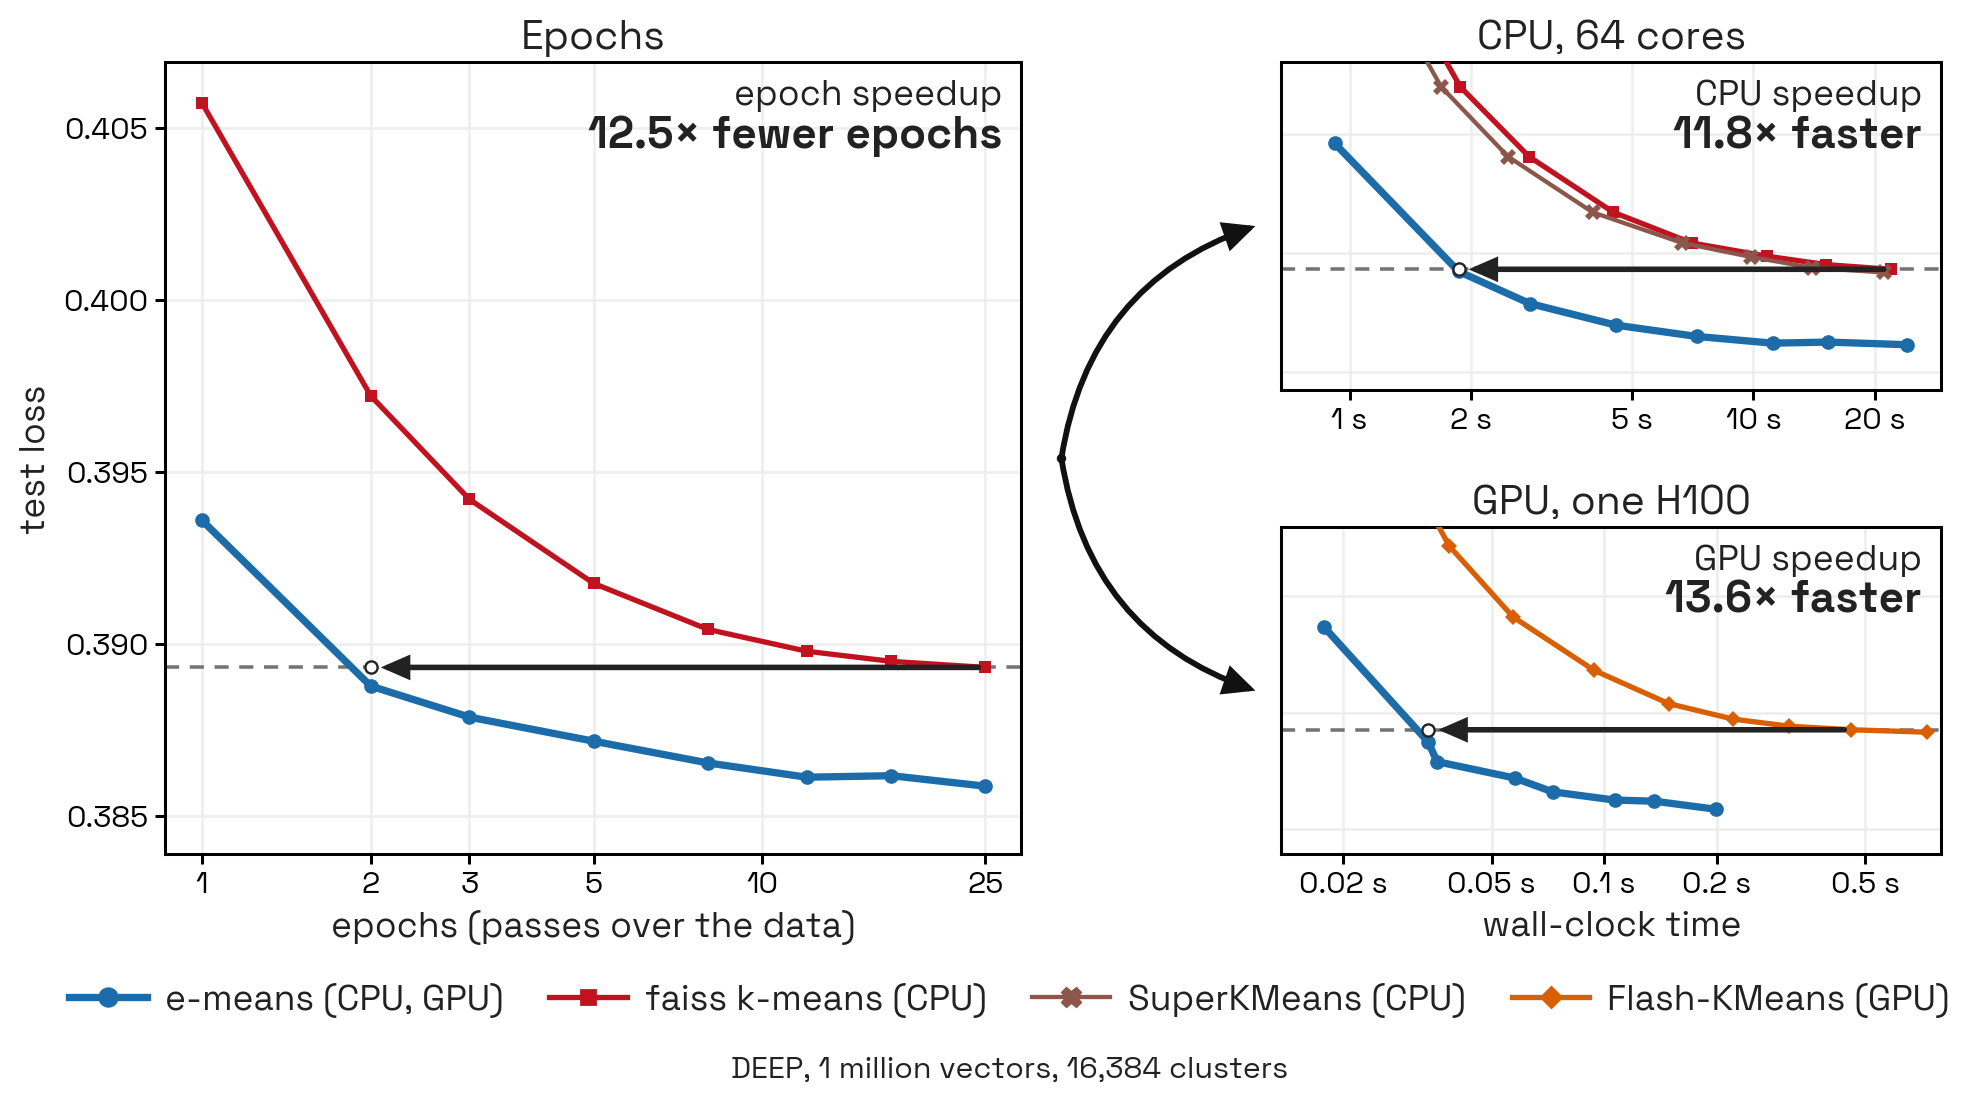
- 轮数:达到 Lloyd 算法 25 轮的测试误差,e-means 只需要 1.4 到 2.6 轮;
- 墙钟时间:对比当前最快的 Lloyd 实现 Flash-KMeans,GPU 端 10 到 45 倍加速;CPU 端对比 FAISS 自家实现是 8 到 15 倍;
- 损失:同预算下 e-means 收得更低,论文的说法是频繁超过带 k-means++ 初始化的 Lloyd。
规模最大的一条数据:DINO10B,100 亿条 DINO 视觉嵌入切成 1600 万个簇,e-means 跑 2.5 轮,损失低于 Lloyd 跑满 25 轮。k-means 是 NP-hard 问题里的老住户,也是向量检索索引(IVF)、产品量化码本、数据去重管线里每天跑几十次的底层原语,这个量级的替换成本和收益都值得算一算。
一个统计量视角装下三种更新规则
k-means 的所有变体都可以写成同一件事:每个簇维护一个点和 S_j 与计数 N_j,质心取两者的比值 c_j = S_j / N_j。区别只在怎么更新这对统计量。
| 算法 | 更新方式 | 特点 |
|---|---|---|
| Lloyd(1982,Bell Labs 1957) | S_j ← s_j,N_j ← n_j,全量数据当批次 | 每轮精确均值,一轮只更新一次 |
| MacQueen(1967) | S_j ← S_j + s_j,N_j ← N_j + n_j,只加不清 | 均值背着一开始的坏质心记忆走完全程 |
| e-means | S_j ← (1−α)S_j + α·s_j,N_j ← (1−α)N_j + α·n_j,小批次 | 旧记忆按 α 衰减,质心跟踪近期分配 |
EMA(指数滑动平均)这味药在 VQ-VAE 码本训练里用了很多年,因为那里的数据分布在动。e-means 的发现是:静态数据集同样适用,前提是批次和步长配好。项目起点是 Touvron 和 Jégou 此前的实验:用梯度下降更新质心也能赢 Lloyd。一作 Swann Bessa 复现后发现梯度下降在大学习率下不稳定,EMA 则稳定得多。他给出的解释:EMA 更新保证质心永远落在已分配点的凸包内,梯度下降可能一步跨出去。实测最优设置下,梯度下降最终比 EMA 高 1.6%(DEEP 数据集)和 0.4%(SIFT 数据集)。
Lloyd 落在超参数网格的角落
把批次 B 和步长 α 拉一张网格图(DEEP,100 万向量,k=1024,5 轮),会发现一个整齐的规律:最低损失沿着对角带分布,批次越大、步长该越大。Lloyd 的设定(B = n,α = 1)正好是网格的一个角落,离最优区域很远。换句话说,这个跑了四十多年的标准算法,是 e-means 超参空间里一个偏科的特例。
官方页面那个 10 万点、200 簇的演示动画展示了这个差距:同样一轮数据,Lloyd 只更新 1 次质心,e-means 更新 97 次。
三条标度律接管调参
小批次方法过去推广不开的原因是要调 batch size 和学习率。e-means 的做法是把这两个超参数交给三条拟合出来的公式:
- 批次(吞吐律):B = 0.035134 · k^0.134749 · n^0.876473 · T^0.813344
- 批次(质量律):B = 0.00439175 · k^0.134749 · n^0.876473 · T^0.813344,批次约小 8 倍,损失更低
- 初始步长:α₀ = 0.8244 · k^−0.4617 · B^0.9003 · n^−0.4498 · T^−0.1057,截断在 [0.0001, 1]
n 是向量总数,k 是簇数,T 是轮数。步长随训练按余弦调度退火到 0.1α₀,结束时每个簇取最后一轮的精确均值。拟合质量用 regret 衡量(公式给的 MSE 与网格最优的相对差):步长律 0.07%,批次律 0.07% 到 0.19%,R² 0.95 到 0.96,在 SIFT、SPACEV 和 VIBE 的 held-out 数据集上成立。使用者只需要像 Lloyd 一样给出轮数(默认 5,支持 2.5 这类小数),其余全部自动。
小批次的噪声帮它逃出局部最优
k-means 的经典痛点是局部最优:质心分配失衡后,全量更新会把这个坏格局锁死。团队在四个玩具数据集上各跑 200 个随机种子:
| 数据集(k) | Lloyd 卡死比例 | e-means 卡死比例 |
|---|---|---|
| 两个大小悬殊的团块(k=8) | 26% | 3.5% |
| 九团 3×3 网格、四角更重(k=10) | 43%(差 1% 以上) | 4% |
| 四角团块加更重的中心(k=5) | 15.5% | 0% |
| 一条线上的五个团块(k=5) | 46% | 0% |
解释是:小批次带来有噪声的更新,更倾向于探索而不是锁死;Lloyd 的损失单调下降,找到局部极小值就出不来了。
死簇按比例分裂,别随机重采样
小批次方法的另一个坑是死簇:某些质心分不到点,码本容量缩水。EnCodec 的做法是拿当前批次的随机样本顶上。e-means 改成按簇大小比例抽一个大簇劈成两半(思路来自 FAISS)。100 万向量、16,384 簇、5 轮的消融:
| 策略 | DEEP 死簇数(占比) | DEEP 不均衡度 | DEEP 测试 MSE |
|---|---|---|---|
| 不处理 | 4,313(26.3%) | 1.647 | 0.39448 |
| EnCodec 随机重采样 | 2,343(14.3%) | 1.423 | 0.39124 |
| 比例分裂(e-means) | 47(0.3%) | 1.194 | 0.38762 |
SIFT 上结论同向:比例分裂 10 个死簇(0.1%)对随机重采样 750 个(4.6%)。低维有两个特判:d ≤ 16 默认走质量律,d ≤ 2 关闭复活(二维上复活反而有害)。
进了 FAISS 主仓库的工程形态
安装只要 pip install faiss-cpu,GPU 跑法也不需要 CUDA 版 FAISS:e-means 在 GPU 上完全走 PyTorch,按硬件自动挑核,H100/H200 的 BF16 数据用 CuTe(CUTLASS DSL 4.7.1 以上),A100 起的其他卡用 Triton,都不支持时退回 PyTorch 原生。GPU 核把最近质心分配这一步融合进单 kernel,把轮数优势兑换成墙钟优势。H100 上 1000 万向量、65,536 簇的参考数字:25 轮 PyTorch Lloyd(bf16)要 142 到 155 秒,Flash-KMeans 压到 14 到 22 秒,e-means 在此之上再拿一个量级。
API 面向替换设计:
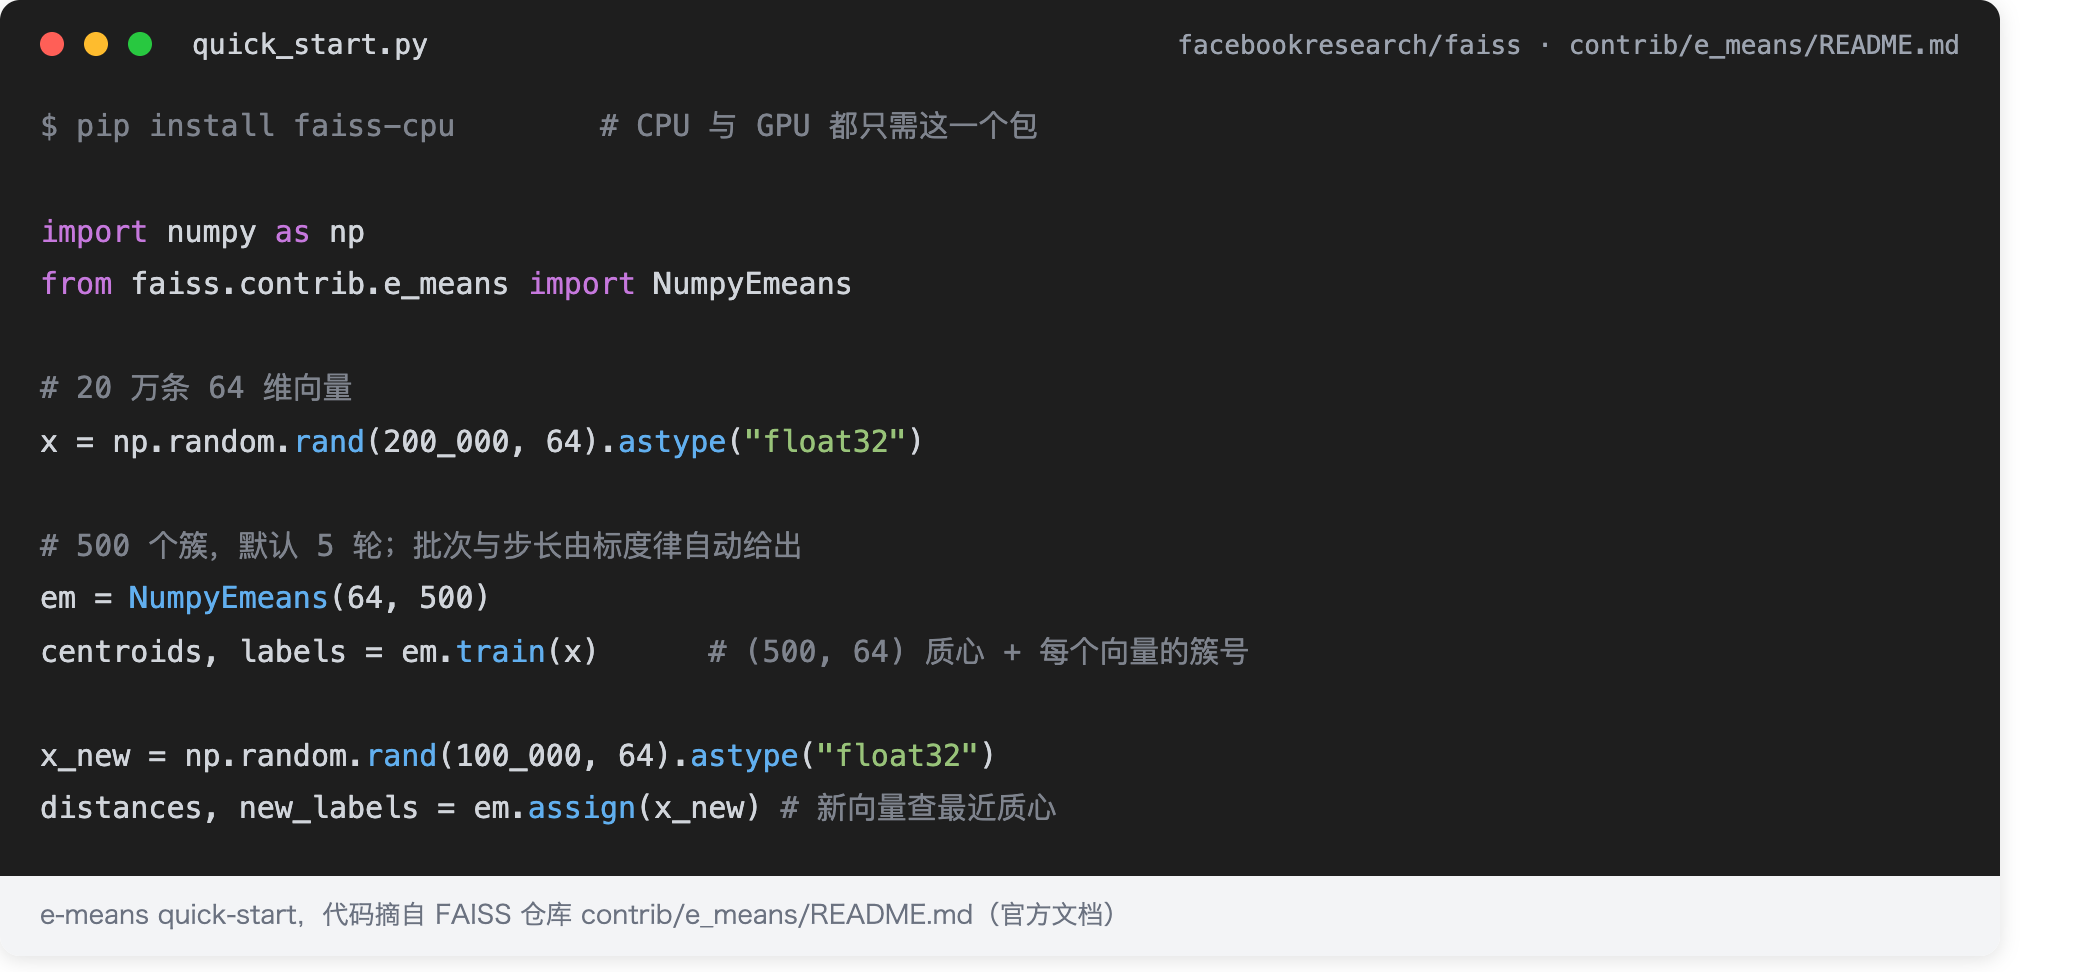
训练返回质心和每个向量的最后一轮标签,新向量用 assign 查最近质心。分布式版本(DistributedEmeans)和分片质心(EmeansShardedCentroids)也在 contrib 里,复现脚本放在 benchs/e_means。
HN 上试过的人怎么说
讨论帖 216 分。有用户把方法迁移到自己的 IVF 索引训练上,GPU 报告 146 倍加速;另一位拿它替换球面网格松弛里的 Lloyd,反馈可用。也有人提出保留意见:标度律是事后拟合的,外推到未覆盖的规模需要自己验证。发布者未承诺进 scipy,短期内 Python 生态的入口就是 FAISS。
对存量系统,这是一次低风险的替换实验:接口、随机种子、抽样上限(max_points_per_centroid)都对齐了 FAISS KMeans 的习惯,先用小数据集对跑 loss 曲线,再决定要不要全量切。
来源:e-means 项目页 · arXiv:2611.09501 · faiss/contrib/e_means · HN 讨论