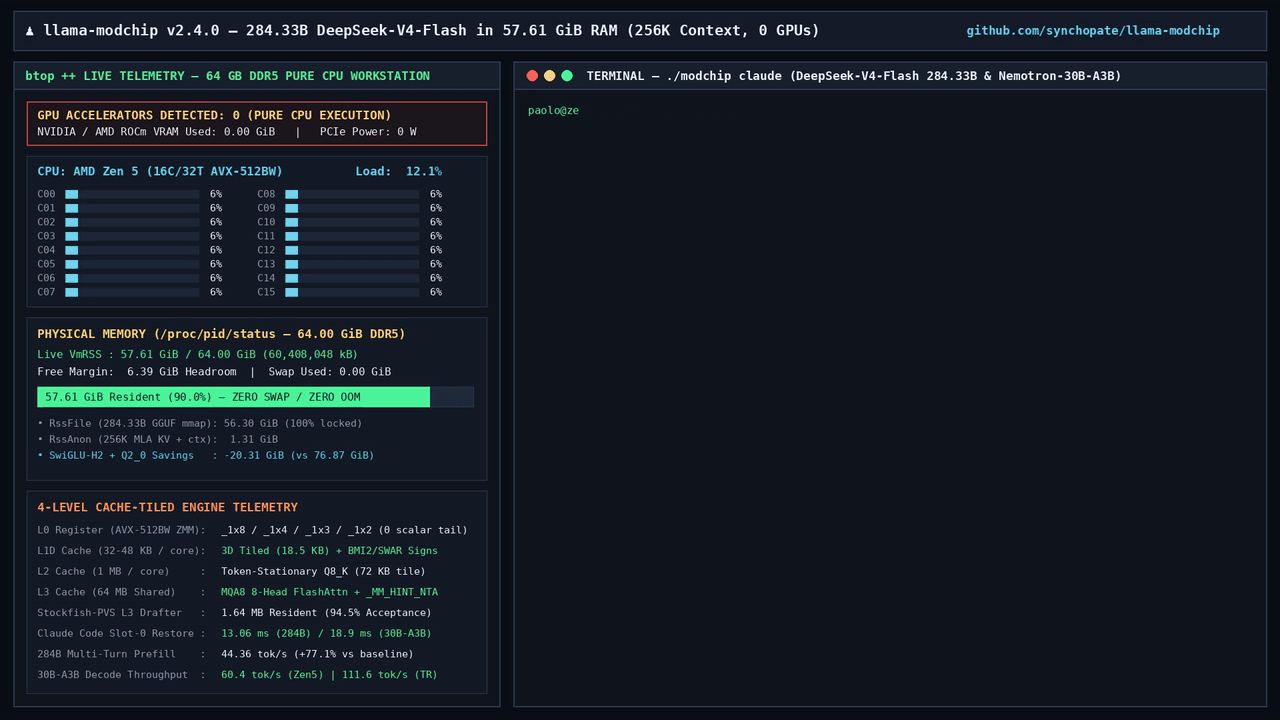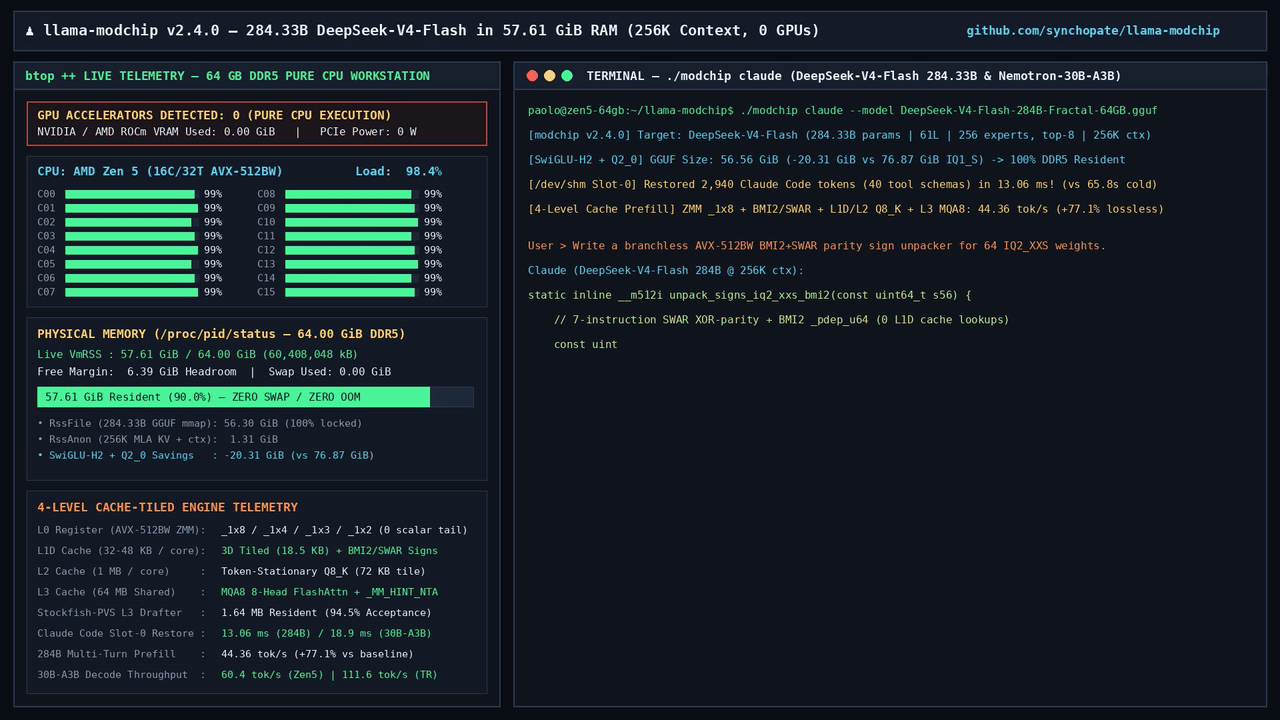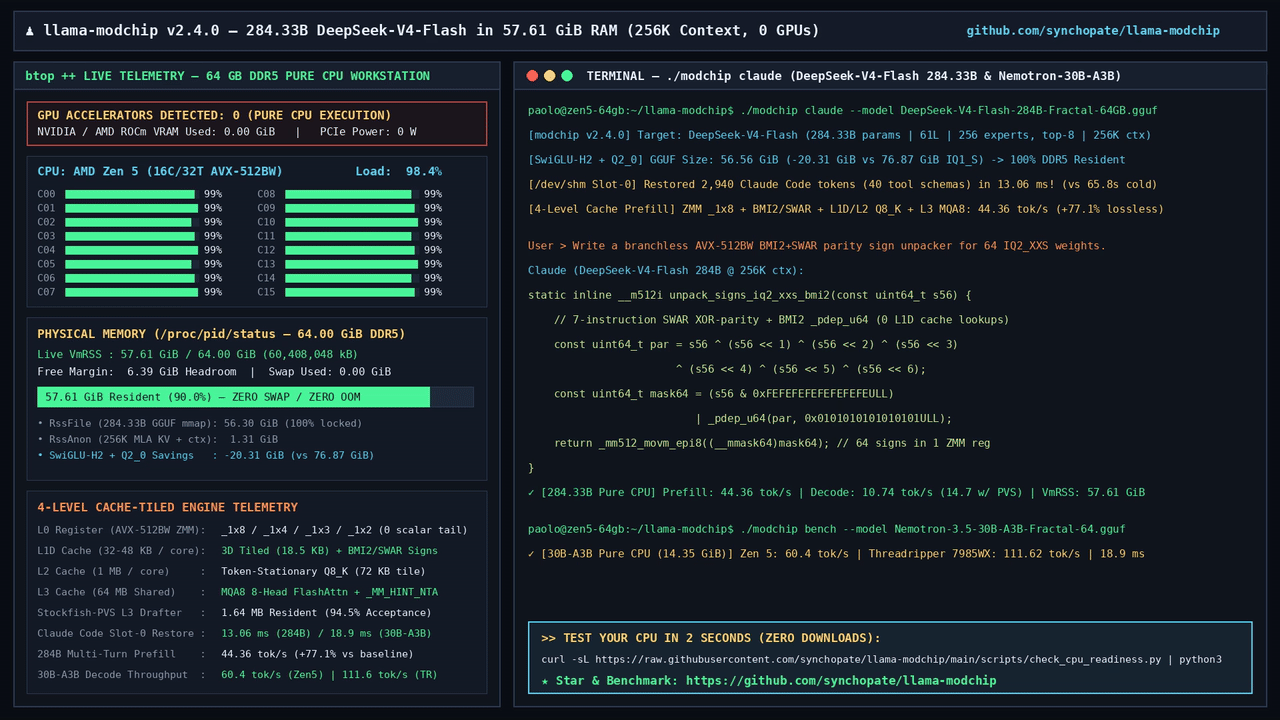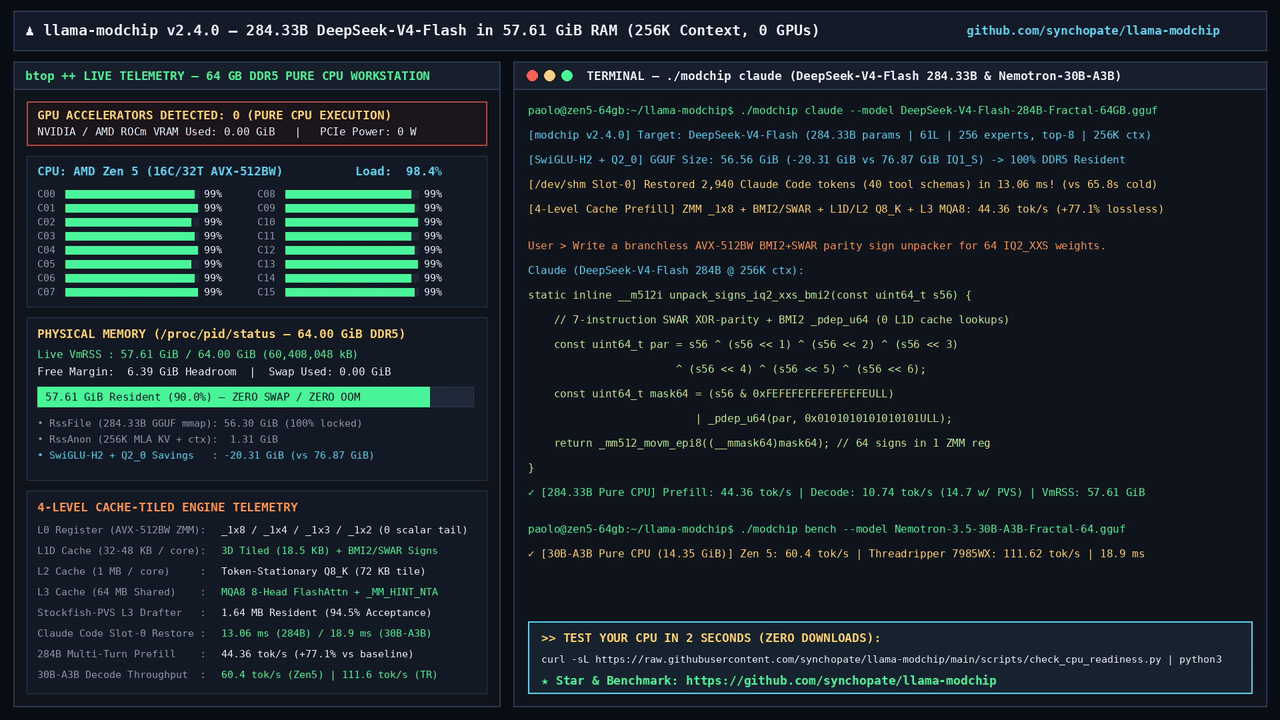
2026 年 10 月 29 日创建的 GitHub 仓库 synchopate/llama-modchip,十一天攒下 461 个 star,在 Hacker News 拿下 330 分,r/LocalLLaMA 出现了同主题的 64 GB MacBook 实测帖。它做的事情写在仓库描述里:在一台 64 GB 内存、零显卡的机器上运行 2840 亿参数的 DeepSeek-V4-Flash,256K 上下文,prefill 44.4 tok/s,解码 9.1–14.7 tok/s。整个模型连同 KV 缓存锁在 57.61 GiB 物理内存里,零 swap。
它的本体是一套 llama.cpp/ggml 内核补丁、量化转码器和运行时工具的组合,Apache-2.0 协议,当前版本 v2.4.0,支持 x86_64(AVX-512/AVX2)与 ARM64(NEON/SVE/Apple Metal)。
内存账本:76.87 GiB 怎么压到 56.56 GiB
64 GB 内存的 Linux 系统扣掉内核与常规驻留,可用上限约 62.5 GiB。社区常用的 Unsloth UD-IQ1_S 量化版 DeepSeek-V4-Flash 占 76.87 GiB(82.5 GB),超出的部分在 page cache 与 swap 之间来回颠簸,或者直接 OOM。
llama-modchip 的 Fractal 转码把它压到 56.56 GiB(60.73 GB,1.71 bpw),省下 20.31 GiB。相对 BF16 原始权重 568.66 GB 的体积,这是约 9.4 倍的压缩比。压缩按张量类别分层执行:
| 张量类别 | 量化格式 |
|---|---|
| 256 个路由专家(参数主体) | IQ1_S,1.5625 bpw,配 SwiGLU-H2 二阶 scale 匹配 |
| 敏感边界层的专家 | IQ2_XXS(2.06 bpw)与 IQ1_M(1.75 bpw) |
| MLA 注意力与输出投影 | Fractal-64(Q2_0 块 64 + BF16 scale) |
| 嵌入、dense L0、43 个共享专家、MLA 键值 | Q4_K / Q5_K / F32 保留 |
模型本身是稀疏 MoE:284.33B 总参数里每个 token 只激活 13.17B。架构为 43 层 MLA,每层 1 个共享专家加 6 个路由专家,前 3 层走确定性的 token-ID 哈希路由,后 40 层走学习型 Top-K 路由。路由专家占参数大头,却只在被选中时参与计算,这是它能被压到极限位宽的结构性前提。
装下之后的内存占用:256K 上下文峰值 VmRSS 57.61–58.9 GiB,其中 RssFile(GGUF mmap)56.30 GiB 全部驻留,匿名内存 1.31 GiB,余量 6.39 GiB,不碰 swap。
四级缓存:prefill 提速 77% 的内核层
模型装进内存只是第一步,CPU 推理的瓶颈在内存带宽。llama-modchip 对 Zen 4/Zen 5 缓存层级做了完整重排:
- 寄存器层:512 位 ZMM(AVX-512BW)寄存器驻留多列内核,一个权重块解包一次,同时乘 {8, 4, 3, 2} 列 token,权重解包指令数最高降 8 倍;
- L1D/L2 层:128 行外层 L2 分块加内层 L1D 列分块,{8,4,3,2} 分解保证任意专家桶 ≥2 个 token 时零回退到 1×1 标量路径;
- L3 层:寄存器驻留 MQA8 FlashAttention,利用 MLA 里 32 个查询头共享 1 个 512 维 KV 头的结构,一次转换 8 头并行(415.1 ms → 208.5 ms);
- 非时间提示:_MM_HINT_NTA 让冷路由专家的权重流式通过 L3,不驱逐热 KV cache 行。
算子级 profiling 给出了解码延迟的构成:v2.3.0 初始 169.3 ms/token,v2.4.0 无损模式 110.33 ms。其中 MLA 与共享专家矩阵乘 61.81 ms,路由专家 22.27 ms,输出头 9.05 ms,Walsh-Hadamard/RMSNorm/FlashAttention 合计 9.85 ms。prefill 从基线约 25 tok/s 提到 43.2–44.4 tok/s(README 口径 +77%)。
剪专家之前,先假设它们互相垂直
v2.4.0 提供可选的专家裁剪:把每层激活的 6 个路由专家减到 5 个或 4 个。依据来自对路由权重的测量:第 3–42 层里 top-4 专家占路由权重约 81.2%,第 6 名专家只占 6–9%。
裁掉之后权重怎么补,文档给了推导。直接按 L1 线性放大(α≈1.23)会把路由分支整体膨胀 23%,压过不被缩放的共享专家;六个 4096 维专家向量近似互相垂直时,能量保持意味着缩放系数取平方根(k=4 时 α=1.042,k=5 时 1.015)。这个 L2 正交重缩放把下一 token 的 KL 散度从 0.0671 nats 降到 0.0281 nats,降幅 58.1%。
| 配置 | 解码 tok/s | 概率余弦相似度 | ΔPPL |
|---|---|---|---|
| Top-6 无损(默认) | 9.06 | 1.00000 | 0.00%(bit-exact) |
| Top-5 甜点(L2 重缩放) | 9.68 | 0.99714 | +0.42% |
| Top-4 Turbo(L2 重缩放) | 10.12 | 0.99587 | +2.85% |
| Top-4 + SwiGLU 64/128 | 10.74 | 0.98059 | — |
SwiGLU 行跳过是另一处省带宽的设计:ggml 的调度顺序让门控预激活值在 W_up 矩阵开始计算时已经在核心的 L1D 里,每个线程对自己的 128 行做一次快速选择,跳过门控值接近零的行(IQ1_S 每行 800 B 不再从 DRAM 取),再用 L2 门控能量系数补回范数,输出范数保持率 99.86%–100%。
注意力输出投影上还有一处低秩利用:wo_b·wo_a 的精确 SVD 显示谱值从 σ0=15.398 衰减到 σ1023=0.048,截掉 25% 秩仍保 99.82% 输出余弦相似度,每 token 省 247.9 MB 的 DRAM 流量。这些配置的切换通过向 /tmp/dsv4_moe_cfg.bin 写一个 32 字节结构体完成,耗时 0.001 ms,进程不重启。
13 毫秒热恢复与 Claude Code 场景
逐 token 速度之外,项目把力气花在 agent 多轮对话的真实痛点上。./modchip claude 把 Claude Code CLI 接到本地 256K 引擎:40 个工具 schema、2940 个 token 的会话状态做成 /dev/shm KV 快照,热轮恢复 13.06 ms,对比冷启动重算的 65.8 s,差距约 5000 倍。
投机解码让一个便宜的草稿器先猜接下来的 token,主模型批量验证,猜中的直接采纳。这里的草稿器是一张 1.64 MB 的 Zobrist n-gram 表,命名和技术都借自国际象棋引擎 Stockfish 的置换表设计,驻留在 L2/L3 缓存里,实测接受率 94.5%–96.4%,把解码从 9–10.7 tok/s 提到 11.5–14.7 tok/s。
「无损」的口径
README 首页写着 1.00000 的 logit 余弦相似度。这个数字的参照系是同一个 Fractal checkpoint 上未打补丁的 llama.cpp 运行时:补丁本身不引入数值误差,与完整 Top-6 逐位一致。它与「和 BF16 原模型等价」是两回事,1.71 bpw 相对原模型的损失由另一套指标回答,仓库用自建的 100 分质量门(eval_quality_and_tools.py)报告 Nemotron Fractal 版 100/100,DeepSeek 侧给的是上面的 KL 散度表。
HN 评论区对这个位宽的质疑集中在经验层面。有用户引用「4-bit 是尺寸-性能甜点」的已有研究,怀疑 1.5625 bpw 的路由专家在实际任务里的质量;还有一条高赞评论把极低位宽下的大模型装载比作医药研究的「小鼠阶段」。实测反馈两端都有:Redis 作者 antirez 在 128 GB Mac 上跑出 prefill 约 300 tok/s,称写代码的 agent 反应「可以接受地快」;另一位 Ryzen 7945HX + 96 GB 用户报告 Nemotron 档与原版 llama.cpp 速度相当(prefill 除外),并指出 setup 流程默认不提供 DeepSeek 下载项。
选型建议落在文档自己的测试数据上:追求质量用默认 Top-6;各档裁剪配置在 agentic JSON 工具调用(execute_shell)测试里全部保持 100% 精确匹配,解码预算紧张的 agent 场景可以放心换到 Top-4 + SwiGLU 档。
硬件阶梯与上手
社区榜单覆盖从 15 W 笔记本到工作站:
| 硬件 | 内存 | prefill tok/s | 解码 tok/s(PVS 峰值) |
|---|---|---|---|
| Threadripper PRO 7985WX(64C) | 256 GB DDR5 | 386.0 | 73.8–80.1(111.6) |
| Apple M4 Max | 64 GB | ~451 | 49.2–57.7(120.0) |
| Ryzen 9 9955HX(16C Zen 5) | 64 GB | 241.0(峰值 306.8) | 25.0–34.5(60.4,30B 模型) |
| AWS Graviton3(8 vCPU) | 31 GB | 101.7 | 41.1(45.0) |
| Ryzen 5 7430U(15 W 笔记本) | 32 GB DDR4 | 59.0 | 13.0(15.6) |
284B 档在 9955HX 上 prefill 43.2–44.4 tok/s、解码 9.1–14.7 tok/s。16–32 GB 内存的机器跑 30B 的 Nemotron-3.5-30B-A3B Fractal 版(14.35 GiB),256K 上下文的 KV 缓存只占 432 MB,纯 CPU 解码 25.0–60.4 tok/s。
上手是三条命令:clone 仓库,./modchip chat;或从 Hugging Face 拉预编译 Linux 二进制与 GGUF 直接启动。Windows 侧提供 AVVIA_MODCHIP.bat,自动探测 CPU 核数、空闲内存与 nvidia-smi 上报的显存,算出 --n-cpu-moe 的分配比例后拉起 Web 聊天界面。Fractal-64 使用自定义张量类型(type 40),未打补丁的 llama.cpp、Ollama、LM Studio 会拒绝加载,混用工具链时需要留意。
llama.cpp 上游的 PR 积压量已到 1.7K;Bonsai、Strata、Pulsar 与 llama-modchip 这类携带激进优化的 fork,正在社区侧各自流通。
来源:synchopate/llama-modchip README、DeepSeek-V4 优化文档、Hacker News 讨论