AI 助手的跨会话记忆是 Agent 工程里投入产出比最难预估的一环:记多了拖慢推理,记少了等于失忆,记错了比不记更糟。Anthropic 官网发布了署名 Lance Martin 的长文《The Components of Agent Memory》,把 Claude 记忆系统的设计拆成组件逐一评测:笔记怎么写、错误怎么纠、知识怎么组织、上下文怎么预载。评测部分给出了一组罕见的对照数据,其中最直观的一场实验让 Claude 玩《宝可梦 红》:一个版本记了 413 个记忆文件,拿到 1 枚徽章;另一个版本只记 9 个文件,拿到 4 枚。
哪些东西不算 Agent 记忆
Anthropic 把定义收得很窄:记忆是 Claude 从经验中获得、跨会话保留、以可读上下文形式存下来的知识。三个近邻概念被明确排除在外:权重(训练期固化的参数)、上下文内学习(只在单次会话内生效)、压缩摘要(compaction,把旧对话轮次折叠成摘要来腾出窗口)。记忆是独立的第四层,会话结束了它还在,下次会话能读。
设计出发点借自人脑。海马体在经历发生时快速编码,但大部分经验是在睡眠和静息时被回放、蒸馏并整合进新皮层的。Agent 的对应物是会话日志(经历发生时的原始记录)和「做梦」(dreaming,空闲时段对日志的离线整理)。这条思路最早由 Letta 与 UC Berkeley 的研究者以 sleep-time compute 的名义提出,Anthropic 把它用在了 Claude 的记忆维护上。
记忆是写给未来的预测
CL-Bench 1.0 是一个测长程任务中记忆使用能力的基准。其中一个数据库任务的设计是:Claude 每道题都在全新会话里作答,唯一跨会话保留的是一个记忆目录;答完题被告知正确答案,可以写记忆留给未来的自己。评测跑在 Claude Managed Agents 上。
这构成了一个学习闭环:答错,记录失败,提出归因理论,验证理论,固化成规则。不同代模型在这个闭环上的行为差异,比分数本身更有信息量:
| 模型 | 记忆目录里留下了什么 | 闭环走到哪一步 |
|---|---|---|
| Sonnet 4.6 | 散落在多个文件里、多条未经检验的猜测 | 会生成理论,不验证 |
| Opus 4.7 | 合并成单一参考文档,标注哪些已核实、哪些未确认 | 建立可信度分层 |
| Sonnet 5 | 每个答案被批改后标记「已确认」,答错会写纠正 | 引入批改反馈 |
| Opus 5 | 规则、判断依据、已发现的陷阱警告 | 首个完整闭环 |
| Opus 5.5 / Sonnet 5.5 | 与 Opus 5 同级的闭环行为 | 闭环,且无记忆时的基线更高 |
上表按原文的行为描述整理。代际演进的方向很清楚:从「会生成理论」走到「会验证理论,并连同依据一起存下来」。
宝可梦:413 个文件输给 9 个
判断什么值得记的能力(salience 判断),评测方式是让模型玩《宝可梦 红》。每个模型开局拿到一个可读写的记忆文件夹,边玩边记。
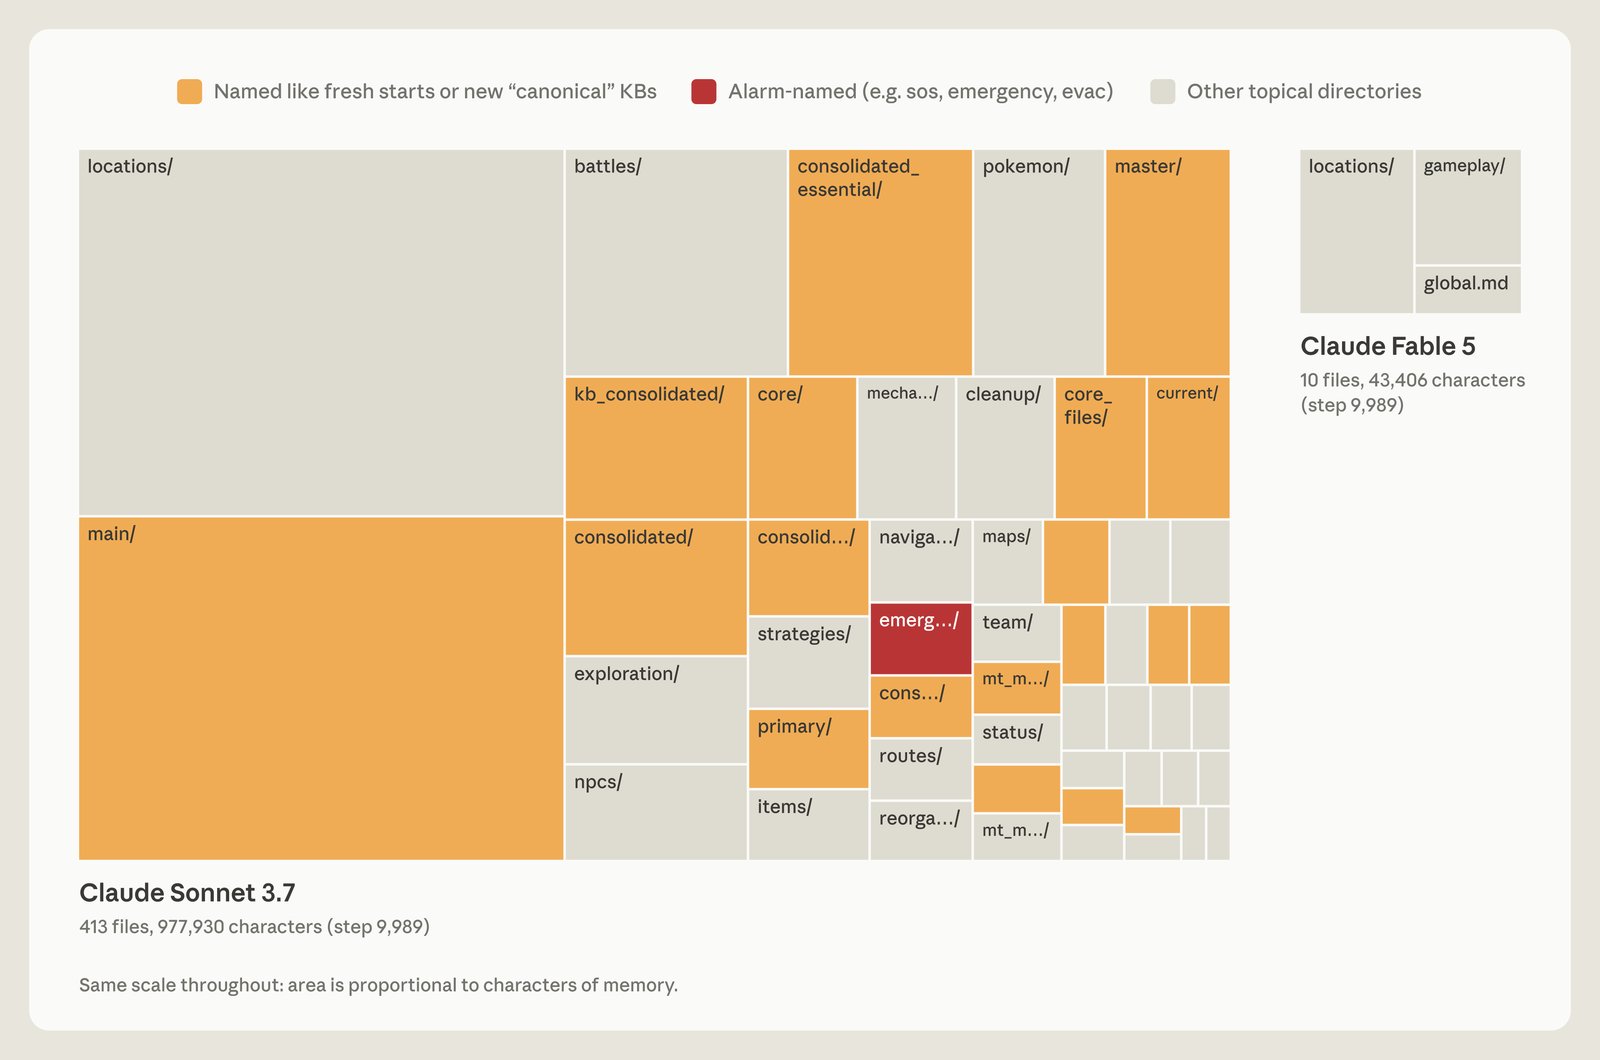
Sonnet 3.7 的策略是万物皆记:每场战斗、每件道具、每个 NPC 各建一条记录,到第 9,989 步攒下 413 个文件,分布在 225 个文件夹里,记忆总量 977,930 字符。问题在于宝可梦的游戏状态每回合都在变,详细记录持续过期,整理记忆本身开始吃掉游戏时间。第 10,000 步附近,它连续 17 步在整理文件:建第 4 个「master」记忆文件夹,新建 6 个文件,删除 9 个文件,游戏内零动作。这一局拿到 1 枚徽章。
Fable 5 只写了 9 个文件、2 个文件夹,外加顶层一个 global.md,共 43,406 字符,不到前者的二十二分之一,拿到 4 枚徽章。它的 global.md 是一块仪表盘:当前目标、道馆攻略预案、使用记忆自身的规则。目录按 locations/(路线导航方案)和 gameplay/(经过验证的策略)组织。一条典型记录来自连续 7 个精灵球都没抓到鲤鱼王之后:「如果 3+ 个球连续失败,改变按键时序,在菜单步骤间插入额外的等待按键。这么改之后立刻抓到了。」
分水岭在冗余判断上。玩家金钱数、当前地图位置这类信息,屏幕上每回合都读得到,存下来只会慢慢过期;策略、计划、验证过的规则是推导出来的东西,不写下来就会消失。413 个文件的版本把两类都记了,9 个文件的版本只记会消失的那部分。
引导的悖论
给模型的记忆指令,Anthropic 试了两档。第一档只说清用途:有个记忆文件夹可用。这对 Opus 4.7 和 Opus 5 就够了,记忆带来明显提升。第二档是规定方法,例如「只记录失败」。结果 Opus 5 和 Opus 4.7 丢掉了记忆带来的大部分增益。对强模型,替它预设哪些信息值得记,反而限制了它的 salience 判断。
弱模型相反,受益于明确引导。Sonnet 4.6 经常不读自己的记忆文件,也不验证自己答错的理论;提示它「答题前先读记忆,然后显式验证理论」之后,它的分数接近翻倍。自发性同样随代际增长:Sonnet 5 十次里有九次会在答题前自发读记忆,Sonnet 4.6 不到一半。
月见山死循环与做梦纠错
会话内随手记的笔记,错了怎么办?月见山案例给出了完整过程。
月见山是个洞穴,入口在地图西侧,出口在东侧。入口附近的悬崖是单向的,跳下去会回到来时的路线,爬不回来。Claude 把宝可中心的位置记错了,笔记写成了东侧。它从宝可中心走出来时宣布「月见山已经在身后了」,并把笔记更新为「月见山 DONE」。几步之后它翻下悬崖,落回原路线;导航工具不显示落差,它得出结论「我冲过头到了很西边」,坚持认为自己一直在正确的一侧。这一轮它三次掉下悬崖。第三次之后它写下「我打算停下来,而不是继续循环」,整局游戏最终没能抵达华蓝市。
纠错发生在做梦环节:对包含错误位置的记忆文件夹跑一次 dreaming,Claude 把笔记与原始会话记录(transcript)逐条比对,发现位置记反了,重写。transcript 在这里的角色是 ground truth:记忆可以写错,但当时发生了什么被完整留存在日志里。修正后的记忆让 Claude 直接折返进洞,最终抵达华蓝市。
350,000 个文件上的知识 wiki
做梦的第二种产出是知识表示。wiki 是其中一种:由 Claude 维护的页面集合,每页汇总一个主题,页面之间互链,构成一张可以在里面找路的地图。
评测语料来自 Anthropic 今年 5 月收购的 Stainless 的内部文档:约 350,000 个文件、4.2 亿 token。25 道测试题、一个检索工具,Opus 5 跑了 128 个 dreaming 会话(每个会话 1M token 预算)增量构建 wiki,各会话通过共享日志协调进度。
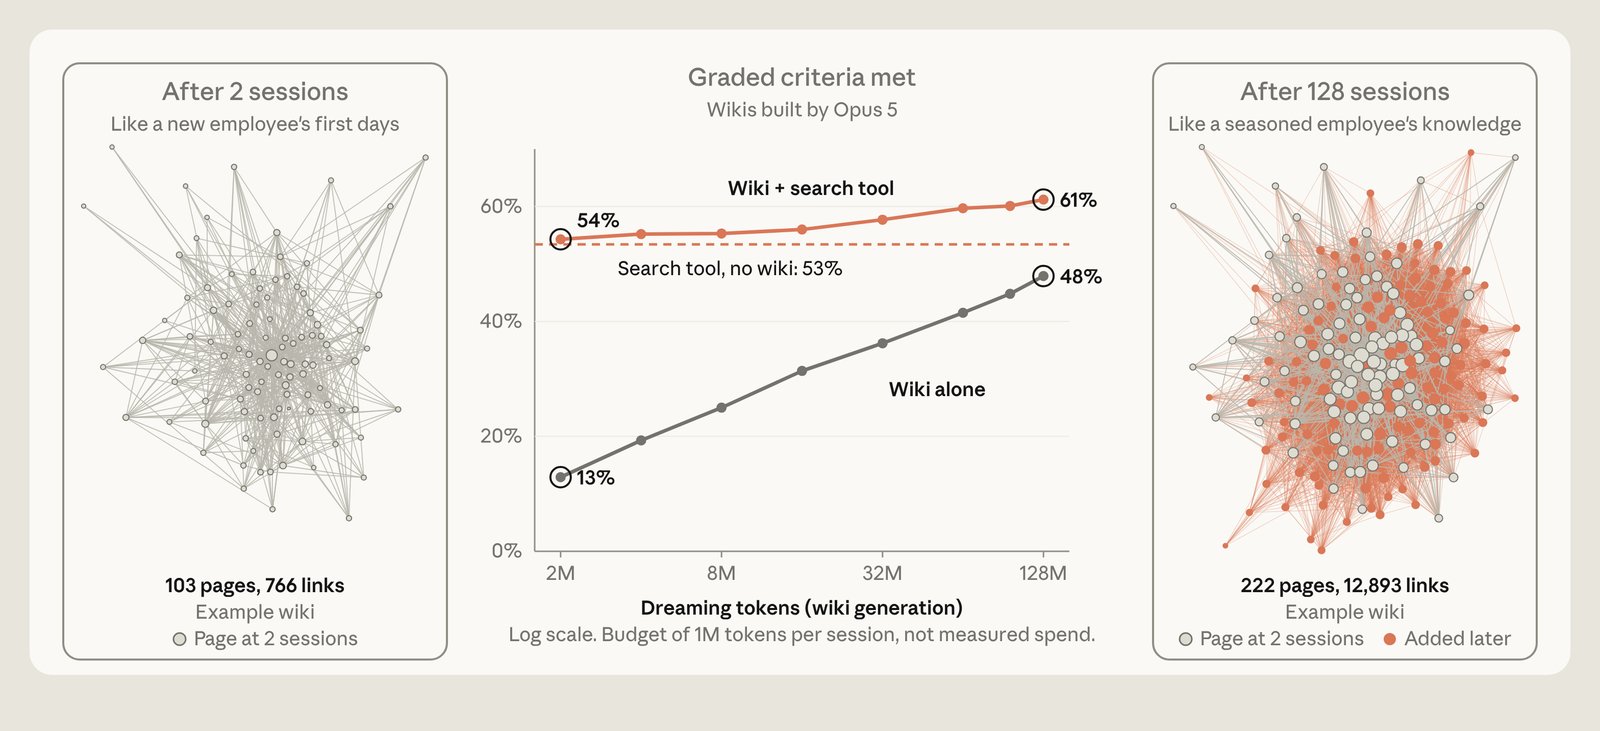
只靠 wiki 答题,得分从 2 个会话时的 13% 涨到 128 个会话时的 48%。wiki 配合检索工具,得分从 54% 涨到 61%,高于只用检索工具的 53%,同时每道题省下约 20,000 token。wiki 本身也在生长:2 个会话时 103 页、766 条链接;128 个会话时 222 页、12,893 条链接。原文图注把这组对照比作「新员工头几天的笔记」和「老员工的知识」。
wiki 的收益取决于题型。24 道并购文档问答题里,超过一半需要跨多份文档综合信息,wiki 组得分 87%,纯检索组 73%。而在单份文档内文本检索就能命中的法律简报任务上,wiki 没有明显增益。失败模式也记录在案:有一个任务的 wiki 最后长得比原始文档还大。原文引了博尔赫斯《论科学的严谨性》里那张与帝国一样大的地图,「抽象」这一层做没了。
注入层要小
做梦还能把笔记提升到记忆层级顶层,由 harness 在每个新会话开始时预载进上下文,Claude 不用搜,甚至不用知道有东西可搜。代价直接:注入占 token,一条错误笔记会跟着进每个会话;加载也不等于执行,Claude Code 的文档警告过指令文件越长遵循度越低。所以顶层必须小,dreaming 的一部分工作就是持续把细节下压、只留链接。Claude Code 的 auto memory 就是这个设计:它不加载整个 MEMORY.md,只加载文件前 200 行或 25 KB 当索引,告诉 Claude 它知道什么、去哪里找。
57 个合同事实的并发事故
一个模拟公司收购的 LAB 任务暴露了并发写问题。多个 agent 同时往一张共享的合同条款表里写,互相覆盖,57 个评分事实只存活 41 个(72%)。修复走了指令反思循环:Claude 复盘失败原因,改写建 wiki 的指令,改成每个合同单独一页、单 agent 负责、条款逐字引用不做摘要,重建后 57 个事实全部存活。第二轮 dreaming 还能补会话间隙:一次整理中它发现 wiki 里 9 条链接指向不存在的页面,把它们改指到既有页面,另加 3 页,含一个索引。
三个没关上的问题
原文结尾列了三个开放问题。记忆该在会话内顺手建,还是全部推给后台做梦:前者即时可用但分心,后者不占注意力但产出无法即时访问。记忆怎么保鲜:错误规则和环境漂移都存在,全量校验的算力成本又高,可能要按「哪些记忆常被访问」来定校验节奏。transcript 检索与知识表示的组合边界在哪,也还没有结论。这些问题都处于开放状态,配套的 cookbook(dreaming 与知识 wiki 的上手代码)已经随文放出。
来源:Anthropic, The Components of Agent Memory(Lance Martin 著);讨论见 Hacker News