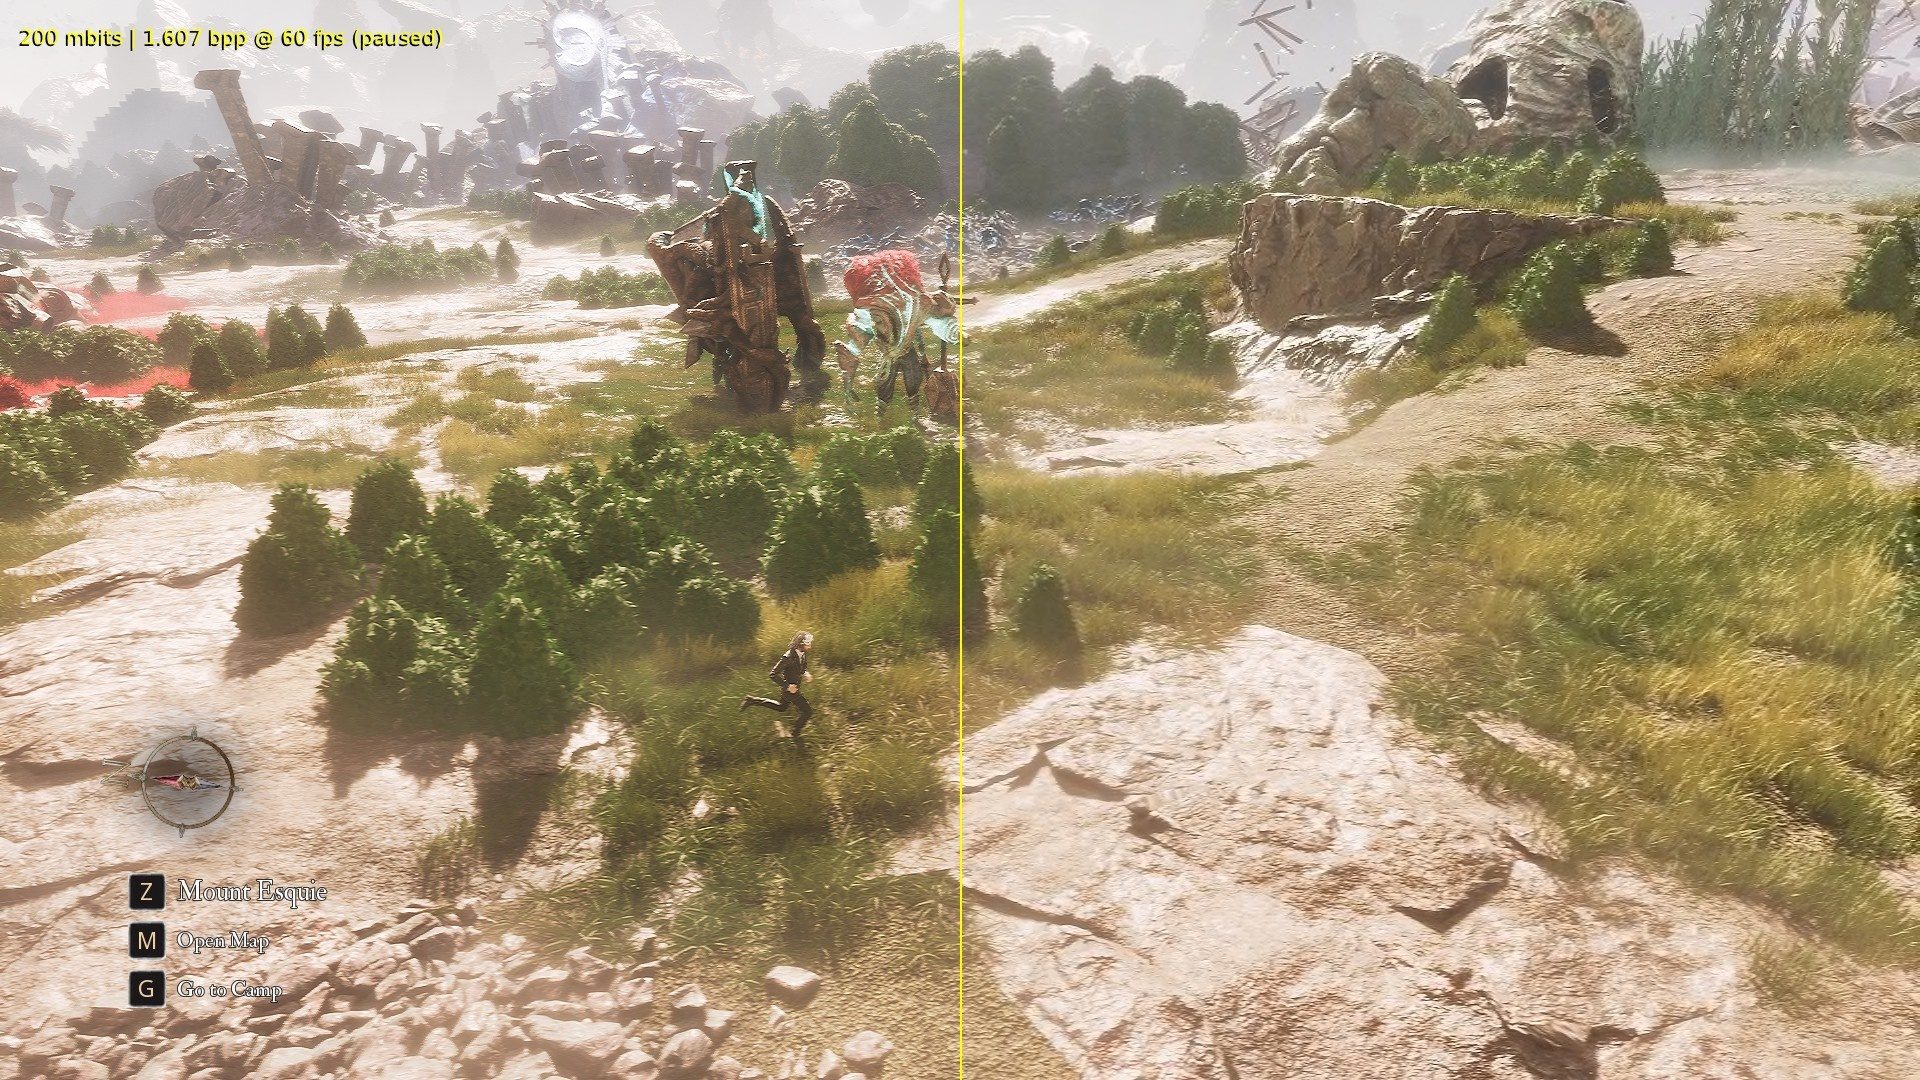
2026 年 9 月 21 日,Valve 在 Steam 客户端测试版中加入了一个实验性的视频编解码器,代号 Pyrowave。它出现在 Steam Remote Play(远程串流)的高级客户端设置里,覆盖 Windows、macOS,以及需要手动启用实验版 SteamRT3 客户端的 Linux。9 月 22 日的测试版更新日志把它列为 Remote Play 分类的唯一新特性:Added an experimental video codec, Pyrowave, which allows high bandwidth, low latency video streaming。
这不是一次普通的依赖升级。Pyrowave 不是 H.264、HEVC 或 AV1 的调优版本,而是一款从码流格式到 GPU 实现都从头设计的编解码器,作者是 Hans-Kristian Arntzen,VKD3D-Proton(把 DirectX 12 转译到 Vulkan 的兼容层,Steam Deck 上大量 Windows 游戏能跑起来靠的就是它)的维护者。Valve 官方的介绍只有几句话,但作者在 2025 年 6 月发表的技术博客加上 MIT 许可证开源的参考实现,把这个项目的技术选择完整地摊开了。对一个每天处理数千万人游戏画面的平台来说,把串流编解码这个关键环节交给社区开发者的自研方案,在商业公司的产品里相当少见。
串流链路里,编码器欠的每一毫秒都要还
游戏串流的延迟是一条链:手柄输入从设备 A 传到主机 B,B 的 GPU 渲染一帧,编码器把这帧压成码流,网络把它送到 A,A 解码并显示到屏幕上。整个链条的理想预算大约 20 毫秒,编码和解码各自只能分到很小的份额。
现代视频编码器的压缩率建立在一个前提上:允许它花时间。B 帧要等后面的帧编完才能确定参考关系,灵活的码率控制需要缓冲区吸收波动,深度搜索的运动估计要拿时间换压缩率。串流场景把这些特权全部收走:码率被硬性封顶(网线就那么宽,没有缓冲区兜底),且不能引入任何额外的帧延迟。被掐掉这些自由度之后,H.264/HEVC/AV1 实际运行在它们设计空间里很尴尬的角落,压缩效率大打折扣。
Pyrowave 的思路是反过来做减法:既然局域网里带宽近乎免费(千兆以太网是二十多年前的技术),那就把带宽花出去,买回延迟和确定性。Valve 官方给出的数字是它的码率是其他串流编解码器的 5 到 10 倍,手动设置范围 100 到 500 Mbit/s,官方建议至少千兆有线直连路由器。作者的博客里给出了量化描述:1080p60 下大约 1.5 bpp(bits per pixel)的码率就能达到肉眼难辨失真的质量,而传统编码器在串流模式下通常工作在 0.1 到 0.2 bpp 附近。
纯帧内编码:把运动估计整个扔掉
第一个激进的减法是彻底不做帧间预测。主流编码器绝大部分压缩收益来自运动补偿,参考前一帧只编码变化的部分,代价是任何丢包或解码错误会沿着参考链向后传播,直到下一个关键帧才能恢复。
Pyrowave 的每一帧都独立编码(intra-only),等效于一个每秒编码 60 次的静态图像编解码器。这带来三个直接收益:
- 丢包即恢复:码流的基本单元是独立的 32×32 系数块,一个网络包丢了,解码端只需要把对应的系数块当作全零处理,画面上出现一小块模糊,下一帧立即恢复,错误永远不会传播。
- 质量恒定:运动估计的质量好坏会让传统编码器在复杂场景( foliage、烟雾、TAA 噪声)下码率波动剧烈;纯帧内编码的质量曲线平稳得多。
- 流水线简单:不需要参考帧管理,不需要 DPB(解码画面缓冲)状态,编码和解码都是无状态的纯函数。
代价同样明确:码率从串流常用的十几 Mbit/s 跳到 200 Mbit/s 以上,公网串流基本无缘,这是给局域网场景的特化解。作者在博客里给了一个参照:1080p60 的 YUV 4:2:0 原始码率约 1.5 Gbit/s,Pyrowave 把它压到大约十分之一,而传统编码器能压到百分之一以下,但那要以延迟为代价。
用小波变换替代 DCT,外加砍掉熵编码
第二个减法更技术化:熵编码(H.264 的 CAVLC、HEVC 的 CABAC 这类变长编码)被整个扔掉。熵编码是压缩率的大头,但它的串行依赖是 GPU 并行化的噩梦,一个符号的码长取决于之前所有符号的状态。
扔掉熵编码之后,Pyrowave 选择了离散小波变换(DWT)而不是主流的 DCT。具体用的是 CDF 9/7 滤波器,与 JPEG 2000 相同。对图形程序员来说小波变换有个亲切的等价描述:它就是带通滤波的 mip-map,逐级下采样图像,同时记录高低分辨率之间的细节差值。Pyrowave 用 5 级分解,把图像的能量按频带拆开,高频带做更激进的量化(利用人眼对高频不敏感的心理视觉特性),比特集中分配给画面的关键区域。
小波的典型失败模式是高频全被量化到零,画面发糊并出现振铃。作者对此的评论是:如今的游戏画面本来就被 TAA(时间性抗锯齿)糊过一遍,这个失真未必那么显眼。码流结构也为此做了适配:系数按位平面(bit-plane)直接裸写进码流,不做任何变长编码。每个 32×32 块是独立可解码单元,内部再划分成 8×8 子块和 4×2 的最小单元,这个划分是照着 GPU 的线程层级设计的:
- 1 个线程处理 4×2 共 8 个系数(8 字节,对齐字节访问,避免 GPU 最讨厌的位操作)
- 1 个 subgroup(线程束)处理 8×8 块
- 1 个 workgroup(128 线程)处理 32×32 块
整条编码管线全部用 Vulkan compute shader 实现,不依赖任何厂商的硬件编码器 API。
码率控制:因为简单,所以精确
没有熵编码还带来一个不太直观的收益:码率变得可精确控制。传统编码器在硬性 CBR 约束下表现普遍糟糕,因为熵编码输出的比特数在压缩完成前无法准确预知,只能在超支后补救。Valve 官方说明里那句「每帧大小恒定」背后是这么实现的:对每个 32×32 块,编码器预先测出「丢弃第 1、2、3…层位平面」各自的失真代价和比特节省,然后按「每比特节省的失真代价」全局排序,用前缀和凑出整帧的目标比特数,最后每个块按决策截断。结果保证落在预算内,通常只差 10 到 20 字节。这是一个单次遍历、耗时固定的全局率失真优化,在传统编码器里这个级别的码控精确度一般要靠反复迭代逼近。
性能数字:比硬件编码器快一个数量级
作者在 RX 9070 XT(RADV 开源驱动)上给出的实测数字:
- 1080p 4:2:0 编码 + 解码:约 0.13 毫秒,解码低于 100 微秒
- 4K 4:2:0 编码:0.25 毫秒
- 「普通」游戏画面:编码约 80 微秒
- Steam Deck 上解码功耗低到难以测出
作为对照,GPU 厂商的硬件编码器(NVENC 等)在同样被限制为纯帧内、硬 CBR、最快预设的条件下,单帧编码耗时通常在 2 毫秒上下。Pyrowave 比专用硬件快一个数量级,快的原因在于整条管线都能摊到数千个 GPU 线程上、没有任何串行环节。博客里还有一个有趣的观察:4K RGBA8 原始帧走 PCI-e 总线的拷贝,比在 GPU 上把它压缩后再传压缩后载荷还要慢,这意味着这套技术在「同一个 GPU 内不同引擎之间搬运像素」的场景里也有潜力。
画质对比方面,作者把 NVENC 的 H.264/H.265/AV1 拉到同样的严苛约束下(纯帧内、硬 CBR、最快预设)做了 VMAF、XPSNR 等客观指标对比。在他的测试条件下(约 1.5 到 2 倍于 NVENC HEVC 的码率),Pyrowave 达到相同质量水平;在部分游戏场景(如《光与影:33 号远征队》的植被与 TAA 噪声)VMAF 曲线明显占优,作者自己也承认 VMAF 对这个编码器的打分偏高,更保守的指标(XPSNR、PSNR)显示差距收窄,且 FP16 中间精度限制了 PSNR 的上限。这是带约束条件下的对比,不是「同码率吊打主流编码器」。

质量与色深:YUV 4:4:4 和 HDR
Valve 的说明里专门提到 Pyrowave 支持 YUV 4:4:4(不缩减色度采样)和 HDR。默认的 4:2:0 会把彩色细节的分辨率减半,红蓝 UI 文字和细线在串流里发糊是老问题;4:4:4 模式为串流桌面、阅读 4K 文本这类场景打开,代价是更高带宽和处理时间。HDR 在主机和客户端都支持时自动启用。编码器支持 4:2:0 和 4:4:4 两种 YCbCr 色彩空间,这是官方实现直接暴露出来的两个选项。
怎么开,谁适合用
实际启用路径:加入 Steam 客户端测试版(Steam Beta Update),重启后在设置 → 远程串流 → 高级客户端选项里选择 Pyrowave。Linux 和 SteamOS 需要在系统设置里启用实验版 SteamRT3 客户端。移动端 Steam Link 应用的支持「即将到来」,但 Valve 开发者已在社区明确:VR 串流(Steam Link VR)不适用,Pyrowave 只服务平面画面串流。
它的适用画像相当窄:主机和客户端在同一个局域网内、两端都有性能可用的 GPU、且用有线千兆连接。典型场景是把客厅 PC 的游戏串到卧室电视、Steam Deck 或迷你主机上跑。WiFi 环境下 200+ Mbit/s 的稳定吞吐对路由器和频段都有要求,公网串流则完全不必考虑。如果你的网络够不着千兆有线,这个编解码器对你没有意义,Valve 也把它设为默认关闭。
第三方生态这边还有一个确定性:PyroWave 的参考实现以 MIT 许可证开源在 GitHub(Themaister/pyrowave),码流格式有独立文档。Sunshine/Moonlight 这类社区串流方案如果想跟进集成,法律上和工程参考上都没有障碍。Valve 把一个平台级的关键组件押注在一个社区开发者的开源设计上,并且第一天就带着可复用的开源实现,这个组合比编解码器本身的性能数字更值得记住。
一个信号:平台级软件的自研路线
值得放在更大的背景下看:Valve 在串流这条产品线上一直有自研习惯(Steam Link 硬件、Remote Play 传输协议、SteamOS),但编解码器这个环节历来交给行业标准(H.264/HEVC)加硬件编码器。Pyrowave 是第一次把这一环也收回来自己做,而且选择的路线上(纯 GPU 通用计算、放弃硬件编码器依赖)反而降低了对厂商专有块的依赖,Steam Deck 和各种 PC 硬件都能无差别跑。作者本人也提到这套 GPU 通用计算实现是冲着跨厂商可移植性去的(Vulkan compute 是跨平台 API)。
对做音视频开发的工程师来说,这个项目是一份难得的完整教材:从码流结构、小波滤波、位平面编码到 GPU 线程映射和率失真优化,每一层的设计动机都写在作者的博客和仓库文档里,且代码可以对照着读。对普通玩家,它是一个开关:网络够好就打开试试,性能曲线是否受益,Remote Play 设置里的性能图表(编码 + 网络 + 解码 + 显示的耗时分解)会给出直接答案。
参考来源:
- Valve 官方公告(Steam Remote Play 社区,2026-09-21)
- Hans-Kristian Arntzen:I designed my own ridiculously fast game streaming video codec(2025-06-16)
- Themaister/pyrowave 开源仓库(MIT License)
- GamingOnLinux:Steam Beta adds experimental new Pyrowave video codec
- Phoronix:Valve Introduces Pyrowave Video Codec In Beta