2026 年 10 月 15 日,Mistral 发布了旗下第一个时序基础模型家族 Timestral。四个型号的参数量分别为 5M、28M、123M 和 209M,最大的 209M 版本在 GIFT-Eval、TIME、fev-bench 三个主流公开基准的预训练零样本(zero-shot)组全部排名第一,超过此前最好的模型,而参数量只有对方的三分之二。权重已经放在 Hugging Face 上,推理代码以 Apache-2.0 协议开源在 GitHub 仓库 mistralai/timestral,模型权重采用 Modified MIT 协议。
时序基础模型是什么
企业的数据里最常见的一类就是时间序列:传感器遥测、可观测性指标、销售额、电力负荷、服务器延迟。围绕它的预测支撑着产能规划、能源调度、供应链和设备维护等决策。
传统做法分两代。第一代是经典统计模型,比如 ARIMA 和线性回归:对单条序列拟合,只从这条序列自己的历史里学规律。数据少的时候它们依然好用,但换一条序列就要重新拟合一次。第二代是深度学习模型,代表是 PatchTST:能从许多相关序列里学非线性模式,但通常仍要在每个数据集上从头训练,学到的东西不能迁移到新领域。
时序基础模型(Time Series Foundation Model,TSFM)把语言模型社区的"预训练+零样本"范式搬进了时序领域:在一个大规模、跨领域的语料上预训练一次,之后对没见过的新序列直接预测,不需要针对具体数据集训练。对一个要同时预测上万条传感器序列的工厂来说,这意味着不用再维护上万个模型。Nixtla 的 TimeGPT、Amazon 的 Chronos、Google 的 TimesFM、Datadog 的 Toto 都属于这一路线,Timestral 是这条路线目前公开榜单上的第一名。
架构:patch 化 transformer 与两种注意力
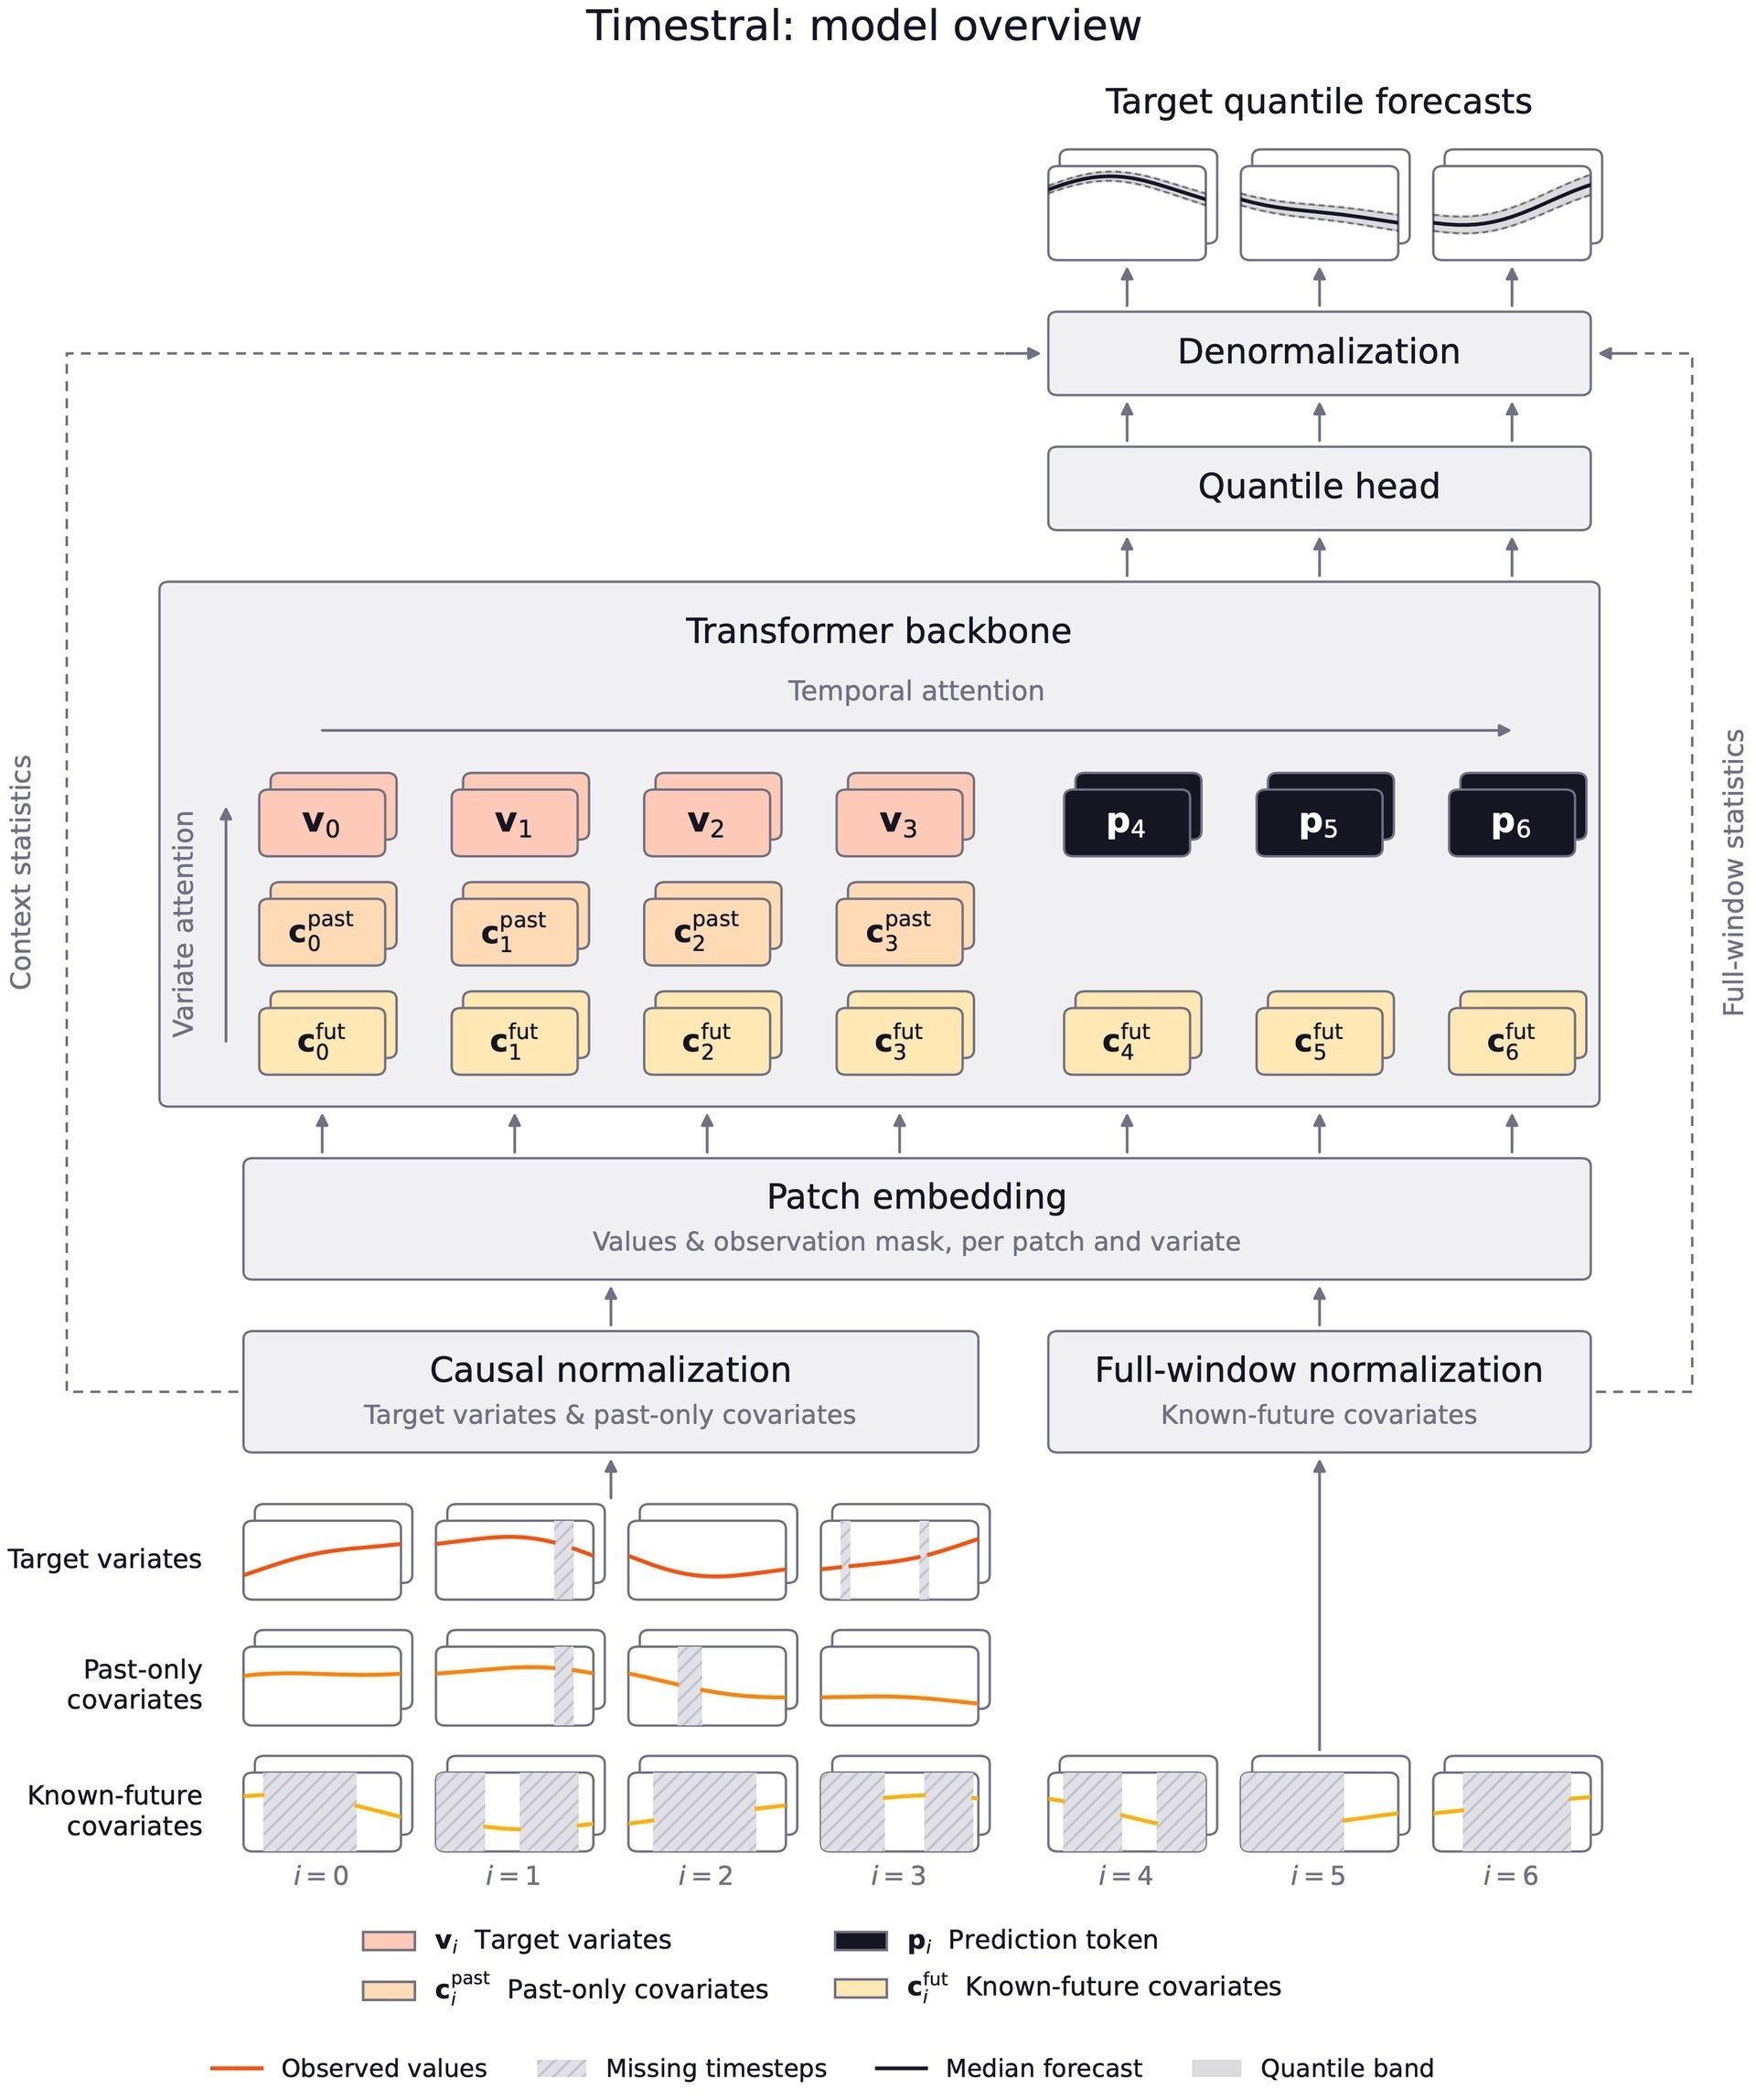
从 Hugging Face model card 看,Timestral-209M 是一个 patch 化的 transformer:24 层,嵌入维度 768。输入序列按每 32 个时间步切成一个 patch,每个 patch 的嵌入除了数值本身,还带着缺失值指示位(missing-value indicator),缺失值直接标 NaN 输入。
模型有两条注意力路径。时间注意力(temporal attention)沿序列方向看上下文;变量注意力(variate attention)在多条相关序列之间建立联系——比如水泵的振动、温度、压力三条序列不再各测各的,温度的异常变化可以作为振动预测的输入。协变量(covariates)也被显式建模,分三种角色:目标变量(要预测的序列)、仅过去可见的协变量(past-only,比如实测气温)、已知未来的协变量(known-future,比如节假日日历、排产计划、天气预报)。输入支持数值型或类别型,类别协变量做目标编码(target encoding)。
上下文窗口最长 32768 个时间步(1024 个 patch),单次前向最多预测 1024 步(32 个 patch);更长的视野按块递归生成,每一块的中位数预测拼回上下文继续预测。输出是概率预测:21 个分位数(0.01 到 0.99),不是单点值,下游可以直接拿分位数区间设告警阈值、算风险敞口。训练目标是对这 21 个分位数求 pinball loss,它是连续分级概率评分(CRPS)的离散近似。
关键机制:解耦视野预测(DHF)
官方博客列出的第一个技术贡献叫 Decoupled Horizon Forecasting(DHF),解决的是因果解码器训练里的一个老问题。
Toto 2.0 和 TimesFM-3 这类因果解码器用连续 patch 掩码(contiguous patch masking)训练:把序列末尾要预测的那段 mask 掉。这个做法有两个副作用。其一,被 mask 的值看起来像"缺失数据",模型没法区分"这是要预测的目标"和"这是传感器坏了没上报";其二,被 mask 掉的值同时也从后续位置的上下文里消失了,长视野按块滚动预测时,真实历史没有被完整利用。
DHF 把这两件事拆开:完整历史始终留在序列里,另设可学习的预测 token(prediction token)去读它前面的全部历史再产出预测。这样每个观测值既当过预测目标、又始终在场当上下文;真正的数据缺口保持"缺失"标记;训练视野长度和缺失数据增强两个超参数解耦,可以独立调整。
协变量感知注意力(covariate-aware attention)配合这个设计:已知未来的协变量在整个窗口内对目标变量可见,目标变量自身保持因果性,信息只从协变量流向目标。也就是说模型可以用节假日日历和天气预报改善预测,但不会把目标序列自己的未来泄漏进预测里。
训练:合成数据打底,两阶段拉长上下文
Timestral 的训练数据以合成为主。先用单变量过程生成器造出带趋势、季节性和多样噪声模式的序列,再用多变量合成器在这些过程之间注入非线性依赖,构成多变量序列。合成优先的好处是可控:数据分布、缺失模式、序列长度都能按需生成,也避免了真实数据里常见的隐私和授权问题。
训练分两阶段。第一阶段在纯合成数据上大规模预训练,上下文 8192;第二阶段在真实与合成混合数据上做后训练,上下文拉长到 4 倍,即 32768。对所有四个型号,架构和训练配方完全一致,只调规模。
企业侧的适配走 Mistral Forge:支持零样本开箱推理、领域协变量的架构扩展、在私有数据上微调(保持通用性能的同时特化),还能控制训练数据配比和回放预训练数据做回测隔离。整条管线可以部署在客户自己的机房,包括物理隔离(air-gapped)环境。
榜单成绩:三个基准的第一名
Hugging Face model card 给出了与主要竞品的完整对比(零样本组):
| 基准 | 指标 | Timestral-209M | t0-gamma | TimesFM-3 | Toto-2.0-2.5B | Chronos-2 |
|---|---|---|---|---|---|---|
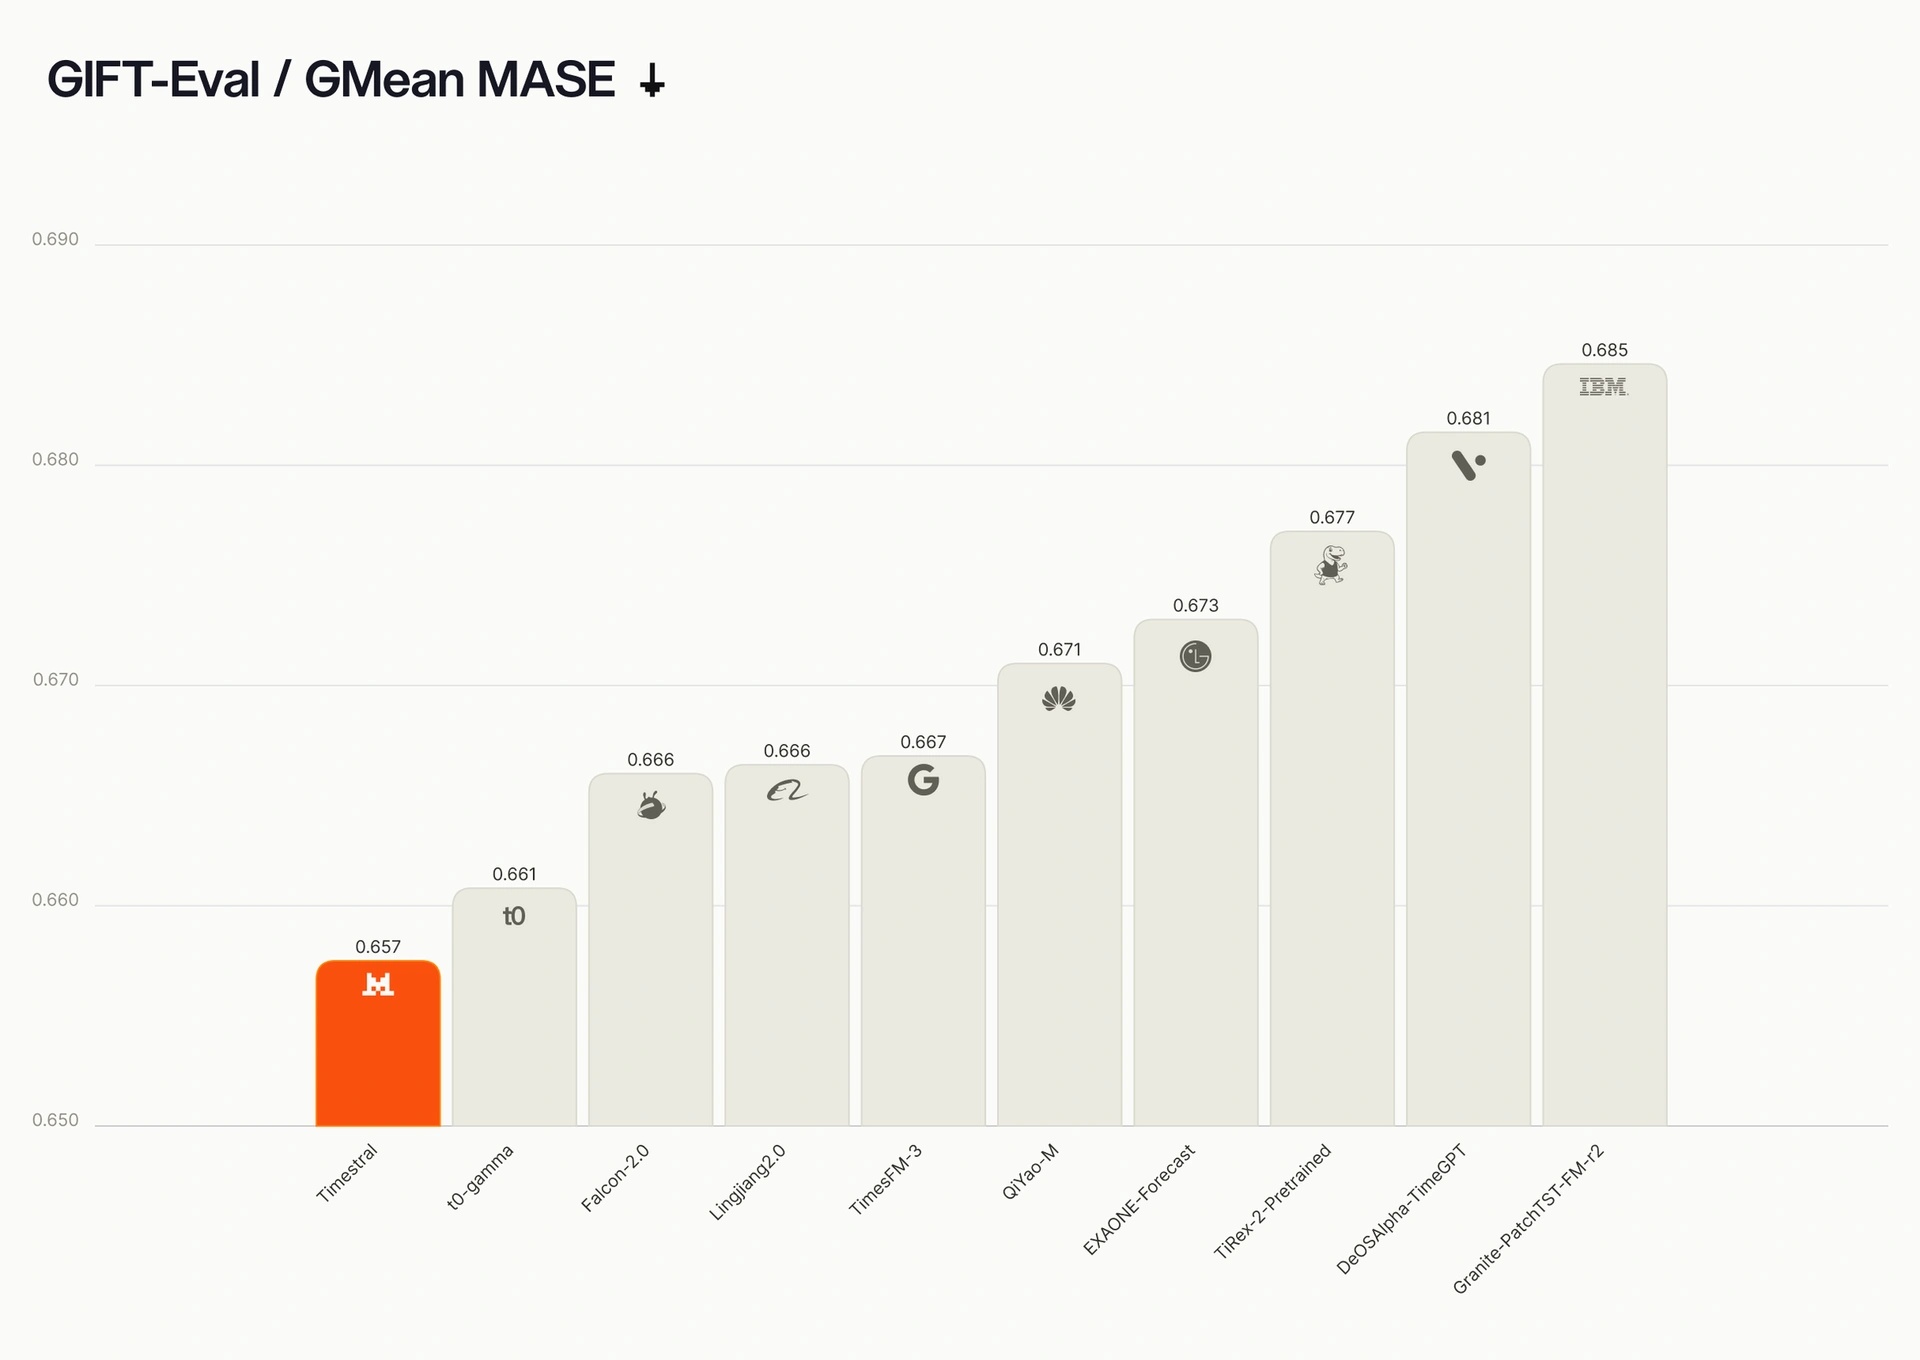
| GIFT-Eval | MASE ↓ | 0.658 | 0.661 | 0.667 | 0.696 | 0.698 |
| GIFT-Eval | CRPS ↓ | 0.446 | 0.452 | 0.456 | 0.476 | 0.485 |
| TIME | MASE ↓ | 0.626 | 0.637 | 0.640 | 0.642 | 0.662 |
| TIME | CRPS ↓ | 0.522 | 0.534 | 0.536 | 0.539 | 0.556 |
| fev-bench | SQL skill score ↑ | 50.39 | 49.42 | 48.99 | 44.42 | 47.28 |
| fev-bench | MASE skill score ↑ | 39.49 | 37.99 | 37.82 | 32.54 | 35.50 |
GIFT-Eval 有 83 个可比的预训练零样本条目,TIME 35 个,fev-bench 37 个。官方强调这些成绩来自单一 checkpoint,没有集成(ensembling)。排名第二的 t0-gamma 与 Timestral 的差距在各榜单上普遍只有千分位到小数点后两位:GIFT-Eval MASE 0.661 对 0.658。Hacker News 评论区也有人指出这一点——领先幅度小,但方向一致:更小的模型拿了更好的名次。
家族内部的规模-精度曲线同样值得看。以 GIFT-Eval MASE 为例:5M 是 0.705,28M 是 0.678,123M 是 0.659,209M 是 0.658。官方博客称 28M 版本在 GIFT-Eval 和 TIME 上击败了约 4 倍大的 Chronos-2;123M 版本与 209M 的分差在 0.2% 以内,而延迟只有后者的四分之三。
CPU 就能跑:延迟与选型
Timestral 推理不需要 GPU。官方给的基准是:8 线程标准服务器 CPU,用 3 周的 15 分钟粒度历史(2016 个点)预测未来 1 天(96 个点),5M 模型耗时 10 毫秒,209M 模型耗时 140 毫秒。28M 的速度是 209M 的 5 倍。
这个延迟水平意味着两条部署路径。一条是高频嵌入:每个指标每次刷新只花几毫秒做增量预测,可以放进现有监控管道里当常驻异常检测器。另一条是批量场景:上千条序列轮流过一遍模型,单核每秒也能处理几十条,小型工厂的传感器规模用一台普通服务器就能覆盖。对个人开发者和中小团队,5M 和 28M 是值得先试的档位——5M 权重只有几十 MB,笔记本电脑就能跑。
四档的选型逻辑可以概括为:5M 做高频和边缘场景,28M 用五分之一延迟拿到接近的精度,123M 是精度-延迟折中点,209M 冲榜单精度。所有档位共享同一套 API(TimestralForecaster.from_pretrained),换档位只改模型名。
用 209M 跑一次预测的最小代码:
import numpy as np
import torch
from timestral import TimestralForecaster

model = TimestralForecaster.from_pretrained(
    "mistralai/Timestral-209M",
    device="cuda" if torch.cuda.is_available() else "cpu"
)

# 1000 个历史观测点
context = np.random.default_rng(42).standard_normal(1000).cumsum()
forecast = model.forecast(context, prediction_length=96)

median = forecast.median
lower, upper = forecast.quantile(0.1), forecast.quantile(0.9)
安装依赖 Python >= 3.10、torch >= 2.4,pip install git+https://github.com/mistralai/timestral.git 即可。从 Hugging Face 拉取权重后本地推理,不需要调用任何云 API。
许可证:代码 Apache-2.0,权重 Modified MIT
这个家族的授权分成两层。GitHub 上的推理代码是 Apache-2.0,可以随意使用和修改。模型权重的 Modified MIT 条款里有一条关键限制:如果贵公司(或雇主)上一个自然月的全球合并营收超过 2000 万美元,就不能行使许可赋予的使用权,需要联系 [email protected] 谈商业授权,或者改用 Mistral 托管服务。年营收低于这条线的公司、研究机构和个人不受影响。
这延续了几家头部模型厂商近两年的做法:用收入门槛而不是"开源/闭源"的二分法划商业边界。对初创公司和大企业的影响完全不对称——前者免费用,后者要么付费要么自建替代。Hacker News 上 Grafana 创始人 rubenfiszel 的评价是"性能逼近榜首很惊艳,但许可限制不友好"。评估是否引入这个模型时,许可证条款应该和精度数据一起看。
争议与方法论问题
榜单领先不等于没有争议。Hacker News 评论区(97 条评论)集中了三类质疑,对理解这类模型的边界有价值。
第一类是指标差距的呈现。有评论者注意到榜首与第二名只差 0.003 至 0.004,但视觉上被拉成很明显的差距。这是所有排行榜通用的呈现问题:柱状图 y 轴的起点和刻度选择会影响观感。数据本身(model card 的表格)没有问题,读榜时应该看原始数字而不是柱子高度。
第二类是"所有时序一个模型"的方法论质疑。有机器学习从业者指出,音频、视觉、金融、传感器的序列模式差异很大,把所有"时间序列"塞进同一个大桶训练,直觉上不如领域专用模型。这条质疑没有简单的答案:Timestral 用合成数据打底的配方部分回应了它(合成器可以按领域注入不同动态),但"领域微调后是否显著优于领域专用小模型"要等技术报告给出消融实验。
第三类是实用性的正反两方。反对意见认为时序数据与文本本质不同,基础模型路线的实际价值有限,并指出官方博客的工业案例是虚构场景而非客户背书。辩护意见则从规模经济出发:手里有 1 万条序列要预测时,逐条拟合不现实,统一一个模型再加协变量是工程上更可行的路径,TSFM 的价值在批量场景而不在单条序列精度。
这些质疑共同指向一个待验证命题:TSFM 在真实生产数据上的表现是否稳定复现榜单优势。Mistral 承诺的技术报告(含完整结果)尚未发布,正式报告里的消融和失败案例值得跟进。
小结
Timestral 把时序基础模型的参数门槛从十亿级拉回了两亿级:209M 参数、CPU 上 140 毫秒一次预测、三个公开基准零样本组第一。技术上,解耦视野预测把"要预测的值"和"上下文历史"分开处理,协变量感知注意力让节假日和排产计划这类已知未来信息安全地参与预测,合成数据优先的配方控制了训练数据的分布。
对工程团队,直接的可用性在两件事上:不用 GPU 的推理成本,和 5M 到 209M 四档按延迟换精度的选型空间。需要留意的边界也有两个:权重许可的 2000 万美元营收门槛,以及榜单领先幅度很小、真实生产数据的复现效果还待技术报告验证。
来源: