价格预测模型回答的问题通常是:给定一段订单簿事件流,某个标的的价格接下来会怎么走。Jane Street 2026 年夏季实习生项目里的一个研究课题换了个问法:能不能让模型直接生成订单簿事件本身,包括挂单、撤单、成交,以及它们到达交易所的时间。这项实验由研究实习生 Kavish 完成,训练数据是四年的美股逐笔数据,每行包含时间戳、价格、事件类型(成交、挂单、撤单等)。结论分两层:模型还没有好到能当真实的生成器用;但这条路的关键难点在哪、用什么工具撬动,已经被系统地试了出来。
市场数据是一种什么数据
生成模型对数据的形态有硬性要求。视频是连续的:每帧像素取连续值,帧与帧之间也连续演化。文本是离散的:词表有限,下一个词从词表里挑。市场数据两头都占。订单簿通过离散动作演化(挂单、撤单、成交),动作空间是离散的;但价格的高基数让它在实践里近似连续,还有一个容易被忽略的纯连续量:时间,即新订单何时到达交易所。
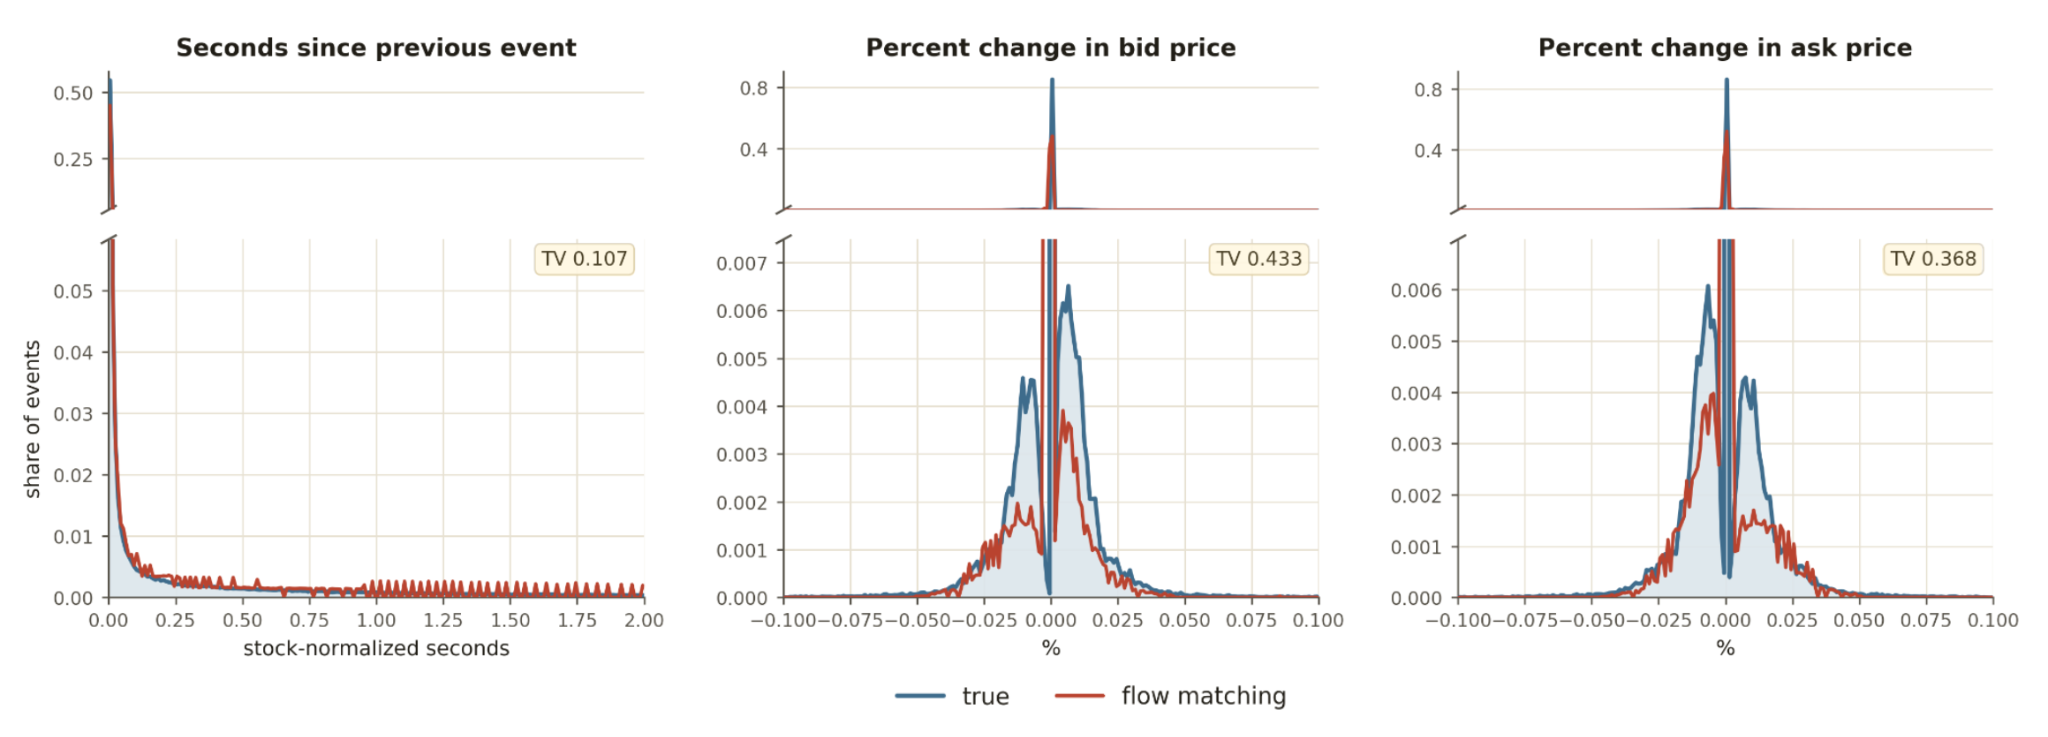
时间这个维度比看上去更难。它的分布带尖峰:两个事件同时到达(时间差为零)是一团点质量;人的最短反应时间附近是一团;整秒附近还有一团,订单常在整点成批到达。价格同样聚集:新价格贴着中间价、当前买价或当前卖价出现,「pennying」(把对手价改善一个最小变动价位)远比改善两个价位常见。平滑分布的假设在这里不成立。
架构:encoder 加 diffusion head
Kavish 的参照是 Li 等人的论文 Autoregressive Image Generation without Vector Quantization(规避向量量化的自回归图像生成路线)。模型分两部分:一个带因果掩码的 transformer encoder,为序列每个位置产出隐向量;一个事件类型头,输出二分类概率,判断下一个事件是成交还是最优买卖价(BBO)更新。连续目标(价格、时间差等)由 diffusion head 生成,以对应位置的隐向量和事件类型为条件,用标准的 AdaLN 方式注入。训练时条件用的是真实事件类型;推理时先用类型头采样出事件类型,再用 diffusion head 生成连续特征,然后自回归地把新事件接回序列末尾。
DDPM 爆炸实录
第一版 diffusion head 按 Improved DDPM 的建议用了 1000 步 cosine 噪声调度,推理用 DDIM 采样。结果不稳定:去噪轨迹发散,7 个连续目标上全部出现 88% 到 95% 的值偏离分布均值 8 个标准差以上。
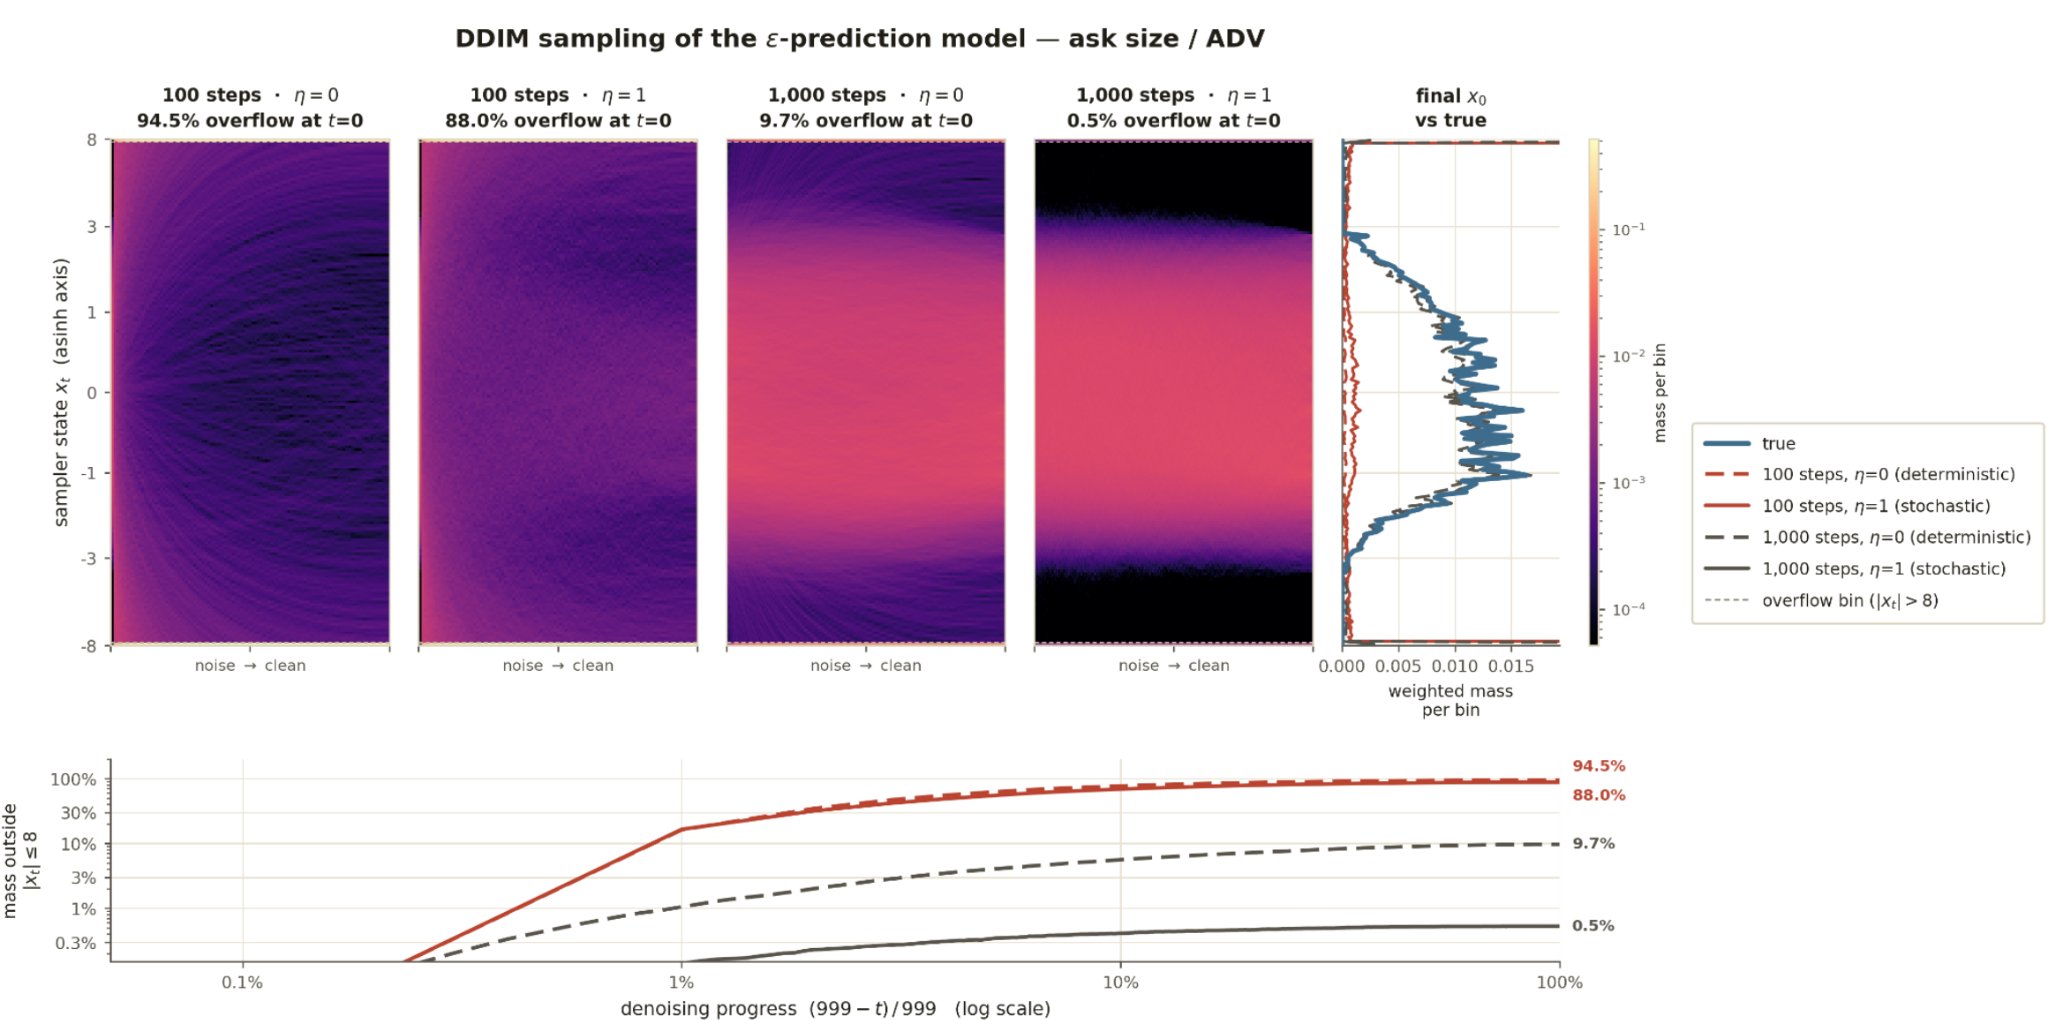
上图的四个面板对应四种配置:100 步确定性采样时 94.5% 的样本溢出(|x̂₀|>8),100 步加随机扰动 η=1 时 88.0%,步数加到 1000 步后降到 9.7%,1000 步加随机性进一步降到 0.5%。机制在图里看得见:采样步数越多,每步的更新增量越小,x̂₀ 越不容易冲出边界;随机性项则把去噪过程往标准高斯方向正则化。两条路都能救 DDPM,但都要调。
Kavish 换了路:rectified flows(流匹配)开箱即用。流匹配与 DDPM 在目标上是同一事物的两种参数化,区别在训练网络预测噪声到数据连线上的速度(数据减噪声),采样轨迹近似直线,很少的积分步数就能算准。换成流匹配后,ask size 目标在 Heun ODE 50 步下的每一次 solver 调用溢出率都是 0.00%。
把尖峰分给分类头
流匹配解决了轨迹发散,下一个问题是不连续性。真实数据的时间差在零点有一根尖刺,价格变动在零附近也有一根,扩散头输出的连续分布在尖峰处始终对不齐。
第一批实验做了手工拆分:把二分类的事件类型头扩成 20 类。BBO 更新被拆成常见模式(只变挂单量、卖价上移、买价下移等),时间差为零单独成为一类,diffusion head 只负责更平滑的目标,比如「非零时间差有多大」「买价变动幅度是多少」(方向已经是类别了)。成交只占全部事件的 8%,原本的二分类头系统性地过预测成交,拆细后这一偏差也得到缓解。这套方法让事件类型和连续目标的边际分布都明显更贴近真实,代价是手工工程量:真实市场数据的字段远不止这几个,「事件发生在哪个交易所」这类高基数字段会把类别数炸掉。
原子平滑
于是有了第二种处理,Kavish 称之为 atom smoothing(原子平滑)。做法分三步:挑一种让尖峰尽可能不尖的变量表示;把真实分布平滑掉;再把概率质量以连续的方式重新堆回尖峰位置,避开硬边界。同一个分布在不同的表示下尖刺程度不同,表示选得对,平滑才做得动。
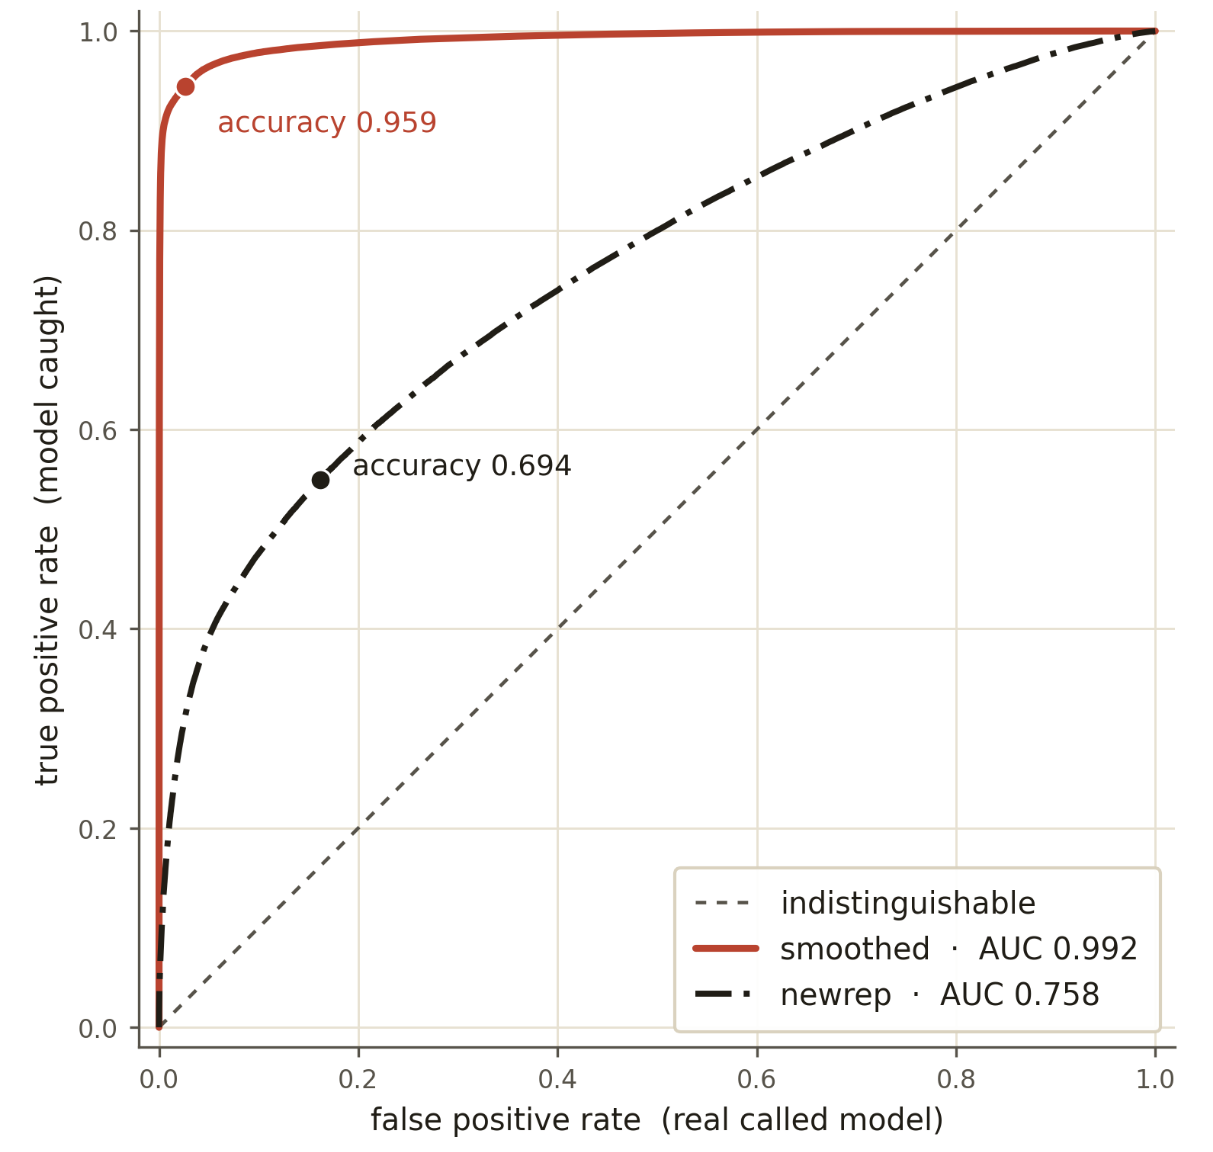
评估用了两把尺子。边际分布层面,单步设置下给模型 10240 个真实事件做上下文,让它画一个下一事件,与真实边际分布算 TV 散度(两个分布在每个取值点上的概率差绝对值之和的一半)。联合与时间一致性层面,训练一个判别器:读一段真实上下文加一个候选下一事件,判断候选来自模型还是来自真实数据。为原子平滑优化过特征表示的生成器在判别器面前明显更难被抓:判别精度从 0.694 提到 0.959,AUC 从 0.758 提到 0.992。
展开与边界
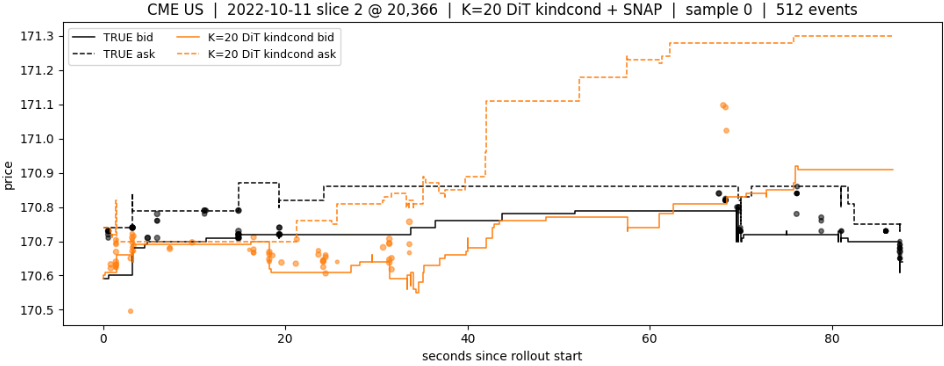
自回归展开是最终目标。下图是一次从真实上下文出发的 512 个生成事件与真实路径的对比:开始阶段贴合,越往后偏得越开,生成路径上的买卖价差在 60 秒附近明显拉宽。这引出项目留下的开放问题:退化有多快,怎么量测,怎么压。
文末的结论很克制:这个模型还没有准确到能当真实的生成器用。项目沉淀下来的是两个旋钮的定位:多少离散性应该直接烘进模型(哪些目标用类别预测,哪些交给扩散),以及特征该怎么表示、分布该怎么平滑,才给扩散模型最好的工作条件。
这份实验记录的直接产出是一个还不能用的生成器,留下的是一组可操作的结论:订单簿事件同时活在两个空间里,连续空间里的「卖量增加 10%」,和离散动作空间里的「把买价 penny 掉」,要在合成数据里重建市场就得把两种存在方式都建模进去。对做回测、市场仿真和撮合压力测试的团队来说,里面记录的失败配置(DDPM 高噪声下发散的完整参数)和有效配置(流匹配加 20 类事件头加原子平滑)同样有参考价值。
来源:Jane Street Blog, Can you use autoregressive diffusion to generate market data?