反向传播自 1986 年 Rumelhart、Hinton 和 Williams 在 Nature 上发表以来,一直是训练神经网络的唯一主流算法。Transformer、Adam 优化器、GPU 上的自动微分,整个深度学习工具链都建立在"梯度沿计算图反向流动"这个前提上。一家名为 qlabs 的小型研究团队在论文《Dust: Pretraining Transformers Without Backpropagation》中给出了一个反例:完全去掉反向传播,只用前向传播加随机扰动,把一个 GPT 风格的 Transformer 在 FineWeb 数据集上从零预训练,当扰动样本数(population)足够大时,测试损失追平了反向传播,在部分设定下甚至低于反向传播。这是零阶(zeroth-order)优化方法第一次在这个最硬的基准任务上接近一阶方法。
反向传播的垄断与其成本
神经网络的训练要解决的核心问题是信用分配:网络有数百万到数千亿个参数,最终输出一个标量损失,每个参数该为损失的变化负多少责任?反向传播用链式法则精确回答这个问题,但它有两个隐含前提:网络必须端到端可微,且梯度必须逐层反向流过整个计算图。这两个前提决定了什么样的架构能被训练——循环神经网络沿时间反向传播(BPTT)时梯度爆炸或消失,含外部程序交互、多步循环计算的网络难以训练,都源于此。
Sutton 在《The Bitter Lesson》中的论断是:随算力扩展的通用方法最终胜出,AlphaGo Zero 是例证——依赖人类棋谱的版本早期学得快,纯自我对弈的版本最终反超。qlabs 团队把同样的逻辑用到信用分配上:可微性和链式法则是低算力时代的好偏好,在高算力时代,它们可能限制了可训练架构的空间。
直接替代反向传播的既有路线是进化策略(Evolution Strategies, ES):给权重加随机扰动,每个扰动个体跑一次前向传播,用损失变化给扰动打分,按分数加权平均得到梯度估计。这类方法只需要前向传播,不要求可微,但公认无法扩展到大网络——前向传播只返回一个标量,扰动维度随网络规模增长,估计方差随之爆炸,所需的种群规模也爆炸。OpenAI 2017 年的 ES 论文(Salimans 等)和 2025 年的 EGGROLL(Sarkar 等,arXiv:2511.16652)都在权重空间里改进效率,EGGROLL 用低秩扰动让每个个体更便宜,但每个个体仍然要占用批次里的一个序列位置,种群规模被前向传播的预算限死。
Dust 的核心:虚拟种群
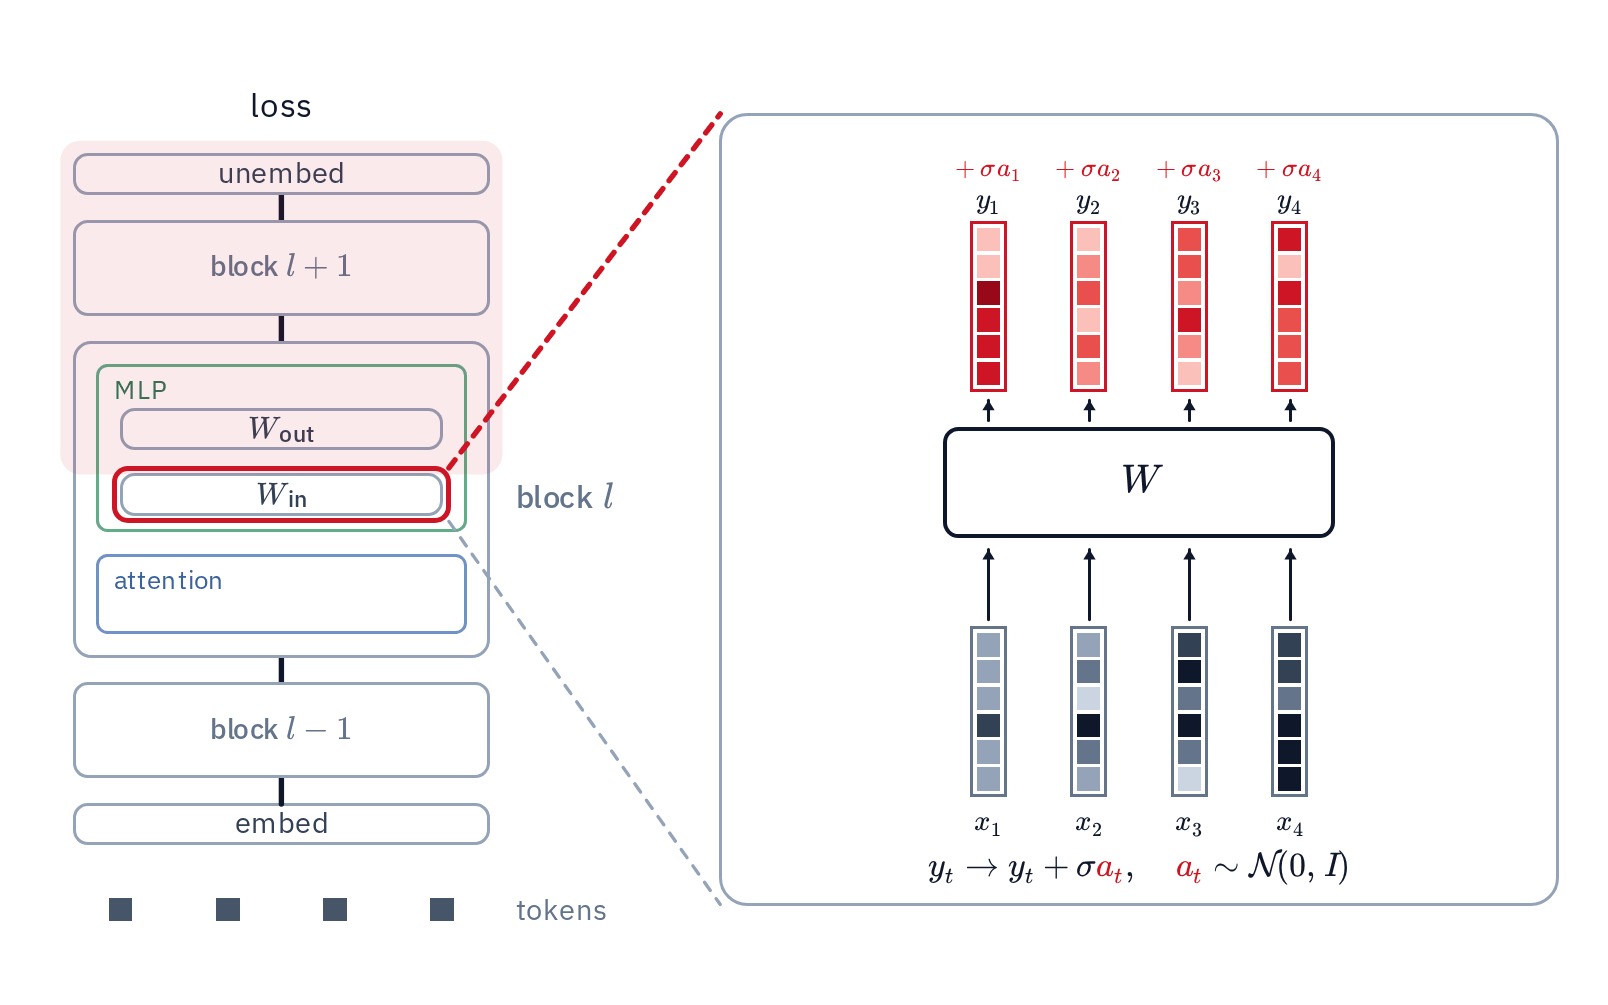
Dust 的做法是把扰动从权重空间搬到激活空间。具体地,对线性层的输出 y_t = W x_t,在每个 token 位置独立加高斯噪声:y_t → y_t + σa_t,其中 a_t 服从标准正态分布,σ 是噪声尺度。一次前向传播后,用该 token 损失的变化给这Token位置上的噪声打分:损失下降了,说明这次扰动朝好方向走了一步。
这个设计的巧妙之处在种群的组织方式。权重空间 ES 里,一个个体 = 一份扰动后的权重 + 一次前向传播,成本高昂。Dust 里,每个 token 位置都是一个"虚拟个体":一个序列有几千个 token,一次前向传播就同时评估了几千个成员,噪声加在激活上几乎不花钱,也不需要为每个成员复制一份权重。论文把这称为虚拟种群(virtual population)——种群沿 token 轴展开,与 EGGROLL 依赖的批次轴正交。在现代 Transformer 上,单次前向传播评估的种群规模比权重空间 ES 大至少三个数量级。
加权后的噪声平均起来就是该层输出误差的估计,它与该层输入的外积就是权重梯度。反向传播构造完全相同的外积,区别只在误差来源:反向传播用链式法则算出输出误差,Dust 用种群平均估计它。注意力内部的扰动(query、key、value、门控、值嵌入)单独处理:这些扰动对自身 token 的损失影响很小,但会被后续 token 通过注意力读取,所以改用注意力输出误差打分,并给未来 token 的分数加一个接近 1 的衰减系数 γ。语言建模头则直接在缓存的 logits 上扰动,每轮只需重算一小块词表的交叉熵,成本只有前向传播的一小部分,因此能跑大得多的种群。
这个方法属于节点扰动(node perturbation)谱系——Widrow 和 Lehr 1990 年、Werfel 和 Seung 2003 年就研究过用激活噪声估计梯度。Dust 的新意在两点:一是按 token 独立扰动,把种群规模沿 token 轴放大;二是为不同层类型设计了区分化的信用分配规则。
与反向传播的正面对比
实验设置:GPT 风格 Transformer,8 层、宽度 512,在 FineWeb 上用 4096-token BPE 词表训练,批次 16k token(8 个序列、每个 2048 token),单轮数据,SGD 加动量,每个配置三个随机种子。token 预算从 100k 扫到 20M,种群从 64 到 16k draws(一次 draw 是对选定层所有 token 的一次完整扰动加打分),反向传播在每个预算下用同一网格单独调参。
结果分三段:
- 100k 和 1M token:Dust 低于反向传播,但差距随种群缩小。1M token 处反向传播测试损失 5.180,Dust 在 1k draws 时 5.265,拉到 16k draws 时 5.065,反超 0.115。
- 10M token:损失阶梯在 16k draws 附近趋平,拟合极限略高于反向传播。
- 20M token:阶梯在 16k draws 仍在下降,幂律拟合的极限是 4.431(95% 置信区间 3.89 到 4.58),低于反向传播的 4.633。作者自己标注了 caveat:阶梯还在下降,拟合约束松,这个数字应读作"差距随种群继续收窄"的证据,而不是测得的极限。
权重空间基线被拉开了数量级。EGGROLL 用 256 倍于 Dust 的种群(16k 对 64 draws)仍够不到 Dust 的损失;按阶梯外推,它需要几千到约一万倍的种群才能匹配 Dust 最小种群(64 draws)的成绩。换用 Adam 优化器后,EGGROLL 几乎没有增益(调参后的 Adam 阶梯与 SGD 阶梯差距在 0.01 以内),而 Dust 和反向传播都能从 Adam 获益——这说明 Dust 的梯度估计与为反向传播设计的现代优化器兼容。
反常识之一:大模型更省种群
零阶方法不能训大网络是这一领域的共识,理由是估计方差随扰动维度增长。Dust 的Scaling实验给出了相反的证据:2M、7.3M、38M、243M 参数(相差 120 倍)的四个模型,固定 10M token 预算做种群扫描,结果在 256 及以上的每个种群规模,损失都从 2M 到 7M 到 38M 递减,243M 模型只略差于 38M。也就是说,更大的模型从规模获得的收益超过了它因方差付出的代价。
更明显的差异在饱和行为:小模型在种群拉大后很快饱和,大模型持续受益。超过 1k draws 后,38M 和 243M 模型的增益比 2M 和 7M 模型高约 30%,而 2M 模型无论种群多大都追不上。论文对这一现象的解释是把模型规模理解为搜索空间的规模和几何:更大的搜索空间装得下更大的种群,损失景观的条件数可能也更好,搜索因此更有效。这给"过参数化"提供了一个新视角:过参数化不只是让优化更容易,它让基于搜索的训练有了用武之地。
反常识之二:类反向传播的梯度自发涌现
Dust 的梯度估计与反向传播梯度有多像?论文在同批次上测两者的余弦相似度,测量的对象是反向传播训练出来的检查点,token 数横跨两个数量级(10M 到 1B),种群从 64 到 128k。结果:余弦随种群上升,每个层类型在每个训练阶段都符合一个两参数规律(拟合 RMSE 低于 0.06),在 100M token 检查点上拟合 RMSE 在 0.0032 到 0.0367 之间。作为对照,EGGROLL 的估计在 128k 前向传播时余弦仍低于 0.05(语言建模头除外)——它的梯度估计从未真正立起来,这解释了它训练失败的原因。
另一个细节是,Dust 的梯度方向与反向传播相似但不收敛于它。论文认为这是好事:估计指向相近的方向但不是同一个方向,优化轨迹因此不同,而实验中这条轨迹有时比反向传播的更好。链式法则之外的信用分配如果能隐式探索损失景观、拾取高阶曲率信息、把搜索拉向平坦区域,就能解释为什么大种群下 Dust 有时落在反向传播之下。作者把这个机制列为开放问题。
训练的根本问题是信用分配:网络有数百万到数千亿个参数,最终输出一个标量损失,每个参数该为损失的变化负多少责任?反向传播用链式法则精确回答这个问题,但它有两个隐含前提:网络必须端到端可微,且梯度必须逐层反向流过整个计算图。这两个前提决定了什么样的架构能被训练——循环神经网络沿时间反向传播(BPTT)时梯度爆炸或消失,含外部程序交互、多步循环计算的网络难以训练,都源于此。Dust 给出的答案是:信用分配可以由搜索承担。
边界与工程代价
这篇论文的诚实程度值得称道,作者把方法的边界写在结论里。第一,Dust 目前不省算力:论文目标是验证搜索式信用分配能在最难的任务上与反向传播竞争,而不是替代它——要成为实用方案,算力效率还需要数量级的改善。论文中 Dust 的优势全部体现在"给定种群规模下比权重空间 ES 高两到四个数量级的效率",以及大种群下对反向传播的追平或反超,而不是"同样的墙钟时间训得更快"。每次 draw 需要对不同层类型分别做扰动前向(尽管干净前向被缓存、只重跑受扰动块之后的部分),interference 控制也要求不同层类型分开打分。
第二,实验规模有限:最大的模型是 243M 参数、20M token,与当代预训练动辄万亿 token 相距甚远。种群需求随 token 增长(这是论文自己观察到的),余弦相似度在 1B token 处保持稳定是希望所在,但外推到生产规模仍是未知数。
第三,真正的想象空间在反向传播做不到的地方:不可微架构、含外部程序在环的网络、BPTT 难以处理的多步循环计算。论文明确把这些留作未来工作——Dust 目前的意义是打样:信用分配可以完全由搜索承担,且在搜索预算充足时不再是一阶方法的下位替代。
对从业者的含义
对大多数工程师,Dust 短期内不改变任何决策——它不会出现在下一个版本的 PyTorch 里,训练你手头的模型仍然该用反向传播。它改变的是两件事的确定性。其一,"零阶方法无法预训练大网络"从共识降级为假设:243M 模型的种群效率反超小模型,是第一条反例证据。其二,可微性不再是信用分配的必要条件:如果搜索式训练成立,架构设计的约束条件就少了一条,那些因为"训不动"而被放弃的结构(循环深度计算、离散操作、外部工具调用在环)值得重新评估。
在算力持续过剩、模型架构创新放缓的背景下,用暴力搜索换掉一个解析方法(链式法则)的尝试方向,与 AlphaGo Zero 用自我对弈换掉人类棋谱是同一类赌注。Dust 没有赢,但它把"能不能"的问题推进到了"多大算力下能"。
论文:Dust: Pretraining Transformers Without Backpropagation,作者 Samip Dahal、Bishwas Mandal、Serdar Gülbahar、Akshay Vegesna。相关方法:EGGROLL(arXiv:2511.16652)、MeZO(NeurIPS 2023,微调场景的前向传播微调)、Forward-Forward(Hinton,2022)。
说明:本文全部实验数据引自论文原文,损失数值口径为测试集损失(验证集最优检查点),种群单位为 draws(Dust)与批次前向传播次数(EGGROLL)。