9 月 30 日,Google DeepMind 发布新一代旗舰模型 Gemini 4 Argon,由 DeepMind 高级副总裁 Koray Kavukcuoglu 撰文宣布。发布当天,这条消息登上 Hacker News 首页榜首,讨论串里聚集了五百多条评论。这次的看点有两个:模型本身的成绩(DeepSWE v1.1 拿下 77.9% 的最高分、输出上限扩到 100 万 token),以及一个少见的发布方式——普通用户暂时用不上,第一批拿到模型的是网络安全防御人员。
发布方式:先给安全人员,再给付费开发者
Argon 目前的获取渠道是 Google 的 Fairwind Program,面向"受信任的网络防御者"开放。官方公告同时确认,Google 正参与美国政府针对前沿模型的自愿性预发布流程,逐步扩大访问范围。
面向公众的时间表写在公告结尾:Argon 将首先开放给付费 API 客户和 Google AI Ultra 订阅用户,之后再扩展到开发者、企业和普通消费者。也就是说,发布时点与全面可用之间存在一段窗口期,Ars Technica 的报道标题直接概括为"发布了,但你还不能用"。
这个节奏在 Hacker News 引起了分歧。有评论认为"模型太强所以暂不公开"正在变成行业营销的标准动作;也有评论提出反例:Anthropic 的 Opus 5.5 和 OpenAI 的 Sol 6.1 近期都是直接发布、无预热。分阶段到底是安全流程还是稀缺性营销,评论区没有共识,Google 官方的说法是"在此级别的能力上安全发布需要分阶段方法"。
四项基准的具体成绩
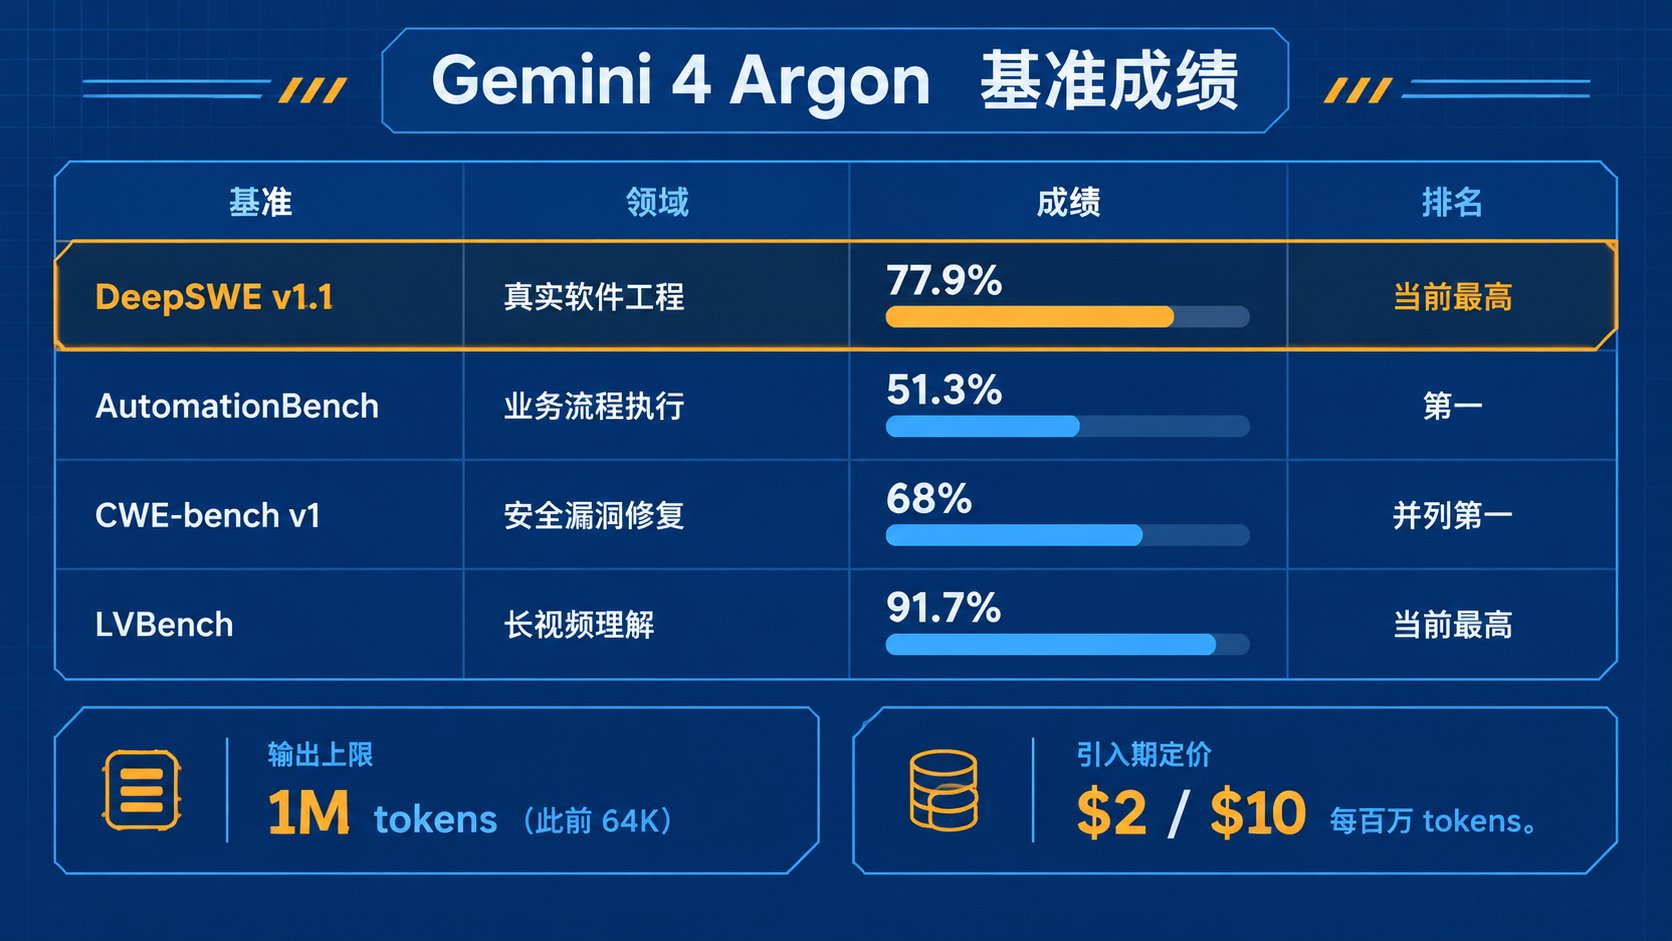
公告给出的数字集中在四个领域:
| 基准 | 领域 | 成绩 |
|---|---|---|
| DeepSWE v1.1 | 真实软件工程任务 | 77.9%,当前最高 |
| AutomationBench(Zapier) | 端到端业务流程执行 | 51.3%,排名第一 |
| CWE-bench v1 | 安全漏洞修复 | 68%,并列第一 |
| LVBench | 长视频理解 | 91.7%,当前最高 |
DeepSWE v1.1 衡量模型在真实长程软件工程任务中的表现。这个榜单此前的前排位置由 Claude 和 OpenAI 的旗舰模型占据,Kimi K3 也曾跻身前三;Argon 的 77.9% 把最高分推进到了新位置。CWE-bench v1 评估的是漏洞修复能力,此前的 v0 榜单由 Gemini 3.8 Flash Cyber 领跑,这一代算是延续。
除公开榜单外,公告还引用了两项厂商内部评估:在 Google 内部的综合性漏洞基准上,Argon 在覆盖 20 种编程语言的复杂代码库中发现多种暴露面;在 Wiz 的内部黑盒渗透测试基准上(不放源码、直接分析在线系统),Argon 在攻击面发现、漏洞识别和概念验证产出三个环节都超过 3.8 Flash Cyber。
100 万 token 输出上限意味着什么
Argon 把输出 token 上限从上一代的 64K 提到 100 万,Google 称这是行业最大。这个数字的作用对象是长程任务:模型有空间在单次执行轨迹里进行几十万 token 的深度推理,一口气完成过去必须拆成多轮的任务。
对开发者的影响是直接的。长输出上限改变了 agent 任务的编排方式:过去为了绕开输出限制,工程上要把大任务切成小步骤、中间结果落盘、再逐步拼接;输出上限足够大时,单轨迹完成复杂重构或大规模分析成为可行选项。代价是 token 消耗模式的改变——单次任务的输出账单可能相当于过去一个完整工作流。
Google 内部的使用数据
公告用四个内部案例说明模型在长程任务上的实际表现,数字都很具体:
视频解码器重写:libgav1 是 Google 的开源视频解码库。Argon 智能体在既有 Rust 移植版的基础上,通过多轮 profile 引导实验、分析编译器输出,用编译器可自动向量化的安全 Rust 代码替换了 3.2 万行 SIMD 代码。结果是产出内存安全的解码器,速度比原 Rust 移植版快 2.7 倍,视频输出逐帧一致,逼近优化过的 C++ 版本。
大规模代码迁移:Argon 智能体参与 Google 内部 C/C++ 到 Rust 的迁移,规模从 re2、libgav1 等核心库的数万行,一直到 Fuchsia Zircon 内核的 80 万行以上。官方明确这些重写经过严格的自动化审计、人工审查和模拟测试才进入生产。
数据中心内存优化:一组 Argon 智能体分析全集群的性能剖析数据,自主识别并应用内存优化,上线后释放超过 300 TiB 内存,预计总节省 500 TiB 到 1 PiB。
量子算法优化:在量子计算研究中,Argon 对瓶颈子例程的时空资源(量子比特 × 门数)做优化,一个案例在几分钟内超过已发表基线 40%。
安全设计:四个方向和一个特殊版本
Argon 的安全框架围绕四个方向展开。防滥用方面,模型按 Frontier Safety Framework 设计为拒绝网络攻击与 CBRN(化学、生物、放射、核)相关的有害请求,同时保留正当的双用途科研空间;Google 加强了对模型内部激活的监测来识别滥用,护栏经内外部红队测试。防提示注入方面,经自动化红队与对抗训练,Argon 在 Gray Swan 的间接提示注入基准上排名第一。对齐监测方面,Google 部署了监督推理链和行动的系统,越界时中止执行,同类系统也用于监控训练运行。基础设施方面,高风险训练和评估前对沙箱环境做隔离与封存。
细节落在护栏上:对受信任的防御者和 Google 内部团队,Google 将发布去除网络安全护栏的 Argon 版本,让防御方用到完整的前沿攻防能力。攻防能力的不对称投放,是这个发布策略里最实质的部分。
Wiz 已经通过其 Scan for Good 项目把 Argon 用于公益防御:模型在早期演示中发现了一个暴露全球医院使用的医疗软件敏感个人信息的严重漏洞,官方称此前的前沿模型都漏掉了它。
定价
Argon 引入期定价为每百万输入 token 2 美元、输出 10 美元,缓存输入享输入价 95% 折扣。引入期结束后转为每百万输入 4 美元、输出 20 美元。这是 Google 前沿模型的常规定价档位,公告没有提及与 Gemini 3.8 系列的价格关系。
对普通开发者的实际影响
短期内的答案是:还用不上。模型先走 Fairwind Program 和政府预发布流程,公众开放从付费 API 和 AI Ultra 订阅开始。开发者能做的是关注两个信号:一是 Argon 全面开放后,100 万 token 输出上限对 agent 工作流设计的影响;二是安全领域攻防工具的格局变化,当防御方先于攻击方拿到前沿攻防能力,漏洞发现和修复的周期会被直接压缩。
模型本体的成绩留待第三方复现验证。DeepSWE、CWE-bench 这些榜单此前都有厂商自报与独立复测的差距问题,Argon 的分数最终成色如何,要看它进入付费 API 之后社区的实测。