你的 AI 对话,正在进入广告追踪系统
九家主流 AI 聊天服务的隐私审计显示:每一家都接入了第三方广告或追踪服务,六家网页版会把对话衍生出的链接、标题、提示词甚至截图交给这些第三方,且这些数据常常与持久用户标识一同传输。这项名为 "Prompt like a Butterfly, Sting like a Tracker" 的研究来自马德里 IMDEA 网络研究所与卡洛斯三世大学,2026 年 9 月中旬公开,发表于隐私技术领域期刊 PoPETs(Proceedings on Privacy Enhancing Technologies),HN 讨论 401 分。论文采用 CC BY 4.0 许可,作者已完成对涉事厂商与欧洲数据保护机构的负责任披露。
研究覆盖了谁,怎么测
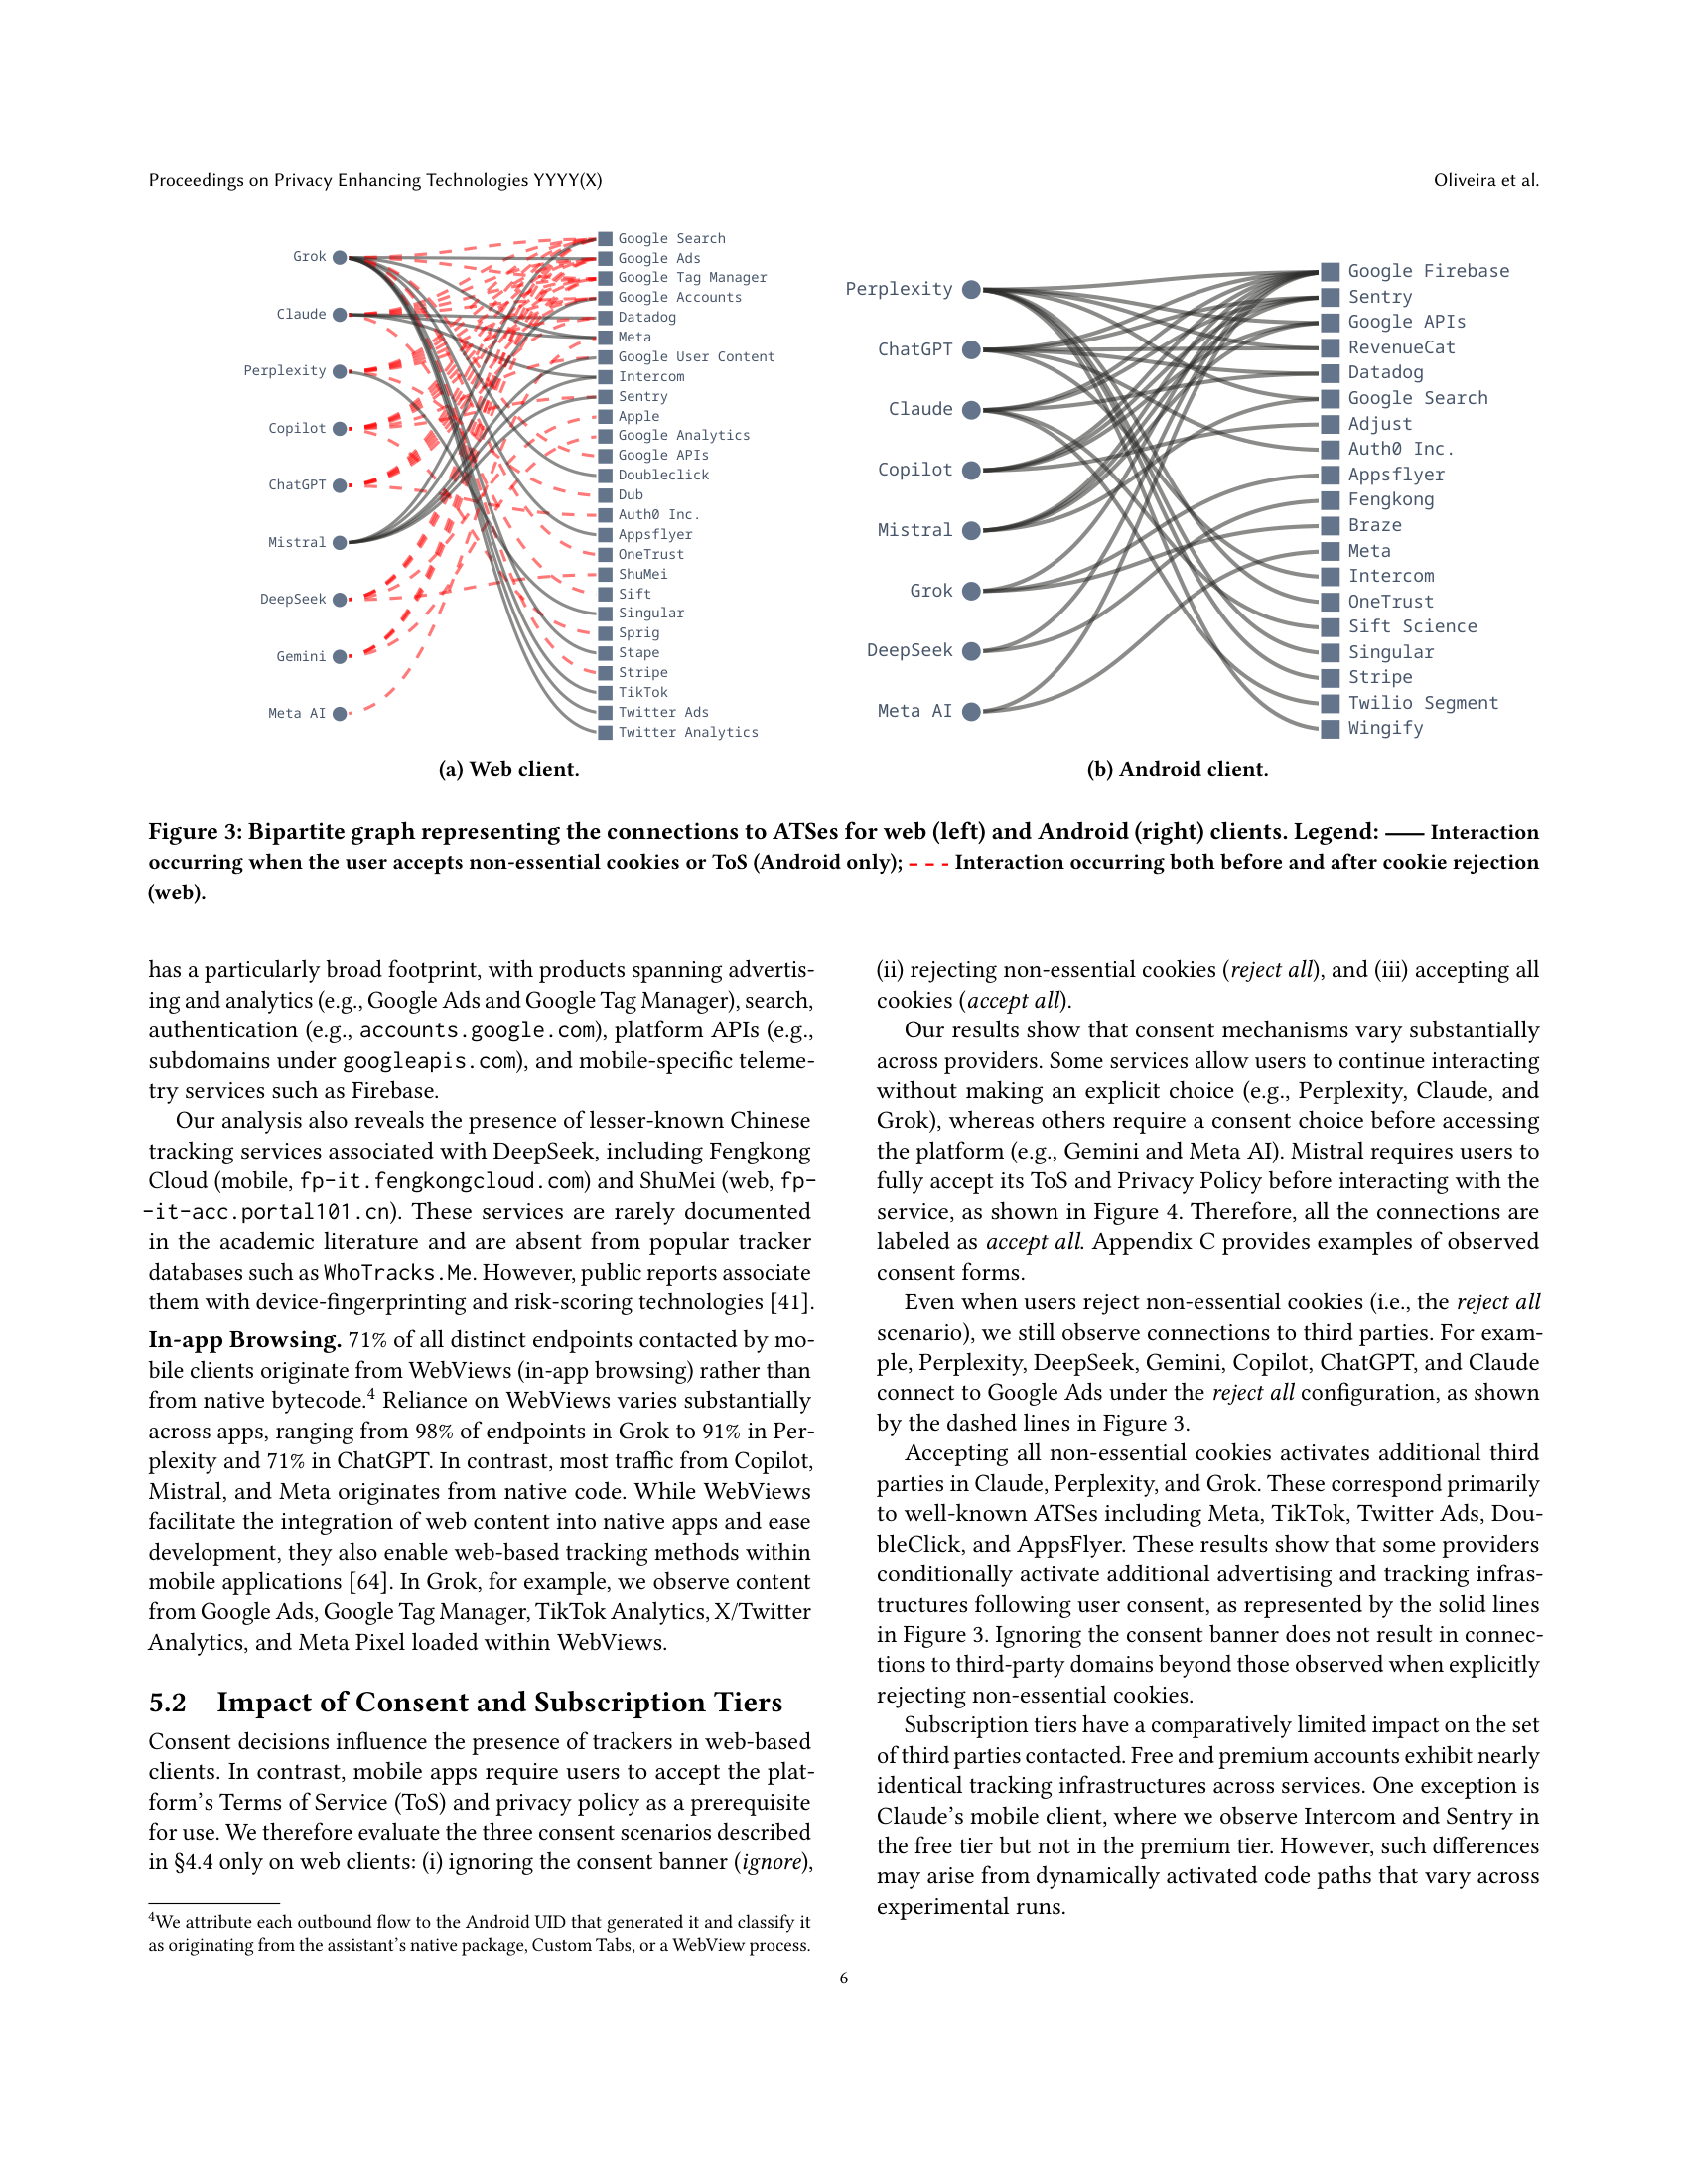
研究对象是九个用户规模最大的对话式 AI 服务:ChatGPT、Claude、Gemini、Microsoft Copilot、Grok、DeepSeek、Perplexity、Mistral(Le Chat)和 Meta AI。团队测量了全部九家的网页客户端,以及其中八家的 Android 客户端(Gemini 移动端流量无法提取)。方法是静态分析与动态分析结合:静态侧解析每家服务的 CSP(Content-Security-Policy,内容安全策略)响应头,枚举页面被授权联系的外部域名;动态侧在受控环境里模拟真实对话,捕获实际发出的网络流量。
实验矩阵覆盖三种 Cookie 同意场景(忽略横幅、全部拒绝、全部接受)与三档账户(访客、免费、付费),提示词刻意使用健康类敏感内容,以观察平台在真实敏感场景下的行为。测量共观察到 124 个第三方域名,归并为 44 家组织,其中 34 家属于广告与追踪服务(ATS)。九个服务无一例外,至少接入一家 ATS。
追踪生态的结构
Google 系产品是覆盖面最广的第三方:Google Search 出现在 8 个服务中,Firebase 出现在全部 8 个 Android 客户端中,Google Ads 与 Tag Manager 各覆盖 7 家网页端。其次是 Sentry、Meta、Datadog 和 Intercom。
两个较少被记录的追踪服务值得单独一提:DeepSeek 集成了数美(ShuMei,网页端)与数穹(Fengkong Cloud,移动端),这两家与设备指纹和风控评分技术相关,既不在学术文献常见名单里,也没有被 WhoTracks.Me 这类主流追踪数据库收录。
网页端与移动端的追踪结构差异很大:15 家 ATS 只出现在网页端(包括 Google Tag Manager、TikTok、OneTrust),8 家只在移动端(包括 Braze)。移动端还有个结构性问题,71% 的第三方请求来自 WebView(应用内嵌浏览器)而非原生代码,Grok 的这个比例高达 98%。WebView 让网页追踪技术在手机应用里原样复现。
对话数据怎么泄漏
这是论文最核心的部分。传统网页追踪观察的是浏览行为,而 AI 聊天服务会产生直接编码用户意图的"对话衍生数据":对话永久链接、AI 自动生成的会话标题、用户提示词、屏幕截图。审计结果:
| 泄漏物 | 网页版涉及服务数 | 涉及第三方数 |
|---|---|---|
| 对话 URL / 永久链接 | 5/9 | 9 家 ATS |
| 对话 ID(不含 URL) | 2/9 | 1 家 |
| 对话标题 | 3/9 | 9 家 |
| 用户提示词 | 1/9 | 2 家 |
| 对话截图 | 1/9 | 1 家 |
对话标题的泄漏值得展开:ChatGPT、Claude、Grok 都会用 LLM 自动压缩用户首条提问生成会话标题。论文给出的例子是,用户问"我的年薪 8.5 万美元,在纽约能贷多少房贷",Grok 生成的标题是"85k NYC Salary: $280k-$350k Mortgage",薪资、城市、贷款区间全在里面。这类标题是语义密度极高的内容摘要,流向的第三方包括 Meta、TikTok 和 DoubleClick,其中 8/9 的泄漏仅在用户接受非必要 Cookie 后发生。
具体到厂商,Grok 网页版的对话数据外送面最大:接受非必要 Cookie 后,DoubleClick、Google Ads、Google Search、Google Tag Manager、Meta、TikTok、Twitter Analytics 七家追踪服务会同时收到对话 ID、完整对话 URL 和会话标题,Google Ads 与 DoubleClick 还收到哈希后的邮箱地址(em 参数)。ChatGPT 与 Claude 的网页版会把全局对话 ID 连同用户 ID 发给 Datadog。Perplexity 在访客模式下会把用户提示词发给 A/B 测试服务商 Wingify。
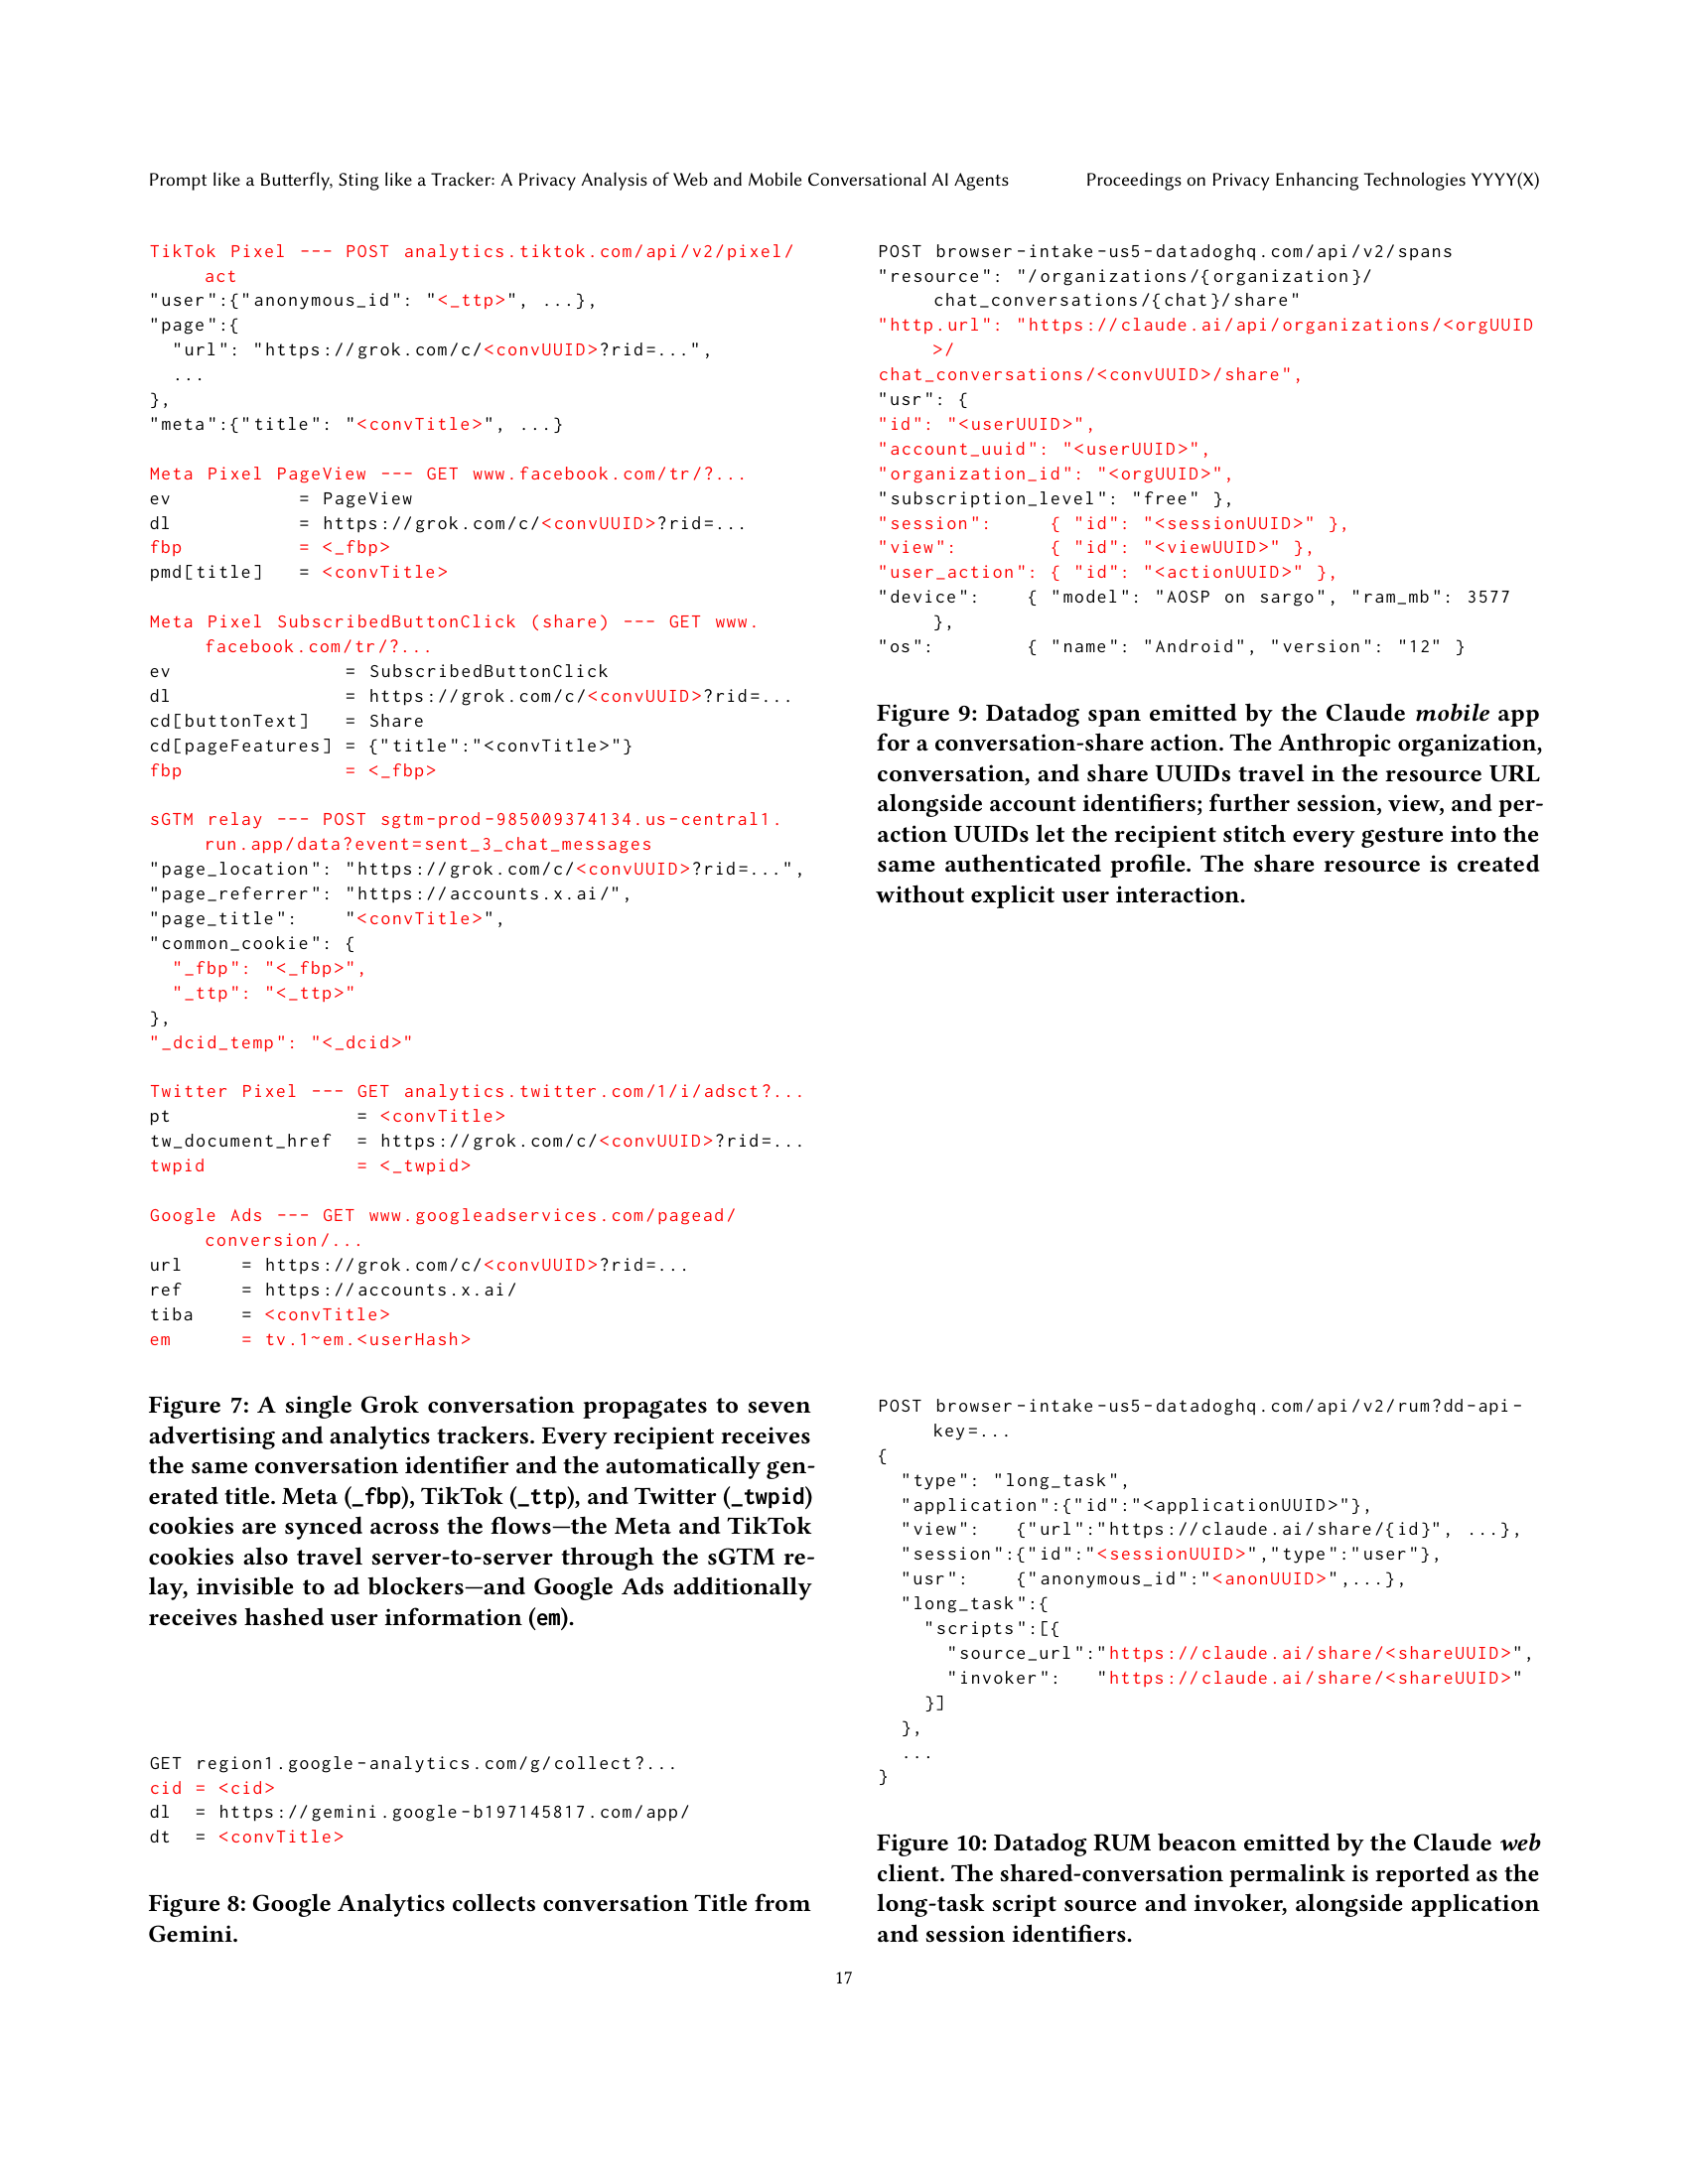
两条服务端通道绕开了广告拦截器。Claude 通过第一方域名代理的 Segment Analytics 加载 Conversion API 配置,把用户事件从自己的服务器转发给十一家追踪平台(Facebook、LinkedIn、TikTok、Reddit、Google Enhanced Conversions 等),每个事件携带两个共享 ID。Grok 则内嵌了服务端 Google Tag Manager(sGTM)容器,把对话 URL 和标题通过 Meta Conversions API 与 TikTok Events API 直接服务器对服务器传输,同一载荷携带 Meta 的 _fbp 与 TikTok 的 _ttp Cookie,让两家平台把同一次对话归并到同一个身份下。
从对话到身份
对话数据与持久标识一同传输时,追踪才能落地为画像。论文观察到的关联手段包括:哈希邮箱(Perplexity 把用户邮箱哈希发给营销分析公司 Singular,第三方可对已知邮箱自行计算同样的哈希完成匹配);Android 广告 ID(AAID,Copilot 发给 Adjust、Grok 发给 AppsFlyer、Perplexity 发给 Singular),且常与账号 ID 或安装 ID 同时传输,即使用户重置 AAID,持久 ID 也能把新 ID 重新绑定回同一人;Claude 移动端还把地理位置坐标和 Android 硬件标识(SSAID)发给风控服务商 Sift Science。
永久链接:默认公开的对话
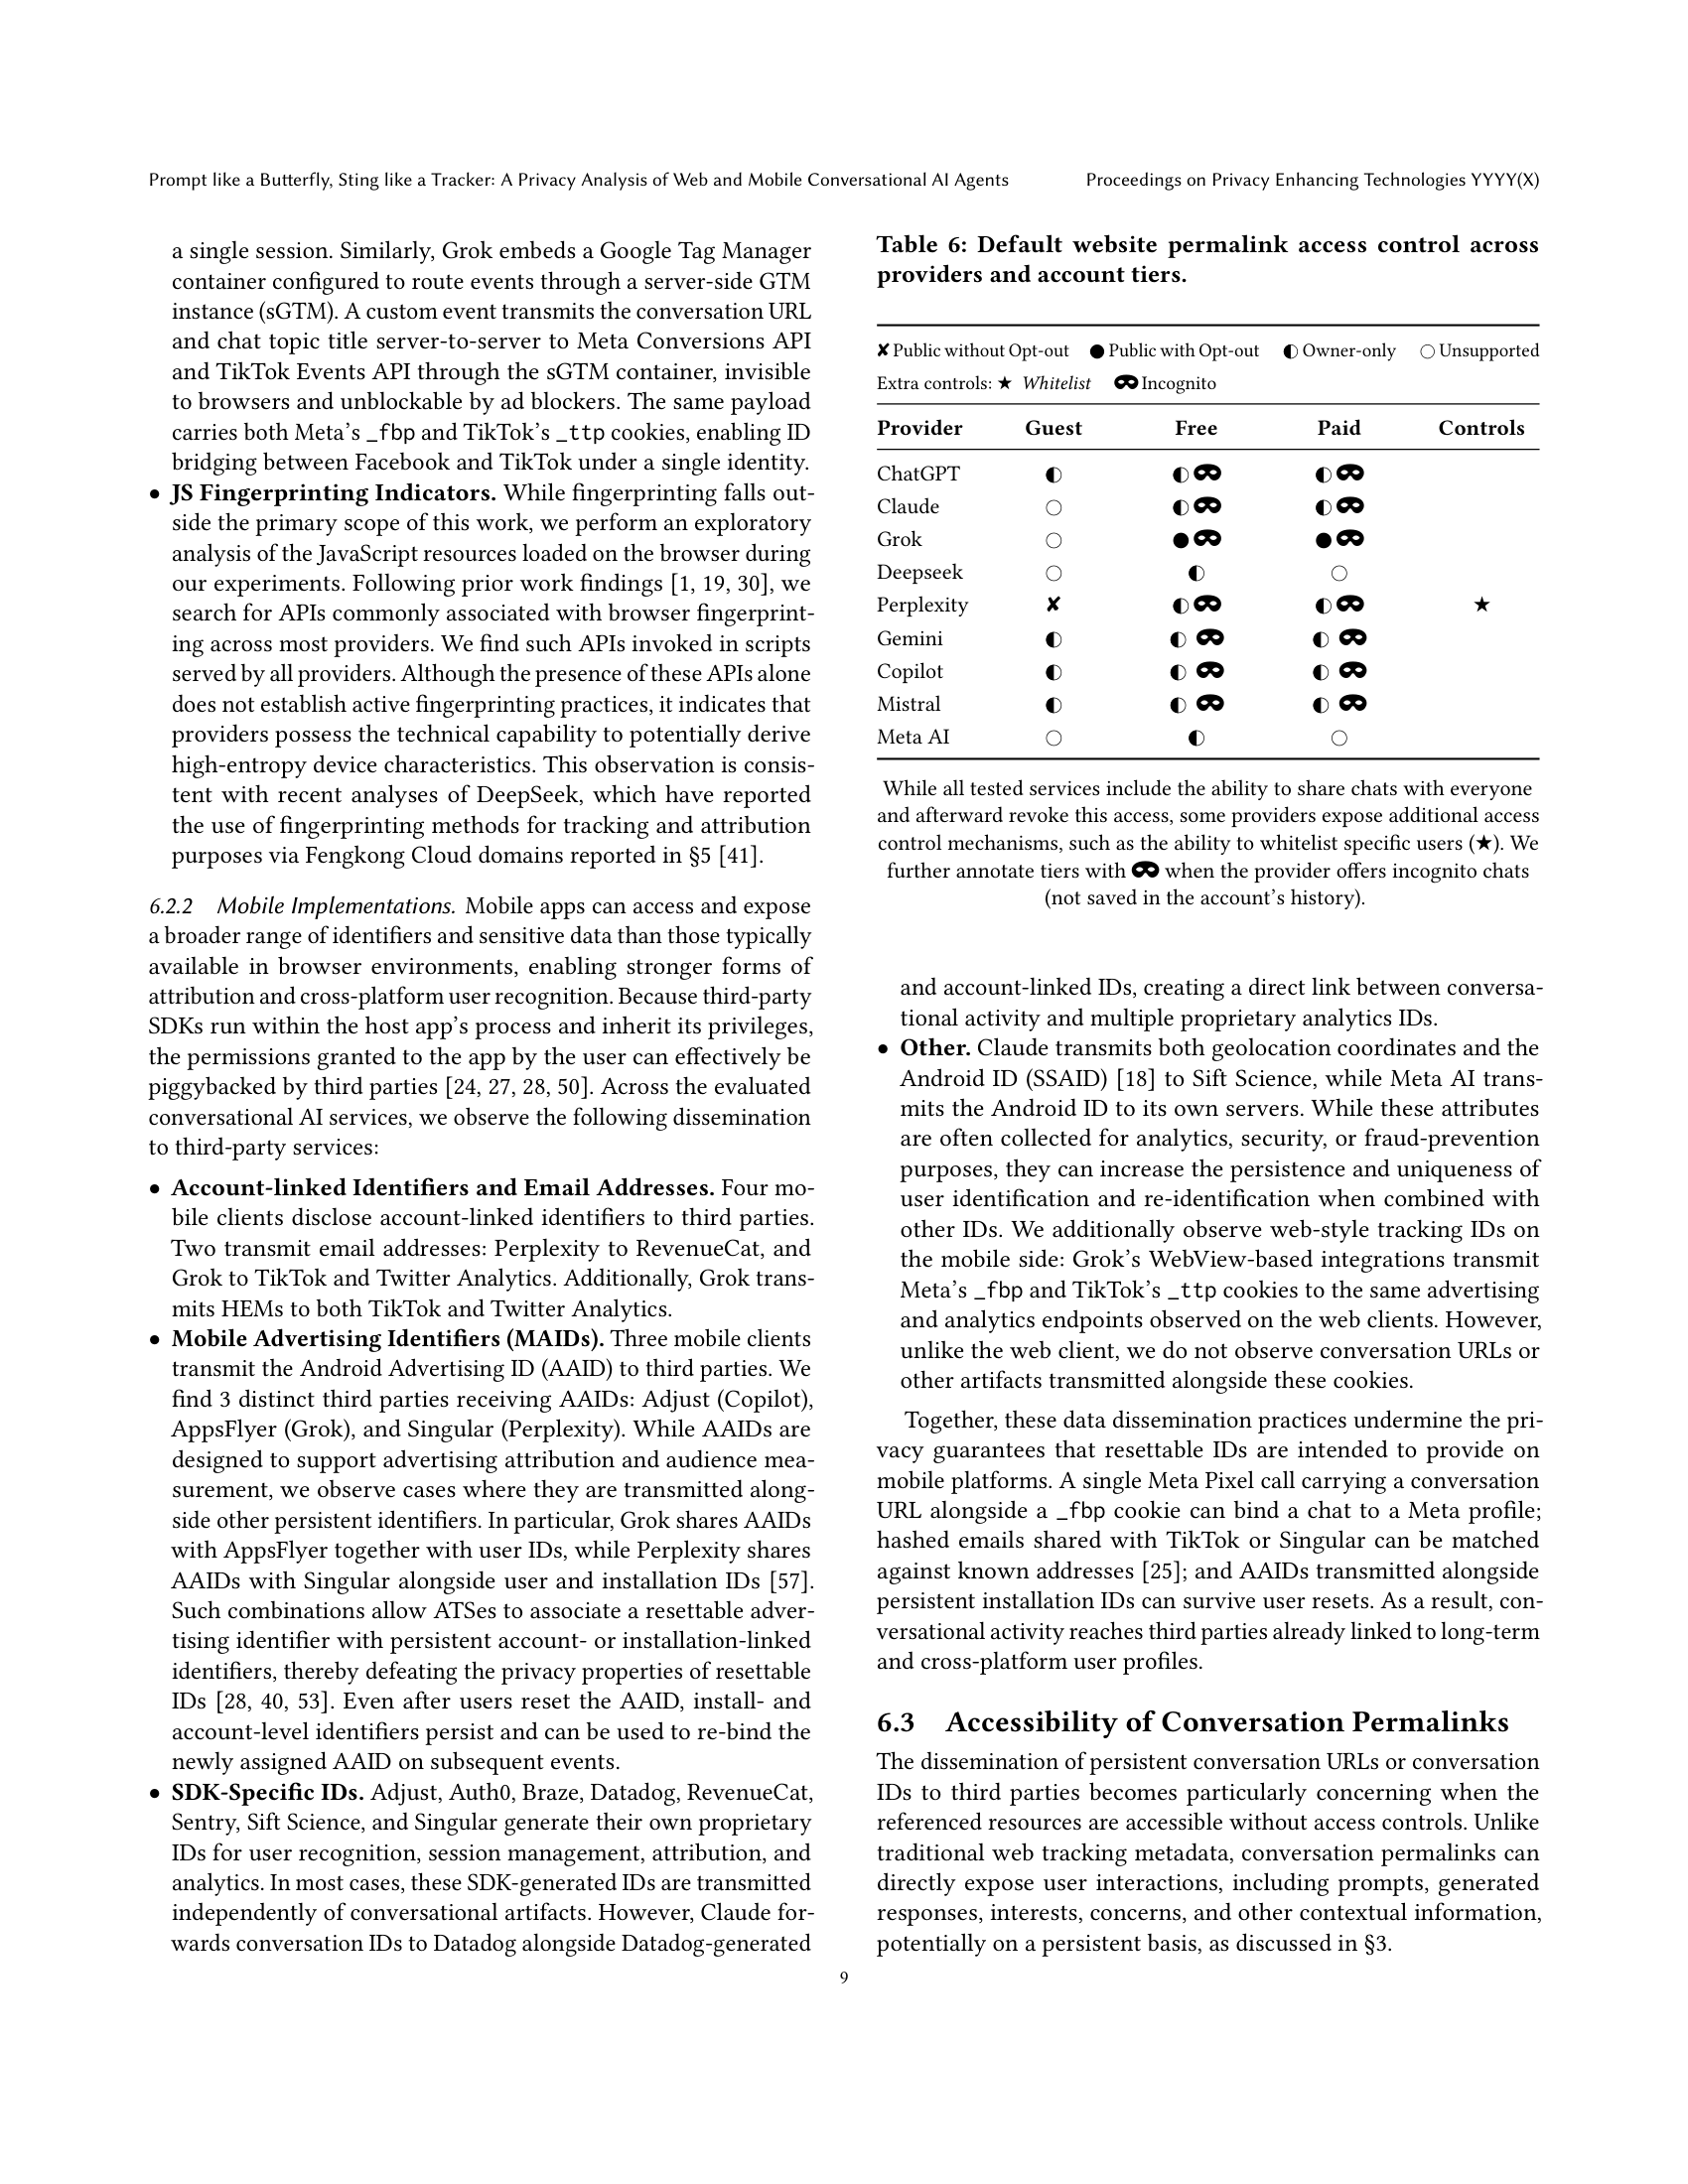
对话 URL 泄漏给第三方的严重程度,取决于链接本身是否需要登录才能访问。论文测了九家服务的永久链接在无痕、未登录状态下的可访问性:
- Perplexity:访客(未登录)用户的对话链接默认全网公开可读,且无退出选项。2026 年 4 月 3 日起,Perplexity 停止把对话 URL 共享给 Meta 等第三方追踪器,时间点与美国一起集体诉讼相关。
- Grok:免费与付费档的对话链接默认公开可访问,需用户主动退出。
- ChatGPT、Claude、Gemini、Copilot、Mistral:链接默认仅所有者可见。
- Meta AI 与 DeepSeek 的部分档位干脆不支持链接访问控制。
分享功能进一步放大暴露:所有九家服务的"分享对话"生成的链接都不需要登录即可查看,分享页内嵌的 9 家第三方由此获得整个对话的完整可见性。Grok 的分享流程中,TikTok 会收集对话截图,Meta 与 TikTok 同时收集用户最近一条提示词。
泄漏之后:内容真的被回访了
数据送出去之后有没有人读?团队在对话与上传文件里埋了金丝雀链接(canary token,一种带访问告警的追踪 URL)验证。结果是 Grok 的对话资源在初始交互后的数小时到数天内被反复访问:70 个不同 IP、横跨 48 个自治域、14 个国家 4 大洲,其中 65.7% 的访问来自美国,而对话发生在欧盟。Perplexity 的爬虫(Perplexity-User)则反复访问金丝雀链接,甚至在被明确要求不要访问的情况下仍然如此。DeepSeek、Copilot、Mistral、Claude 的访问限于提交时的一次性抓取,来自 AWS 与 GCP 的云基础设施。
同意与付费,保护力都有限
拒绝非必要 Cookie 的实际效果:网页标识外送的 77.3% 只在用户接受非必要 Cookie 后发生,说明同意机制名义上有作用。但按追踪器数量计,全部拒绝后仍有 80.8% 的第三方追踪器保持活跃,Perplexity、DeepSeek、Gemini、Copilot、ChatGPT、Claude 在"全部拒绝"配置下依然连接 Google Ads。忽略横幅与明确拒绝的结果没有差别。
付费档与免费档的追踪基础设施几乎一致,没有任何服务因订阅而减少第三方。Mistral 要求用户完全接受服务条款才能使用,其全部流量被归入"全部接受"档。网页端唯一支持持久保存 Cookie 偏好的是 ChatGPT 付费档,而 OpenAI 自己的数据是约 95% 的用户停留在免费档。
法律层面
论文按 GDPR 与 ePrivacy 指令逐项分析了这些实践:Cookie 与追踪像素在广告目的下需要事先知情同意(ePrivacy 第 5(3) 条);向第三方披露对话信息需要独立的告知与法律基础;OpenAI、Anthropic、Perplexity、xAI 的隐私政策都用"用户内容""服务交互信息"这类泛化表述带过第三方访问,未按欧盟法院 Meta Platforms Ireland 案(C-757/22)要求的颗粒度逐项说明。健康、心理、财务类对话长期积累后可推断出特殊类目数据,即便单条对话不含身份信息。团队明确说这不是合规判定,判定需要厂商内部文档,但指出了值得监管机构关注的张力点。
这对使用者意味着什么
论文的缓解章节直接给出几层判断。浏览器层面,Brave 这类默认阻断广告与追踪资源的隐私浏览器能挡住网络层追踪,但服务端与第一方追踪可以绕过;移动端没有与网页 Cookie 同意对等的机制,用户控制力更弱。
对个人用户,审计结果支持三个可执行的习惯:其一,网页版聊天里拒绝非必要 Cookie 仍然值得做,它确实能关掉标题与截图类泄漏的大部分通道,只是别指望它拦住全部;其二,把 AI 分享链接当作公开网页对待,任何拿到链接的人(和链接页面上嵌入的九类第三方脚本)都能读到全文,分享前清掉敏感内容;其三,付费订阅不减少追踪,敏感问题更稳妥的载体是企业档或本地部署模型,论文也指出企业档的独立承诺不在本次测量范围内。
对开发者,这篇论文的方法论(CSP 静态枚举 + 动态流量捕获 + 金丝雀验证)可以直接复用到自家 LLM 应用的隐私审计上,论文明确说,这些泄漏向量同样存在于依赖同一套网页与移动分析管线的客服聊天机器人和 AI wrapper 应用里。
论文全文(CC BY 4.0):Prompt like a Butterfly, Sting like a Tracker,发表于 PoPETs。HN 讨论见 news.ycombinator.com/item?id=49890226。