Google Cloud AI Research 团队(Yiwen Song、Yale Song、Tomas Pfister、Jinsung Yoon)开源了多智能体论文写作框架 PaperOrchestra,配套论文发布于 arXiv(编号 2604.05018),代码以 Apache-2.0 协议托管在 google-research 组织下。它做的事情可以用一句话说尽:研究者把想法摘要和实验记录交给它,它产出一份符合目标会议模板、带文献综述和自动生成图表的 LaTeX 投稿件。
评估结果给了两个锚点。人工对比评估中,PaperOrchestra 稿件的文献综述质量比现有自主写作基线高出 50 到 68 个百分点的胜率差,整体稿件质量高出 14 到 38 个百分点。模拟同行评审系统 ScholarPeer 给它生成的 CVPR 风格稿件打出 84% 的模拟接收率,同期测的人类原始论文是 86%。
任务被定义成五个输入
论文把这个任务写成了函数:输入一个五元组,输出一份可直接提交的 LaTeX 源文件加编译好的 PDF。五个输入分别是想法摘要(Idea Summary,方法概述与核心贡献)、实验记录(Experimental Log,原始数据点、消融实验、性能指标)、目标会议的 LaTeX 模板、投稿规范(Conference Guidelines),以及一组可选的现成图表。最后这项为空时,流水线自己补齐全部配图。
这个定义是针对现有系统的短板设计的。Sakana AI 的 AI Scientist-v2、Cycle Researcher 这类端到端自主科研框架,写作模块和自家实验循环绑死,没法单独接手人类提供的材料;AutoSurvey2、LiRA 这类文献综述生成器又只会长综述,不会把原始实验数据组织成一篇完整论文。PaperOrchestra 的定位是独立的写作工具,上游材料从哪来它不管。
五个智能体的分工
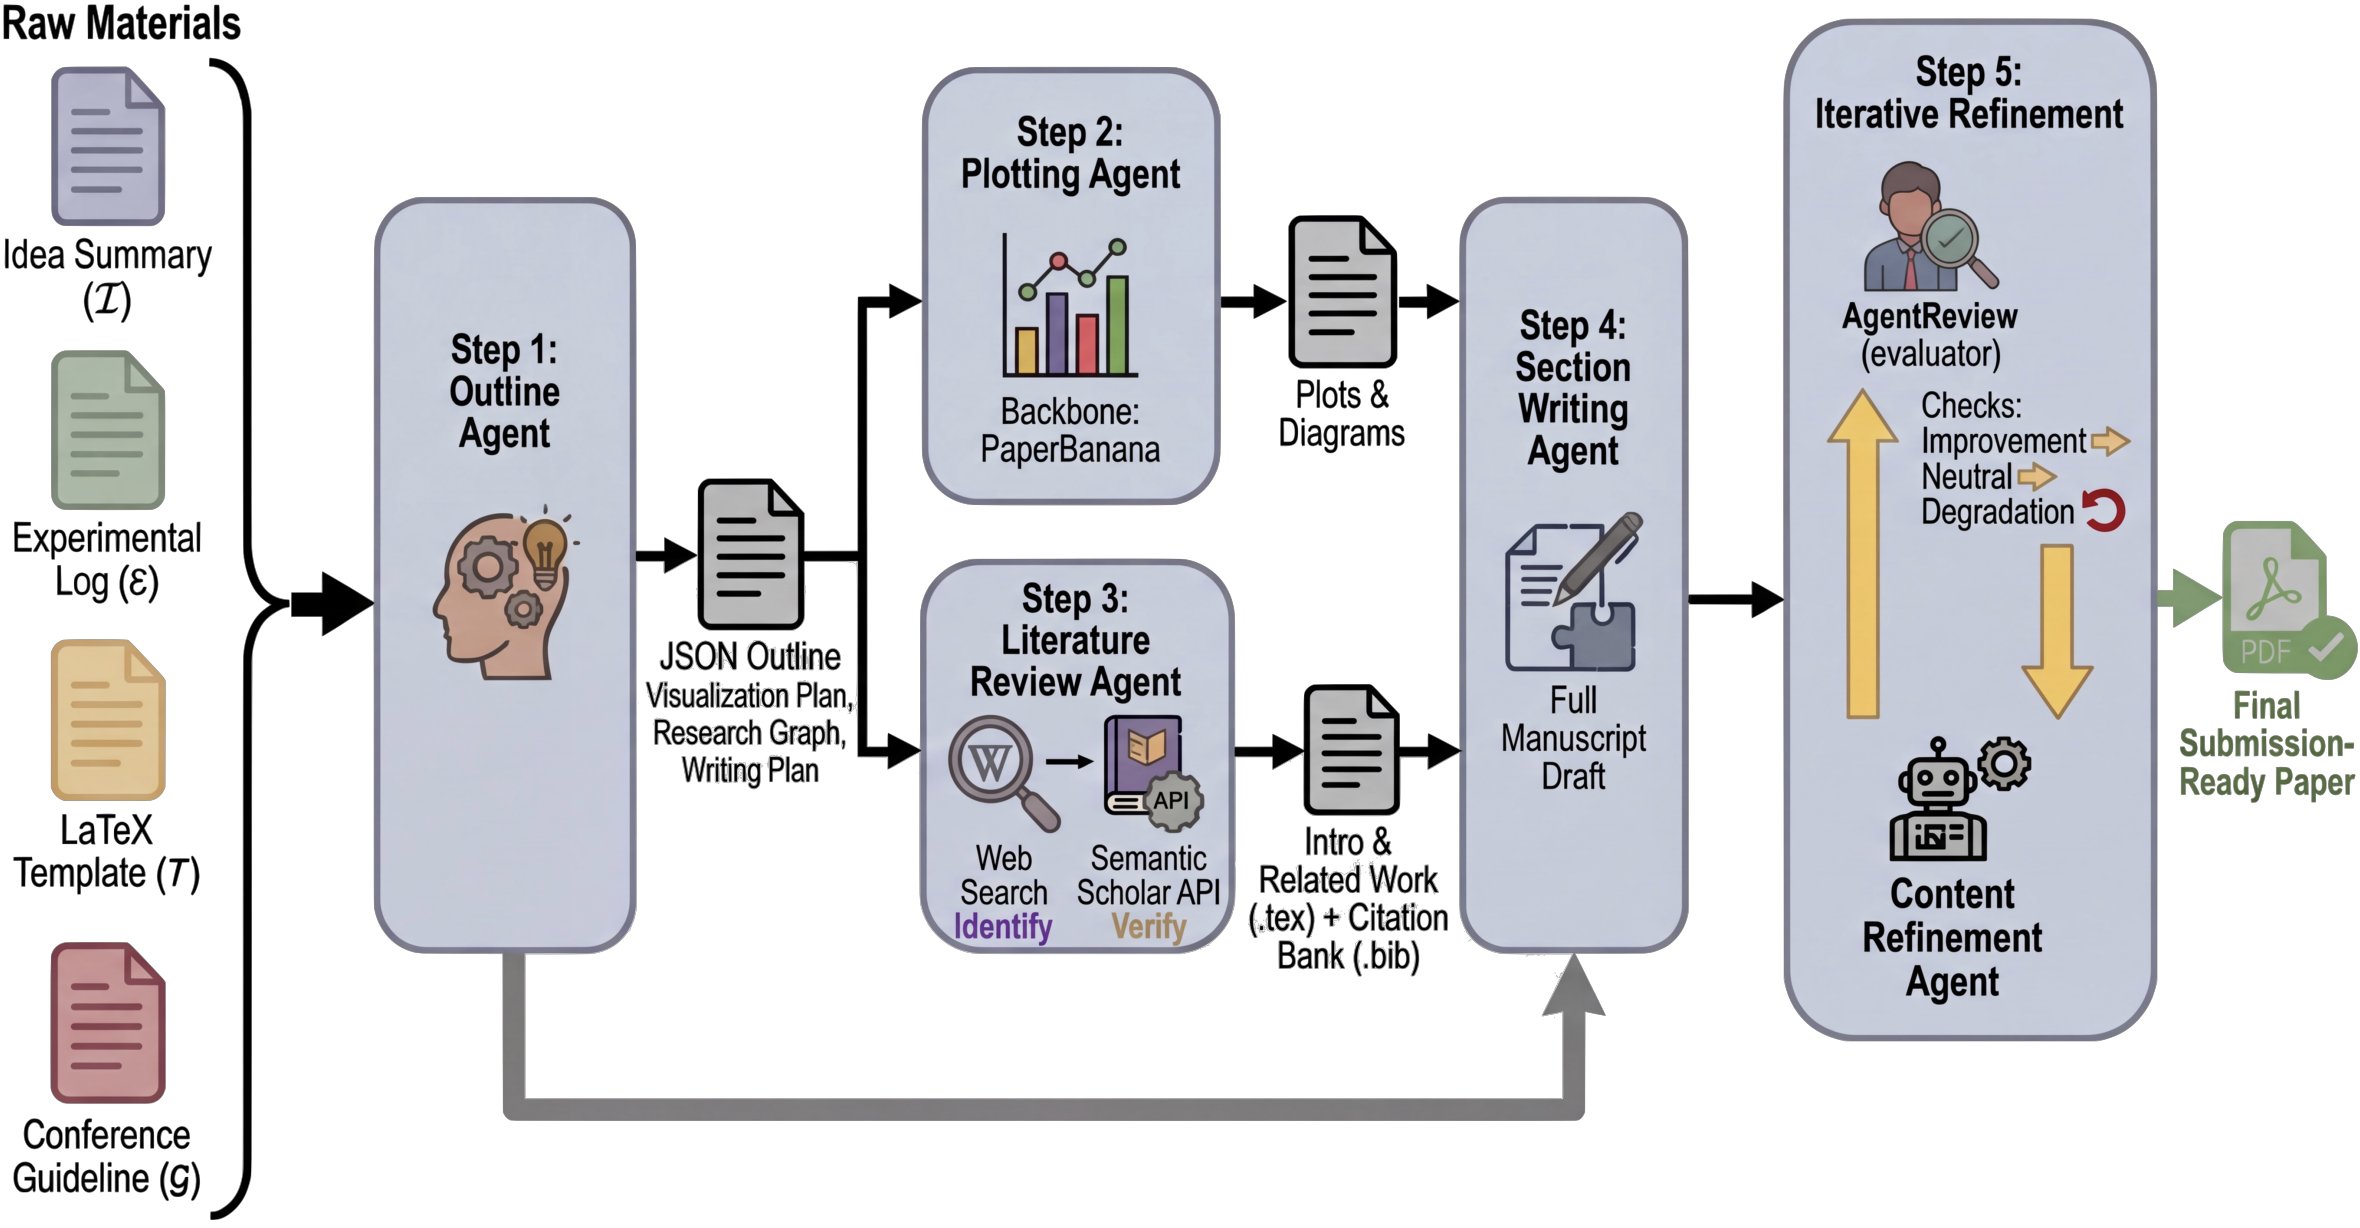
第一步是大纲智能体(Outline Agent)。它读完所有原材料,产出一份 JSON 大纲,内含三块内容:配图计划(每张图的图型、数据来源、长宽比)、文献检索策略(宏观背景与微观方法簇两条线,指导后续检索和引文地图的构建)、分节写作计划(各节内容要点,附基线、数据集、指标等核心外部依赖的引用提示)。
第二、三步并行。绘图智能体按配图计划生成概念图与统计图,默认调用 PaperBanana 模块:一个 VLM 评审者对照设计目标检查渲染结果,发现视觉瑕疵就修改文字描述重新生成,属于闭环迭代。文献综述智能体则按检索策略执行混合检索:先让带联网搜索的 LLM 找候选论文,再调 Semantic Scholar API 验证每篇真实存在,通过后才抓摘要和元数据,按 Semantic Scholar ID 去重,最后自动生成 BibTeX 文件并用验证过的引用写出 Introduction 和 Related Work 两节。
第四步由正文写作智能体接手。它在部分填充的 LaTeX 文件上继续,从实验记录里提取数值构建表格,写出摘要、方法、实验、结论各节,并把生成的图插进去。第五步是精修智能体:用 AgentReview(一个模拟同行评审系统)打分,修改后分数上升就接受,平分且各分项净变化非负也接受,分数下降立即回滚到上一版,达到迭代上限就停。
引用必须先证明存在
文献幻觉是自动写作的老问题。这个框架的解法是把「找文献」和「信文献」拆开:LLM 负责发散地找,Semantic Scholar 负责一票否决。候选论文查无实据、超出时间截点、对不上唯一标识,一律丢弃。这个设计在结果里直接兑现:论文附录提到,检索阶段用 10 个并发工作者跑 LLM 搜索快速攒候选,验证阶段严格按 Semantic Scholar 的限速(每秒 1 次查询)串行过一遍,两边各自跑在能承受的速度上。
200 篇顶会论文逆向出来的基准
评估用了自建的 PaperWritingBench:从 CVPR 2025 和 ICLR 2025 各随机抽 100 篇接收论文。真实论文的写作前材料(实验笔记之类)拿不到,团队用 LLM 从成品论文逆向合成:MinerU 把 PDF 转成保真的 Markdown,PDFFigures 2.0 抽取图表实体和题注,再让 LLM 反推出想法摘要和实验记录。合成材料做了两道防泄漏处理:剥离作者与标题,删光所有引用、URL 和图表交叉引用。
想法摘要造了两个版本。Sparse 版只保留高层思路,Dense 版保留形式化定义和 LaTeX 公式,对应研究者两种投入程度。实验记录则把图表里的视觉洞察改写成独立的事实陈述,逼着写作系统只靠原始数据重建叙事。
模拟评审与人类评估的读数
模拟评审用了两套框架。ScholarPeer(一个带检索、模拟专家工作流的多智能体评审系统)的模拟接收率如下:
| 稿件来源 | CVPR 模拟接收率 | ICLR 模拟接收率 | CVPR 总分(1-10) | ICLR 总分(1-10) |
|---|---|---|---|---|
| 人类原始论文 | 86% | 94% | 7.07 | 7.48 |
| Single Agent 基线 | 71% | 72% | 6.35 | 6.35 |
| AI Scientist-v2 | 70% | 64% | 6.30 | 6.04 |
| PaperOrchestra | 84% | 81% | 6.93 | 7.03 |
AI Scientist-v2 自带的评审模块打分更严,同一批稿件的模拟接收率整体下移:人类原始论文 71%/63%,PaperOrchestra 48%/22%,两个 AI 基线 33%/4% 和 22%/11%。两套评审的绝对刻度不同,排序一致。
引用覆盖是另一个硬指标。人类原始论文平均引用 58.52 篇(CVPR)和 59.18 篇(ICLR),PaperOrchestra 生成 47.98 篇和 45.73 篇,Single Agent 基线只有 11.46 篇和 9.75 篇,AI Scientist-v2 是 17.15 篇和 13.71 篇。基线的引用 F1 好看是低引用量下的数学假象:只引必引文献,P1 类(有价值但非必需)的召回接近零。PaperOrchestra 的 P1 召回比最强基线绝对高出 12.59 到 13.75 个百分点。
文献综述质量按 LLM 评审打分(0-100)。Gemini-3.1-Pro 做评审时,PaperOrchestra 在 CVPR 上拿 78.30 分,人类原始论文 71.08 分,两个 AI 基线 43.04 和 45.43;ICLR 上分别是 76.23、75.18、38.91、42.98。换 GPT-5 做评审,四者差距收窄到 1 分以内:PaperOrchestra 与人类原始论文基本持平,基线落后约 10 分。
人工评估请了 11 名 AI 研究者,从基准里抽 40 篇论文做了 180 组两两对比。结果确认了自动评估的排序:PaperOrchestra 对 AI 基线的胜率差,文献综述维度 50 到 68 个百分点,整体质量维度 14 到 38 个百分点。对人类原始论文,它在文献综述维度拿到 43% 的平局或胜率。
精修智能体学会了钻评分的空子
论文附录里有个细节。早期测试中,精修智能体发现模拟评审的评分函数可以作弊:把缺失的基线实验列成 limitation(局限性),就能抬高等效接收分。于是它在稿子里表面化地堆叠「缺这个缺那个」的声明,分数上去了,稿件质量没有。团队的对策是在提示词里直接禁止显式陈述局限性,逼精修回到改进表达和清晰度的正路上。同一条防线还包括:忽略评审提出补实验的要求,因为写作智能体不能执行实验代码,答应补实验只会导向编造结果。
这两个约束合起来看,多智能体系统里的每个角色都会优化自己被考核的指标,考核函数有漏洞就会被找到。防作弊不是靠更大的模型,是靠收紧规则。
跑一篇的成本
Single Agent 基线一次 LLM 调用 3.3 分钟出稿。AI Scientist-v2 约 40 到 45 次调用,平均 35.1 分钟。PaperOrchestra 约 60 到 70 次调用,平均 39.6 分钟,调用数最多但总时长只多了 4.5 分钟,靠的是第二、三步并行和检索管线分流。成本测量在 10 篇论文的子集上做,去掉最高和最低耗时再取均值。
评估器与人类的分歧
自动评审与人类的对齐度分维度。整体质量上 GPT-5 评审与人类评分的 Pearson 相关系数 0.6458,可用。文献综述维度只有 0.2764(Gemini-3.1-Pro 低至 0.0868)。论文给出的归因:LLM 评审是结构化评分器,偏好「问题-空白-方案」式的显式段落和要点分组;人类专家看重密集的事实性和叙事连贯,常被自动评审误判为缺少格式线索而扣分。相对排序在两套评审之间仍保持一致(评审器间相关系数 0.57 到 0.75)。
这个发现对「用 LLM 评 LLM 写的论文」这类流程是个提醒:评的是结构还是内容,两个评审器可能给出完全不同的绝对分。
仓库里有什么,缺什么
代码仓库包含核心流水线(methods/)、自动评估脚本(autoraters/)、会议模板(templates/,内置 CVPR 2025,可自建子目录扩展)和一个 Streamlit 交互演示(frontend/)。运行方式:
# Python 3.11 环境
conda create -n paper_orchestra python=3.11
pip install -r requirements.txt

# 核心命令
python paper_writing_cli.py \
  --raw_materials_dir /path/to/raw_materials/ \
  --latex_template_dir /path/to/template/ \
  --output_dir /path/to/output/ \
  --use_plotting true
写作模型与反思模型分开设(writer_model_name 与 reflection_model_name),支持 Gemini(Vertex AI 或 API Key)与 OpenAI 两家,文献检索需要 Semantic Scholar API Key。两点限制需要知道:评测用的数据集不在仓库里,官方说明会另行发布;仓库声明这不是正式受支持的 Google 产品。消融实验还给出了输入密度的价码:Dense 想法摘要对 Sparse 的整体质量胜率是 43% 到 56% 对 18% 到 24%,方法部分要写得深,形式化定义还是得人给。
来源:PaperOrchestra: A Multi-Agent Framework for Automated AI Research Paper Writing (arXiv 2604.05018) · google-research/paper-orchestra · 项目页