把同一个应用交给 Claude Opus 5.5,让它分别用 12 个 JavaScript 框架构建,每个框架跑五次取中位数,每跑一次都按同一份规格说明做一致性验收,最后按 API 报价算账。这是 Socket 工程师、前 Microsoft Edge 团队成员 Nolan Lawson 10 月 28 日在个人博客发布的基准测试。它给「AI 编程时代怎么选前端框架」这件事补上了长期缺位的证据层:单次构建成本从 Hono+htmx 的 2.67 美元到 Angular 的 4.97 美元,相差 86%;耗时从 Astro 的 8.2 分钟到 Angular 的 17.2 分钟;token 消耗从 Nuxt 的 385 万到 Angular 的 976 万。
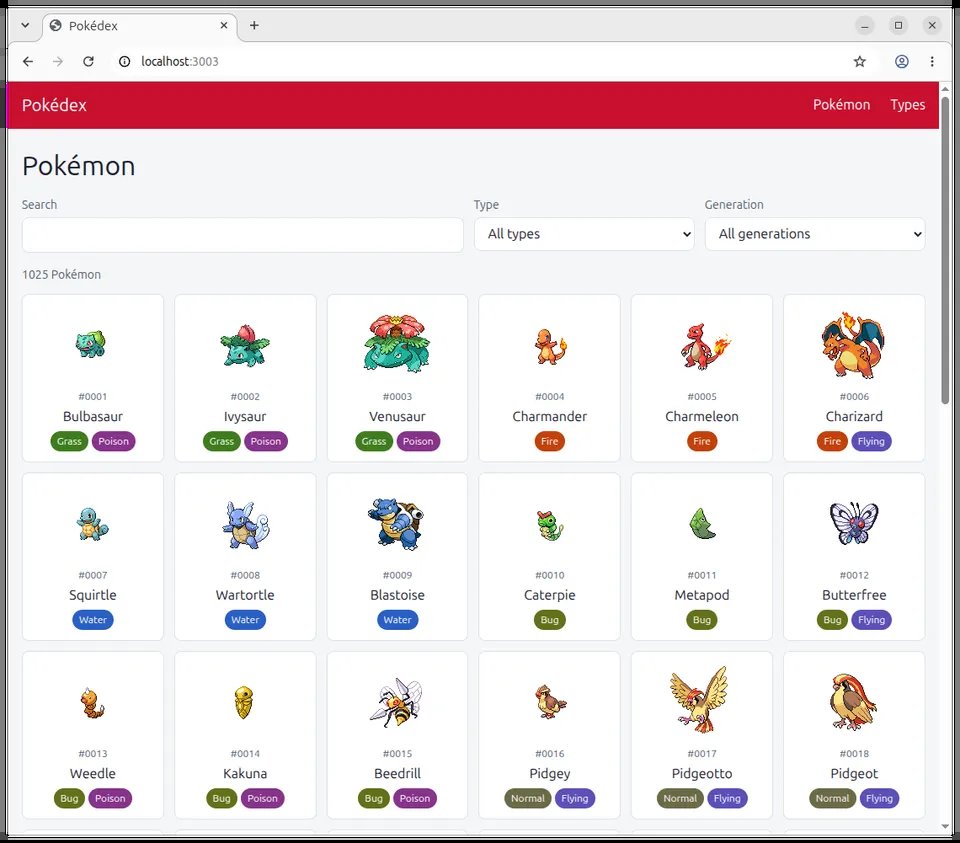
测试应用是一个 Pokémon 图鉴:精灵列表、类型筛选、招式与各世代数据,数据源是 PokéAPI。应用本身偏内容展示,交互不重,Lawson 在文中多次强调它只代表一种应用形态,复杂仪表盘或游戏类应用会得出不同的结论。
防作弊的基准设计
这个基准最容易翻车的地方在于「agent 偷懒作弊」,Lawson 为此做了几层约束。
验收不靠肉眼,靠一套基于无障碍树(accessibility tree)的规格一致性测试套件,不检查 DOM 结构,只检查行为是否符合规格;CSS 方法不限定,但禁用 Tailwind、Bootstrap 等组件框架,视觉一致性靠规格里给出的设计 token 保证。每个框架尽量配上官方的 MCP 或 skills,避免「训练数据里没这个框架所以吃亏」的指责。agent 在沙箱里运行,事前不知道产物会被 Lighthouse 测性能和可访问性。还有一条明确的禁令:不许把所有 HTML 预生成为静态文件来骗高分,测试套件里有对应检查。
所有跑分用 Claude Opus 5.5 的 high effort 档位,框架取当时最新版本:Next.js 16.4.3、Angular 22.2.3、Astro 7.4.2、Nuxt 4.6.2、SvelteKit 3.1.0、React Router 8.5.0、Qwik City 1.20.3、SolidStart 2.1.0、TanStack Start 1.169.4,外加 Hono+htmx、Gracile+Lit 和一个只用 Vite 不用框架的 Vanilla 组。Angular 有两次运行产出了拒绝非 localhost 请求的 SSR 应用,Lawson 将其计为有效失败,该组只取三次成功样本。
对随机性,Lawson 的处理方式是多轮取中位数并如实报告区间:LLM 有时一次跑偏去读无关文档,Lighthouse 自己的 LCP 判定也会在两次运行中挑不同的最大元素,所以每个数字都带五次运行的最小最大区间,性能与可访问性分数只报首页一页(其余页面走势相近或波动过大)。
构建成本:最省 2.67 美元,最贵 4.97 美元
成本按 Claude Code 报出的 API 价格计算。Lawson 自己用的是每月 100 美元的 Max 订阅,这笔钱没有真花,但相对差异成立。
| 框架 | 单次成本(美元) | 五次区间 |
|---|---|---|
| Hono+htmx | 2.67 | 2.23–3.19 |
| Astro | 2.76 | 2.16–3.63 |
| Nuxt | 2.82 | 2.39–4.25 |
| Vanilla(仅 Vite) | 2.98 | 2.24–3.37 |
| Next.js | 3.14 | 2.58–4.13 |
| Qwik | 3.27 | 2.35–3.80 |
| TanStack Start | 3.54 | 3.11–3.96 |
| SolidStart | 3.79 | 2.84–4.81 |
| React Router | 3.81 | 2.82–3.97 |
| SvelteKit | 4.28 | 3.59–4.65 |
| Gracile+Lit | 4.65 | 3.92–5.07 |
| Angular | 4.97 | 3.19–6.82 |
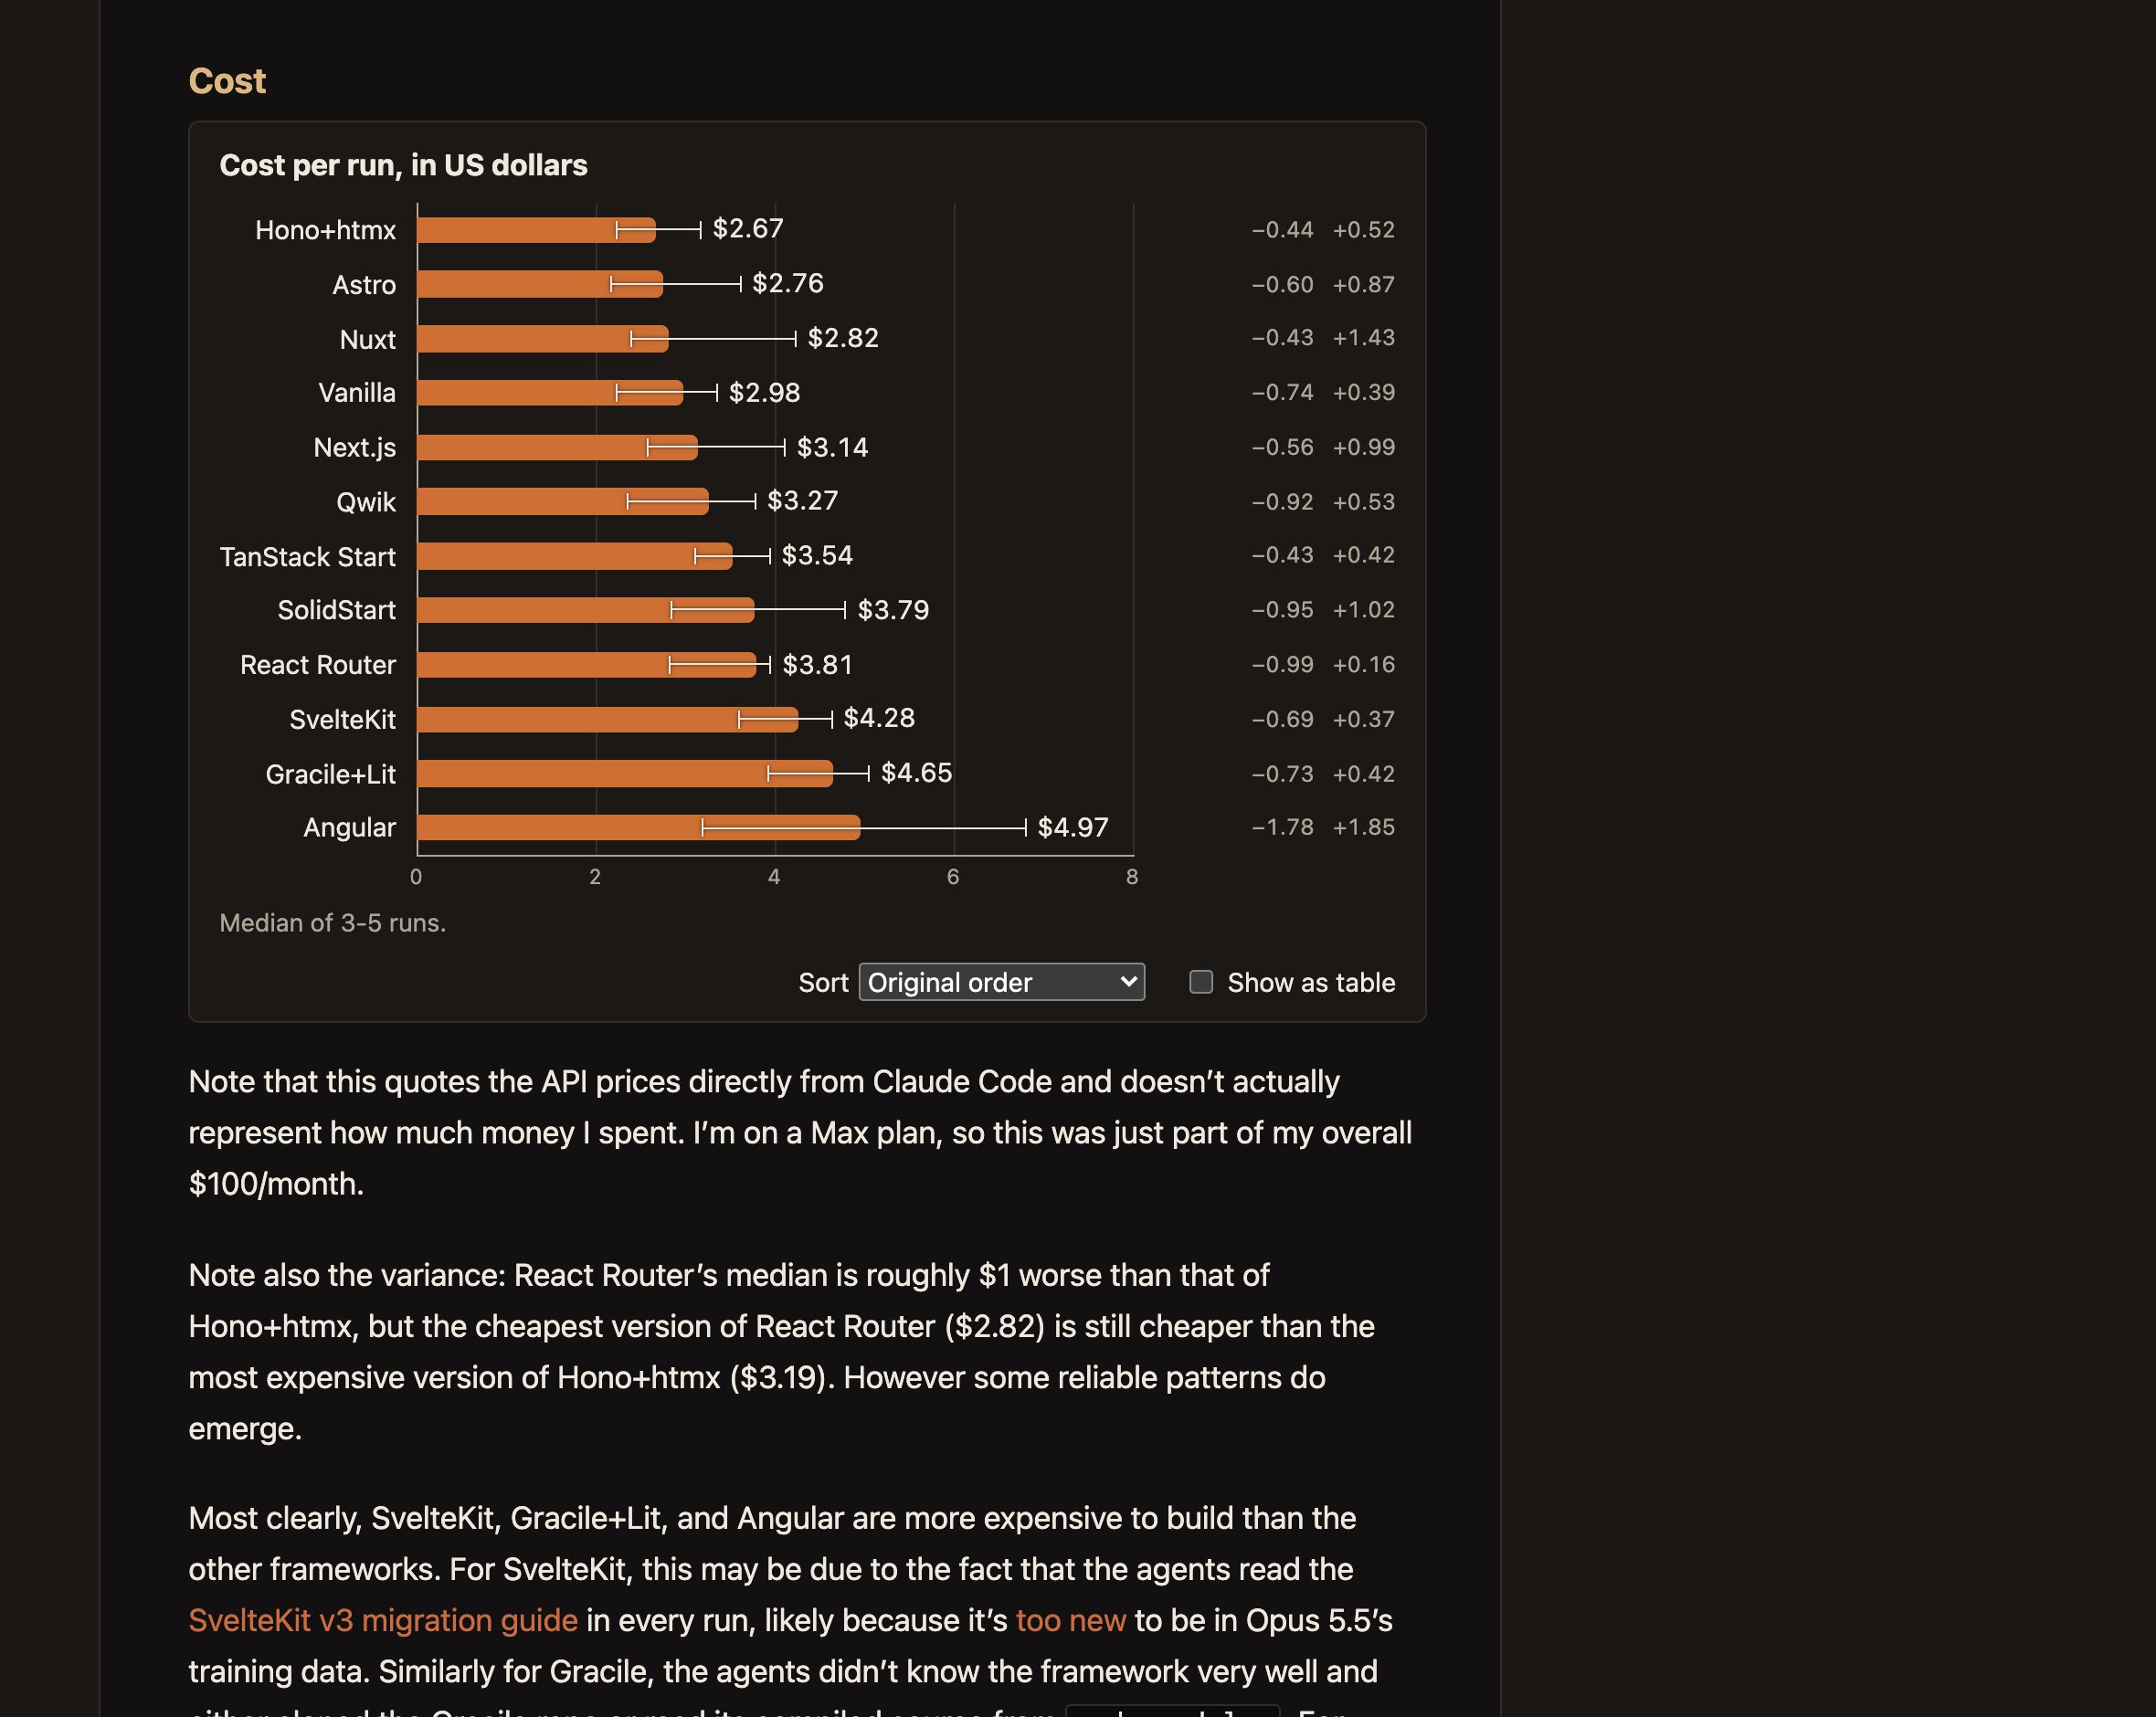
方差大到需要单独说明:React Router 的中位数比 Hono+htmx 贵约 1 美元,但 React Router 最便宜的一次(2.82 美元)低于 Hono+htmx 最贵的一次(3.19 美元)。LLM 本身是随机的,偶尔一次跑偏去读一堆无关文档,成本就上去了。剔除噪声后仍然稳定的结论是三个:SvelteKit、Gracile+Lit、Angular 的构建成本系统性地高于其余九个。
时间与 token 同步放大
成本差异的来源可以直接看时间和 token 两列,三者排序基本一致。
| 框架 | 耗时(分钟) | token 消耗(百万) |
|---|---|---|
| Astro | 8.2 | 4.13 |
| Hono+htmx | 8.6 | 4.26 |
| Nuxt | 9.0 | 3.85 |
| Vanilla(仅 Vite) | 10.1 | 5.00 |
| TanStack Start | 10.3 | 7.07 |
| Qwik | 10.7 | 5.64 |
| SvelteKit | 10.8 | 8.53 |
| Next.js | 10.9 | 4.99 |
| SolidStart | 11.2 | 7.13 |
| Gracile+Lit | 12.1 | 9.04 |
| React Router | 12.5 | 7.58 |
| Angular | 17.2 | 9.76 |
Angular 单次中位 17.2 分钟,最慢一次跑进 23.7 分钟,是 Astro 的两倍还多。token 列里 Vanilla 组是另一处反直觉数据:不给框架、只给 Vite,agent 五次运行全部自建了 SPA 结构,消耗 500 万 token,高于 Nuxt、Astro、Hono+htmx、Next.js 四个框架组。对 agent 来说,一个现成的框架比从零搭结构更省 token。
质量分数拉满,差距藏在字节与阻塞里
Lighthouse 的 Performance、Accessibility、CLS 三项几乎饱和:Accessibility 十二个组全部 100 分,Performance 最低 97(Vanilla),CLS 除 Vanilla 的 0.111 外全部 0.000。AI 生成的前端在可访问性上已经不挑框架。
Astro 产物零 JS 字节,Next.js 传输 142 KiB;总阻塞时间 Astro 为 0,Angular 为 103 ms;LCP Astro 810 ms,Next.js 2090 ms。Core Web Vitals 对 SPA 有系统性偏严是已知问题,Lawson 在文中如实标注了这一点。Qwik 是表格里的例外:它用客户端路由,是标准 SPA,但三项指标都落在 MPA 阵营一侧,正对应它的 Resumable 设计目标。
| 框架 | JS 传输量(KiB) | TBT(ms) | LCP(ms) |
|---|---|---|---|
| Astro | 0 | 0 | 810 |
| Vanilla(仅 Vite) | 7 | 0 | 1667 |
| Gracile+Lit | 8 | 0 | 956 |
| Hono+htmx | 18 | 0 | 978 |
| SvelteKit | 36 | 0 | 1130 |
| SolidStart | 40 | 11 | 1204 |
| Qwik | 40 | 3 | 979 |
| Nuxt | 84 | 40 | 1727 |
| Angular | 93 | 103 | 1954 |
| React Router | 115 | 17 | 1729 |
| TanStack Start | 118 | 1 | 2028 |
| Next.js | 142 | 71 | 2090 |
Astro 产物零 JS 字节,Next.js 传输 142 KiB;总阻塞时间 Astro 为 0,Angular 为 103 ms;LCP Astro 810 ms,Next.js 2090 ms。Core Web Vitals 对 SPA 有系统性偏严是已知问题,Lawson 在文中如实标注了这一点。Qwik 是表格里的例外:它用客户端路由,是标准 SPA,但三项指标都落在 MPA 阵营一侧,正对应它的 Resumable 设计目标。
代码行数连着未来的维护账单
可维护性维度,Lawson 选了最朴素的指标:非空源码行数。
| 框架 | 代码行数 |
|---|---|
| Hono+htmx | 1370 |
| Nuxt | 1415 |
| Astro | 1461 |
| Vanilla(仅 Vite) | 1492 |
| Next.js | 1539 |
| React Router | 1564 |
| SvelteKit | 1611 |
| SolidStart | 1630 |
| TanStack Start | 1697 |
| Gracile+Lit | 1717 |
| Qwik | 1744 |
| Angular | 2009 |
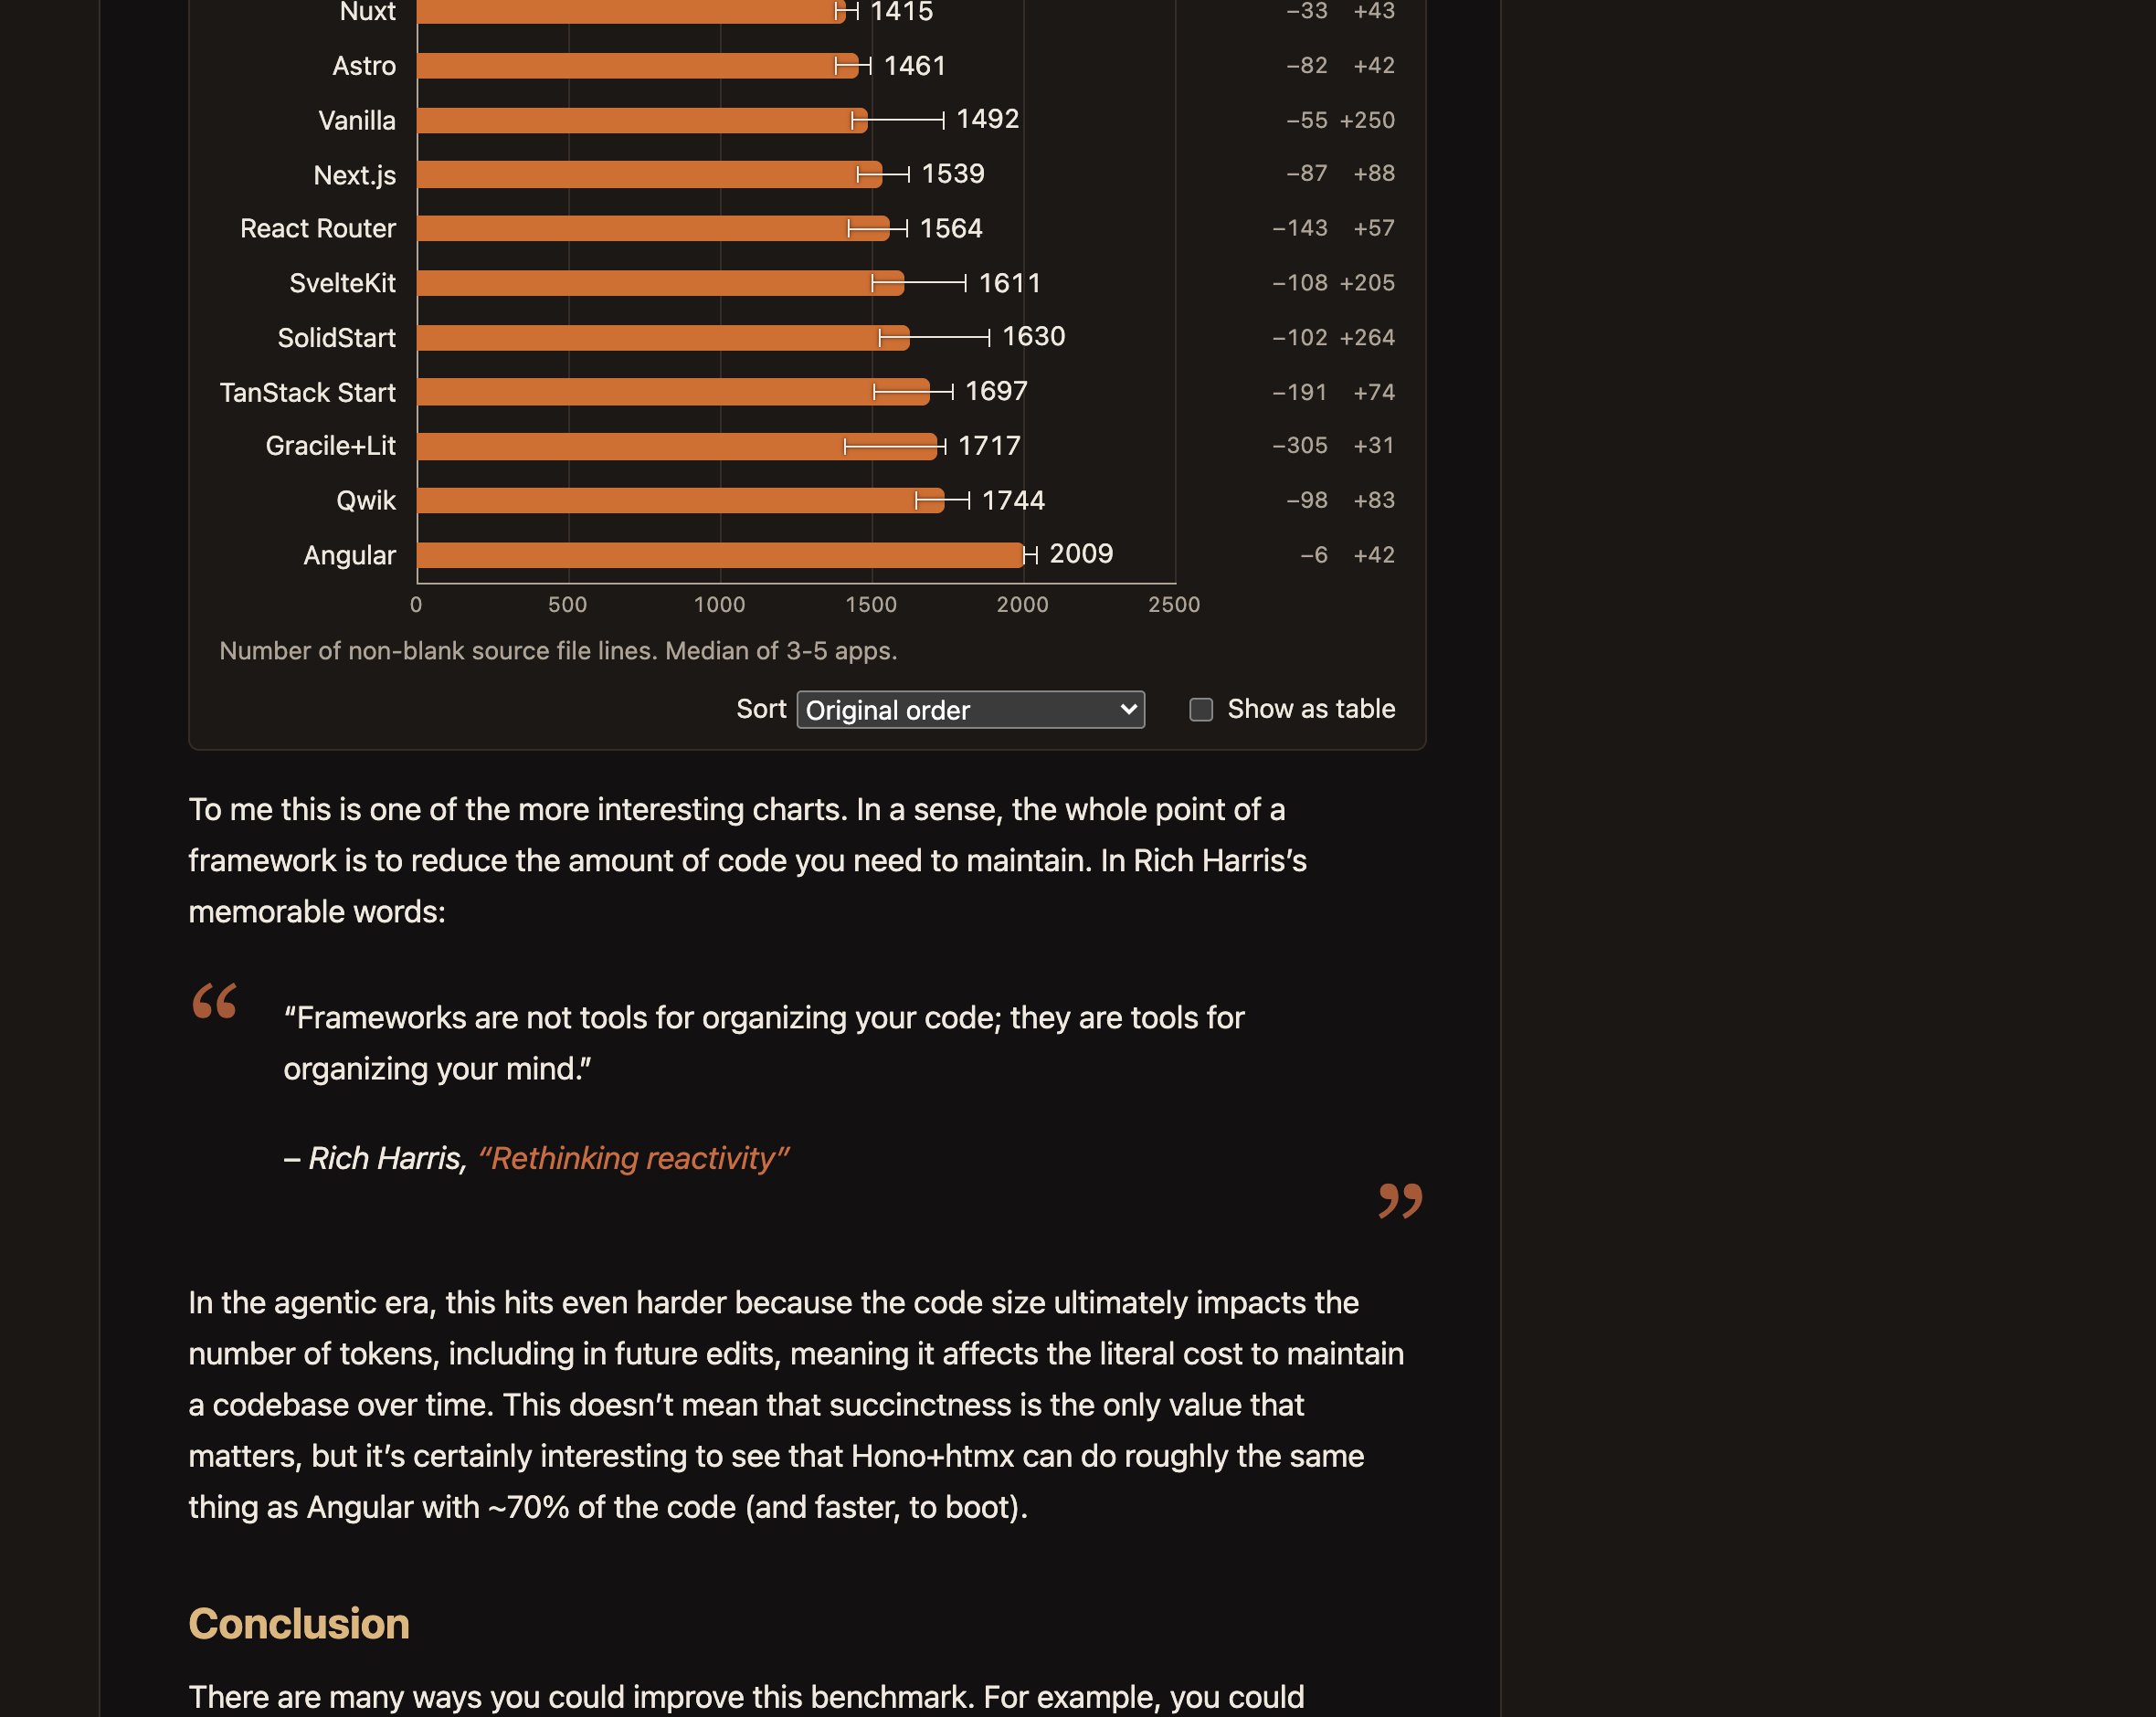
Hono+htmx 用大约 Angular 七成的代码实现了同一份规格,构建还更快。Rich Harris 在「Rethinking reactivity」演讲里说框架真正组织的是人的思维,代码只是外显;到了 agent 写代码的阶段,这层关系变得更直接:代码量进入上下文窗口,之后每一次修改、每一次 review 的 token 成本都跟它挂钩,行数原本只是风格偏好,现在直接决定后续账单。
训练数据新鲜度成了隐藏变量
为什么 SvelteKit、Gracile+Lit 明显更贵?Lawson 给出的归因都落在训练数据上。SvelteKit 组的 agent 每次运行都会去读 SvelteKit v3 迁移指南,因为 v3 太新,不在 Opus 5.5 的训练数据里;Gracile 更冷门,agent 干脆去 clone 仓库或者读 node_modules 里的编译产物。框架越新或越小众,agent 需要现场补的课越多,token 就烧得越多。Angular 的成本则与它最大的代码量直接相关。
MCP 与 skills 的使用情况参差:Nuxt 的 MCP 一次都没被 agent 用上,TanStack Start 的 skill 文件五次里只被发现两次,React Router 的 skill 五次全用。Lawson 对这批官方 MCP 和 skills 的评价偏向负面,怀疑它们当前版本帮倒忙多于帮忙。
边界与可复现性
这份基准的边界在文中写得清楚:单一应用形态、内容型站点,换成仪表盘或游戏结论会变;Lighthouse 偏向 MPA,量应用内交互会得到另一套排序;模型只用了 Opus 5.5 一档,换 agent、换 effort、换框架版本都是开放的实验变量。基准代码和全部运行结果分别放在 nolanlawson/agent-framework-benchmark 与 agent-framework-benchmark-results 两个仓库,58 次运行(11 个框架各 5 次加 Angular 3 次)的每次请求、每次产物代码与 Lighthouse 原始报告都可以逐条核对,批号为 20261026。Lawson 同时欢迎各框架作者改进自己的 AI 工具链后重新参战。
来源:The AI cost of JavaScript frameworks(Nolan Lawson) · Hacker News 讨论 · 基准仓库 agent-framework-benchmark