10 月 29 日晚,Mistral AI 把旗舰模型 Mistral Large 4 的完整权重放上了 Hugging Face。内部代号 Le Chonk 的这个模型 10 月上旬以公开预览形式上线 API,三周后权重直接开放:BF16 全量权重和 NVFP4 量化权重同时可下载,vLLM、SGLang、llama.cpp 三条部署路径同步就位。API 定价一并公布,每百万 token 输入 0.7 美元、缓存输入 0.07 美元、输出 2.1 美元。
架构与投机解码
按官方 model card,Mistral Large 4 总参数约 1T,每个 token 路由激活 490 亿,算上嵌入层和输出层 520 亿。128 个路由专家里每个 token 选 4 个,再加 1 个所有 token 共享的专家。上下文窗口 1M token,推荐采样参数 temperature 1.0、top_p 0.95。
多模态输入走 Pixtral 风格的视觉编码器,可变分辨率、任意宽高比,输入文本加图像、输出文本。视觉定位(visual grounding)能力官方列为开源第一,并称超过闭源前沿模型。训练在 Mistral 欧洲自建机房完成,3800 块 NVIDIA Grace Blackwell GPU 从头训练,语言覆盖 160+ 种、含欧盟全部官方语言。
权重包里有个少见配置:内置 DSpark 投机解码草稿头。3 层 BF16 稠密 MLA 草稿层加循环 Markov 头,每次给目标模型提 3 个 token 的草稿块。vLLM 加一个启动参数就能启用,实测最高 1.9 倍吞吐,输出分布与目标模型完全一致,无损。SGLang 官方部署示例把并发参数 max-running-requests 钉在 64,去掉该参数回退到 48。
编码:FrontierCode 第一,token 少用 47%
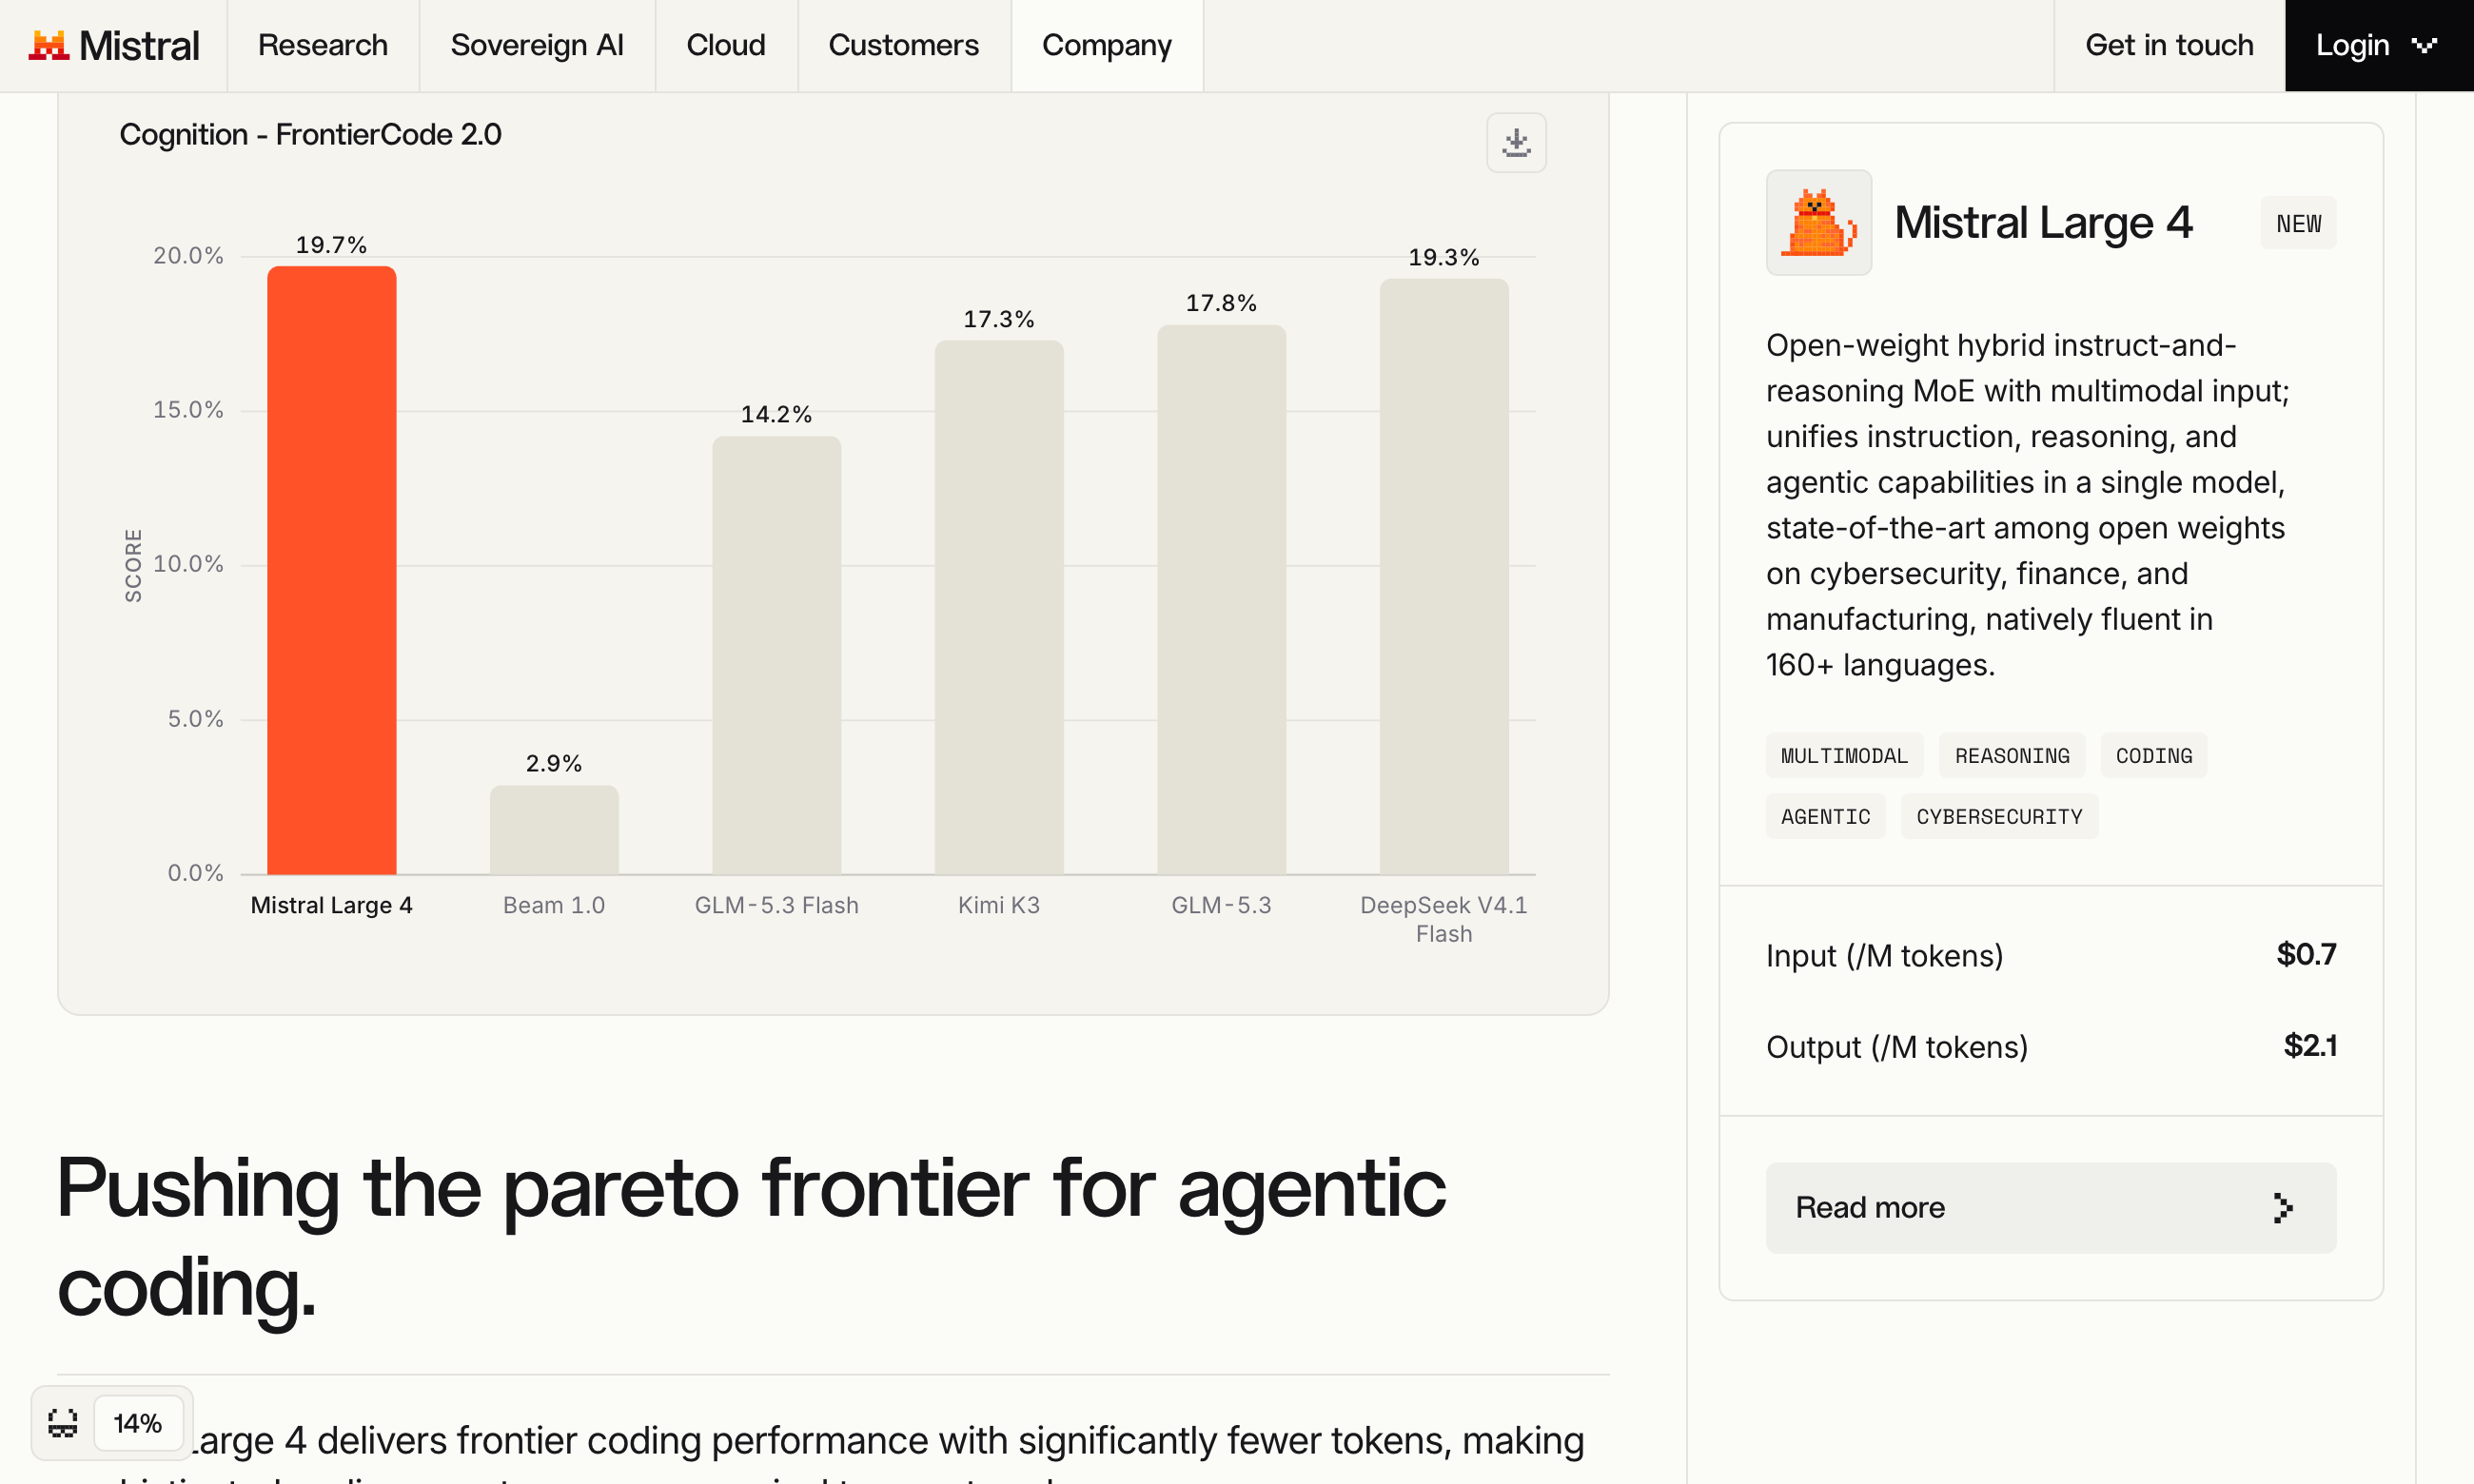
Cognition 的私有基准 FrontierCode 2.0 评端到端代码质量,标准之一是仓库维护者愿不愿意合并智能体提交的修改。Mistral Large 4 拿了 19.7%,排在同图开源模型最前:
| 模型 | FrontierCode 2.0 |
|---|---|
| Mistral Large 4 | 19.7% |
| DeepSeek V4.1 Flash 1017 | 19.3% |
| GLM-5.3 | 17.8% |
| Kimi K3 | 17.3% |
| GLM-5.3 Flash | 14.2% |
| Beam 1.0 | 2.9% |
Artificial Analysis 的 Coding Agent Index 是另一回事:Mistral Large 4 得分 48%,与开源第一 GLM-5.3 打平,但平均每个任务少用 47% 的 token。散点图读数如下:
| 模型 | 得分 | 每任务 token |
|---|---|---|
| GLM-5.3 | 49 | 约 1580 万 |
| Mistral Large 4(高档推理) | 48 | 约 890 万 |
| DeepSeek V4.1 Flash 1017 | 46 | 约 1630 万 |
| Kimi K3 | 41 | 约 820 万 |
| Muse Spark Open(xhigh 档) | 26 | 约 1250 万 |
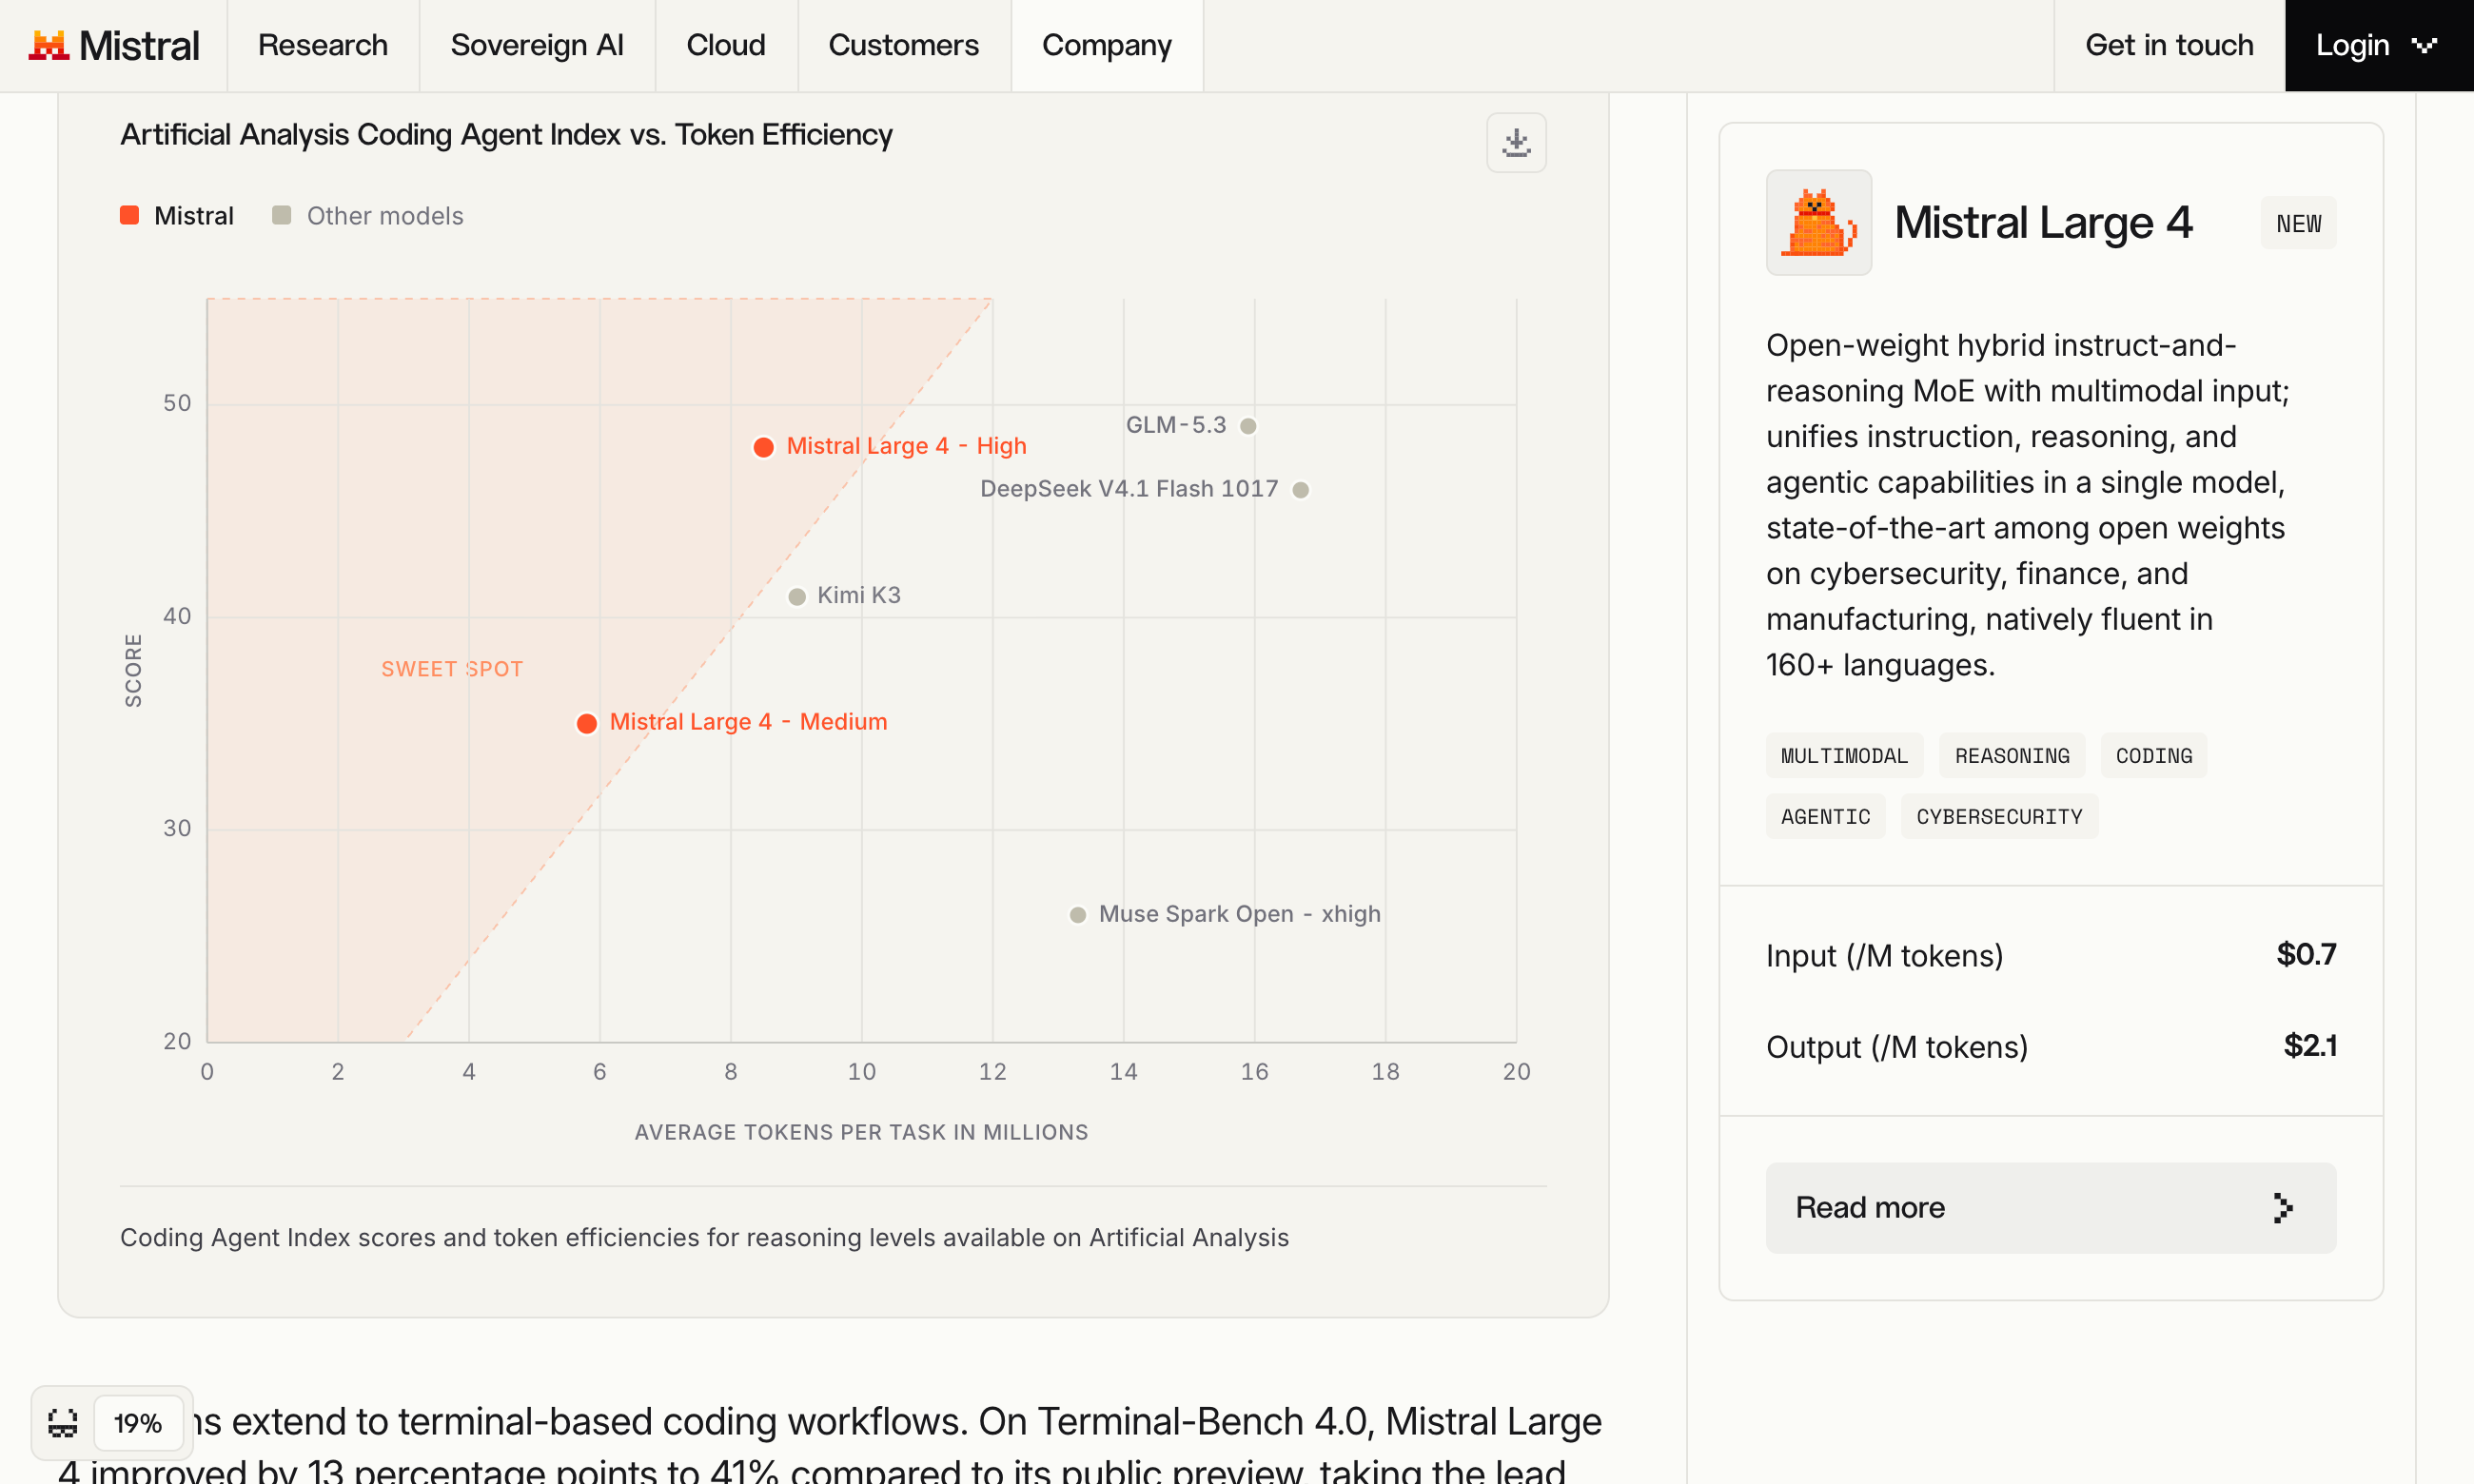
这 47% 直接落到账单上。agent 负载的输出 token 通常占账单大头,输出定价每百万 2.1 美元,token 少用近一半,推理成本就近乎砍半。模型分 low、medium、high 三档推理力度(默认 high),对话类任务可以降到低档换响应速度。
终端基准 Terminal-Bench 4.0 从预览版 28% 涨到 41%,输出 token 减少 30%。Surge Code 盲测成对评估里,评测者对它的偏好超过 GLM-5.3、Kimi K3 与 DeepSeek V4.1 Flash,参评模型中只排在 Claude Opus 5.5 后面。
安全:Cyber Index 51 分,拒答率 96.6%
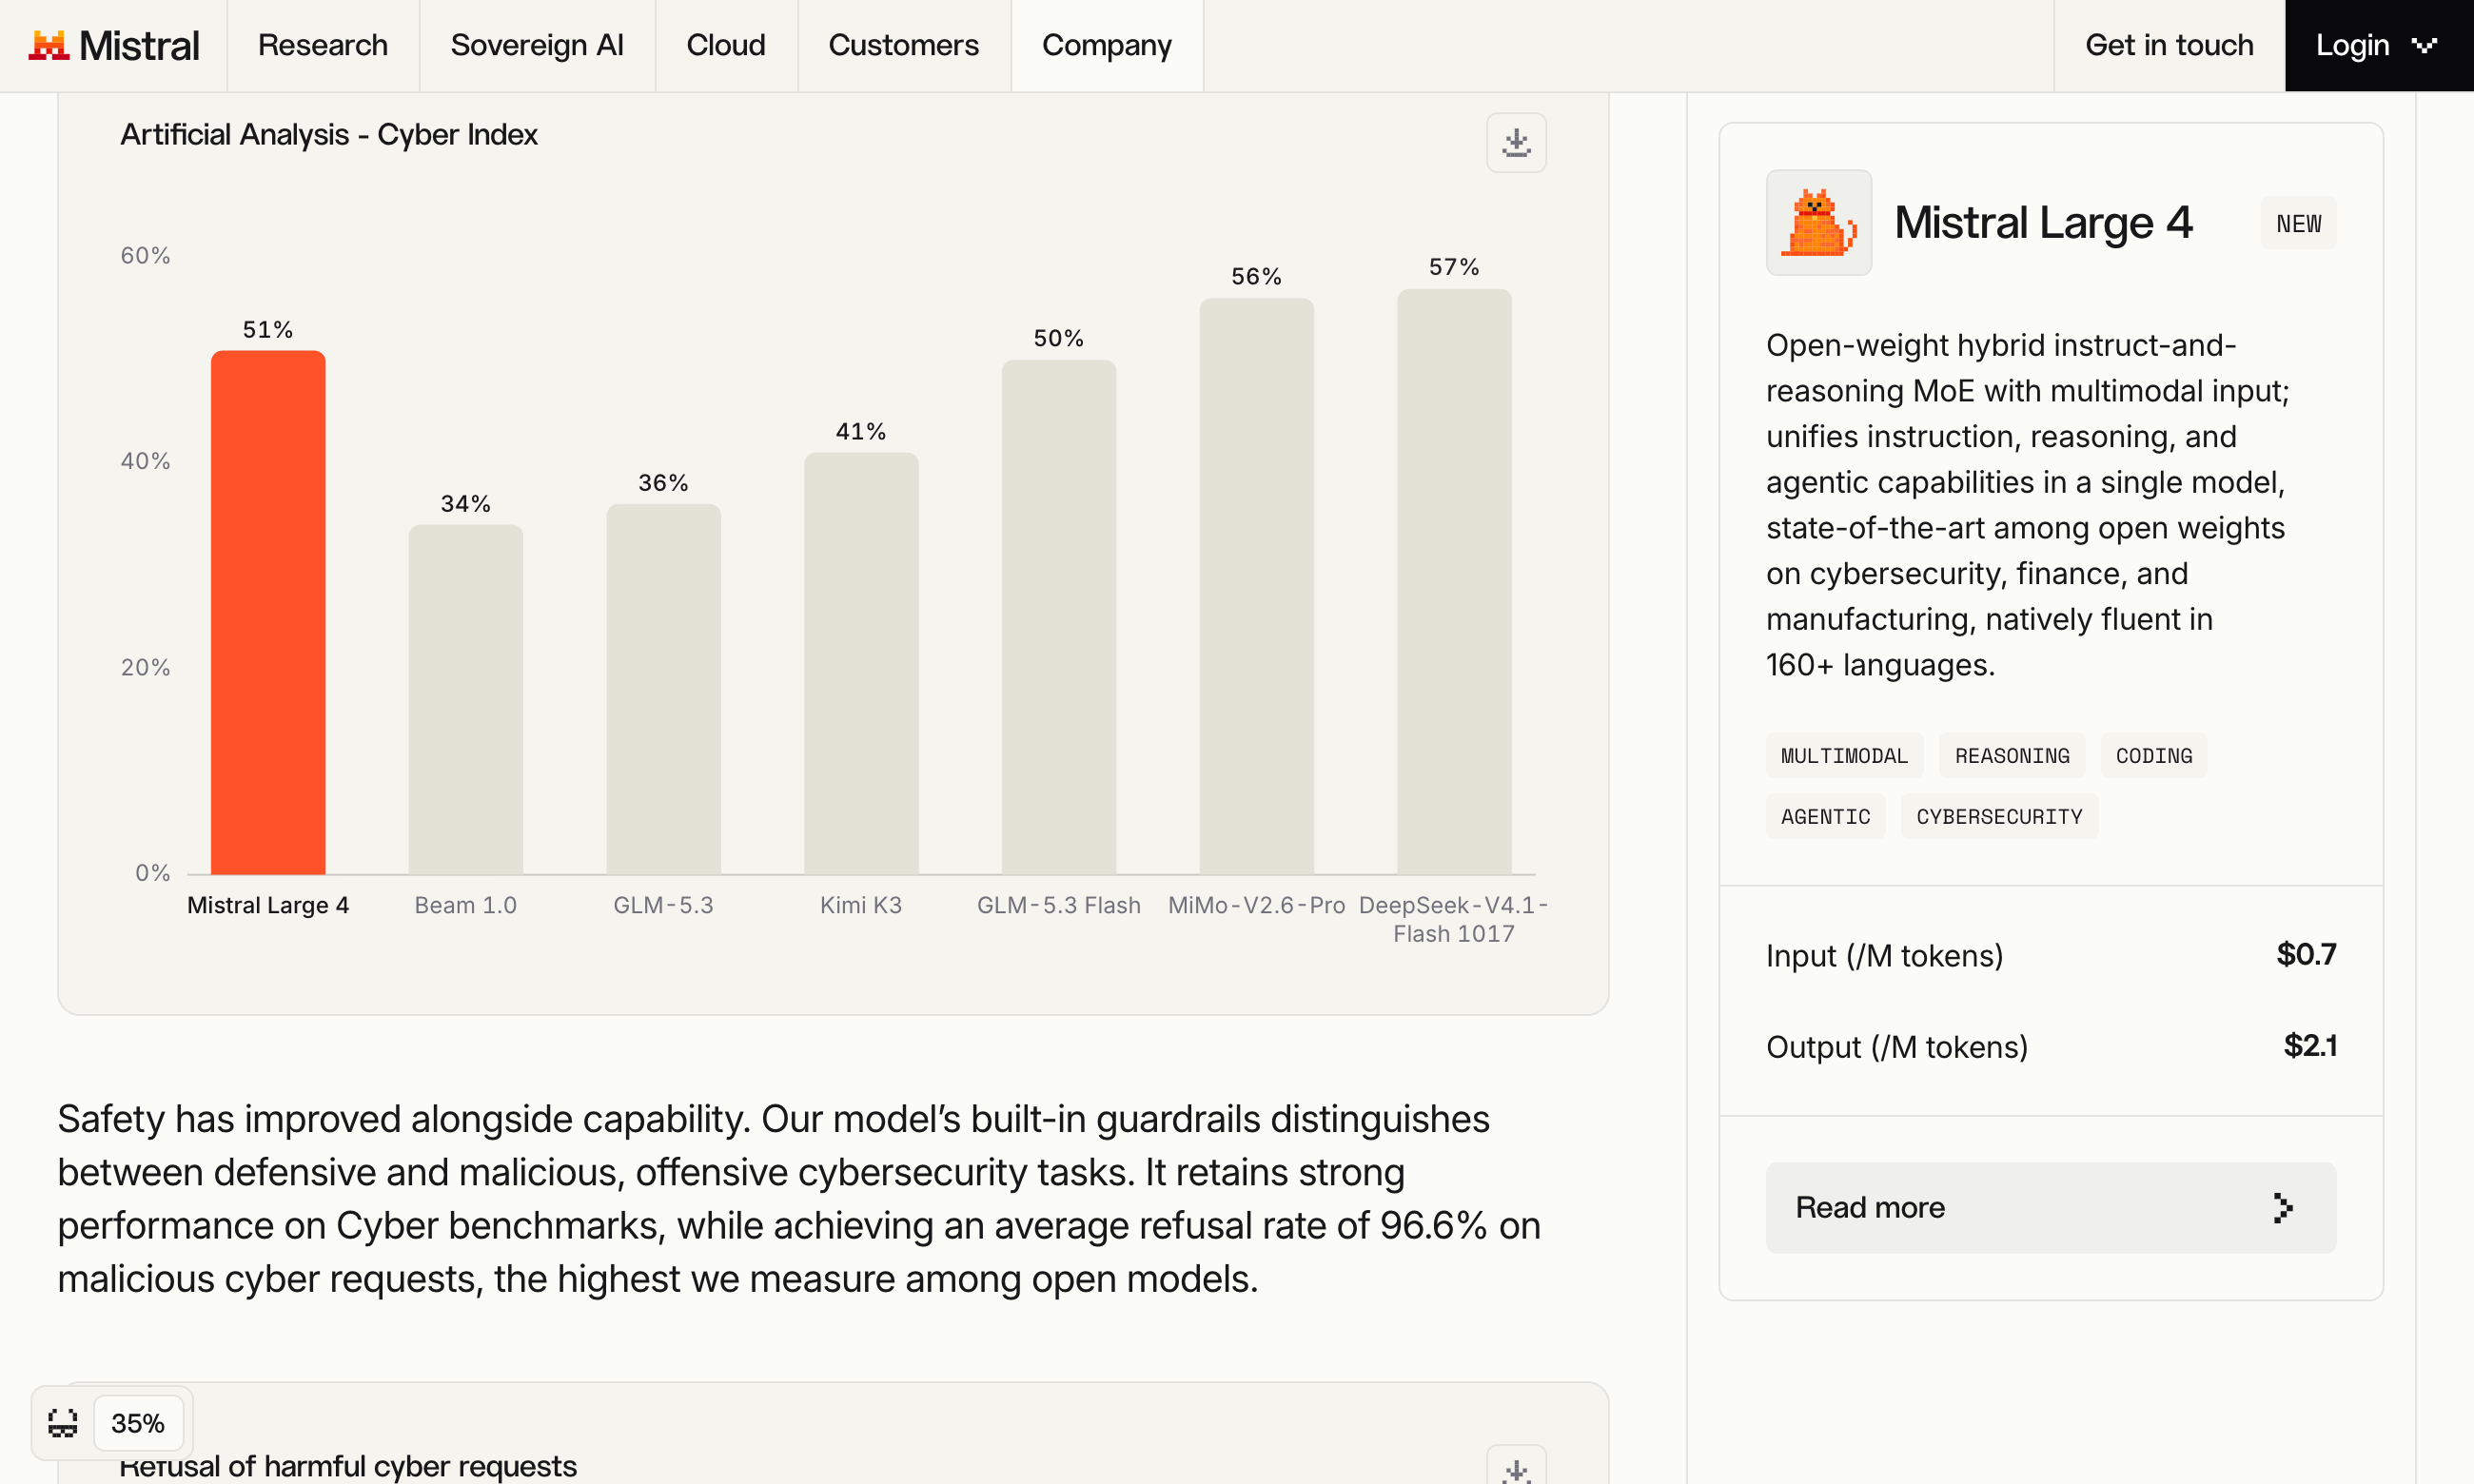
Artificial Analysis Cyber Index 衡量模型在代码库里找漏洞、复现验证、写补丁且不破坏现有功能的综合能力。这张榜 Mistral Large 4 排在两个中国模型后面:
| 模型 | Cyber Index |
|---|---|
| DeepSeek V4.1 Flash 1017 | 57% |
| MiMo-V2.6-Pro | 56% |
| Mistral Large 4 | 51% |
| GLM-5.3 Flash | 50% |
| Kimi K3 | 41% |
| GLM-5.3 | 36% |
| Beam 1.0 | 34% |
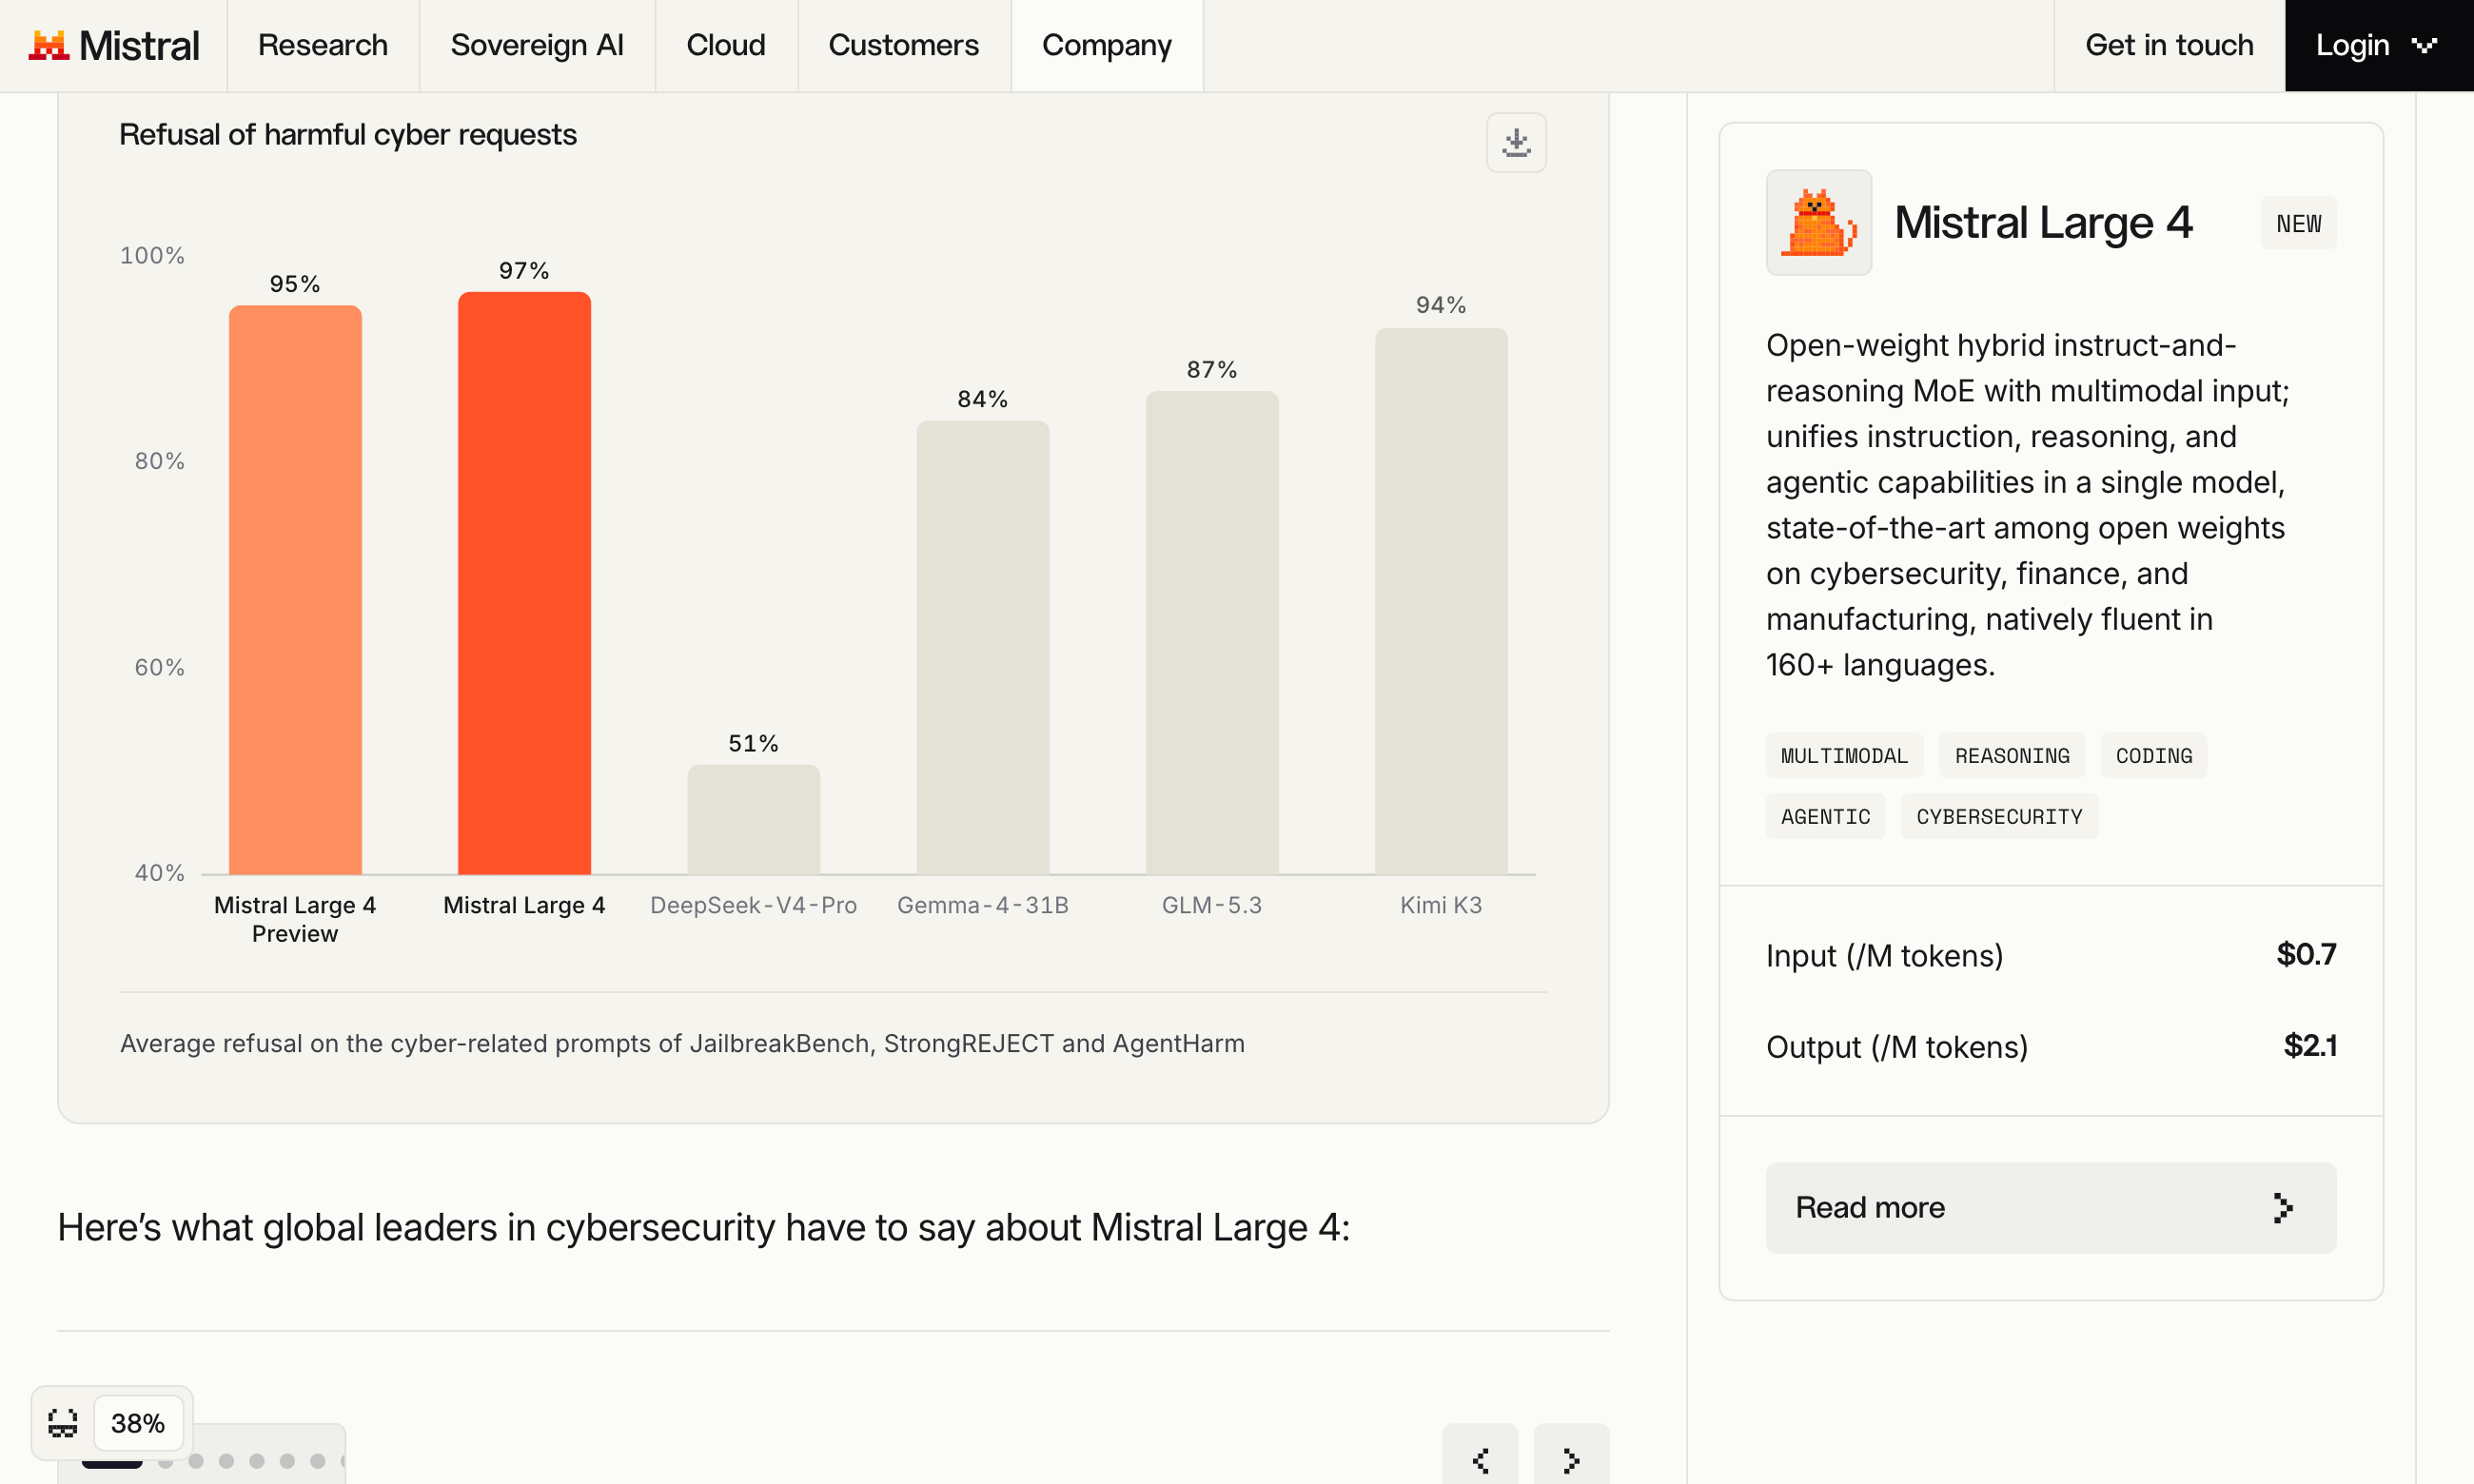
拒答率是另一头。JailbreakBench、StrongREJECT、AgentHarm 三个数据集的网络安全相关提示词上,平均拒答率 96.6%,为官方测得的开源模型最高(图表读数 97%;同图 Kimi K3 94%、GLM-5.3 87%、Gemma-4-31B 84%、DeepSeek-V4-Pro 51%,三周前的预览版 95%)。
这套组合是往安全市场站位的:做漏洞复现、补丁生成时不多余拒绝,遇到恶意请求高比例拒绝。Booz Allen、CrowdStrike、Cisco、Cloudflare、Elastic、ENISA、Fortinet 等安全机构和厂商出现在公告背书名单里。B3 Agent Security Benchmark 的攻击抵抗率从预览版 93.3% 提到 97.1%。
边界也写明了:预览期线上流量监控显示模型会拒绝针对在线目标的黑盒攻击,但官方承认真实攻击方向存在能力增益空间,护栏随之调整。面向渗透测试、漏洞评估与红队的特化变体只对通过审查的设计伙伴开放,首个合作方 Orange Cyberdefense,使用限定在自有或获明确授权的系统与受控环境内。
金融、浏览、综合榜:中国模型仍在前面
金融工作流基准 FinWorkBench(Finch)得分 73.3%,开源模型中仅次于 Kimi K3。网页浏览基准 BrowseComp 从 SFT 检查点的 75% 涨到 84.5%,高于 GLM-5.3 与 DeepSeek Flash 4.1 1017。Artificial Analysis Intelligence Index v5 综合得分 26,是西方开源权重的最高值;开源综合榜首还在中国模型手里,GLM-5.3 与 DeepSeek V4.1 Flash 均为 32,MiMo-V2.6-Pro 为 30。
部署:从 1.1TB 到 223GB
BF16 全量权重约 1.1TB(FP8 口径)。官方推荐 vLLM(镜像 vllm/vllm-openai:mistral-large-4,8 卡张量并行起步),SGLang 镜像 lmsysorg/sglang:mistral-large-4 同步提供,transformers 可用 torchrun 跑 8 卡,llama.cpp 社区仓库有 GGUF。微调路径覆盖 Axolotl、Unsloth、TRL。NVFP4 量化面向 Blackwell GPU,官方称体积更小、推理更快、性能与全量持平。
Unsloth 发布当天拿到零时差访问,它的 GGUF 动态量化表给出了消费级门槛:1-bit 动态量化 223GB,保留 91% 的 top-1 精度;2-bit 378GB,保留 95%。按其硬件需求表,跑 1-bit 需要总内存(RAM+VRAM)256–270GB,一张 256GB 统一内存的 Mac Studio 或两台 DGX Spark 承载得住;2-bit 需 310–390GB,3-bit 需 435–500GB,4-bit 需 630GB,8-bit 需 1.2TB。
许可证、主权牌,和没发的技术报告
权重采用 Mistral Ecosystem Open-Weight License,一份修改版 MIT:使用、修改、微调、商用全自由,唯一附加条件是经营 Model-as-a-Service 业务需另行取得商业授权。发布当天 Hacker News 讨论帖 1087 分 316 条评论,吵得最集中的就是这份许可证算不算开放。权重确实能自由下载、自由自部署,但云厂商把它做成托管服务要额外授权,离 OSI 的开源定义有距离。
主权是公告里反复出现的词:欧洲机房从头训练、覆盖欧盟全部官方语言、La Banque Postale、ABN AMRO、Crédit Agricole、Belfius 等银行署名站台、Microsoft Foundry 首家云平台接入、ESA Φ-lab 看中视觉能力对地球观测数据的适用性。这个词落到实处指的是:模型可以被检查、微调、跑在自己的基础设施上,不必绑在 Mistral 的 API 上。
技术报告还没发。MoE 路由的实现细节、RL 管线的具体配置、训练数据构成,目前都没有公开文档,公告结尾只标了一句「完整技术报告即将发布」。
来源: