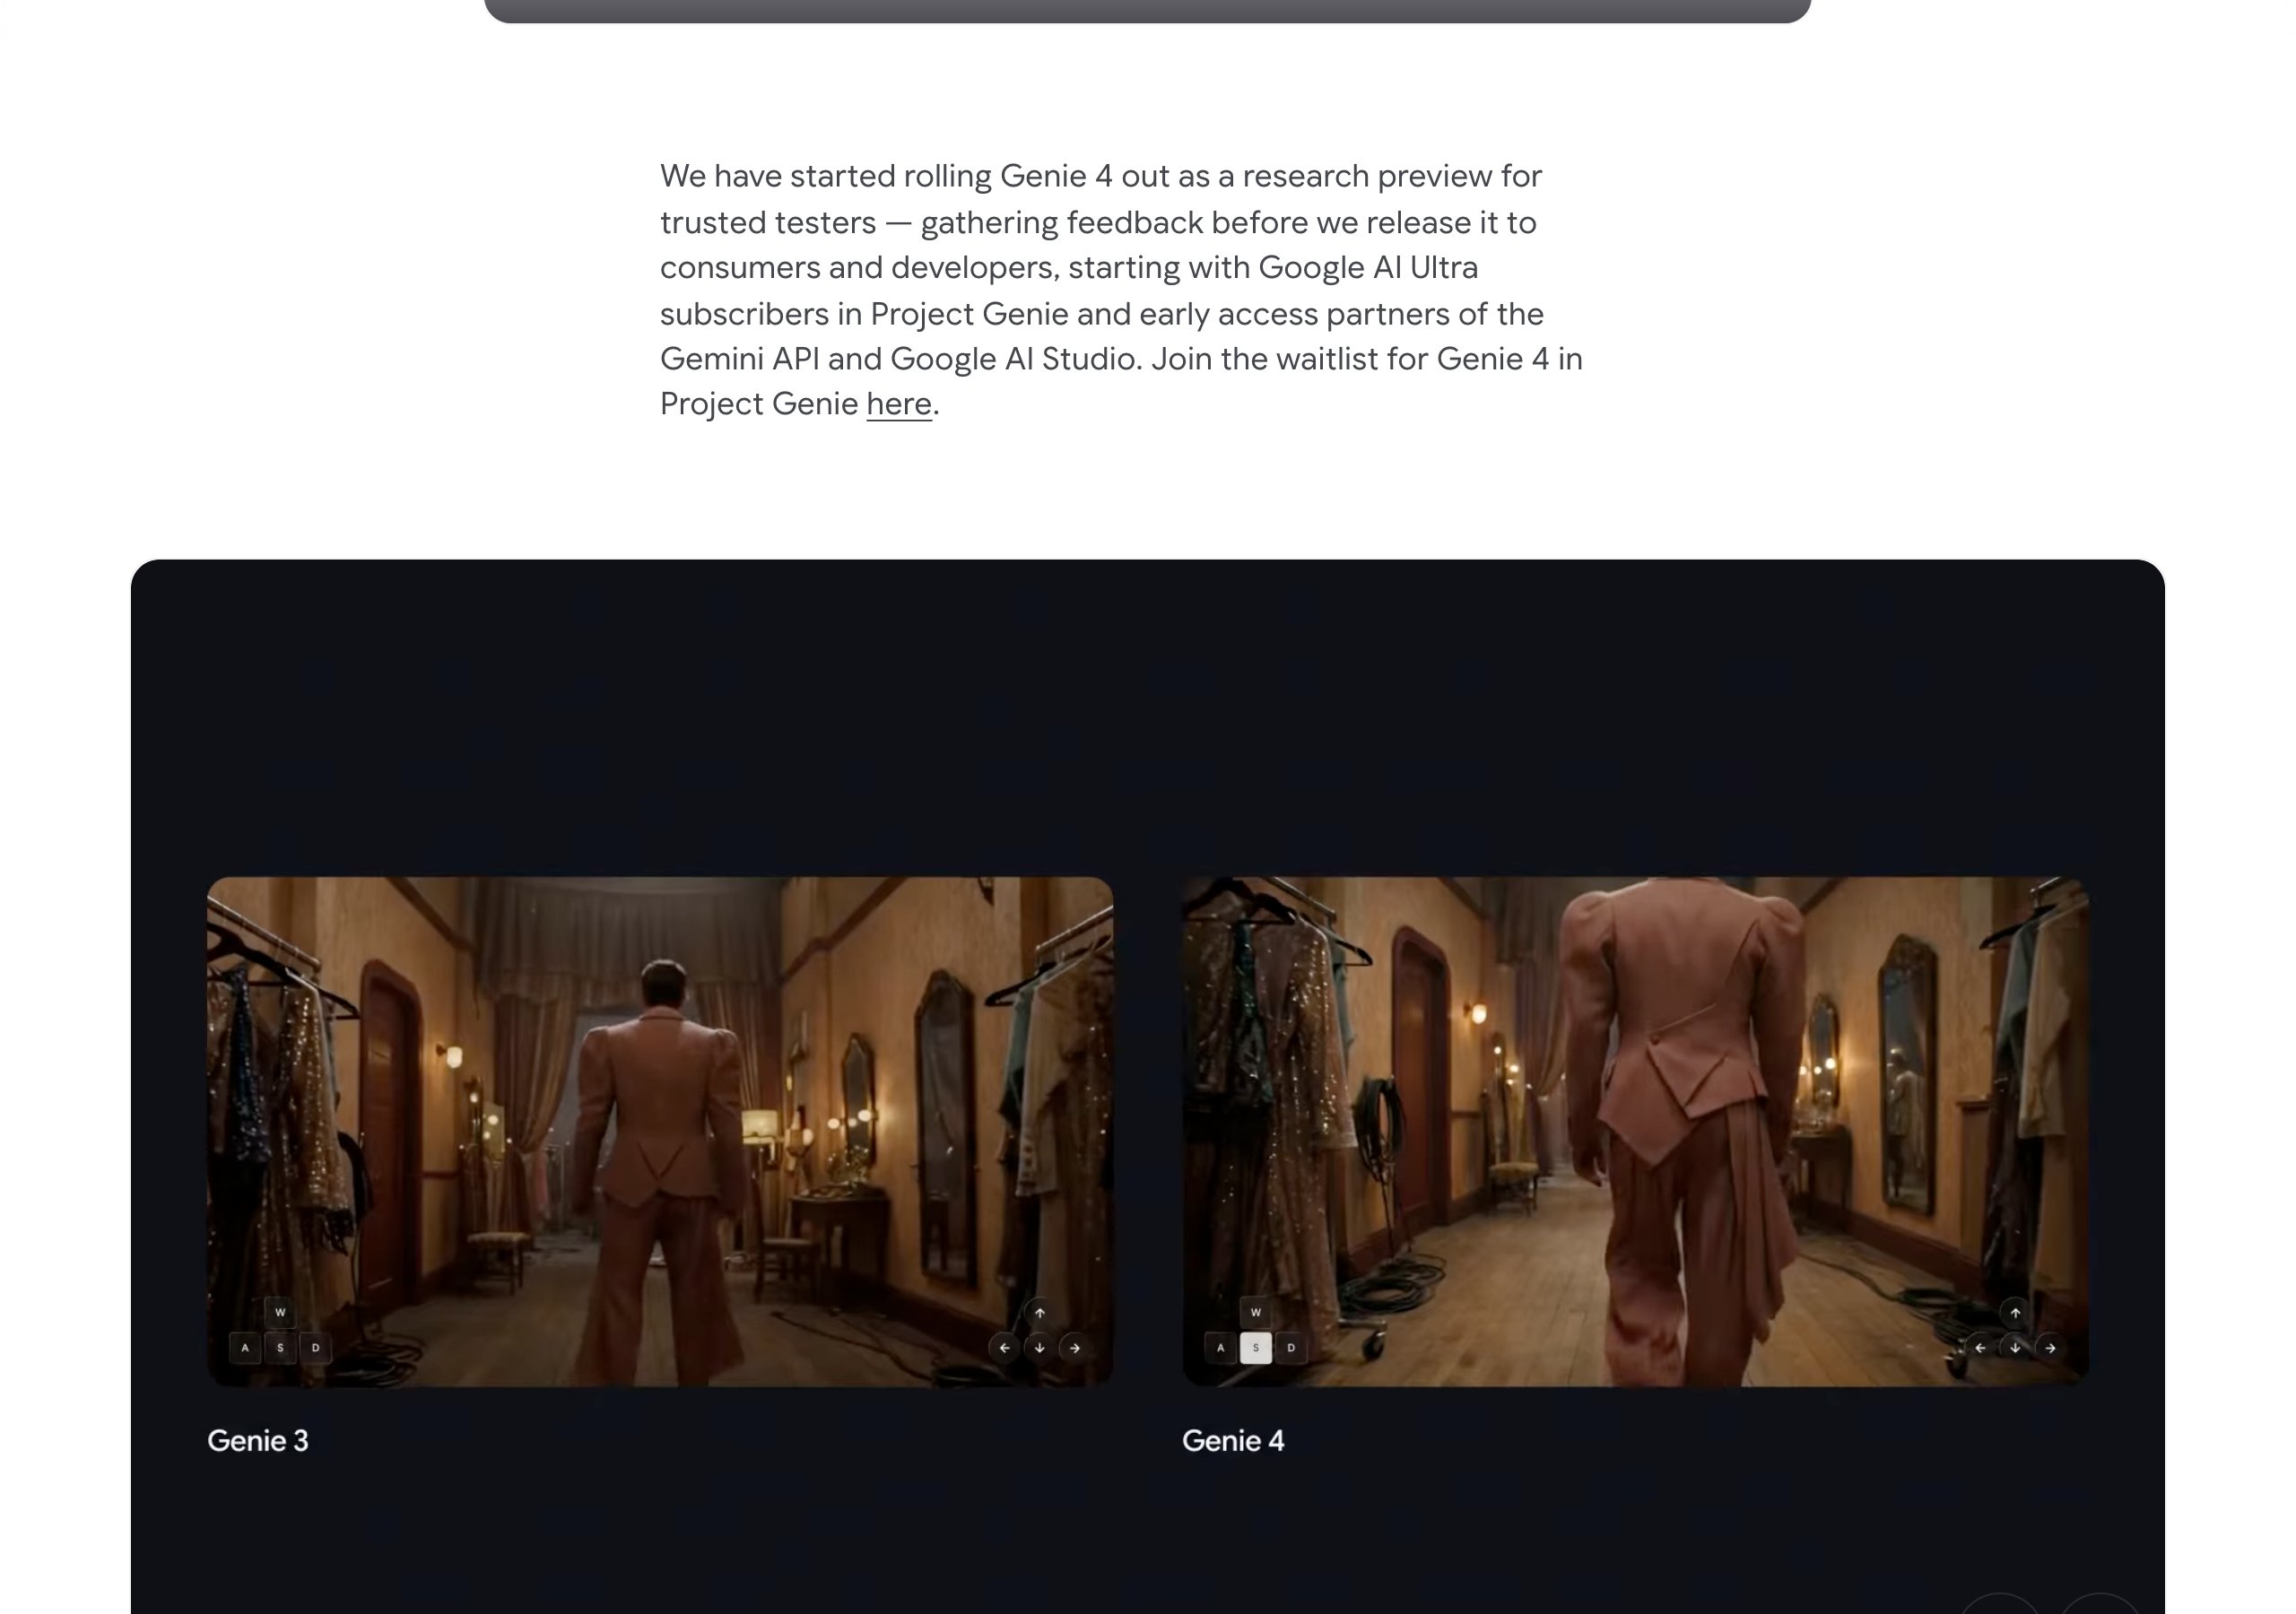
2026 年 10 月 27 日,Google DeepMind 发布第四代世界模型 Genie 4,先以研究预览(research preview)形式向受信任测试者开放。距离 Genie 3 发布约 15 个月,这一代在三个方向同时换代:画面自带原生生成的声音,人物可以实时对话,Gemini 模型被放进生成环内维持因果与连贯。
世界模型是什么,Genie 走到了第几代
按 DeepMind 的定义,世界模型(world model)是「用自己对世界的理解来模拟世界一部分的 AI 系统」,让智能体能够预测环境将如何演化、自己的行动会产生什么影响。这条线被 DeepMind 视为通往 AGI 的关键踏脚石:智能体可以在无限丰富的模拟环境里训练,而不必依赖真实世界的试错。
Genie 系列的节点很清楚。2024 年的 Genie 1 和 Genie 2 是最早的一批基础世界模型,能从提示词生成可交互环境;2025 年 8 月 5 日的 Genie 3 首次做到实时交互:文本提示生成动态世界,以每秒 24 帧的速度实时导航,720p 分辨率下维持几分钟的场景一致性。当时官方页面上并列展示的,还有能玩 3D 游戏的智能体 SIMA 2。
Genie 4 的跃迁点在官方博客里被归纳为四项能力,其中两项是 Genie 3 完全没有的。
四项能力拆解
实时塑形:用自然语言改世界
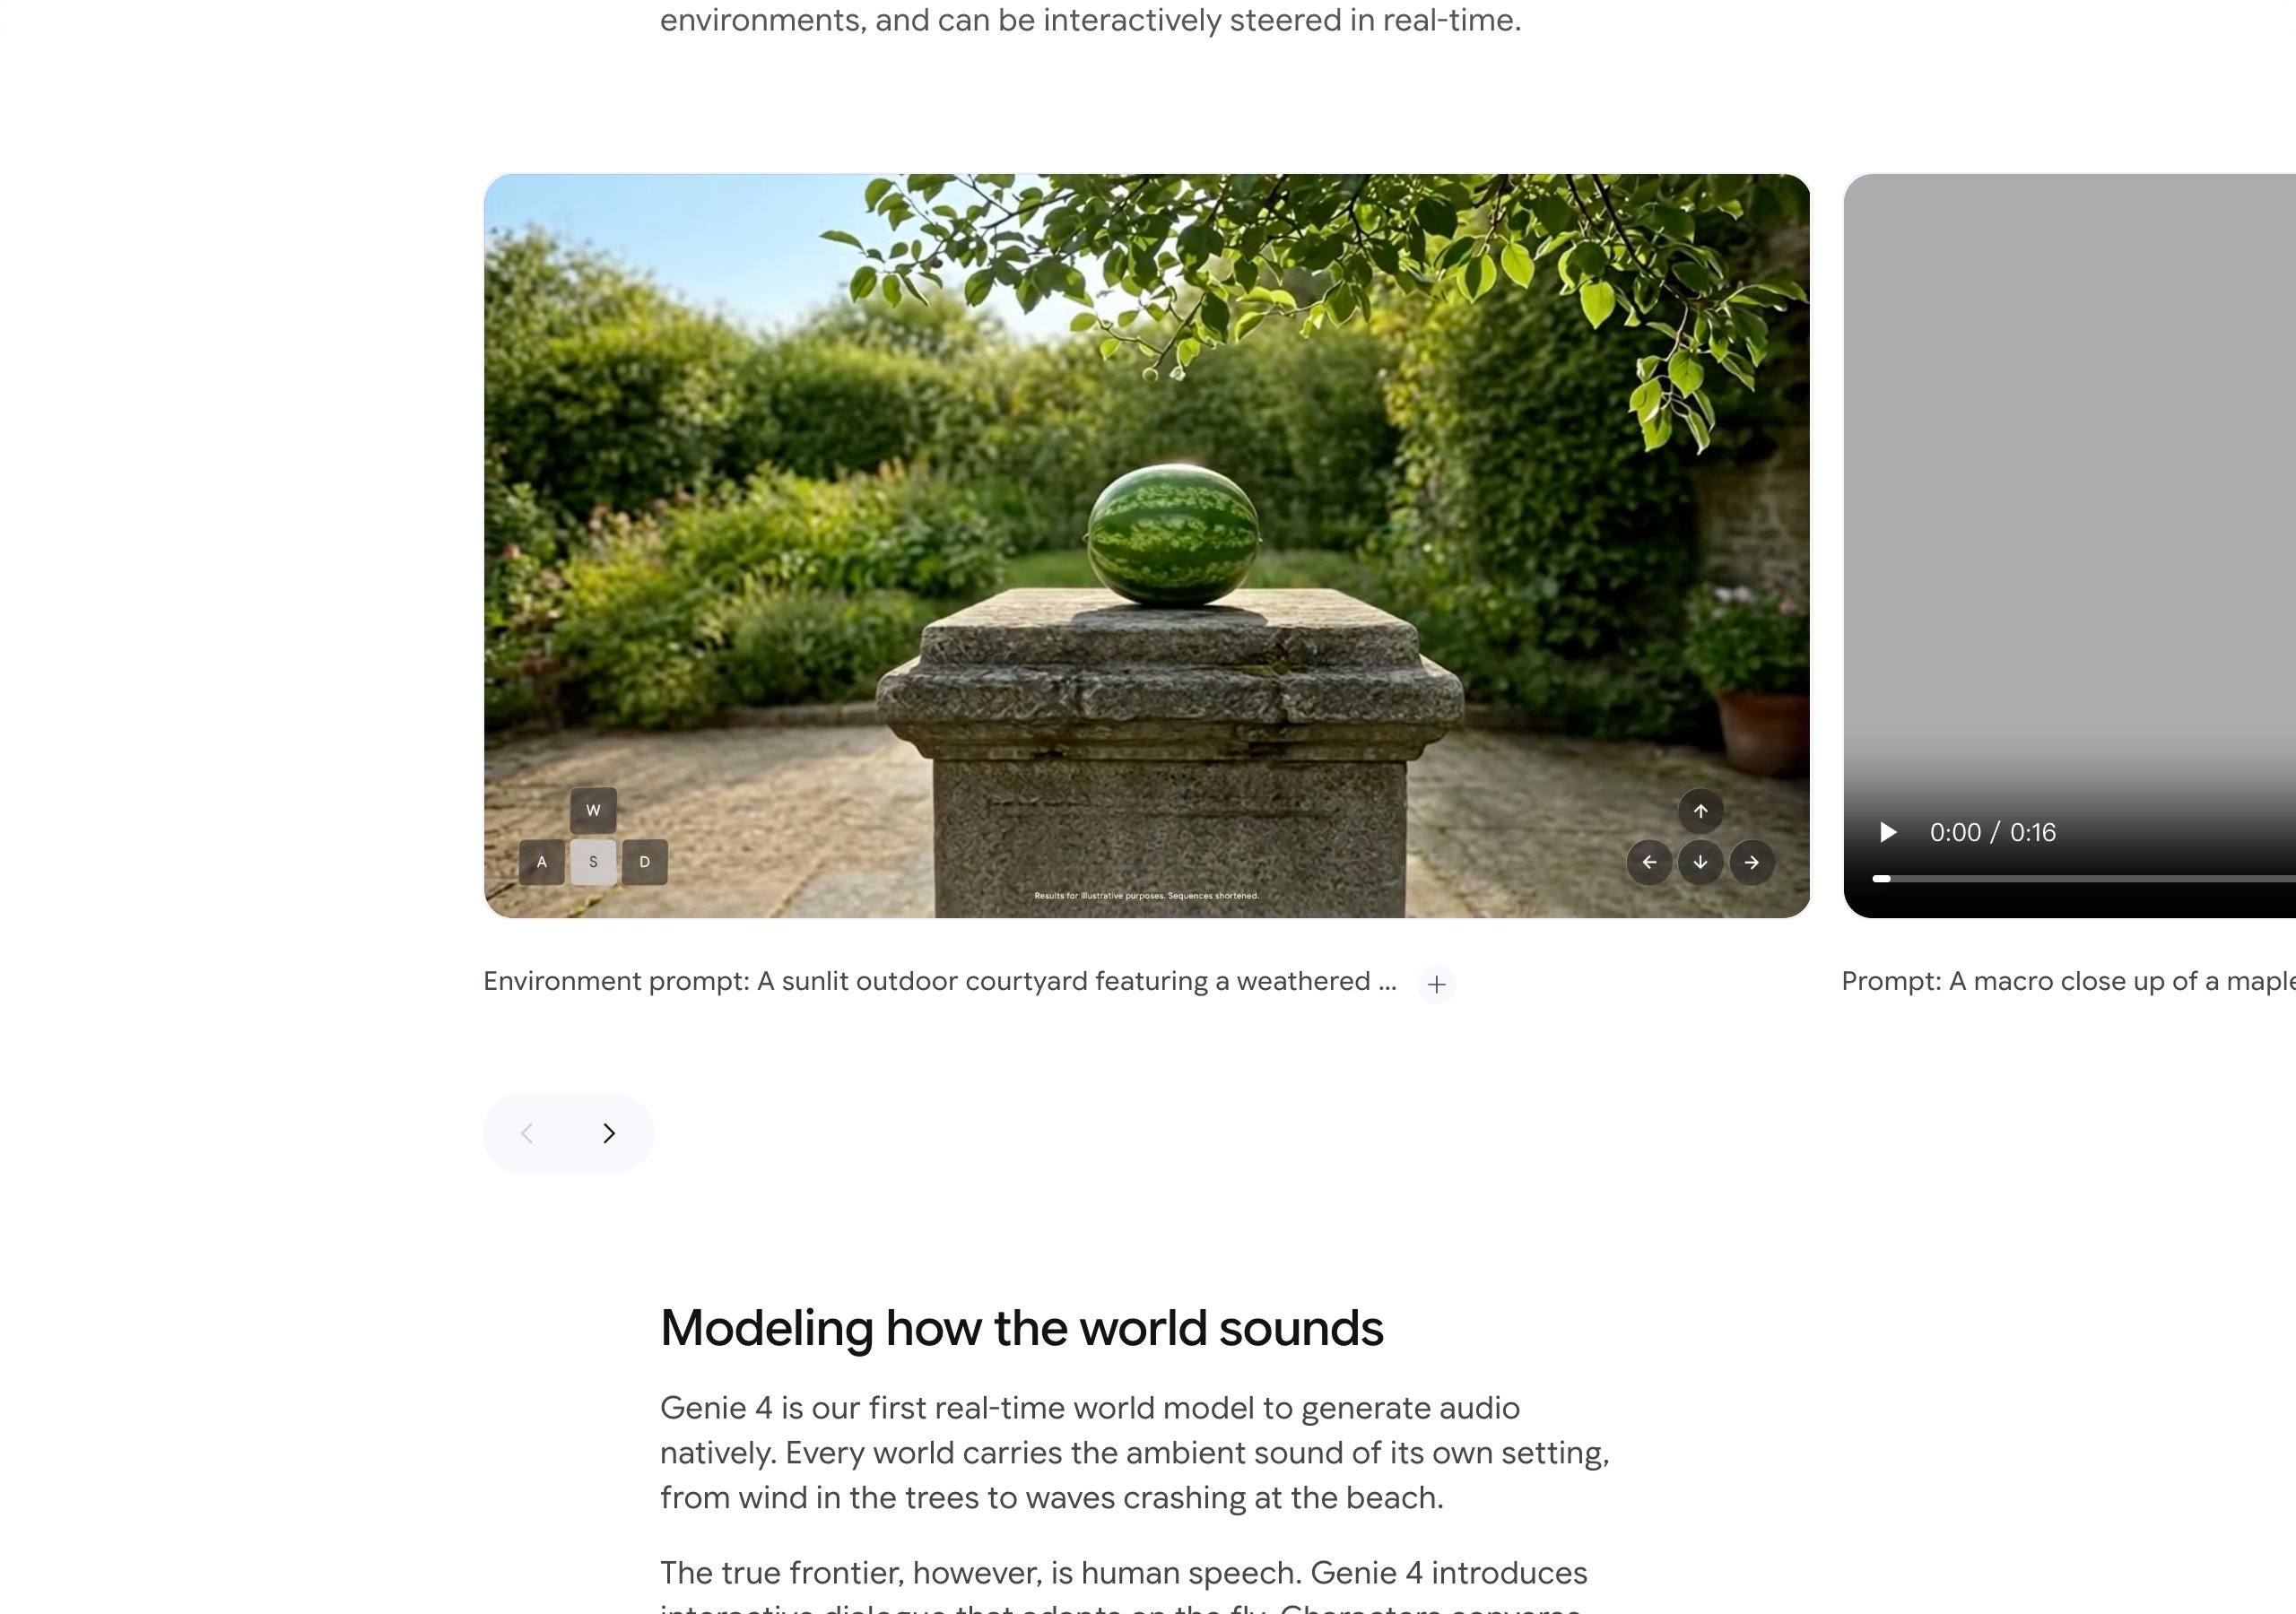
Genie 4 里可以用键盘控制移动和镜头,用文本提示在生成过程中实时改世界:换天气、移镜头、往场景里引入一个新人物或新物体。Gemini 会把你的输入上下文化,改写成贴合当前场景的指令;在你两次输入的间隙,Gemini 也在持续观察并引导场景,让世界连贯地推进。
物理与人物动作的拟真度
官方称 Genie 4 建立在对世界更深入的物理理解之上,能模拟空气动力学、碰撞等真实物理场景。变化最大的是人:角色动作自然,对环境做出有机反应,并且可以在生成过程中被实时引导。
原生音频与角色对话
这一项是 DeepMind 首个原生生成音频的实时世界模型。每个世界自带环境声,风吹树梢、海浪拍岸都由模型同步生成,无需后期配音。官方把真正的前沿方向定在人类语音上:角色能进行实时适应的交互式对话,对你的输入或世界中的事件做出反应。
Gemini 在环:多步事件的因果模拟
第四项能力是架构上最有信息量的部分。Gemini 3.8 Flash 在这里充当环内引导智能体(guiding agent in the loop):Genie 4 实时生成世界的同时,Gemini 持续观察画面、把目标拆解成步骤序列、复核传入帧来跟踪进度、验证每一步是否完成;世界发生变化或用户介入时,它当场调整计划。官方称这带来了「有可靠因果关系、程序化行为和多步推理能力的世界」。
DeepMind 还在实验 Gemini 4 Argon 与 Genie 4 的组合,对接 Gemini Robotics:Argon 把用户指定的任务拆成步骤,这些步骤以文本字幕的形式实时插入正在渲染的模拟中,演示场景是 Apptronik 的 Apollo 人形机器人下跳棋。
Genie 与 Gemini 的分工
Genie 4 的底座与 Gemini 家族深度绑定:Gemini Omni 负责把模拟锚定在真实世界的外观与行为上,其他 Gemini 模型提供维持场景连贯性所需的复杂推理。官方把这描述为「混合世界模型」方向的早期一步:语言与代码模型负责结构化推理、规划叙事时间线,Genie 负责逐像素生成眼前的物理现实,官方认为两者的互补能力是通向更连贯、更可控、更接地气的世界模型的路径。
谁能用上,怎么用
当前的开放节奏分三步:先是受信任测试者的研究预览,随后开放给 Project Genie 里的 Google AI Ultra 订阅用户,以及 Gemini API 和 Google AI Studio 的早期访问合作伙伴。普通用户现阶段能做的是加入 Project Genie 的等候名单(waitlist)。
受信任测试者在用它做什么
官方公布了五类测试者(覆盖创意产业、新闻、教育、游戏、工程)的四个方向:
- 影视预演:创作者把 Genie 4 当作快速「草稿模式」,走进场景的实时模拟里连续试拍多个版本,当场调整机位、灯光、台词和动作;
- 新闻与档案:摄影记者在测试把单张 2D 档案照片在几秒内变成可进入的环境模拟,用于体验历史空间、推演山洪或野火这类短期环境事件如何展开;
- 游戏原型:游戏开发者从想法到可探索原型只要数秒,在写下第一行引擎代码之前,先用自然语言验证视觉风格、材质美学与交互机制;
- 企业仿真:各行业企业伙伴在评估它做「从零到一」场景生成的能力。
官方自述的边界
DeepMind 在博客里主动列出了局限:Genie 4 只能在较短的会话内维持环境连贯,视觉细节与物体恒常性会随时间漂移,跑得越久、经过越多复杂提示词编辑、在场景中移动越多,漂移越明显;复杂物理交互、实时音频的准确性、可读文字的渲染、空间精度与长期一致性都还是进行中的研究方向。
安全侧的动作包括:上线前的内部安全评估,与全模型线一致的安全护栏,以及所有生成视频和音频都嵌入 SynthID 隐形水印(覆盖视觉与音频两种模态),用于识别 AI 生成内容。
这篇发布文在 Hacker News 拿到 636 分、385 条讨论,社区主要的质疑集中在游戏化用途的算力经济性上:为一个玩家实时生成世界需要的 GPU 集群成本,与把确定性引擎分发到消费者硬件相比是否成立,输入延迟问题也被反复提及。
从演示到基础设施
DeepMind 给 Genie 4 划定的用途清单里,游戏只占一角,更靠前的位置给了机器人与智能体的训练环境:无限变化的模拟世界可以用来训练智能体、测试智能体在不同环境中的表现,再进入真实世界。Genie 3 到 Genie 4 的变化方向也与此一致,生成质量的提升之外,Gemini 在环带来的多步事件因果模拟补上了关键一块:生成视频已经可以交互,训练与测试环境还要求因果可验证。
来源:Google DeepMind 官方博客《Genie 4: A new generation of world simulation》、Genie 3 发布页(2025 年 8 月)、Hacker News 讨论帖。