Cloudflare 把内部安全审计系统拆出了一个单仓库版本:security-audit-skill。这个 skill 随官方博客《Build your own vulnerability harness》一起开源,仓库创建于 2026 年 6 月,目前登上 GitHub Trending 榜首,总星标数 37,000,单日新增超过 2,000。
它做的事情可以一句话概括:把 Claude Code、Gemini CLI 这类编码智能体变成一个多阶段安全审计员。装上 skill 之后,一句"security audit this codebase"就会触发固定流程:编排多个隔离的子智能体,跑完侦察、狩猎、验证、输出、复核、报告六个阶段,最后产出机器可校验的 findings.json 和人类可读的审计报告。
六个阶段各做什么
**侦察(Reconnaissance)**阶段负责建模。三个并行的侦察子智能体分头读代码,把架构、信任边界、输入面、历史证据写进 architecture.md,同时生成一份 deterministic coverage 的 coverage-ledger.json。父智能体在这一步之后会跑 validate-coverage-ledger.cjs 做机械校验。
**狩猎(Hunting)**阶段是核心。系统按仓库划分 (区域 × 攻击类) 网格,每个格子派一个隔离的 Hunter 智能体。攻击类不是随意搭配的,仓库里内置了 13 个攻击类文档:内存安全与二进制、AI 与 LLM、Web 协议与认证、客户端、供应链与发布、云与部署、RPC 与消息队列、资源耗尽、数据隔离与生命周期、桌面/移动/本地 IPC,等等。AI 与 LLM 单独占一个文档,覆盖提示注入、智能体工具调用、输出处理三类针对 LLM 应用的攻击。
**候选验证(Validation)**阶段引入对抗性:每一个候选发现都要交给一个全新的智能体去证伪,检查威胁模型、利用路径、受影响代码、证据是否站得住。验证者自己不能提交发现——校验自己作业的 Hunter 会确认自己输出的一切。
**结构化输出(Structured output)**要求所有发现按 confirmed / needs_validation / rejected 三种判决写入 findings.json,并用 zero-dependency 的 report-schema.json 校验。三种判决有严格定义:confirmed 必须有完整的来源追溯和有界观察结果;needs_validation 有一个精确的未解决事实、不带严重度;rejected 记录被证伪的候选。
**独立复核(Independent verification)**用新智能体逐条核对最终记录的来源声明;发生材料替换的,再追加一轮独立验证。
**报告(Reporting)**从验证后的记录和覆盖账本推导出 REPORT.md、FINDINGS-DETAIL.md、NEEDS-VALIDATION.md 三份文件。
同一仓库的多次运行是可加的:skill 会读取先前运行的账本和发现,针对上次的覆盖缺口重新狩猎,重新验证已变更的源码,把过时或未解决的工作从"已覆盖"里排除出去。
从 skill 到 harness:Cloudflare 的六周改造
官方博客给出了这个 skill 的出身。Cloudflare 团队从一个约 450 行的 security-audit skill 起步,在单仓库上反复调 prompt,直到能稳定挖出真实漏洞。这段素材也解释了为什么这个 skill 值得研究:它的 prompt 至今仍带着最早那版 skill 的攻击场景、漏洞类别和反模式检测,后来整套 harness 的编排架构就是围绕这些 prompt 长出来的。
单跑 skill 很快撞上三堵墙:上下文耗尽(一小时后上下文窗口填满,模型吃掉自己的记忆,上午刚记下的漏洞线索转眼就忘)、持久化(中途崩溃全部重来)、跨仓库推理(单仓库会话看不到消费方仓库,而接口处恰好是漏洞高发区)。
解法是把每一阶段外置成独立智能体,前面挂编排器,后面接数据库。Cloudflare 给出的关键数据:从 slash 命令到覆盖 128 个仓库的 fleet 扫描器,用时六周;映射几乎是一比一的。SKILL.md 和 README 明确给出 skill 六阶段与 harness 八阶段的对应关系:
| Skill 阶段 | Harness 阶段 |
|---|---|
| Recon 智能体写 architecture.md | Recon |
| Hunter 按攻击类执行 | Hunt |
| 验证者证伪发现 | Validate |
| 幸存发现生成报告 | Report |
| findings.json 机械校验 | 行号与函数的机械校验 |
| 新智能体复核发现 | Independent validation |
运行态的 harness 有八个阶段:Recon、Hunt、Validate、Gapfill、Dedup、Trace、Feedback、Report。Gapfill 检查覆盖网格里的薄弱格子并生成新狩猎任务;Trace 沿依赖图行走,在消费方仓库里自动生成新的狩猎任务,把单仓库扫描变成全舰队扫描;Feedback 从验证失败和浅层运行中学习,即时改写排队中的 prompt。4 到 8 阶段是一个持续的生产者-消费者循环:新任务不断入队,Dedup 实时把同根因的发现折叠合并,晚发现的漏洞同样能在同一轮里被验证、报告、跨仓库检查。
每个智能体的上下文用量被硬性压在总窗口的 25% 以下。所有阶段写入同一个 SQLite 数据库,键为 (run_id, repo, stage),任何阶段可恢复、可重试、可被后续运行复用,崩溃的代价只是损失在飞的那一个任务。
数字:漏斗两端
官方博客给了一组完整的运行数据。发现端(VDH)累计产出 20,799 个原始候选,12,057 个通过独立验证;验证端(VVS)池子里另有 1,784 个来自其他 harness 的发现,合并后 13,841 个,Dedup 折叠掉 5,442 个重复,1,154 个被判定为错误仓库或非风险,最终 7,245 个可执行发现交付工程团队。严重度拆分:Critical 41 个,High 777 个,Medium/Low 6,427 个;其中 396 个被判定为可从互联网直接利用。
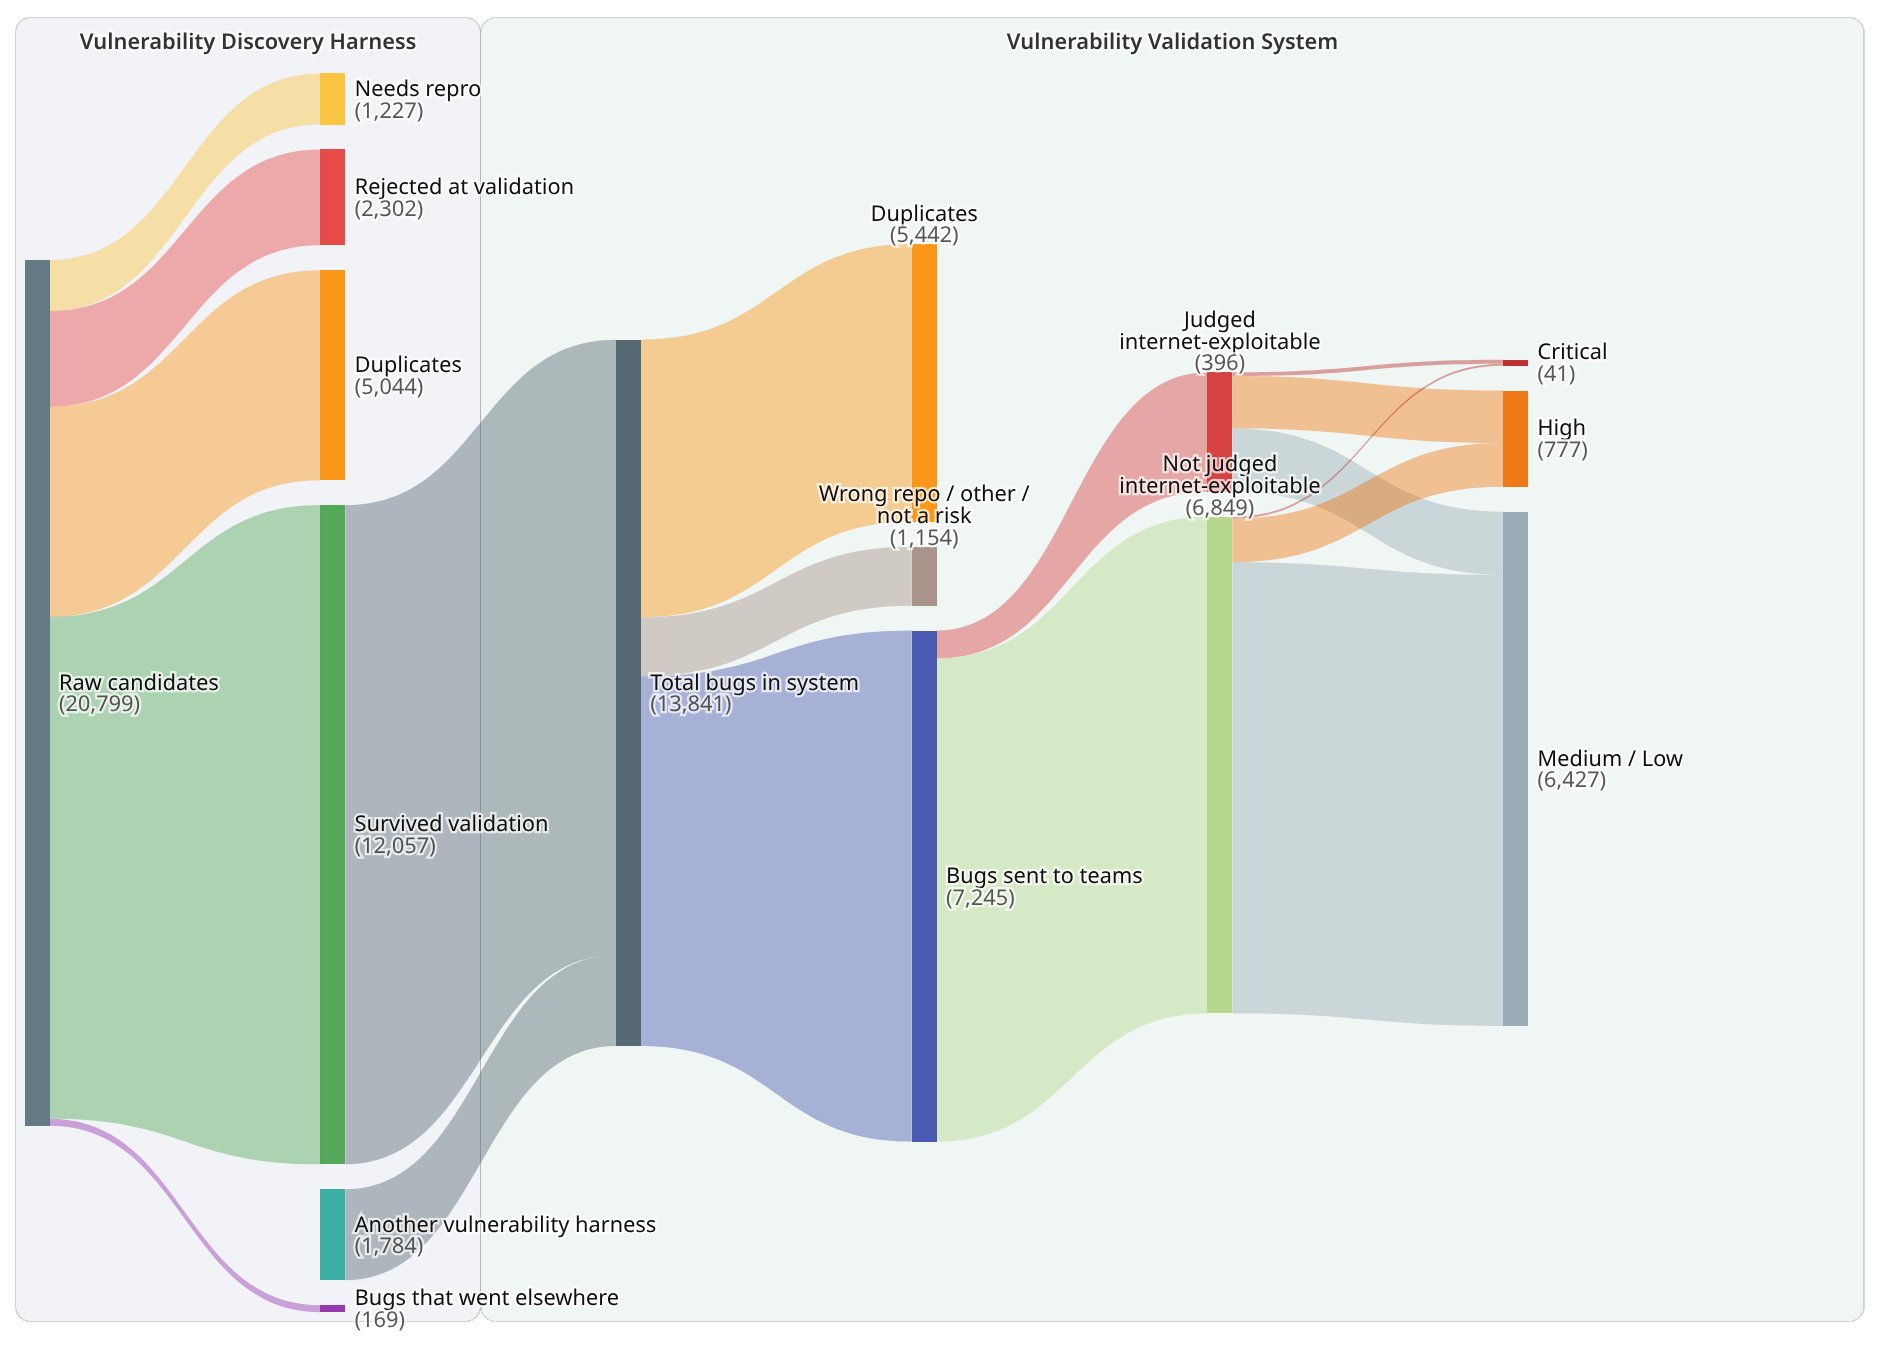
两个过程指标更值得看。初始验证拒绝率从 40% 降到 11%,高可信发现的占比从 35% 升到 58%——这说明侦察阶段的上下文注入质量在持续改进,垃圾候选在进入验证前就被拦下。团队还强调不宣称召回率:代码库不存在"全部真实漏洞"的标注集,任何召回数字都是猜测,他们只跟踪重跑是否持续发现新漏洞、覆盖是否持续增长。
单仓库基准(约 30k 行代码):一次完整运行 3-4 小时,产出约 100 个初始发现,3 小时内去重压缩到 80 个不同缺陷,修复智能体平均 5 分钟一个,全程约 14 小时产出可直接审查的 pull request。其中约 10 个高危缺陷走人工快速通道,5 天内修复上线;其余在 15-20 天窗口内分批滚动。
反模式清单与判定纪律
skill 的 SKILL.md 里有一份十条反模式清单,每一条都对应真实踩过的坑:把清单偏离当漏洞报告、无边界的纵深防御建议、在共享环境实测、猜测不在源码里的部署行为、把同主体自我影响当跨边界结果、报告比观察更强的解析器效果、只输出无法去重验证的纯文本发现、把旧发现的同源记录当锚点重复报告、给 needs_validation 记录分配严重度、在独立验证前写报告。
判定纪律上还有四条核心原则。要求边界与结果:每个候选必须说清低信任主体、接受的输入或动作、意图控制、跨越的边界、受影响主体、可观察的具体结果,缺一不可。使用有界本地证据:静态分析定来源路径,沙箱内的最小化本地测试定行为,到达错误返回值或越权记录就停,不生成持久化或隐蔽材料。尊重源可见性:部署控制、代理行为、身份策略不在仓库里就不要假设存在或不存在,用 needs_validation 记录精确缺失的事实。优先级与确定性分离:只有 confirmed 才有严重度,严重度不能超过已证明的影响。
给个人开发者的部分
Cloudflare 把 skill 单独拆出来开源,意图也写在博客里:harness 的架构不依赖任何单一模型,发现和验证用不同模型互相制衡,模型是可替换的组件,编排层才是资产。skill 是这个体系的单仓库入门版。
实际跑起来有两个硬性前提。第一个是模型:README 要求编码智能体支持工具调用和并行子智能体。第二个是沙箱:目标代码的构建、测试、进程、浏览器、模拟器、fuzz 必须跑在操作系统级沙箱里,禁外网、白名单环境变量、资源限额、只允许写入指定 scratch 目录;任何控制不满足时,skill 不会执行目标代码,而是把缺失能力记为 needs_validation 的阻塞项。指南模式默认不落盘任何文件,完整审计模式在显式请求时才启动六阶段全流程。
安装一条命令:npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit。装进 Claude Code 或任何支持 Skills 规范的智能体后,触发词是 security audit / find vulnerabilities / pen-test。输出目录默认 ~/security-audit-skill/<repo-name>/run-<N>,审计工件只写在你显式指定的、被版本控制忽略的目录里。