OpenAI 把「做判断」这件事做成了一个独立的 API。Decisions API 目前处于公开测试阶段,官方预计未来几周正式发布:你给它一段文本或一张图片,再加几个问题,它不写文章、不聊天地,直接返回结构化判断,官方口径的速度是 Responses API 的约 10 倍。同一周,HN 热榜上还挂着另一个帖子:AWS 旗下的 Strands 团队把同类的决策模型以开源权重发布,2B 参数,一台 RTX 3090 上中位延迟 106 毫秒,M3 MacBook 约 153 毫秒。
一边是头部云厂商把判断能力封装成一等 API 端点,一边是另一个巨头把同类能力开源到能跑在你自己的 CPU 上。决策模型(decision model,也叫 system one model)这个三周前还只是创业公司单一产品的品类,现在正式拿到了两大云平台的入场券。
Decisions API:判断成为一种端点
先看 OpenAI 这边的产品形态。Decisions API 目前处于公开测试阶段,走独立的 POST /v1/decisions 端点,当前只有 gpt-6-luna 一个模型可用。请求由三部分组成:模型名、作为共同证据的输入(文本或图文消息)、一组问题。每个问题有三种类型:
- predicate(断言):判断一个条件是否成立,返回 0 到 1 之间的概率。官方示例是检查产品照片里有没有可见损伤。
- choice(选择):从你给定的固定选项里挑一个,返回每个选项的概率分布加一个总体置信度。示例是客服工单该路由给账务、技术还是物流部门。
- score(评分):按你定义的有序等级打分,返回概率加权的等级指数。示例是按「仅外观 / 有绕过方案 / 完全阻塞」三档评估 bug 严重度。
一次请求可以并行问多个独立问题:一张产品图可以同时问「有没有损伤」和「属于什么品类」。官方文档明确了边界:需要生成自由文本或 JSON 对象时用 Responses API,需要模型发起工具调用时用 function calling,Decisions 只负责「从给定选项里选」这一件事。
定价结构能说明这个产品的定位。gpt-6-luna 走 Decisions 端点时输入 $0.10 每百万 token,只收输入 token 费用,没有缓存读写费、没有输出 token 费。对比 OpenAI 官方价目表:同一个 gpt-6-luna 走标准端点是输入 $0.10、输出 $0.50。判断类请求的输出极短(一个选择加一组概率),免掉输出费等于把这类调用的成本压到了标准调用的一小部分。文档同时写明支持零数据保留(ZDR)和 HIPAA 合规用途,美国和欧洲(EEA + 瑞士)支持数据驻留。
AWS 的答案:把 LM head 拆掉
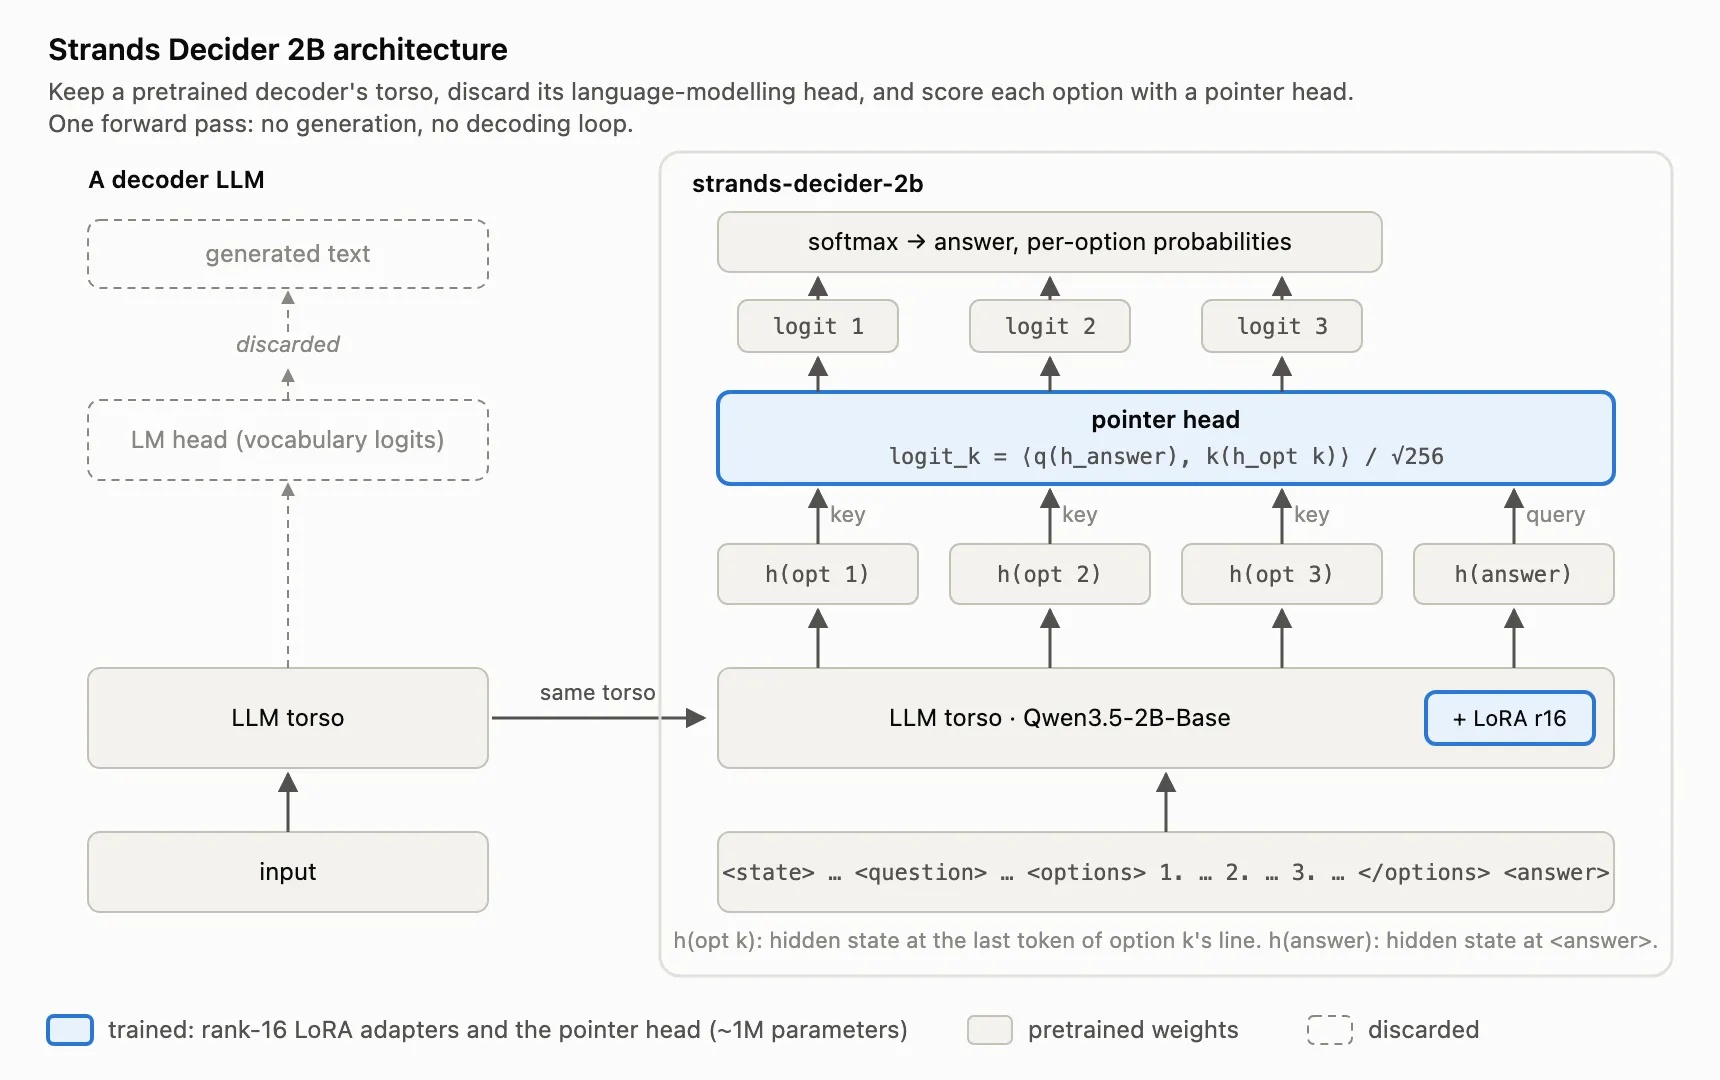
Strands 是 AWS 的 agentic AI 项目家族,Decider 2B 是其在 9 月底创建、10 月初开源的决策模型,代码(Apache-2.0)和权重(Hugging Face)连同全部训练数据与脚本一起发布。它选择了一条更「外科手术」的路线,官方架构图把整个思路画成了一次手术:
拿一个预训练好的 Qwen3.5-2B-Base,保留完整的 decoder torso,把顶部的语言建模头(LM head,负责从约 24.8 万词表里挑下一个 token 的那部分)整个拆掉。换上的是一个只有约一百万参数的 pointer head:它读取 <answer> 位置的隐藏状态,与每个选项末 token 的隐藏状态做点积,一次前向传播里给所有选项并行打分。torso 本身只做 rank-16 的 LoRA 微调。输入格式是显式标记的 <state>...<question>...<options>1..2..3..</options><answer>,模型不做任何文本生成,自然不存在生成式幻觉,也没有逐 token 解码的循环。
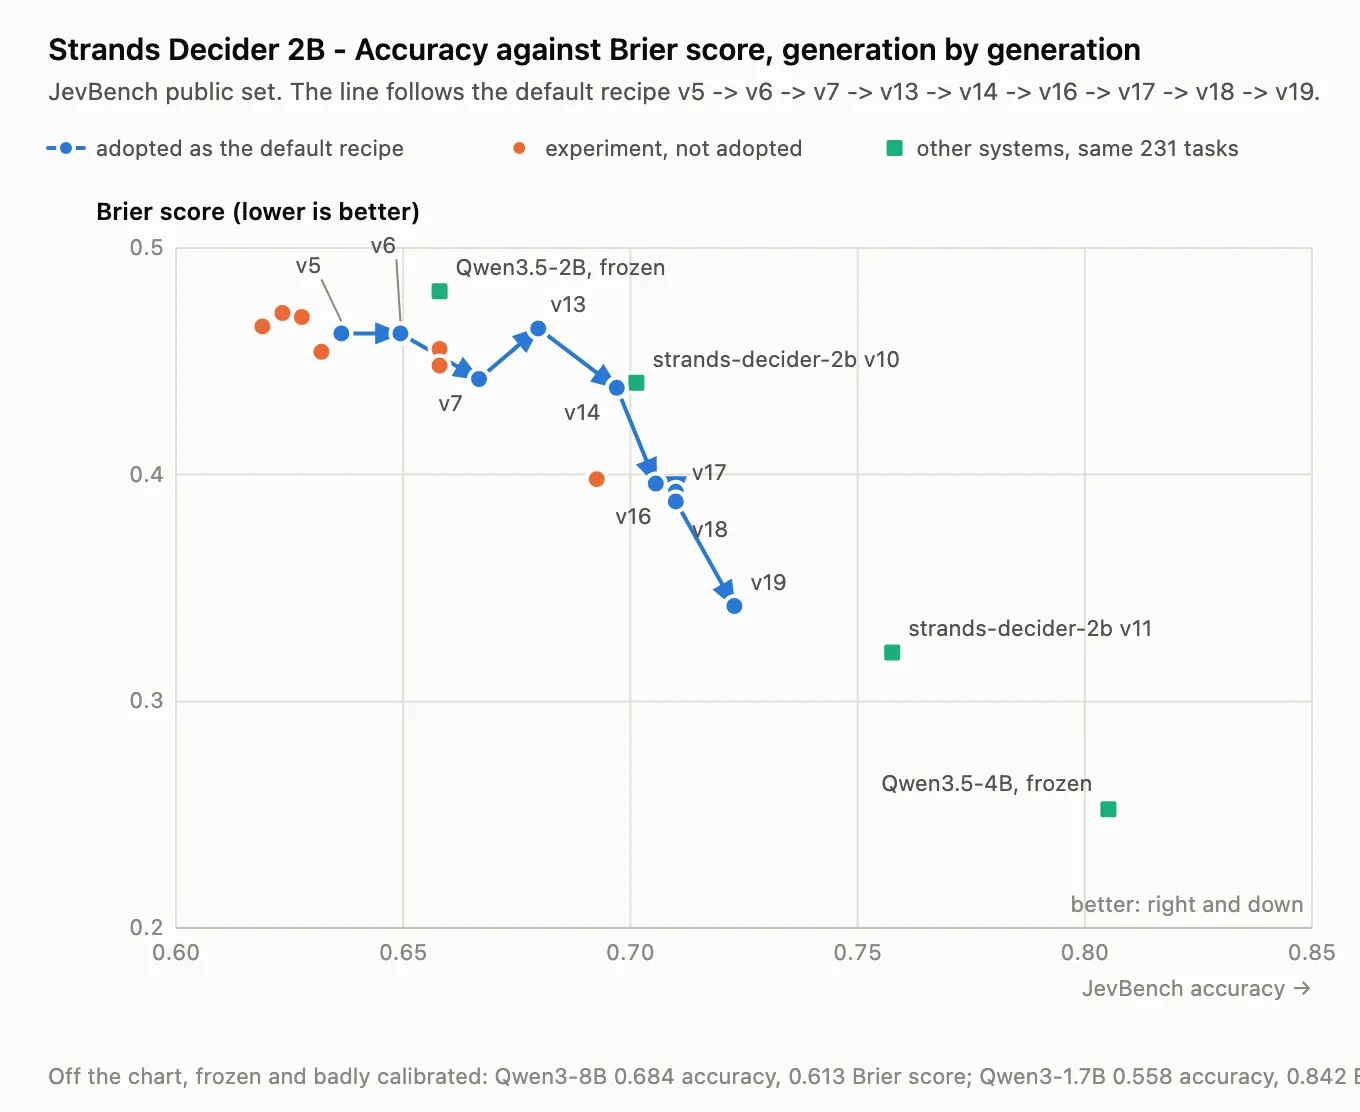
这个架构不是一次成型。官方博客写明了迭代史:第一版用的是 slot head,效果明显更差;发布时已是第 19 版(v19),每一版的改动都留在仓库里。当前 Hugging Face 上的发布版已经迭代到 v21:六种子训练、JevBench 公开集 231 题对 176 题(76.2%)、Brier 分数 0.323、ECE 0.064。作为对照,官方训练轨迹图里标出了未微调的冻结 Qwen3.5-2B:准确率约 66%、Brier 约 0.48,落在图左上角。同图能看到 v5 到 v19 每一代架构迭代把「准确率-校准」散点一步步推向右下方(更准、更可信)。
延迟数据同样来自官方:RTX 3090 上 230 个请求,中位 106 毫秒(p95 296 毫秒),博客口径「中位约 115 毫秒」;M3 MacBook 小任务中位约 153 毫秒。Mac 上还有 MLX 后端,官方称比 MPS 快 1.4 到 1.6 倍。安装就是一行 pip install strands-decider,也提供了本地 HTTP 服务模式。
同一个品类,两种商业化路径
把两边放在一起看,差异不在能力,而在「谁替你跑模型」。
| OpenAI Decisions API | Strands Decider 2B | |
|---|---|---|
| 形态 | 托管 API(公测) | 开源权重 + Apache-2.0 代码 |
| 底座 | gpt-6-luna(未公开架构) | Qwen3.5-2B + LoRA + pointer head |
| 题型 | predicate / choice / score | noul(是/否)/ choice / score |
| 输入模态 | 文本 + 图像 | 文本(v21 已带视觉评测,官方发布检查含 NaturalBench 0.785、POPE 0.878) |
| 成本 | 输入 $0.10/1M token,输出免费 | 自己的硬件,电费 |
| 延迟 | 官方称约 10 倍于 Responses API | 本地 106 毫秒中位(RTX 3090) |
| 数据合规 | ZDR / HIPAA 可选 | 数据不出机器 |
HN 评论区的讨论补上了几个可核实的细节。价格上,有人拿 Jev 对比:Jev 输入 $0.042 每百万 token,Decisions 是 $0.10,同一个基准全跑一遍的成本约 3 倍差。模态上,「图像输入」被认为是 Decisions 相对 Jev 补齐的第一个缺口。社区的动作也快:发布几天内已经有人把 Strands Decider 移植到浏览器里跑(WebGPU 版权重出现在 Hugging Face),有人在 Chrome 扩展里用它做邮件过滤,还有人试出 MLX 后端在 Mac 上的加速。
工程师该怎么用它
决策模型的适用位置,两边官方给的说法高度一致:模型路由、工具选择、参数核查、工单分诊、护栏检查、评测打分、记忆管理。共同特征是「高频、低难度、要概率」:让一个 frontier LLM 每次花几秒钟判断「这句话是不是紧急工单」是大材小用,让一个传统分类器覆盖所有表述变化又需要长期标注维护,决策模型卡在两者之间:通用性接近 LLM,成本延迟接近传统分类器。
Strands 官方博客给了一个具体的接入模式,值得展开:用 Strands SDK 的 InterventionHandler,在每次工具调用前让 Decider 回答两个是/否问题,参数是不是用户真的说过的、现在调用是不是太早。返回的是带类型的动作(放行、拒绝、转人工、带反馈退回),几行 Python 就能把「Agent 猜测用户意图并自信地调错工具」这类事故拦在执行前。博客的原话是:一个便宜到这种程度的判断,可以放在 LLM 调用永远放不进去的路径上。
边界同样清晰。Strands 模型卡坦承了限制:长多篇档文档是弱项(JevBench 困难档得分远低于简单档);换一种问法答案可能不变(问题被读得比文档少);校准只在训练分布内成立,上线前要用你自己的流量实测置信度阈值。Decisions API 是闭源托管服务,速度和概率质量依赖 OpenAI 的实现,重度使用前同样需要按官方建议用标注样本校准阈值。官方还提供了一个与 Live API 语音联动的指南:用户说「刷新这个页面」,语音会话把对话转写和当前状态交给 Decisions,从 back/reload/noop 三个动作里选一个执行。
决策模型的路线分野在这里很清楚:OpenAI 把它做成按量付费的托管端点,服务不想碰模型运维的团队;AWS 把它做成可以下载、微调、重训的开放权重,服务要把判断逻辑留在自己机器上的场景。两条路线共用同一个技术判断:Agent 工作流里绝大多数判断不需要生成文本,需要的是带概率的快速选择。这个判断正在被两大云平台用产品投票确认。
说明
- Decisions API 数据来自 OpenAI 官方文档(developers.openai.com/api/docs/guides/decisions),公开测试阶段,GA 时间官方表述为「未来几周」。
- Strands Decider 2B 数据来自官方博客(strandsagents.com)、GitHub 仓库 strands-labs/strands-decider 与 Hugging Face 模型卡(StrandsAgents/strands-decider-2B-hobson-v19/v21),Apache-2.0。
- Jev 价格对比来自 TypeSafe 官方博客与 HN 评论区引用的第三方基准,全量基准成本对比(约 3 倍)来自 HN 用户引用的 OpenRouter 数据,未独立复测。
- 本文不构成任何采购建议,API 定价与模型能力以官方最新文档为准。