Gleam 是一门跑在 Erlang 虚拟机(BEAM)上的静态类型函数式语言,编译器用 Rust 写成。10 月 6 日发布的 v1.19.0 做了一件表面低调、内里伤筋动骨的事:Erlang 代码生成器被完全重写,编译产物从 Erlang 源码换成了 Erlang 抽象形式(abstract forms)。编译速度显著提升,BEAM 崩溃报告和堆栈追踪的行号第一次精确回指 Gleam 源码。官方基准里,同一个测试项目的完整编译时间从 v1.17 的约 405 毫秒降到 v1.19 的约 325 毫秒。
从输出源码到输出 AST
要理解这次变更,得先看 BEAM 生态编译器的标准流水线。以 Erlang 本身为例:源码先经过 tokenizer 和 parser,变成一棵带元数据的语法树,这棵树就是 Erlang 抽象形式(abstract forms);编译器再从抽象形式生成 Core Erlang 中间表示,最终产出 BEAM 字节码。抽象形式有稳定的表示,也有基于 Erlang external term format 的二进制编码。
Gleam 之前的做法跳过了前半段:编译器直接生成 Erlang 源代码文本,把这段文本交给 Erlang 编译器,从 tokenizer 开始走完整流程。这种方式实现门槛低,Gleam 团队也靠它把语言推到了 v1.0 之后。代价同样明显:Gleam 编译器为了产出「人好读、编译器也能解析」的文本,要做漂亮的排版;Erlang 编译器拿到文本后还要重新 tokenize、parse 一遍,Gleam 侧掌握的类型信息和位置信息在生成文本时大量丢失。
v1.19.0 把这段路径短路了。新的代码生成器直接构造抽象形式,用二进制格式交给 Erlang 编译器,跳过 tokenizer 和 parser 两个阶段。Giacomo Cavalieri 用几个月时间完成了这次重写,第一阶段的成果已随 v1.18.0 发布,v1.19.0 是完整形态。
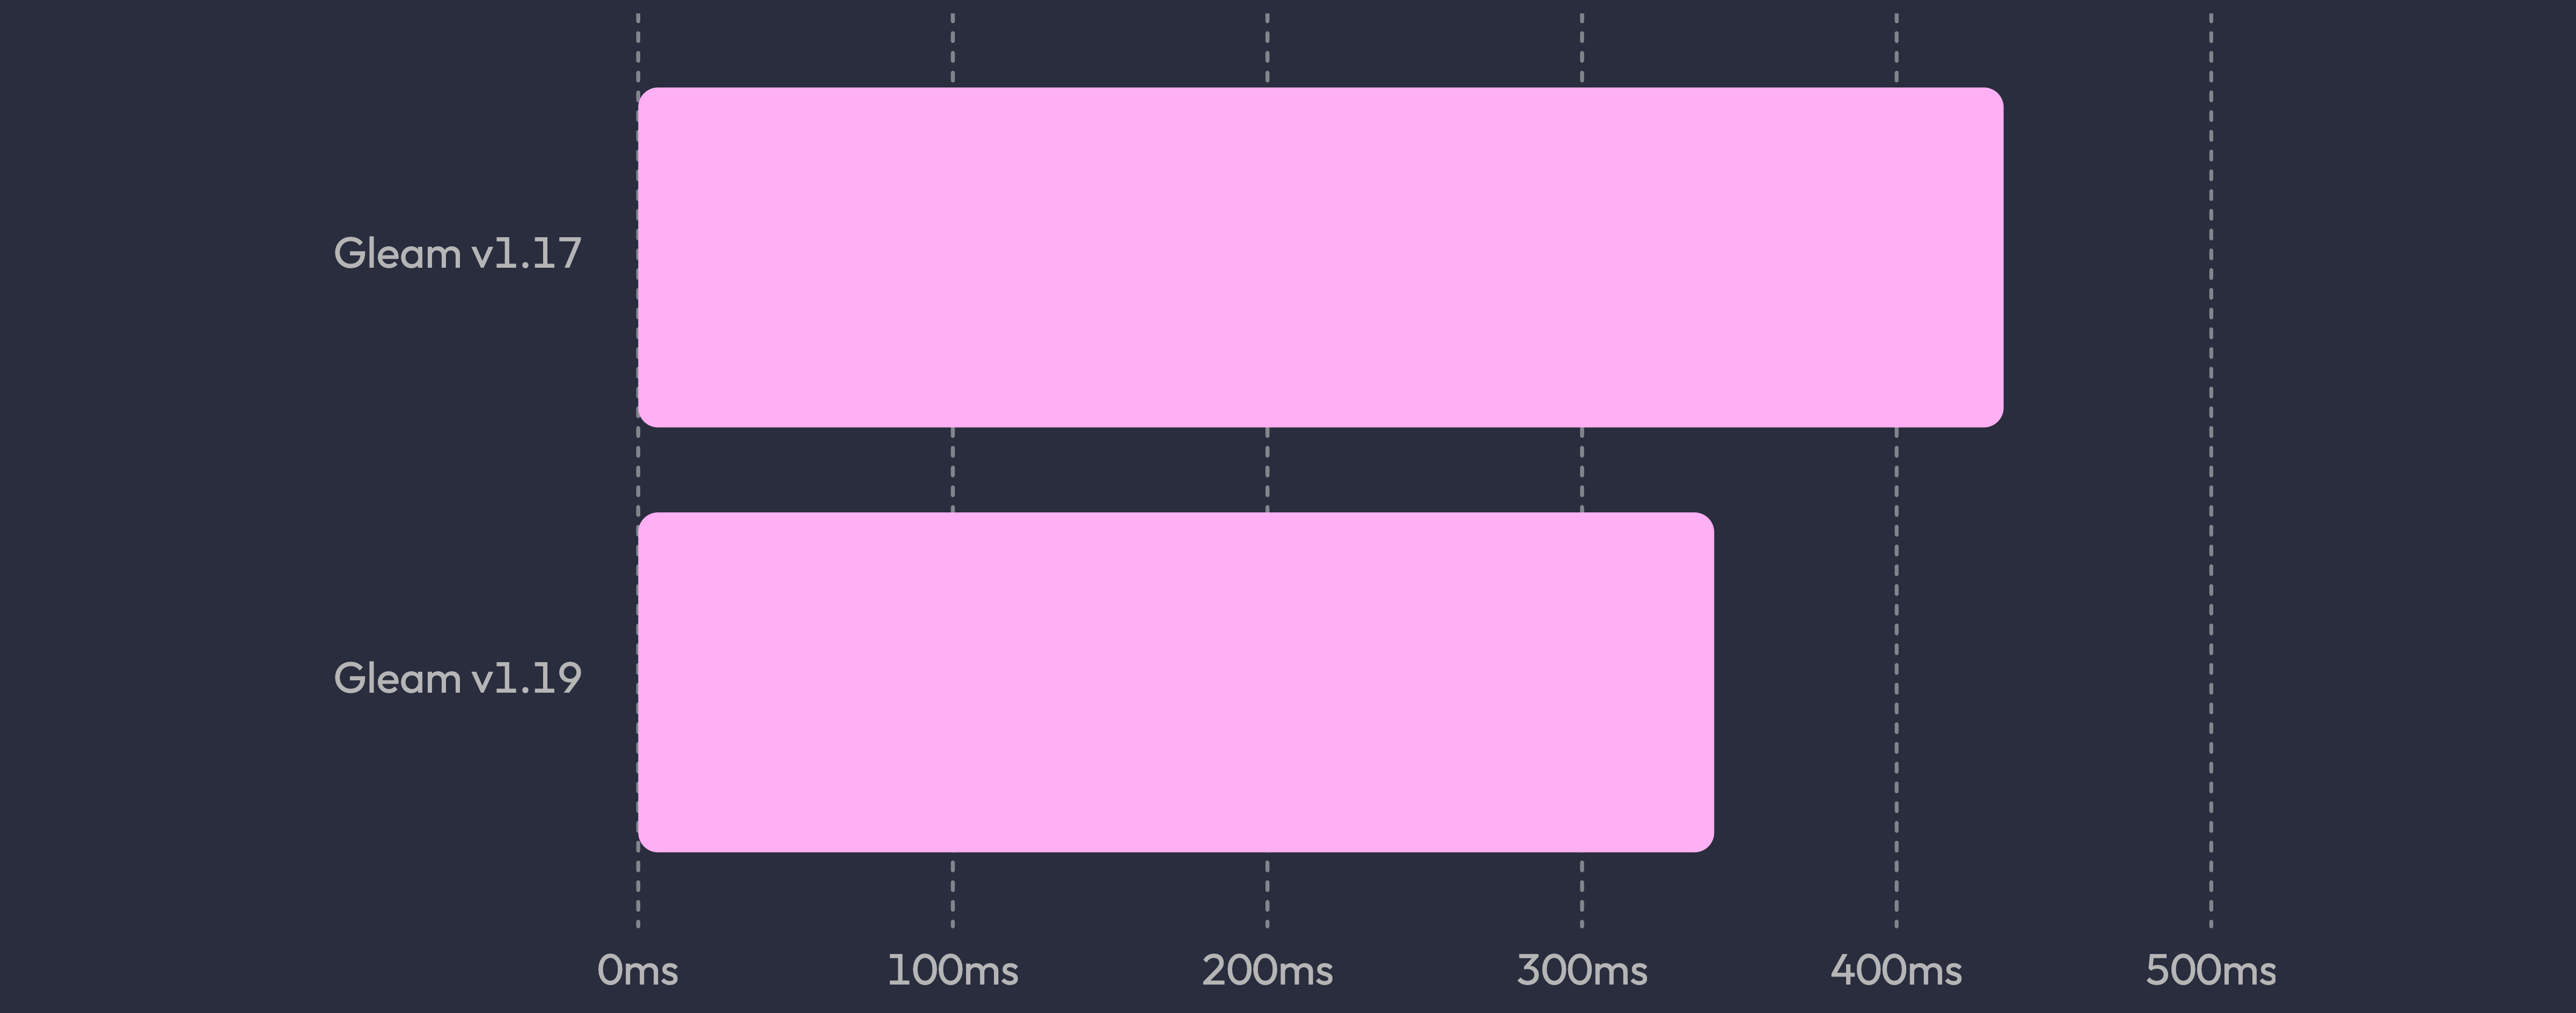
收益是三个层面的。速度上,省掉两次完整的前端解析,构建时间明显下降,下面这张官方对比图里 v1.17 到 v1.19 的差距清晰可见:
诊断体验上,这是对日常开发影响最大的一项。此前 BEAM 崩溃报告和堆栈追踪里的行号指向的是生成的 Erlang 代码,编译器只能映射到「最近的函数」,报错行号经常对不上 Gleam 源码;现在位置元数据从抽象形式一路带进运行时,行号精确无误。官方文档还提到,这套元数据足以支撑 edb 等调试器对 Gleam 的完整支持,只是团队尚未投入这项工作。
代码质量层面,Erlang 代码生成器是 Gleam 代码库里最老、最稳定的部件之一,写于项目早期,风格停留在旧标准。重写后的生成器按当前代码规范实现,官方的评价是它拉高了整个编译器的质量基线。
为什么不直接生成 BEAM 字节码
跳过 Erlang 编译器前端之后,一个自然的问题是:为什么不走到底,直接生成 BEAM 字节码?这样还能利用 Gleam 的静态类型信息做 Erlang 编译器做不到的优化。
Gleam 团队在发布文中给出了明确的取舍分析。关键在于接口稳定性:Erlang 源码和抽象形式都是固定不变的接口,而 BEAM 字节码不是。每个版本的虚拟机都会演进字节码格式,增加指令、移除废弃指令。直接生成字节码意味着 Gleam 团队要永久承诺跟进每一次虚拟机演进,与 Erlang/OTP 维护者紧密协同,在每个 OTP 新版本发布时同步适配;还要复刻 Erlang 编译器几十年积累的全部优化,即使有 Gleam 静态分析的加持,这也是一笔巨大的工程开销。
Gleam 是一个靠赞助维持的社区项目,核心开发者全职投入依赖每月 5 到 20 美元级别的个人赞助。资源约束下的工程决策必须考虑十年维度的可持续性。编译到抽象形式处在成本收益的平衡点上:拿到了跳过前端的收益,又把字节码演进的风险留给 Erlang 编译器去消化。
这个选择在 BEAM 生态里有先例。Elixir 编译器同样先把 Elixir 代码编译到 Erlang 抽象形式,再交给 Erlang 编译器产出字节码。Gleam 官方对此的说法是:对 Elixir 够用的路线,对 Gleam 也够用。三种语言在同一台虚拟机上各用各的前端,共享同一个经过几十年生产验证的后端。
基准数据与横向位置
官方基准基于 José Valim 的 langcompilebench 项目改造:编译 100 个模块,每个模块包含 100 个返回 hello world 字符串的函数,完整构建、无缓存,对比 v1.17.0(重写前)与 v1.19.0(重写后)。v1.17 大约需要 405 毫秒,v1.19 降到约 325 毫秒,缩减约五分之一。官方同时强调这个基准只覆盖语言特性的一小部分,实际项目的增量编译在开发过程中通常远快于全量构建。
横向对比更能说明位置。扩展到其他语言后,同一个测试项目的编译时间排名如下:
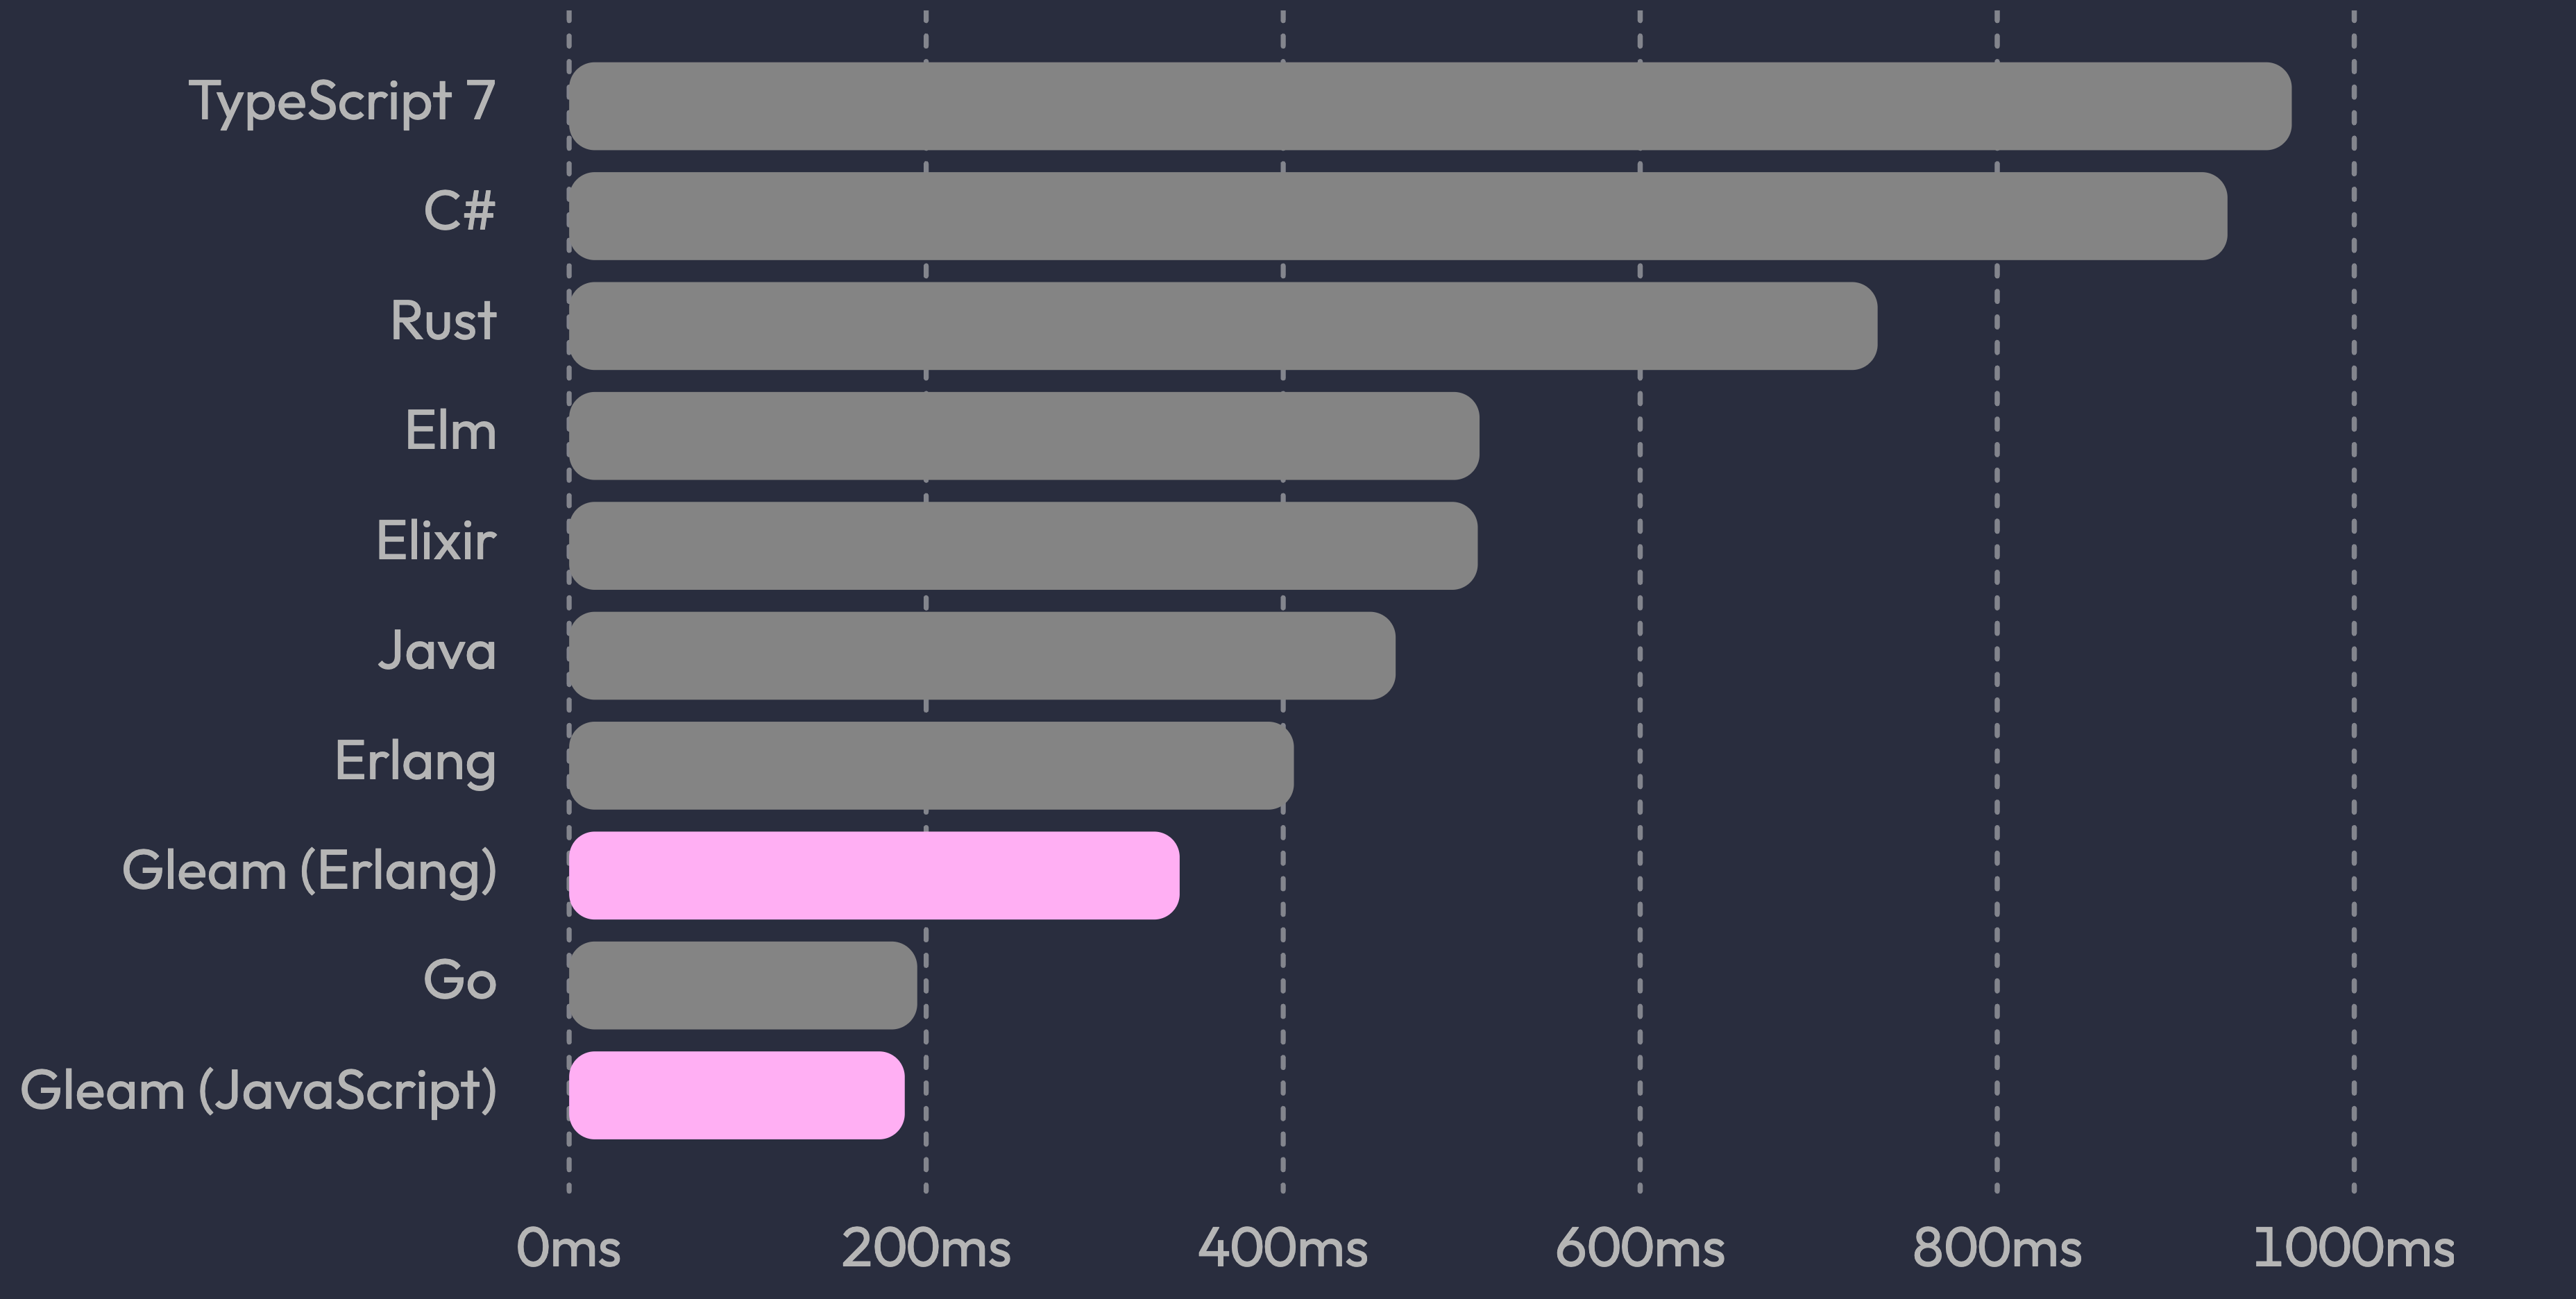
Gleam 编译到 Erlang 目标约 320 毫秒,编译到 JavaScript 目标约 190 毫秒,在 TypeScript 7、C#、Rust、Elm、Elixir、Java、Erlang、Go 等一众语言里排在前二,只有 Go 的编译时间与 Gleam(JavaScript 目标)处于同一量级。类型检查、两个后端的代码生成加符号解析全流程控制在一秒以内,这是 Gleam 开发体验里「等待编译」几乎无感的底层原因。
JavaScript 侧的两项生成代码优化
v1.19.0 不只有 Erlang 后端的重构,JavaScript 后端也拿到两项生成代码质量的改进。
第一项是模式匹配编译产物的扁平化。Gleam 用 case 表达式做模式匹配,编译到 JavaScript 时会变成嵌套的 if 语句。此前一个匹配两层结构的 case 会生成五层嵌套、多个中间变量;John Downey 的改进把嵌套 if 折叠成单条件表达式,中间变量随之消失。压测数据有个有趣的细节:gzip 之后代码包体积几乎不变,但生成代码的分支数减少,给 JavaScript 引擎的优化器留了更干净输入。
第二项是短列表字面量的构造优化。Gleam 的不可变持久化链表与 JavaScript 的连续数组是两种数据结构,此前列表字面量一律编译成「先建 JS 数组、再整体转换」的两步构造。新版对短列表直接生成逐节点 prepend 的构造代码,跳过数组中转。对大量使用短列表的应用(典型如 Lustre 生态)这是直接的运行时收益;长列表仍走数组路径,因为那条路对长列表更快。
生态位与工具链的同步演进
Gleam 目前的定位是 BEAM 生态里的类型安全层:Erlang 和 Elixir 是动态类型,Gleam 用静态类型系统覆盖同一个运行时,并且与两者零成本互操作。这次编译管线的调整强化了一个信号:Gleam 不想当「生成 Erlang 代码的转译器」,它在向 BEAM 生态一等公民的位置靠拢,与 Elixir 平起平坐地共享编译器基础设施。
工具链的几项改进也指向同一个方向。语言服务器补齐了 label 的跳转定义、查找引用和重命名支持,这是 LSP 完整性的最后一块主要拼图。编译到 JavaScript 时生成的 TypeScript 声明文件获得了函数重载:此前类型收窄函数(如判断 Box 是否为 Full 的谓词)会把泛型参数退化为 unknown,现在声明层面保留了原始类型参数。面向其他构建工具的编译命令也在增强:gleam 编译到 BEAM 时自动生成虚拟机需要的 .app 资源文件,compile-package 命令新增 --no-dev 标志,export 系列命令支持标准输入输出,这些都是为 Elixir 的 Mix 和 Erlang 的 rebar3 原生集成铺路,让 Erlang/Elixir 项目可以直接引用 Gleam 写的依赖包。
错误信息延续了 Gleam 的一贯投入:git 合并冲突标记、Java 风格的模式匹配竖线、常量表达式里的非法运算符、record 更新语法位置写反等场景都有了专门的提示;无效类型别名不再引发连锁错误。编译器的容错能力同步增强,语言服务器在代码处于非法状态时仍能提供完整分析,这对重构中途的体验至关重要。
对使用者的实际意义
已经在用 Gleam 的团队升级到 v1.19.0 是零成本切换:编译目标没有变,运行时行为没有变,变化全部藏在编译器和工具链内部,升级后立刻拿到更快的构建和准确的报错行号。
对 BEAM 生态的开发者,这次发布降低了尝试 Gleam 的心理门槛:它不再依赖「生成可读 Erlang 源码」这类取巧路径,工程上与 Elixir 走同一条经过验证的管线。在 Mix 和 rebar3 的原生支持落地后,Erlang 或 Elixir 项目引入一个 Gleam 依赖包会像引入同语言包一样自然。
官方对这次变更的评价基于基准数据:抽象形式这个「给编译器看的中间层」处在稳定接口与工程收益的交集上,Elixir 用了十五年验证这条路,Gleam 沿着它走到了 v1.19。
项目地址:github.com/gleam-lang/gleam(Apache-2.0),发布文与基准细节见 gleam.run。