ARC-AGI-3 官方基准的记分卡上,Claude Opus 5.0 在过去的最好成绩是 40.68 分。同一个模型,换上一套名为 VISTA 的外部框架之后,拿到 100.00 分:25 个公开游戏、183 个关卡全部通关,总步数比首次接触游戏的人类测试者少 57.4%。这套框架来自何恺明团队(MIT),论文《VISTA: A Visual Harness for Reasoning in an Interactive World》于 10 月 1 日挂在 arXiv(2610.02200),作者为 Qiushi Han、Keya Hu、Linlu Qiu、Cathy Wu 与 Kaiming He。
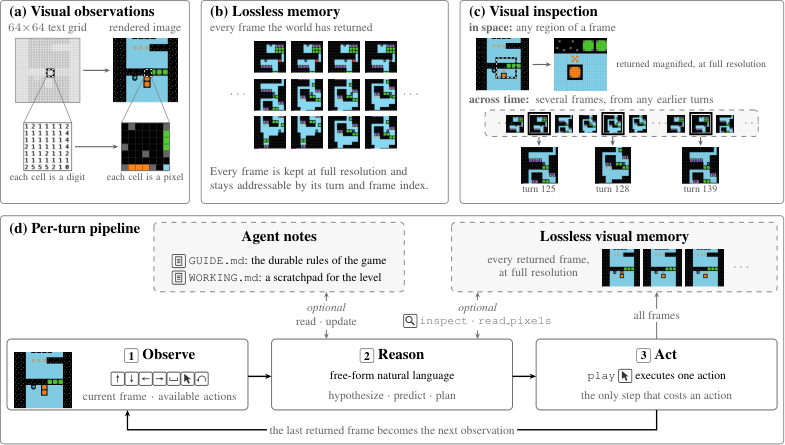
VISTA 没有训练任何新模型。框架内部套用的是 Claude Opus 5.0 和 GPT-5.6 Sol 这两个现成的多模态模型,外加一个 MCP 服务器暴露的几个工具函数。何恺明团队给出的判断是:多模态模型的推理能力早就足够,过去半年模型在 ARC-AGI-3 上分数低迷,瓶颈出在输入表示和记忆机制上。
ARC-AGI-3 在考什么
ARC-AGI-3 是 Keras 之父 François Chollet 的 ARC Prize 基金会于 2026 年 3 月发布的交互式基准,由一批人类手工设计的像素小游戏组成。与 ARC-AGI-1/2 的静态「看图猜变换」不同,ARC-AGI-3 的每个游戏开局不提供任何说明:没有规则、没有目标描述,智能体只能观察画面、尝试操作、从画面的变化中推断这一切是怎么运作的。官方对「攻克」的定义是:AI 首次接触所有环境时的行动效率达到或超过人类水平。
评分指标是 RHAE(Relative Human Action Efficiency):通关的前提下,以首次游玩的人类平均步数为基准,步数更少得分更高(每关满分 115 分,超过人类步数则按平方比折减,未通关计零分),最后对 25 个游戏取平均。这个设计同时惩罚「过不了关」和「靠海量试错暴力通关」两种路线。
ARC Prize 官方今年 5 月的分析报告显示,GPT-5.5 在这套测试上的得分是 0.43%,Claude Opus 4.7 是 0.18%,人类首次游玩可以 100% 通过。VISTA 论文引用的官方基线是:GPT-5.6 Sol(max 推理强度)13.33 分,Opus 5.0(high 推理强度)40.68 分。
瓶颈一:数字表不是眼睛
ARC-AGI-3 官方接口把每帧画面表示为一张 64×64 的整数网格,每个数字对应一种颜色。这套表示信息无损,但和模型的视觉先验完全错位:模型在预训练里见过的是图片,不是数字矩阵。
VISTA 的第一个改动是把数字表换回渲染后的 PNG 图片:64×64 的官方帧做 8 倍最近邻放大,成为 512×512 的图像,格子之间画上一像素的网格线。模型从头到尾只看图片,甚至不会被告诉「这个世界是 64×64 网格」。
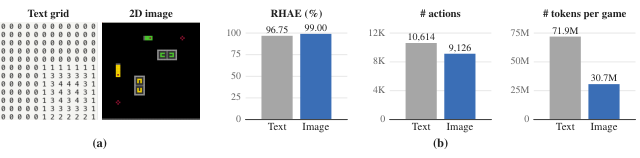
对照实验的结果分两层。单纯看分数,文字网格并不差:GPT-5.6 Sol 后端下文字网格 96.75 分、图像 99.00 分。但效率差距悬殊:64×64 文字网格一帧要消耗约 4,000 个 token,512×512 图片只要约 308 个;平摊到每局游戏,文字版烧掉 7,190 万 token,图片版是 3,070 万,不到一半。25 个游戏的总动作数也是图像版更少(10,614 对 9,126)。信息等价的两种表示,计算成本差了一倍以上。
瓶颈二:KV Cache 留不住画面
第二个瓶颈在记忆。标准 VLM 的历史记忆靠上下文窗口里的 KV cache:上下文一满就压缩或丢弃旧帧,模型想回头核对某个细节时,那一帧往往已经不在了。
VISTA 的做法是把游戏返回的每一帧(包括动画中间帧)按「回合编号 + 帧编号」原样存档,建立一套无损视觉记忆。模型通过两个工具回看:inspect 调出任意历史帧、任意区域,可以多帧并排、可以局部放大;read_pixels 读取指定区域的精确像素颜色。按评分规则,这些回看操作不计步数,只有真正操作游戏的 play 才计步。论文把这套机制称为「显式注意力」——回看哪一帧、放大哪一块,全部由模型自己决定,而不是调度器写死的流程。
配套地,模型还有两个笔记文件:GUIDE.md 记跨关卡可复用的游戏规则,WORKING.md 是当前关卡的草稿纸。上下文临近上限时,模型写一份简短的状态交接,在新上下文里继续,笔记和视觉记忆全程保留。
给模型的全部指令只有四句话,核心是「用尽可能少的游戏动作通关游戏;建立并维护一个紧凑、可修订的游戏模型;每次行动前简述预期,行动后简述所有可见变化」。没有任何一句教它具体怎么玩。
代码派一个夏天,笔记派三句话
VISTA 之前刷爆 ARC-AGI-3 社区榜的方案——Schema、Tycho、Retrodict——走的是程序合成路线:让大模型为每个游戏写一套可执行的世界模型(状态表示 + 转移规则 + 目标条件),在模拟器里搜索最优动作。这条路有效,代价是每个游戏几千行代码。
论文给了 LF52(一个跳棋机制游戏)的直接对比。Schema 团队发布的该游戏世界模型约 4,000 行 Python,71 个函数中的一个就要处理「绿色棋子正交跳跃」的合法性判断:枚举四个方向、检查落点和被跳棋子的状态。VISTA 的模型在 GUIDE.md 里用三句话记下同一条规则:绿子点击后跳到两格外的空位、被跳过的绿子移除、紫色基座是固定跳板可被任意棋子跨越。一页笔记换四千行代码,VISTA+Opus 5.0 在这个游戏拿了满分。
论文的立场是:大量通往正确动作的推理可以在自然语言的模糊性里完成,不必编译成可执行程序。这在游戏之外意义更大——真实世界里没有人会提前给你写好一套 4,000 行的模拟器。
成绩单与横向对比
Opus 5.0 后端的完整成绩:25 个游戏全部 100 分,183 关全通,总共 7,542 步(人类基准的 56%)。逐关数据里有几个值得展开的案例:
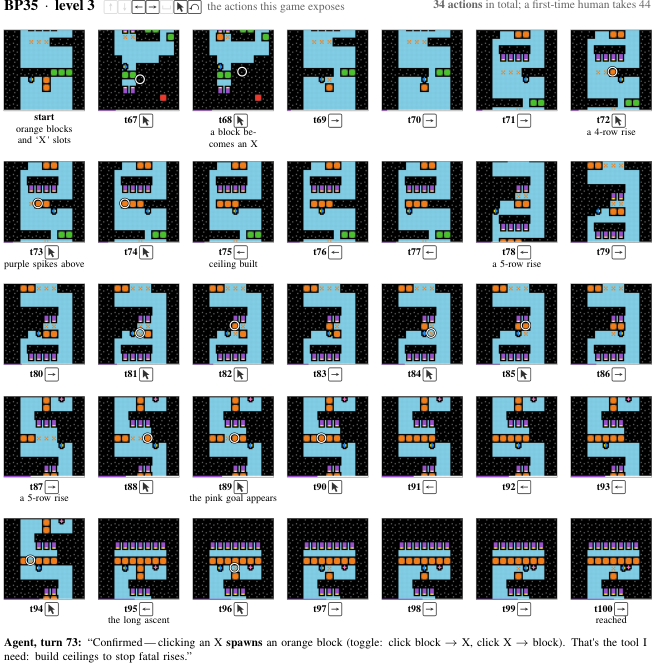
BP35 第 3 关:人类首次通关 44 步,模型 34 步。时间线显示它点击一个橙色方块后,方块变成了 X——它随即停下,把前几帧动画调出来并排比对,搞清了「点 X 能让橙块重新长出来」的开关机制,然后在笔记里写下:这就是我要的工具,用它搭天花板,挡住会要命的上升。
m0r0(吃豆人机制):人类基准 1,107 步,模型 256 步,是全部 25 个游戏中人机差距最大的一关。迷宫里豆子吃一颗少一颗,模型在第 13 回合和第 36 回合两次强行翻回开局第一帧去核对地图。
cn04:人类 789 步,模型 235 步(0.30 倍)。
与社区榜并行方案的横向对比(同一批公开游戏):
| 系统 | 是否程序合成 | 模型 | RHAE |
|---|---|---|---|
| 官方最小接口 | 否 | GPT-5.6 Sol (max) | 13.33 |
| 官方最小接口 | 否 | Opus 5.0 (high) | 40.68 |
| Schema | 是 | GPT-5.6 Sol | 95.35 |
| Schema | 是 | Opus 4.8→Fable 5 (max) | 98.98 |
| ewma_sv_v1.6 | 是 | GPT-5.6 Sol | 98.97 |
| Retrodict | 是 | GPT-5.6 Sol | 99.86 |
| Tycho | 是 | GPT-5.6 Sol / Opus 5.0 | 100.00 |
| VISTA | 否 | GPT-5.6 Sol (max) | 98.27(论文正文 99.00) |
| VISTA | 否 | Opus 5.0 (xhigh) | 100.00 |
Tycho 同样拿到 100 分,但它依赖程序合成;VISTA 是已知第一个不写程序就达到满分/近满分的系统。
消融:三组反直觉的数据
论文的消融实验(GPT-5.6 Sol 后端,200K 上下文默认配置)给出三组值得玩味的数据:
上下文不是越大越好。 默认 200K 上下文拿到 99.00 分,每局消耗 3,070 万 token;开到 780K,token 涨到每局 1.057 亿,分数反而更低;砍到 100K,分数只降 0.4,token 近乎减半。
分辨率也不是越高越好。 8 倍放大(512×512,每帧 308 token)是默认配置;降到 2 倍(128×128,20 token)性能明显受损;升到 16 倍(1024×1024,每帧 1,229 token)没有额外收益、每局成本更高——多出来的 token 占掉了上下文,模型却没有看得更明白。另一头,4 倍放大用默认配置四分之一的 token 就拿到相当的成绩。
换个 320B 开源模型,框架照样抬分。 用开放权重的 GLM-5.3 Flash 320B 做后端,官方最小接口成绩低迷,VISTA 拿到 66.93 分。这是论文里唯一一组开源可复现的完整结果。
走出 2D:三个通用环境
同一套框架最小改动后泛化到另外三个基准:GameWorld(34 个浏览器游戏、170 个任务)、AI GameStore(10 个网页游戏,成绩按人类中位数归一化)、BabyVision(388 道静态视觉推理题)。GameWorld 上成功率 63.33%±2.37%,超过人类新手的水平;BabyVision 上,官方实现 41.0%,VISTA 63.2%——静态看图题没有交互历史,提升全部来自「放大看」这个动作本身。
把同一批游戏渲染成 3D 场景后(视角、光照都变了),RHAE 降到 84.12,步数涨到 20,640,但仍然大幅超过官方基线。这说明框架对观察表示不敏感:文字网格、2D 图、3D 场景都能跑,模型甚至能在没人告知的情况下自己发现视觉概念。
分数的边界
论文对自己的成绩单留了一段冷静的边界说明:所用模型发布时间晚于公开游戏,无法排除这些游戏进入过训练数据的可能,ARC-AGI-3 的私有集才是对泛化能力的真正检验。这是所有刷榜结果共有的不确定性,官方记分卡能验证的是「这 25 个公开游戏上发生了什么」,不能证明私有集表现。
即便把边界画在这里,VISTA 的信息量依然清晰:模型权重没动一个参数,40.68 到 100.00 的差距全部来自「让模型直接看图、让它随时能翻回去看」。ARC Prize 联合创始人 Mike Knoop 的判断是,越来越多的「学习」会发生在模型权重之外。具身环境是何恺明团队的下一站——那里的世界不会有人提前翻译成一张数字表。
来源:
- 论文:VISTA: A Visual Harness for Reasoning in an Interactive World(arXiv:2610.02200)
- 项目页(含 25 游戏完整记分卡与回放):vista-research.github.io
- ARC Prize 官方对 GPT-5.5 / Opus 4.7 的失败模式分析:arcprize.org