10 月 2 日的 GitHub Trending 上,一个已经拿过月度第一的老项目重新冲回榜单:JuliusBrussee/caveman,108,938 stars,日增 271。驱动它重新上榜的是 9 月 30 日发布的 v3.0.0——这个让 AI 编码代理「像原始人一样说话」的工具,把整条产品线(引擎、代理、CLI、两套 SDK、middleware)全部转成 Apache-2.0,middleware 升到 1.0 稳定版,Learn 子系统改成会自己跑的后台巡检。一个 4 月以玩笑起家、一周拿 4,000 star 的技能文件,到 3.0 版本已经变成一套可托管、可嵌入、带独立第三方实测数据的三层 token 优化体系。这篇文章拆开看它的架构、它公开的数字,以及它在什么情况下反而让你花更多钱。
从一句玩笑到三层架构
Caveman 的出发点是一条技能规则文件:让模型用电报式的「原始人语」回答——丢掉客套铺垫,保留代码、命令、路径和报错原文。README 里的对比示例能看出它的取舍:同样是解释 React 组件重渲染,普通回答用 69 个 token 铺陈原理,caveman 版 19 个 token 直接给出「每帧新建对象引用、内联对象 prop 触发重渲染、用 useMemo 包住」的结论。修复方案一模一样,死掉的只有开场白。
这条安全边界是刻意设计的。技能文件永远不会压缩三类内容:代码本身、错误消息原文、安全确认语句。遇到不可逆操作或「are you sure」级别的警告,代理会自动切回完整句子说清楚,然后再切回短句模式。换句话说,它压的是模型的「嘴」,不是模型的「脑」。
但 JetBrains 在 2026 年 7 月的实测揭开了这个技能的天花板:在 86 个真实编码任务上做配对 A/B(Claude Code 2.1.200、claude-sonnet-5、Harbor 沙箱、约 240 次计费试验、总花费约 106 美元),强制开启 caveman 技能只减少了 8.5% 的输出 token,质量无统计差异(sign test p=0.82)。原因在于编码代理的 token 大头在「读」这一侧:日志、测试输出、diff、JSON、搜索结果,这些技能文件一个都碰不到。JetBrains 的结论反过来说明:想省 token,得压缩「读」的那一侧。
这就是 caveman 从一个技能文件长成三层架构的原因。v3.0.0 的三个组件各管一头:
- 技能(skill):压缩代理「说」的,一个规则文件,装进 30 多种编码代理(Claude Code、Codex、Gemini CLI、Cursor、Windsurf、Cline 等),
npx skills add JuliusBrussee/caveman -g一条命令,免费。 - 代理(proxy):压缩代理「读」的。一个跑在本地的进程,卡在编码代理和模型提供商之间,把工具输出、日志、JSON、diff、网页在进入上下文之前先压一遍。原文逐字节存进本地 SQLite,返回一个恢复句柄,模型随时可以取回完整版。
- 中间件(middleware):压缩「你自己的应用」发出的。给 LangChain、Vercel AI SDK、OpenAI、Anthropic 调用包一层 wrapper,v3.0.0 起稳定在 1.0.0,TypeScript 和 Python 双实现,适配器列表覆盖 20 多个框架。
代理这一层是怎么压缩的
代理的核心是一条 detect() 分型管线:先判断载荷类型,再路由给对应的压缩器,每类保留「答案依赖的内容」、丢掉其余:
| 识别类型 | 保留什么 | 目标节省 |
|---|---|---|
| json | 键名、结构、错误子树,折叠重复数组 | 70-90% |
| log | 报错、堆栈、首尾行,丢 INFO 和进度噪音 | 85-95% |
| code | import、签名、类型,省略函数体且语法保持合法 | 40-70% |
| diff | 文件/hunk 头和变更行,折叠重复上下文 | 60-80% |
| search-result | 排名头部命中加诊断/安全命中 | 80-95% |
| text / HTML | 标题、开头结尾、关键段落 | 50-80% |
压缩之前先落盘:每个被压缩的字节都有本地 SQLite 里的逐字节备份,代理拿到的是一个 X-Caveman-Recovery-Handle 恢复句柄,MCP 侧信道提供 caveman_retrieve 工具让模型按需取回原文。任何 MCP 宿主还能拿到 caveman_compress、caveman_stats、caveman_toon_encode/decode 四个配套工具。整条链路里没有 caveman 的服务器——你的 Claude Pro/Max 登录态原样透传给 Anthropic,密钥留在本机。
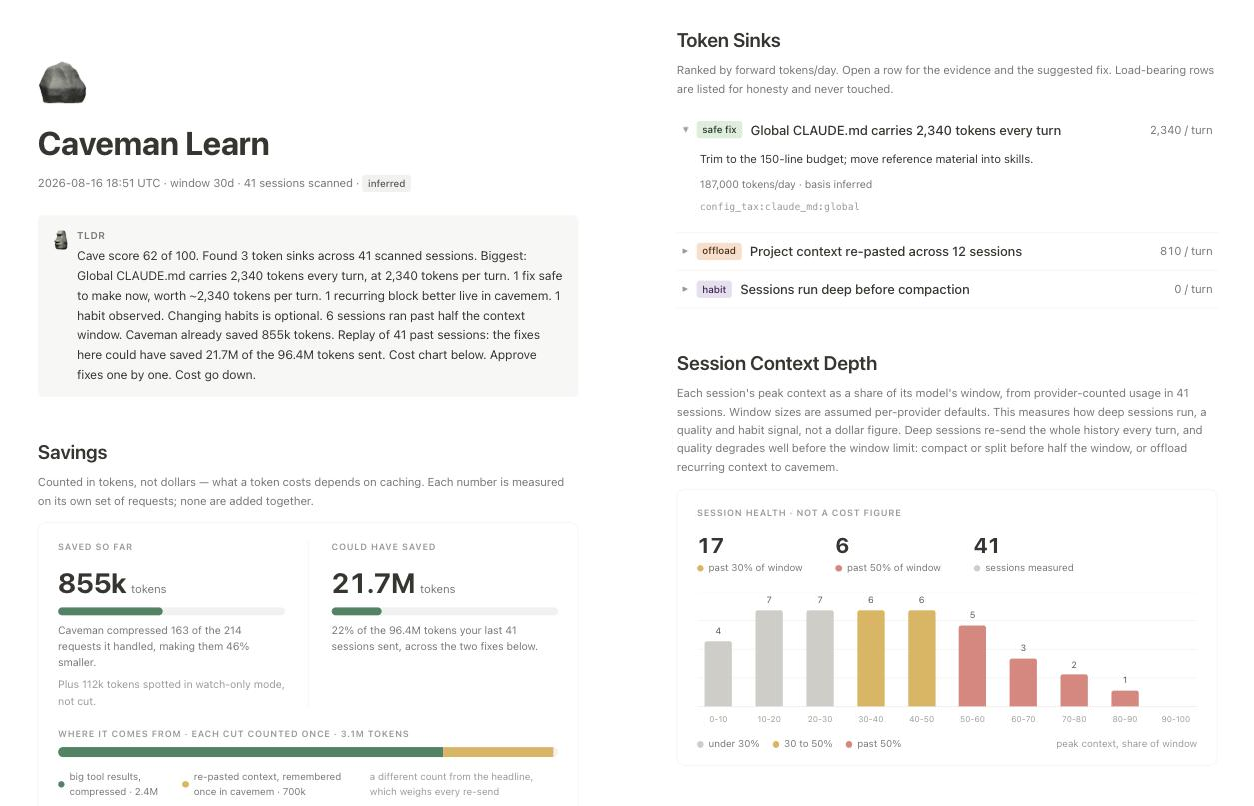
配套的 caveman learn 是账单分析器。它本地只读地扫你磁盘上已有的数月代理会话历史,把 token 去向从大到小排队,每个大户后面跟一条一行修复。它能抓出的坑相当具体:Claude Code 只加载 MEMORY.md 的前 200 行(或 25KB),超出的部分代理根本看不到但没人告诉你;同一条规则被两个文件重复加载,每条消息都为它付两次钱;CLAUDE.md 里引用的路径早已不存在。v3.0.0 把它改成 autopilot 模式——会话结束后低优先级后台复扫,最多每 6 小时一次,发现新的大户才在下次会话开头提示一行。每次修复前先征求同意,改完重新计量,没有让每条消息变小的修复会被自动撤销。
数字:哪些经得起第三方验证,哪些是自测
Caveman 的 README 把数字分成三个来源等级,这个结构本身就值得看。
第三方实测(最硬的一层)。Adobe Research 的 CAVEWOMAN 论文(arXiv 2606.24083,2026 年 6 月,作者 Adeyemi、Rossi、Dernoncourt)把「原始人文风」当成一个被基准测试过的语域来研究:8 个模型、5 个数据集、5 档压缩强度。结论分两半——输出侧压缩确实省钱,多数 API 模型的单位成本降到 1.4-2.4 倍(最好情况 3 倍);输入侧压缩是严格的负和:模型收到被压短的 prompt 后会用更长的回答来补偿,五基准均值净成本反升约 1.15 倍,最差数据集升到 1.8 倍,强压缩下 2.7 倍。所以 caveman 从不重写你的 prompt,只动代理自己的输出。JetBrains 的 86 任务 A/B 补上了代理场景的那一半:输出 token 省 8.5%,质量打平。
仓库自测(固定基准,方法公开但原始工件未发布)。54 次运行的 Claude Code 固定套件,提供商口径的输入 token,每个案例跑三遍,答案逐一对着已知正确答案校验:总输入从 885,793 降到 591,673,省 33.2%;18 个答案检查全过;按案例聚类的 95% 置信区间是 14.6% 到 48.5%。同套件里 Headroom 的包装只省 6.7% 且 3 个答案错误。这张表里有一行红字:Dashboard HTML 案例不降反升 9.9%——那个案例没有可用的压缩变换,代理只付了自己的开销。维护者在表旁边写了一句:「我哪天把红行藏起来,你就该不再信绿行了。」
诚实清单(自曝亏损场景)。docs/HONEST-NUMBERS.md 列了三种净亏钱的情况:简短的一问一答编码场景,技能规则本身每条消息注入约 1,000 token,短输出省不回这个成本(issue #145 有用户实测净亏);按请求计费的产品(GitHub Copilot 的 premium requests),答案再短也是同一次请求,省不了额度(issue #506);工具侧计数失控的场景,一个 Cursor A/B 实测开 caveman 后 430 万 token、关掉只要 100 万(issue #550,该次运行无法复现,但规则重注入、重试和缓存计费确实可能吞掉全部节省)。README 给的自查命令是 caveman trial -- claude:同一个真实任务开关各跑一遍,对着提供商账单页比数字,「这个 A/B 比本页任何数字都大」。
v3.0.0 变了什么
9 月 30 日的这次发布做了四件事。
许可证统一成 Apache-2.0。 此前仓库混用许可,SDK 是 MIT;从 3.0.0 起引擎、代理、browse、MCP server、shrink、cavemem Go 核心、共享平台全部 Apache-2.0,没有托管服务限制条款、没有 Change Date、不需要商业授权。历史版本保留发布时的旧许可,外部贡献者的 MIT 代码单独放在 LICENSE-MIT。对一个 75 个贡献者的项目来说,这一步是把「能不能拿去公司内部部署」的问题彻底关掉——README 原话:fork it, embed it, run it for your company。
middleware 1.0 + SDK 1.2。 中间件从实验版转正,适配器失败时默认 fail-open:caveman 出问题,你的请求原样通过并给一条响亮警告。代理侧加了租户身份、Postgres HA 存储、TLS/mTLS 和 HA 部署清单,协议 schema 以 @caveman-ai/contracts 2.0.0 发布。
Learn 自动化。 前面说的 autopilot、记忆文件体检(抓 Claude Code 只读前 200 行的漏加载、失效的 @imports、重复加载的规则)、周同比趋势(取每周中位数会话,不足 5 个会话就明说数据不够),都进了一个不需要人记得去跑的后台循环。
遥测默认开启。 CLI 及其代理钩子默认发送使用统计(随机安装 ID、IP、命令计数、token 数),90 天后抹掉 IP、13 个月后删其余,明确声明不发送 prompt、代码和文件路径。技能单独使用不发送任何东西。不想要就 caveman telemetry off 或设 DO_NOT_TRACK=1,跑一次还会打印安装 ID 供你要求删除已发数据。默认开、一行关、删得掉,这组设计在独立开发者的项目里算是把选择权交还得很干净。
使用边界
把三层拆开看适用面:技能层适合任何「读回答多过粘贴代码」的场景,JetBrains 的结论是「好玩,且质量无可见损失」,只是别指望大额节省;代理层才是账单大头所在——长会话、多日志、多测试输出的工作流,33.2% 的输入节省发生在这一层;middleware 层面向自建代理应用的团队,fail-open 保证了接入风险的下限。
该跳过的场景同样明确:纯代码生成、几乎没有散文可删的工作流;按请求计费的产品;简短一问一答(规则注入成本收不回来)。维护者自己写的判断标准是最终口径:同一个任务开关各跑一遍,对着提供商账单页比总数,省亏立现——如果 caveman 让你的任务变贵,就为那个工作流把它关掉。
一个 4 月的玩笑项目走到 3.0,它真正交付的产品,是这套把「说、读、发」三个token出口分开计量、分别压缩、逐字节可回滚的体系,外加一份把亏损场景写在自己 README 里的诚实清单。
说明
- 仓库与发布说明:JuliusBrussee/caveman、Caveman 3.0.0 Release(2026-09-30)
- 第三方实测:JetBrains:Speaking to AI Agents like Cavemen Saves Tokens. We Test.(2026-07);Adobe Research,CAVEWOMAN: How Large Language Models Behave Under Linguistic Input and Output Compression,arXiv:2606.24083,DOI 10.48550/arXiv.2606.24083
- 仓库自测口径:README「The Numbers」节及 docs/HONEST-NUMBERS.md、docs/WRAP-BENCHMARK.md;54-run 固定基准的原始工件未随仓库发布,数字为固定报告口径
- 配图为项目官方素材:仓库 og:image、官方 wrap-stack 架构图、Learn 报告界面截图