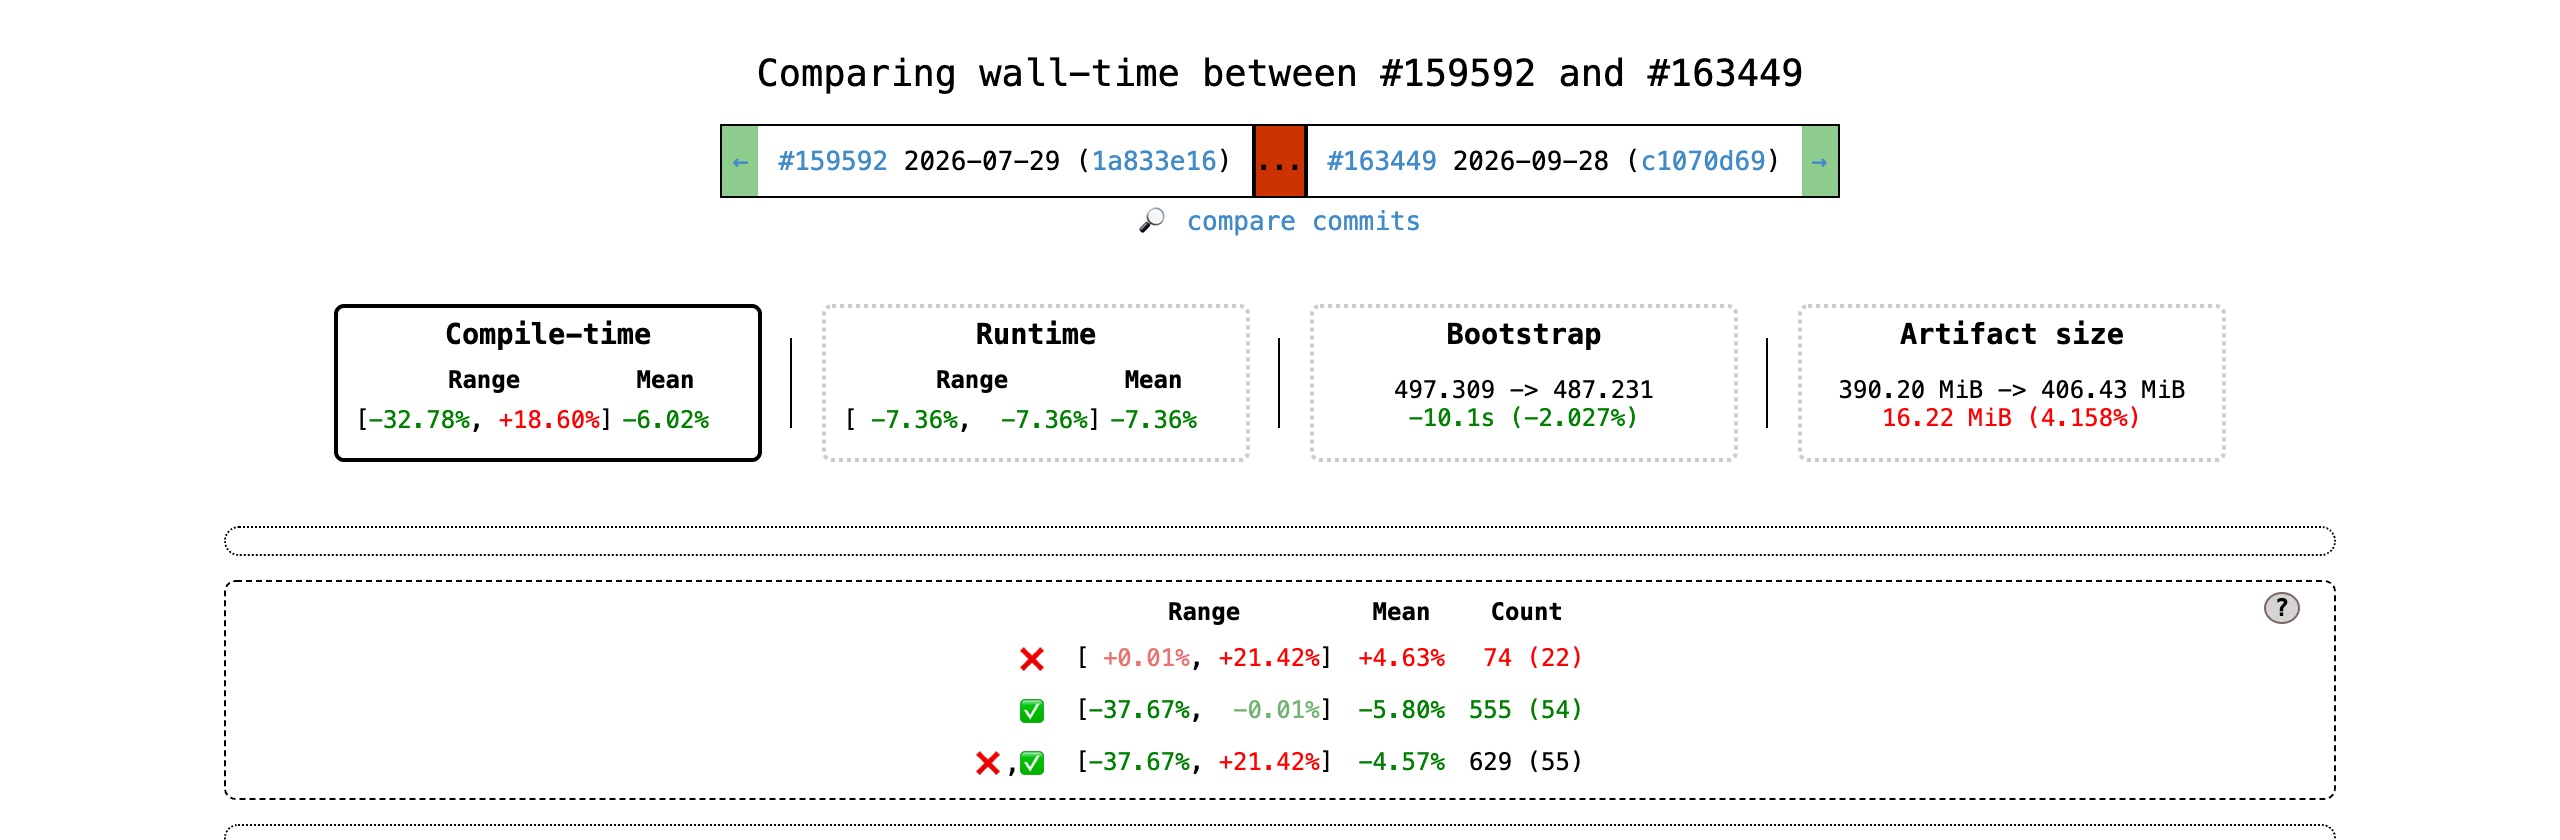
10 月 1 日,Hacker News 上有一篇帖子爬到了首页:Nicholas Nethercote 的月度总结《How to speed up the Rust compiler in September 2026》。文章覆盖的是 2026 年 7 月 29 日到 9 月 28 日这两个月,Rust 编译器(rustc)在这段时间里交出了一份相当罕见的成绩单。
Nethercote 是 Rust 编译器性能领域最重要的贡献者之一,从 2020 年起持续撰写编译器性能的月度与季度总结。这一次的数据来自 Rust 官方基准测试平台 perf.rust-lang.org:629 项基准测量中,555 项编译耗时下降,74 项出现回退,平均墙钟时间下降 4.57%。两个月内拿到这个幅度的整体改进,在这份基准的历史上屈指可数。他给这个结果用了基准测试圈的黑话:a sea of green(一片绿海),意思是基准对比页面上的改进条目多到把回退完全淹没。
对 Rust 开发者来说,编译速度是这门语言最持久的一项抱怨。cargo build 等待的时间在社交媒体上被做成了无数梗图,也有人因为它放弃了把 Rust 引入生产环境。这两个月发生的事情,恰好是多个长期项目同时到了收获期。
先看总账:整体与个体
先看官方基准平台给出的汇总。以 7 月 29 日的提交和 9 月 28 日的提交做对比:
- 编译耗时(wall-time):均值下降 6.02%,区间从 -37.67% 到 +18.60%
- 运行时性能(runtime):均值 -7.36%
- 引导编译(bootstrap):497.309 秒降到 487.231 秒,节省 10.1 秒
- 编译器产物体积:从 390.20 MiB 涨到 406.43 MiB,增加 16.22 MiB
博客正文引用的均值是 4.57%,基准平台页面的汇总框显示 6.02%。两者都对:4.57% 是 Nethercote 引用的两个月整体均值,6.02% 是同一平台按不同统计口径(计入或排除部分基准的组合方式不同)得出的数字。开发者引用任何一个,都需要说明出自哪张表。本节其余数字全部来自基准平台汇总框和博客正文原文。
中间三行数字值得单独看。运行时性能提升 7.36% 意味着升级编译器版本的现有项目,编译出的程序跑得也更快了,这主要来自 LLVM 升级(后文展开)。引导编译时间只降了 2%,因为它是全量构建编译器自身,受单个优化影响小。产物体积上涨 4.15% 是这几个数字里唯一的"变差",编译器二进制变大通常与新代码加入和内联策略变化有关,对用户项目没有直接影响。
Clippy 开启 PGO:一个 PR 拿下 18%
这两个月里单点收益最大的工作之一,来自一个并不新鲜的编译优化技术:PGO(Profile-Guided Optimization,配置文件引导优化)。
原理说起来不难。编译器自己也是一个程序,也由编译器编译。普通编译对所有代码一视同仁,而 PGO 先让程序在真实负载下跑一遍,记录哪些分支最常走、哪些函数最常调,再用这份"画像"重新编译,让最热的代码路径按最快的方式布局。
PR #159642 由 Jakub Beránek 提交,给 Clippy(Rust 官方的静态检查工具)启用了 PGO。效果是大多数 Clippy 基准的墙钟时间下降,最好情况下降低 18%。开发者每次运行 cargo clippy 都在等待这个工具扫描代码,18% 的时间节省直接缩短每次提交前的反馈循环。
这里有个容易被忽略的工程背景:PGO 本身是 LLVM 的成熟特性,没什么技术门槛,真正的工作量在于把基准画像采集和发布流程接进 Rust 的 CI 体系,让每个发布版本的 Clippy 都带上 PGO 优化。工具类基础设施的提速,往往卡在流程而非算法。
LLVM 23:一次升级换 1.2%
PR #158734 由 Nikita Popov 提交,把 rustc 使用的 LLVM 升级到 23 版本。这次升级给所有基准带来平均 1.2% 的墙钟时间下降。
1.2% 听起来微不足道,但放到上下文里就不一样了:这是一个 PR 带来的全局改进。rustc 的编译后端完全委托给 LLVM,Rust 团队自己的优化大多集中在前端(类型检查、借用检查、中间表示转换),后端的免费提速只能等 LLVM 上游进步。每次 LLVM 升级,rustc 都能白捡一轮后端优化。过去几年 LLVM 的版本节奏稳定在半年一版,这条"随升级免费提速"的通道对 rustc 来说是长期红利。
运行时性能那 7.36% 的均值下降,主要也归功于这次 LLVM 升级,因为后端代码生成质量直接决定产出程序的运行速度。
两座大山同时启动:Polonius 和下一代 trait solver
这两个月最重要的两件事,都不是某个单独的优化:rustc 两个重构时间最长的子系统同时迈上了 Nightly 通道。
Polonius Alpha:新的借用检查器
8 月 4 日,Rust 官方博客宣布 Polonius Alpha 在 Nightly 上启用。借用检查器是 Rust 的标志性组件,负责在编译期拒绝所有可能引发内存安全问题的代码。现役实现叫 NLL(Non-Lexical Lifetimes),2019 年上线。Polonius 这个名字从 2018 年就出现了,它是一个更精确的借用检查模型,能接受一些被 NLL 误伤的合法代码,但原始实现的性能一直达不到实用标准,项目停停走走多年。
这次启用的 Polonius Alpha 是 2023 年提出的新方案,重新设计了算法结构,让它可以在 NLL 现有实现上渐进扩展。官方博客给了个典型例子,get_mut_or_default 这类"从 map 里取值、取不到就插入默认值"的写法,NLL 会误报借用冲突,开发者只能改写代码绕开;Polonius Alpha 的分析是流敏感的(flow-sensitive),能看出 None 分支里那个借用已经死了,直接放行。
代价是它做的事严格更多。官方对 crates.io 下载量前一万名的 crate 跑了测试,发现了少量"显著"回退,幅度大多很小。博客里提到的 serde 就是受影响的流行 crate 之一。
Jack Huey 在 9 月提交了两个 PR 给 Polonius 减负:#161938 把活跃性计算改成惰性求值,serde 的指令数下降 3% 到 5%;#163027 调整了一个数据结构并修改内联策略,多个基准指令数小幅下降。Nethercote 特意强调,从整体数据看,Polonius 带来的回退已经被其他改进淹没,629 项基准里 555 项改善就是证据。
下一代 trait solver:四年后接近稳定
8 月 21 日,Rust 官方博客宣布下一代 trait solver 在 Nightly 上默认启用。官方博客对它的定位措辞是:这是 Rust 编译器自诞生以来最大的单次变更,完全替换了 where 子句求证、关联类型归一化等核心机制。
trait solver 是 Rust 类型系统的心脏。T: Clone 这样的约束是否成立、泛型代码里每个类型参数到底对应什么类型,都由它来推理。旧求解器的架构问题积累多年,Type Alias Impl Trait、Return Type Notation 等一系列语言特性被它阻塞,还有超过两百个已知的类型系统 bug 与它相关。新求解器一次解决了这批问题。
性能方面,官方博客给了一个极端例子:一个把国际象棋规则编码进 Rust 类型系统的程序,旧求解器会直接挂起,新求解器一分钟内出结果。更实际的例子是 datafusion(Rust 生态重要的数据分析库),编译速度提升超过 8 倍。Jana Dönszelmann 写了一篇专门的文章讲新求解器的性能优化工作。
和 Polonius 一样,新求解器也在少数场景更慢。Nethercote 自己在 9 月提交了六个相关 PR(#160479、#160605、#160801、#160892、#161077、#161211),其中几个对特定 crate 的编译时间有明显效果:有的 crate 编译时间砍半,有的降 25%,有的降 15%。
算法替换:150 万次调用变成 9 万次
这两个月里最能体现"优化该做在哪"的案例,是 Nethercote 提交的 PR #160193。
rustc 的数据流分析(borrow checking 依赖它)需要反复遍历控制流图(CFG),迭代到达不动点为止。遍历顺序决定收敛速度。cranelift-codegen 这个 crate 里有一个超过 18000 个基本块的巨型函数,旧遍历算法跑 EverInitializedPlaces 分析时需要调用 150 万次 apply_effects_in_block 才收敛;换了新算法,9 万次就够。这个 crate 的 check build 墙钟时间因此下降约 30%。
同一个函数,没有改任何分析逻辑,只是换了遍历顺序,调用次数差出 16 倍。 Hacker News 评论区把这条单拎出来讨论,一条高赞评论说,最大的编译器优化往往来自更换算法而不是调优热循环,#160193 正是这样一条 PR。
同类的还有 xmakro 的三个 PR:#157281 优化特化图构建时的 impl 处理,全基准平均周期数下降 1.58%;#158059 优化增量编译数据加载,最好情况指令数降 6%;#160473 消除一条热路径上的多余内存分配。这最后一条还有个插曲:同样的思路 Nethercote 在更早的 #155714 里试过,当时在个别基准上出现回退,没有合入;xmakro 换了静态派发替代动态派发的实现方式,把这件事做成了。同一个优化思路,实现细节决定成败。
CI 与流程:性能工作多了到什么程度
有几个细节能说明这两个月性能改进的密度。
一是 rollup PR 的变化。Rust 项目因为 CI 容量不足,习惯把多个小 PR 打包成一个 rollup 合并。常规做法是影响性能的 PR 单独合并,保证每个 PR 的性能影响可测量。这两个月性能改进 PR 多到什么程度呢?Jonathan Brouwer 打了一个包含 10 个性能改进 PR 的 rollup,这在历史上是第一次;后来的 #162859 又打包了 4 个。因为合并后还能对单个 PR 补跑基准验证预期效果,打包不会让影响测量失真。
二是产物体积换来的人工优化。Chris Denton 在 #160535 里把编译器默认栈大小调大,删掉了散落在递归热点路径上的手动栈扩容机制 ensure_sufficient_stack。这个改动的讨论持续了很久,焦点是栈耗尽该怎么处理才稳妥,最终的性能收益是多条基准指令数下降,最好情况接近 3%。
三是 LLM 用在了分析环节。Nethercote 提到,他仍然亲手写全部代码和文字(项目政策也要求如此),但在本文提到的多个 PR 上,LLM 辅助做了不少分析工作。Rust 项目有专门的 LLM 使用政策页面,划定了允许的边界。核心开发者把 LLM 用在"找问题"而不是"写代码"上,这个用法在这两个月的性能工作里已经常规化。
这份成绩单的后续
Nethercote 在文末透露,他第二天将入职 Hexcat,参与 Rust 官方的编译器性能优化目标项目。这个项目是 Rust 官方 2026 年目标体系的一部分,官方目标页面列出的主攻方向就是编译性能。核心个人贡献者转入专职岗位,意味着这轮提速不是阶段性冲刺,接下来还有持续的投入。
Polonius Alpha 和下一代 trait solver 都计划在接下来几个月内稳定。前者上线后,被 NLL 误伤的代码可以少写绕行逻辑;后者稳定后,被旧求解器阻塞的语言特性会陆续解封。两者在 Nightly 上接受测试的阶段,恰好是开发者反馈影响最大的窗口:rustup update nightly 拿到最新版本,跑一遍自己的项目,遇到回退或报错去 GitHub 提 issue,就能参与这两个 Rust 编译器史上最大变更的收尾。
基准数据:perf.rust-lang.org(对比 2026-07-29 与 2026-09-28 两次提交) 原始文章:nnethercote.github.io《How to speed up the Rust compiler in September 2026》 启用公告:blog.rust-lang.org(8 月 4 日 Polonius Alpha、8 月 21 日下一代 trait solver)