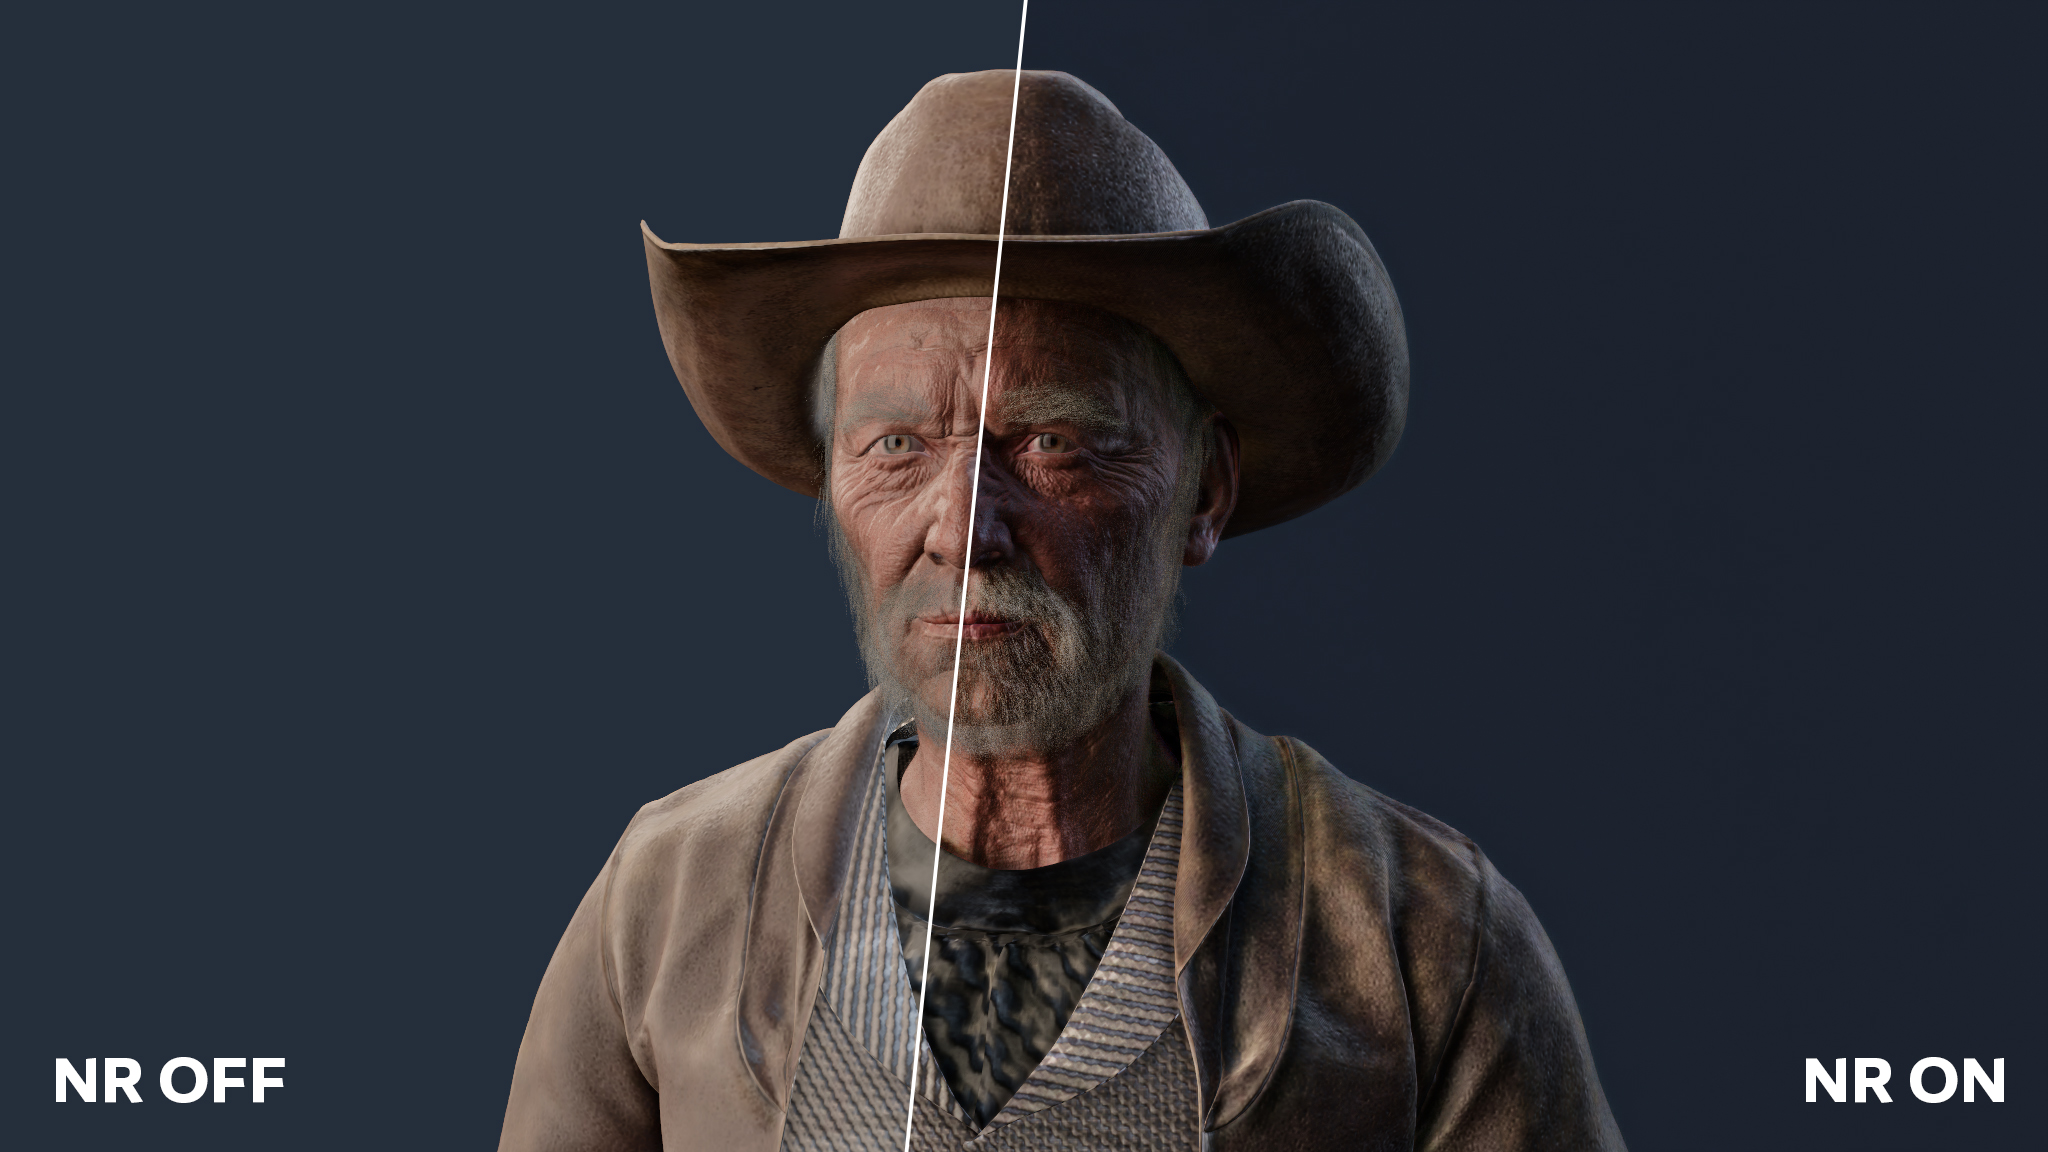
2026 年 9 月 22 日,NVIDIA 正式发布 DLSS 5。它标志着一个转折点:这是第一个不再"重建画面"的 DLSS,而是直接"生成画面"的技术。按照 NVIDIA 官方报告的说法,DLSS 5 是首个生成最终显示画面的 DLSS 技术,据其所知也是第一个实时运行的产品化生成式渲染模型。
发布两周后,一个署名 maanHimself 的开发者在 GitHub 上公开了一个名为 OpenDLSS-NR 的项目:用纯 Vulkan 从零重写了 DLSS 5 的神经渲染网络,并宣称做到逐字节一致(bit-exact)——不只是最终图像,网络内部全部 75 个块边界的中间结果,与官方 DLL 的原始输出字节对字节完全相同。
DLSS 官方技术自 2019 年问世以来从未开源,权重从不公开,论文不提供实现细节。这个项目没有复刻权重本身,而是复刻了"跑这个网络的完整机器",把黑盒内部的结构、精度和调度全部还原了出来。
这个网络到底做了什么
先厘清一个常见误解:OpenDLSS-NR 复刻的 DLSS-NR(Neural Rendering)网络并非超分。它的输入和输出分辨率相同,不放大任何东西。
它做的事属于另一条路线。NVIDIA 官方称之为"3D 引导神经渲染"(3D-Guided Neural Rendering):游戏引擎先把场景渲染成常规画面,然后这个网络在画面之上补全传统管线难以实时呈现的真实世界细节,比如皮肤下的次表面散射、树叶间的光线穿透。引擎渲染的帧是"不可动摇的基础",网络只能在这个基础上生成细节,而不能改变结构。
NVIDIA 在官方报告中给它的分类是生成式神经渲染网络(generative neural rendering network)。工作方式可以概括为:输入一帧渲染图像的低动态范围代理、三条高斯噪声通道、上一帧输出经运动矢量重投影后的历史画面,以及 5 个风格控制标量;输出每像素 4 个通道,3 个是 RGB 残差,1 个是时间混合权重。
一句话概括:网络拿着引擎画好的底稿,注入受控噪声,按开发者设定的风格重新渲染这张图。
网络结构:71 个 Transformer 块的 U 形堆叠
OpenDLSS-NR 的文档完整还原了网络内部结构。它是一个 Swin 风格的移窗 Transformer 和全局 ViT 的混合体:
- 71 个块,6 个池化层级:从全分辨率的 32 通道开始,逐级下采样加宽通道,到最底层的 1024 通道全局 ViT,再逐级上采样回全分辨率,构成一个 U-net;
- FP8 (E4M3) 激活精度:所有跨内核边界传播的数据都用 E4M3 格式(4 位指数、3 位尾数)量化,矩阵乘累加用 FP16;
- 权重总量 141 MiB,全部以 E4M3 打包字节存放;
- 窗口注意力为 8×8,窗口网格每块轮换 4 个相位(常规 Swin 只用 2 个),使每条窗口边界都被不同块跨越;
- 缩放余弦注意力:注意力分数是限幅的余弦相似度乘以可学习的每头温度参数,取代无界点积,这是整个网络能在 FP16 累加器上稳定运行、且权重能压到 3 位尾数网格的前提;
- 底层 ViT 对最粗层级的全部 token 做全局注意力,并把 softmax 的归一化挪到值累加阶段执行,与窗口注意力形成两套不同但都已被逐字节验证的 softmax 变体。
网络末端接一个 32 到 4 通道的输出头:前三个通道是加在代理画面上的 RGB 残差,第四个通道经 sigmoid 变成逐像素的历史混合权重,决定当前帧与重投影历史的融合比例。这个设计让网络自己决定每个像素相信神经生成多一点,还是相信时间累积多一点。
值得强调的是精度上的一个关键细节:全部中间值遵循"先舍入到 FP16,再从 FP16 量化到 E4M3"的发布顺序,且按 RNE(就近舍偶)执行,NaN 发布为 +0、零的符号位保留。这类细节对普通推理无影响,却是字节级一致的前提。
逐字节验证怎么做
"bit-exact" 不是一句口号,项目为此搭了一套三层验证体系:
第一层,块边界捕获比对。 通过对官方 DLL 做插桩运行,录制每一层 Transformer 块输出的 E4M3 激活数据作为参考基准。校验工具 parity 在 512×512 分辨率下比对全部 75 个边界、共 5770 万个 E4M3 字节,全部一致。在 1024×768、1920×1080、2560×1440 和 3840×2160 分辨率下,所有 75 个边界同样逐字节一致。
第二层,CPU 参考实现。 项目附带一个网络算术的 CPU 移植版本,verify 工具把 GPU 每个内核的输出与 CPU 结果逐一对照,不一致时能精确报告到具体某个内核,供 bisect 调试。
第三层,浏览器移植版交叉验证。 ports/browser-webgpu/ 是同一网络的 WebGPU 实现,不使用张量核心、不使用 FP8,在浏览器里靠算法定义(而非硬件指令)做到与捕获基准逐字节一致。同样的字节,三种完全不同的技术路径(Vulkan+张量核心、浏览器 WebGPU、CPU 参考)都能到达,等于从三个独立方向证明了复刻的精确性。
整个验证流程由工具链 bench / profile / parity / verify 组成,任何一行舍入代码写错,75 个边界中会立刻有一个字节对不上。作者还在文档里记录了第一个 parity bug:NVIDIA 的 GLSL 编译器把 float(float16_t(x)) 当成空操作直接优化掉,导致一次中间发布被静默省略——这种坑只有追求字节级一致时才会暴露。
三个实现里的工程决策
仓库里最有分量的部分,是同一网络的三套实现,以及围绕它们做出的一系列公开工程取舍。
纯计算着色器架构:整个系统只用一个计算队列、12 个存储缓冲区绑定槽,不使用任何图像对象和渲染管线。所有数据都是平铺的浮点数组。Vulkan 侧的扩展组合是 VK_KHR_cooperative_matrix + VK_EXT_shader_float8 + VK_NV_cuda_kernel_launch:张量核心的 FP8 MMA 指令通过 Vulkan 的 cooperative matrix 接口暴露,而性能关键的内核则由 Python 脚本生成 PTX 汇编,经 VK_NV_cuda_kernel_launch 由驱动 JIT 后注入同一命令缓冲区。GLSL 路线作为可读的"规范",PTX 路线作为实际运行的高速路径,两者必须产出相同字节,且这一约束被纳入日常一致性门禁——文档明确提到,正是因为有这道门禁,两个已经悄悄腐坏的 GLSL 参考内核才被及时暴露。
绕过屏障的链式调度:两次内核启动之间的 Vulkan 屏障代价约 1 微秒,更糟的是会清空 GPU 流水线。这个网络的每帧要跑 241 次内核启动,屏障开销是主要瓶颈之一。作者的方案是移除相邻 PTX 内核之间的屏障,改用显存里的同步计数器:生产者内核完成后递增计数,消费者内核自旋等待。这套机制依赖一个 NVIDIA 硬件行为(同一队列上先启动的工作组先被调度),而这不是 Vulkan 规范保证的。项目为此内置了看门狗:任何等待超过 1 秒即判定假设失效,放弃该帧、回退到屏障模式重见图,把"可能挂起"降级为"可观测的失败"。4K 分辨率下整帧 29.3 毫秒,这个安全网的存在成本可以忽略。
固定顺序的 softmax:归一化的求和顺序被精确固定(相邻配对、奇偶分组、指定树形结构),因为浮点加法不满足结合律,求和顺序改变一个位,输出就不再是字节一致。注意力指数部分也没有传统的减最大值操作,改用带钳位的线性化指数计算,这个非常规选择同样来自对原始 DLL 的逆向工程。
性能
在 RTX 4070 SUPER(Ada 架构)上,完整网络单帧推理取 40 帧最小值:
| 分辨率 | 单帧耗时 | 每帧计算量 | 实测算力 |
|---|---|---|---|
| 512×512 | 2.72 ms | 139 GFLOP | 51 TFLOP/s |
| 768×768 | 2.83 ms | 297 GFLOP | 105 TFLOP/s |
| 1920×1080 | 7.77 ms | 1021 GFLOP | 131 TFLOP/s |
| 2560×1440 | 12.6 ms | 1730 GFLOP | 137 TFLOP/s |
| 3840×2160 | 29.3 ms | 3907 GFLOP | 133 TFLOP/s |
241 次调度在所有分辨率下保持不变。1080p 到 4K 区间呈线性扩展,稳定在约 133-137 TFLOP/s,接近该卡 FP8 张量峰值的一半。小分辨率区间则受限于每个阶段的计算量过小、无法填满 GPU,加上 241 次启动的固定开销。
另一个分布特征来自 U 形结构本身: U 形结构(每降一级,token 数量减少四分之三、单 token 计算量约翻两番),各层级的 FLOP 占比相当均匀,从 11.5% 到 17.6%。时间分布则不均匀:全分辨率的两块是长时间流式处理,占比低于算力占比;最底层的 ViT 因为只有 192 个 token 喂不满机器,是唯一需要 split-K 的阶段。
WebGPU 移植版在 512×512 下单帧 72 毫秒,约为 Vulkan 路线(2.7 毫秒)的 26 倍,证明了浏览器没有张量核心和 FP8 时付出的真实代价,也说明它在功能验证上的价值远大于实际帧率价值。
权重在哪、法律边界在哪
明确说:这个仓库里没有权重。
权重仍需用户自行从安装了 DLSS 5 的游戏目录中提取。项目定义了开放的 manifest.json 目录格式(包含 SHA-256 校验),加载时会验证网络结构,块数不是 71 的模型直接拒绝载入。
README 中明确声明:项目与 NVIDIA 无关联、未获认可;仓库不含任何 NVIDIA 软件、权重、头文件,也不含获取权重的指引;不授予任何 NVIDIA 知识产权权利。代码许可证为 MIT,相对宽松;而权重文件本身仍受 NVIDIA 的模型许可约束。
把两头合起来看:结构(MIT 代码)公开,参数(专有许可)不公开。这构成了一种有意义的边界划分——网络架构知识进入公共领域,模型参数仍留在版权世界。对渲染研究者来说,前者才是长期无法获得的部分。
意味着什么
对图形工程师:第一份关于 DLSS 5 网络内部结构的公开、可验证、可复现的描述。此前公众对 DLSS 内部结构的了解停留在"基于 Transformer"(DLSS 4 报告披露过超分和光线重建采用 Transformer 架构)这类粗粒度描述,从来没人完整写出过 71 个块怎么连接、每一步精度在哪里发布、softmax 按什么顺序求和。现在这些都以可执行代码和捕获数据的形式公开了。
对推理系统工程师:一组完整的实时 FP8 推理参考实现,从 Vulkan 扩展组合、cooperative matrix FP8 GEMM、PTX 代码生成、绕屏障的链式调度,到字节级验证门禁。这些组件在任何"把大模型塞进严格帧预算"的场景里都会反复遇到,而公开、完整、带逐字节验证的例子此前几乎不存在。
对实时渲染行业:DLSS 5 把实时管线推进到生成式渲染的时代,而神经渲染管线的关键组件现在有了公开参照。社区之前已经出现过社区驱动的 DLSS 替代实现(比如开放式的 XeSS 生态、AMD FSR 的 ML 版本),但"逐字节复刻闭源网络并完整记录其结构"属于另一个层级的逆向工程。它演示了一种路径:通过输出比对来合规地理解一个黑盒模型,而不是通过破解或提取它的参数。
严格的使用边界同样清楚:仓库里的浏览器演示需要用户自己提供模型文件,没有权重它不会运行;NVIDIA 随时可以通过改变模型结构使这套复刻过时——而那恰恰说明它记录的是某个具体时点的精确快照,而不是一个可以跟着官方更新的通用替代品。
项目地址:github.com/maanHimself/OpenDLSS-NR,MIT 许可证。NVIDIA 的 DLSS 5 报告和项目页见 research.nvidia.com/labs/adlr/DLSS5。