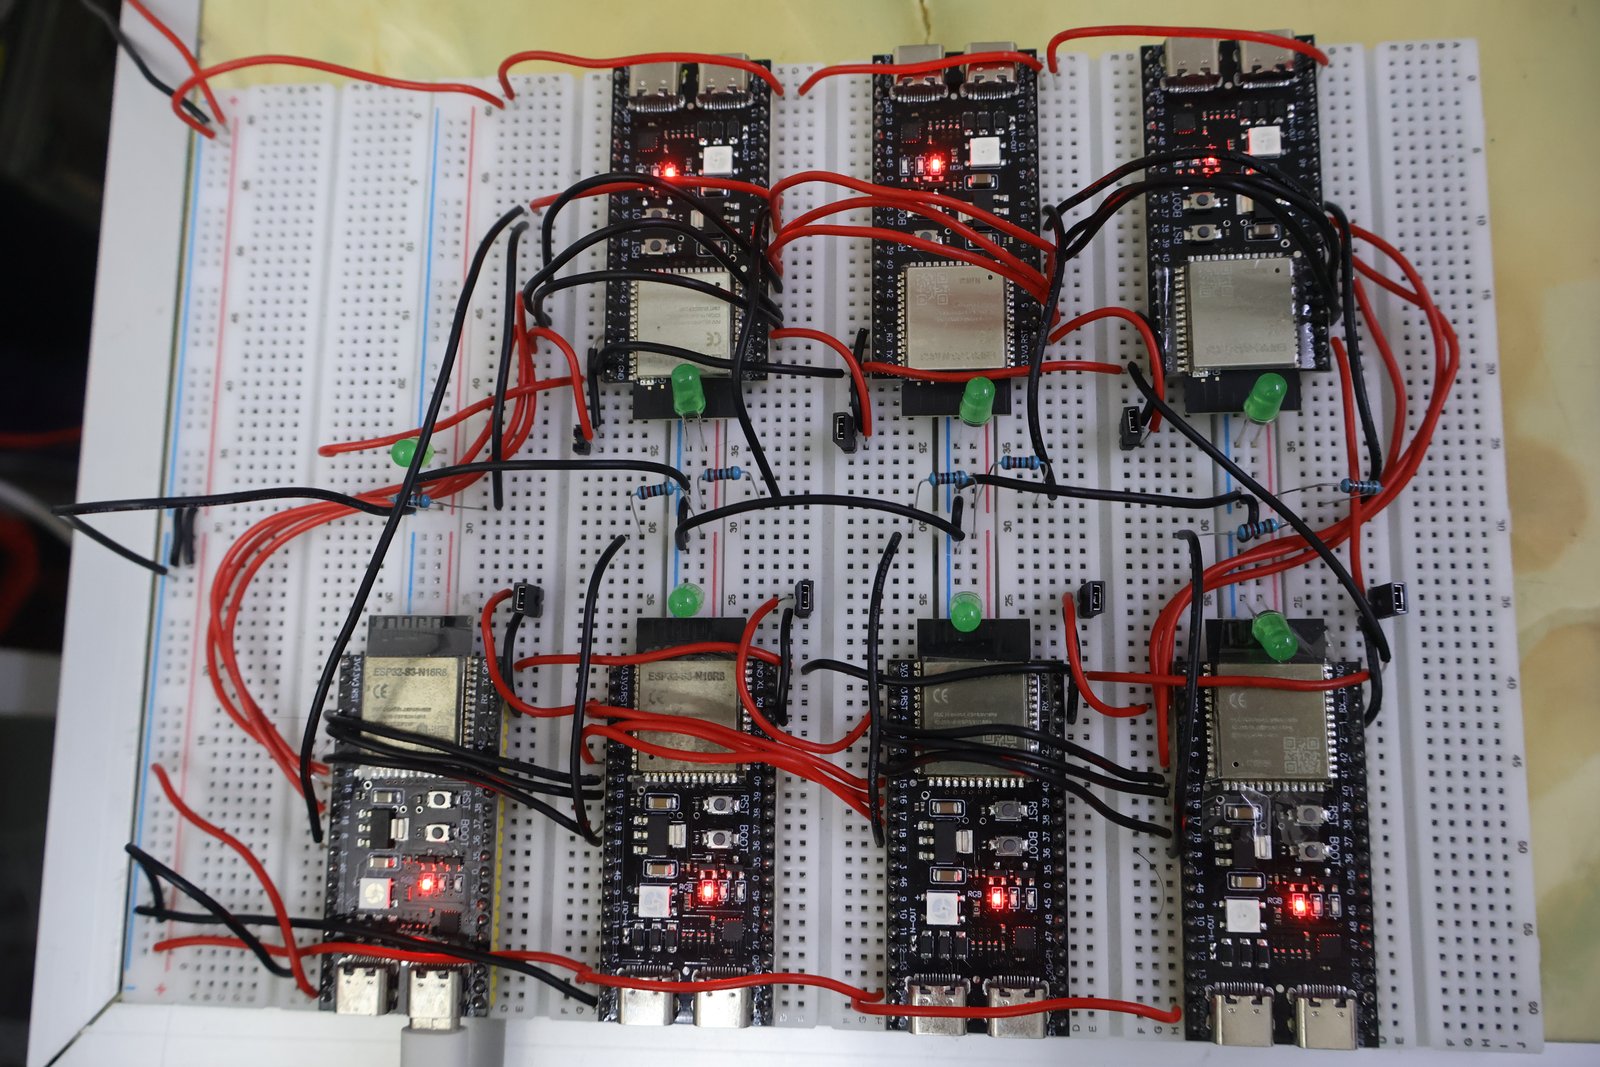
7 块单价 20 元左右的开发板,加起来不到 150 元的硬件成本,正在用 1.58 bit 精度的权重跑一个 0.5B 参数的语言模型。这是 GitHub 上的开源项目 ESP32s3-LLM-Cluster 做成的事:把 Qwen2-0.5B 剪枝、量化,切分到 7 块 ESP32-S3 上,每块板子只负责 4 层 Transformer,用 SPI 菊花链串成一条推理流水线。
1.58 bit 是什么:三种数组成的世界
理解这个项目,先要理解 BitNet。2024 年 2 月,微软研究院发表论文《The Era of 1-bit LLMs》,提出 b1.58 量化方案:把大模型里的线性层权重从 16 位浮点数压缩成三种值——-1、0 和 1。log2(3) ≈ 1.58,这就是「1.58 bit」名字的来源。
传统模型里,每个权重是一个 16 位浮点数,占用 2 字节;换成三值权重后,4 个权重打包进 1 个字节(每个权重 2 bit),存储空间缩到原来的约 1/16。更关键的是计算量的变化:浮点乘加变成三值加减法。权重只有 -1、0、1 三种取值时,「乘法」退化成符号翻转和跳过——硬件上不需要乘法器,只需要加法器和查表。
代价是模型必须在训练时就按三值约束来学(量化感知训练,QAT),而不是训练完再压缩。微软用 4 万亿 token 训练出的 BitNet-b1.58-2B-4T 是这条路线的官方基准,推理速度在 x86 CPU 上达到全精度模型的最高 6.17 倍,能耗降低 71.9% 到 82.2%。2026 年,微软又把这条路线延伸到 embedding 模型(BitNet-embedding-0.6B/270M)和语音识别(VibeASR.cpp),bitnet.cpp 官方推理框架宣称可在单颗 CPU 上以每秒 5 到 7 个 token 的速度运行 100B 参数的 BitNet 模型。
ESP32s3-LLM-Cluster 是这条技术路线的极限测试:当算力和内存小到只剩几百 KB RAM 时,1.58 bit 的压缩优势不再是锦上添花,而是「能不能跑起来」的入场券。
七块板子怎么分工
项目的底座是乐鑫 ESP32-S3:双核 Xtensa LX7,主频 240 MHz,16 MB Flash 加 8 MB PSRAM,一块板子的算力大致相当于十年前的入门手机。这个规格跑不动任何完整的大模型,但把模型切开就不一样了。
作者选择了流水线并行(pipeline parallelism):7 块板子里 1 块做主节点,6 块做计算节点,24 层 Transformer 按「每板 4 层」切开:
| 参数 | 数值 |
|---|---|
| 基座模型 | Qwen2-0.5B(剪枝+量化) |
| 层数分布 | 24 层 ÷ 6 节点 = 每节点 4 层 |
| 隐藏维度 | 896(Qwen2-0.5B 原生) |
| 注意力头 | 14 个 Q 头 / 2 个 KV 头(GQA) |
| 词表 | 从 151K 剪到 32K |
| 量化精度 | 1.58 bit 三值线性层 + INT4 嵌入 |
| 单层权重 | 约 3.82 MB(打包后) |
| 每节点占用 | 约 15.3 MB Flash(16 MB 分区内) |
| 上下文窗口 | 512 token(KV Cache 放 PSRAM) |
主节点负责 BPE 分词和 INT4 词嵌入查表(约 14 MB,放 Flash),把隐状态向量以 FP32 发给第一个计算节点。每个计算节点接收上游传来的向量,跑完自己负责的 4 层(RMSNorm、带 RoPE 的 1.58 bit 注意力、KV Cache 写入 PSRAM、1.58 bit MLP),再把结果传给下一块板。第 6 块节点算完后把向量传回主节点,主节点做最终 RMSNorm、LM Head 映射和贪心采样,吐出下一个 token。
板间通信用的是 SPI 菊花链:每块板开两个 SPI 通道,A 通道做发送、B 通道做接收,板与板之间 GPIO 直连——主节点的 MOSI/CLK/CS 接到节点 1 的接收脚,节点 1 的发送脚再接节点 2,以此类推。主节点还负责整个集群的复位时序:它的 GPIO 1 串起所有板子的复位引脚,最后一块板算完会通过 GPIO 3 把「全部就绪」信号回传给主节点。
工程细节里的真功夫
这个项目的价值不只在架构图,还在它把 MCU 上跑 LLM 的工程坑逐个趟了一遍:
汇编级优化。三值线性层的核心运算写在了 Xtensa 汇编里(bitlinear_forward.S),配合查找表(lut_table.cpp)做定点 MAC 运算。权重按 4 个一组压进字节、按 4 字节对齐排布,让单核内层循环尽量吃满总线带宽。
词表手术。Qwen2 原生词表 151K,嵌入矩阵放不进任何一块板。作者先用 crop_token.py 把词表剪到 32K——这是 ESP32-S3 16 MB Flash 的物理上限,workflow 里明确写着:再大就得把嵌入矩阵拆到两块板子上。
编码一致性陷阱。workflow.md 里有一条对所有做极端量化的人都适用的警告:Python 端的 2 bit 三值打包顺序,必须和 C/汇编端的解包逻辑、验证脚本的解包逻辑严格一致。不一致不会报错、不会崩溃,只会静默污染所有权重,输出变成无法从症状定位的乱码。作者把它标注为「非常难调试」的一类问题。
物理顺序即逻辑顺序。每块板烧录的层文件必须和它在菊花链里的物理位置对应:节点 1 烧 layers_0_to_3,节点 2 烧 layers_4_to_7。烧错了同样不报错,只是静默产出乱码。排错手段朴素到靠 Windows 设备管理器逐个核对 COM 口。
功耗实测。整个集群(7 块板)空闲时 5V × 0.23A ≈ 1.17W,推理时约 1.53W——比一颗灯泡省电,这是 MCU 端侧部署相对 GPU 服务器的真实数量级差距。
性能与诚实声明
每块节点推理一层切片耗时约 1.3 秒,6 个节点串行推进,每生成一个 token 要走完一整条链。作者没有公布精确的 tokens/s,但按流水线时序推算,生成速度在个位数 token 每秒的量级——和 bitnet.cpp 在桌面 CPU 上跑 100B 模型的速度恰好是同一数量级,只是算力差了四个数量级以上。
作者在 workflow.md 里同样诚实地写了上限:自制的 QAT 微调脚本只能做部分训练,loss 会停在 8.0 左右,模型会输出重复 token;他用贪心(argmax)采样配合欠训练模型,实际输出接近「高级噪声生成器」。HN 评论区最热门的留言也是这个判断——「压缩到这个程度,它更像一个精致的 LLM 噪声制造机,但依然迷人」。
这正好划出了 1.58 bit 路线的现实边界:权重压缩 16 倍省下的内存和算力,被训练质量买单。微软的 2B-4T 模型用 4 万亿 token 训练才追平同尺寸全精度模型;在家庭实验室里用单卡做 QAT 微调,很难复现这个训练强度。三值约束能不能用更少的算力逼近全精度质量,仍是这条路线的核心 open problem。
对端侧部署的实际参考
抛开极客趣味,这个项目给做端侧 AI 的人提供了几个可复用的结论:
流水线并行在 MCU 集群上可行,但吞吐受最慢节点限制,且延迟随规模线性增长。作者明确说了:100 块板可以跑 400 层模型,但推理时间也线性变长。这决定了它适合「能等」的场景(离线文本生成、传感器数据批处理),不适合交互式应用。
SPI 菊花链是低成本板间互联的务实选择。不用网络栈、不用交换芯片,GPIO 直连加 DMA 收发,代价是带宽和拓扑固定。对百元级硬件,这套方案的工程性价比高于以太网或 WiFi 方案。
量化方案的验证工具链比量化本身更难。三值打包/解包的多端一致性、词表裁剪后的嵌入覆盖检查、层序与物理拓扑的核对,这些「不出错但产出乱码」的问题占了这个项目 troubleshooting 章节的大半。做端侧量化部署的团队可以直接参考这份故障清单。
1.58 bit 是 MCU 的可行起点,不是终点。0.5B 模型切到 7 块板、512 token 上下文、个位数生成速度——这些数字离实用还有距离,但把「LLM 的最低硬件门槛」又推低了一档。HN 评论区有人照这个思路在做 150M 参数、更低量化位数的版本。当量化训练方法和端侧芯片继续各自的曲线,两条曲线的交点就是下一个「能在灯泡里跑模型」的时刻。
来源
- ESP32s3-LLM-Cluster(GitHub):README 与 workflow.md,规格表、接线图、功耗数据均出自此处
- The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits(arXiv:2402.17764):BitNet b1.58 原理论文
- 1-bit AI Infra: Fast and Lossless BitNet b1.58 Inference on CPUs(arXiv:2410.16144):bitnet.cpp 加速与能耗数据
- microsoft/BitNet(GitHub):官方推理框架与模型发布时间线
- Hacker News 讨论