9 月中旬 TypeSafe 发布 Jev 时,它带来的定价结构比模型本身更引人注意:输入每百万 token 0.042 美元,输出免费,因为 Jev 根本不生成文本。这个模型接受一段状态描述和几个问题,返回每个选项的概率分布,官方公布的单次响应在 70 到 500 毫秒之间。两周之后,一个名叫 Jeff 的独立项目把同样的能力搬到了本地:基于 Qwen3.5 和 Gemma 4 微调出的 0.8B 到 2B 小模型,权重放在 Hugging Face 上以 Apache 2.0 许可开放下载,在 RTX PRO 6000 上单次决策 22 毫秒,在 Apple M4 Max 上用 MLX 后端 28 毫秒。
项目代码在 GitHub 仓库 firelex/jeff,训练配方从 Denis Yarats 的开源项目 AutoJev(MIT 许可)继承而来,作者明确标注与 TypeSafe 没有隶属关系。模型不生成任何文字:输入状态和选项,输出直接是概率。这个设计决定了它的速度上限、部署成本,也决定了它的能力边界。
决策模型在解决什么问题
现有 LLM 的输出是字符串。软件要消费这个字符串,需要解析、校验、重试,还要承担模型跑偏的风险。TypeSafe 把这类任务称为 System One 任务,取 Kahneman《思考,快与慢》里"快思考"的意象:不写文章、不做多步推理,只在高频出现的判断场景里给出选项级别的结论,比如客服工单该路由到哪个组、这条用户消息是否在要求退款、这段内容属于哪个审核标签。
Jev 的训练方法被称为 RLCD(Reinforcement Learning for Calibrated Decisions),优化目标绕开了人类偏好,直接对准校准过的决策:模型给出的概率要如实反映正确率,说 0.9 置信的判断就应该九成是对的。输出结构在推理前就定义好,模型不可能输出类型错误的结果。Jev 的三项题型由此而来:choice(从最多 255 个选项中选一个,附带完整概率分布)、Noul(是/否判断,返回 0 到 1 的浮点数,名字来自伯努利分布)、score(沿自定义等级给出一个分数)。多个独立问题可以放进同一次请求并行求值。
这个形态的适用面由两个约束划出来。一是模型只做选择,不做预测:官方实测让 Jeff 预测"两回合后会发生什么",结果与随机猜测无异。二是题目描述的方式对结果影响极大:官方对照实验里,同一局 Frogger 游戏,把目标选项的措辞改成与其他前选项一致的句式,单局过马路次数从 15 次跌到 3 次;改回描述后果的写法,成绩恢复。
Jeff 的做法:把读答案变成一次前向
Jeff 复刻的是接口格式,实现路径是标准的微调。基座模型是 Qwen3.5-0.8B、Qwen3.5-2B 和 Gemma 4 E2B,训练管线分四步:
- 构建混合训练集:27.1 万条问题,来源包括转成判断题形式的公开数据集(蕴含、问答、情感、安全、事实核查)、WinoGrande 训练集 4 万条、RAGTruth 1.5 万条、ContractNLI/CUAD/ConditionalQA 等真实长文档、1 万条程序化生成且带精确答案的概率题、约 3.1 万条由本地教师模型(Qwen3.8-Flash-Next,跑在两台 DGX Sparks 上)合成并抽检的问题。3% 的问题里埋了注入攻击样本,5% 加了"以上都不是"选项。
- 泄漏过滤:每条训练题对照评测集和 JevBench 做近似重复检测,共移除 50 条。
- 全量微调:单卡 RTX PRO 6000(96GB),一个 epoch,batch 256,学习率 0.8B 用 5e-6、2B 用 1e-5,损失函数是对选项字母位置的交叉熵,之后拟合一个标量温度用于校准。checkpoint 在开发集上挑选,评测集从不参与任何选择。
- 服务化:jeff-serve 提供 HTTP 接口,请求格式与 Jev 相同,MLX 后端覆盖 Apple Silicon。
推理时模型读提示词末尾答案槽位置上每个选项字母的 logits,一次前向经 softmax 得到全部选项的概率。因为没有逐 token 生成的过程,延迟基本不受选项数量影响,这正是 0.8B 模型能压到 22 毫秒的原因。
成绩:分类打平,推理仍有代差
官方在五个公开基准共 4599 题外加 JevBench 公开困难档(105 题,单独计分)上对比了三个 Jeff 模型与 Jev 的公开成绩:
| 基准 | 0.8B 未训练 | Jeff-0.8B | 2B 未训练 | Jeff-2B | Gemma4 E2B 未训练 | Jeff-Gemma4-E2B | Jev 公开成绩 | AutoJev-27B |
|---|---|---|---|---|---|---|---|---|
| 总体(5 基准) | 45.3 | 79.1 | 46.5 | 83.1 | 62.5 | 81.6 | 83.0 | 84.9 |
| BBH | 39.5 | 64.0 | 46.0 | 68.0 | 51.3 | 66.4 | 94.3 | 82.8 |
| Financial PhraseBank | 36.0 | 96.4 | 53.4 | 96.3 | 86.0 | 96.1 | 77.0 | 84.2 |
| JudgeBench | 56.6 | 62.6 | 57.4 | 64.6 | 46.9 | 60.6 | 78.6 | 78.9 |
| RAGTruth | 49.1 | 86.1 | 35.9 | 88.9 | 63.8 | 87.4 | 77.3 | 88.9 |
| WinoGrande | 49.2 | 68.6 | 52.2 | 79.0 | 51.0 | 77.4 | 90.7 | 83.3 |
| JevBench 困难档 | 36.2 | 47.6 | 45.7 | 53.3 | 41.0 | 48.6 | 73.3 | 70.3 |
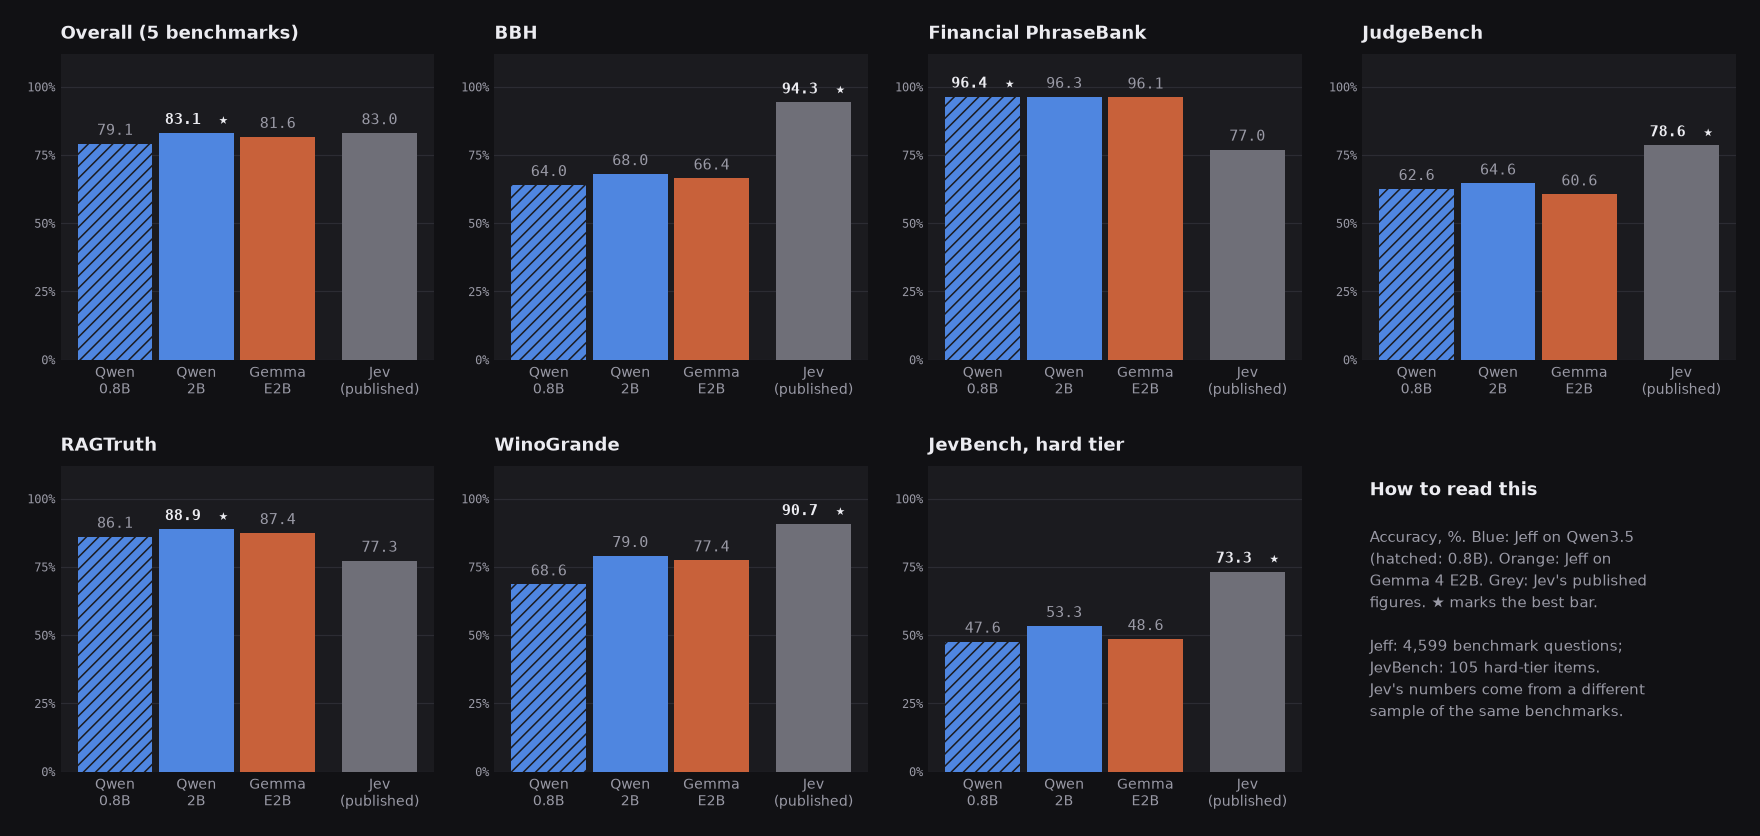
数据里有三条清晰的分界线。Financial PhraseBank(金融语句情感)和 RAGTruth(引用真实性核查)这两类分类与 grounding 任务上,0.8B 的 Jeff 已经超过 Jev 的公开成绩:96.4 对 77.0,86.1 对 77.3。BBH、JudgeBench、JevBench 困难档这些推理密集型基准上差距仍然完整:0.8B 在 BBH 上拿到 64.0,Jev 是 94.3;困难档 47.6 对 73.3。官方模型卡把这一点写得很明确,并注明 Jev 与 AutoJev 的公开数字测自同一批基准的不同样本。
延迟与体积是另一组对照。0.8B 的 16-bit 权重只有 1.7GB,M4 Max 上 28 毫秒一次决策;Jev 的公开 Doom 对局里单次调用 212 毫秒(含网络,测自加州笔记本到官方服务)。两套数字没有在相同硬件上对齐,但量级差距说明了本地部署省掉的东西:没有网络往返,没有按 token 计费的账单,也没有速率限制。
游戏实测:基准分不能预测真实对局
项目用 Doom、Frogger、Pac-Man 做零样本测试,每回合把局面和合法动作写成文字,选项只描述后果("这个方向会被车撞掉一条命"),不提示哪个是对的。20 局、固定种子 1234:
| 模型 | Doom 击杀数 | Frogger 过街次数 | Pac-Man 豆子(满 98) |
|---|---|---|---|
| 随机动作 | −0.05 | 0 | 11.2 |
| 手写规则机器人 | 6.55 | 10.25 | 94.1 |
| Qwen3.5-0.8B 未训练 | 5.0 | 1.0 | 25.8 |
| Jeff-0.8B | 6.55 | 10.3 | 57.0 |
| Qwen3.5-2B 未训练 | 0.55 | 0.05 | 72.1 |
| Jeff-2B | −0.9 | 6.0 | 41.2 |
| Gemma4 E2B 未训练 | −0.55 | 0 | 3.2 |
| Jeff-Gemma4-E2B | 0.55 | 0.15 | 53.2 |
两个反直觉的结果值得单独看。第一,2B 全面强于 0.8B 的基准分数没有迁移到游戏里:Jeff-2B 在 Doom 上是负分(方向感完全丢失),Frogger 和 Pac-Man 都不如 0.8B 版本,官方推测未训练的 2B 本就更保守,而训练放大了这一倾向,Pac-Man 里掉头频率达到未训练版的 3.5 倍,官方标注"需要进一步研究"。第二,未训练的 Gemma 4 E2B 基准分最高(62.5),对局表现却是三个基座里最差的,多数时候选对但不可靠,而实时循环里偶发错误会复合放大;训练修好了它的 Pac-Man(3.2 到 53.2),没修好 Doom 和 Frogger。这组数据对"拿基准分选模型"的惯常做法是一个直接的提醒。
另一个细节来自对照实验:Jev 官方 Doom 提示词(一个方位角数字加一条瞄准规则)在 Jeff 全部模型上失效,无论训练与否;把后果写成文字的选项描述才是有效格式。
边界与上手
官方的使用建议里最关键的一条是"推理交给代码,判断交给模型":它是一个分类器,不是规划器,描述每个选项导向什么后果可以,让它预测未来不行。校准是按开发数据拟合的,换到差异大的领域需要重新校准。目前只支持英文文本。
上手路径只需要四步:克隆仓库、uv sync(Apple Silicon 加 --extra mac)、从 HuggingFace 拉权重、设 JEFF_BACKEND=mlx 启动 jeff-serve。0.8B 权重 1.7GB,16GB 内存的笔记本装得下,请求格式与 Jev 完全一致,应用从 API 版迁到本地版不需要改请求结构。零样本精度不够时,官方给的参照是:约 1.1 万条领域样本微调半个多小时(单 GPU),语音导航任务的保留集准确率从 31.7% 提到 95.8%,单次决策约 40 毫秒(M4 Max)。
这条路线的可复现性是它和订阅一个 API 的本质区别。训练数据构成、泄漏过滤记录、每个基准的选择过程全部公开,训练脚本在仓库 scripts/train_all.sh 里;数据的每个来源带着各自的开源许可(部分 CC BY-SA),官方发布权重与代码但不发布训练数据。同样的思路在开放权重社区不止一家:Simon Willison 在 9 月 21 日的评论里列出了同期出现的 Kev(Qwen 3.5 的 0.8B/4B/9B 版本)等一批复刻项目,JevBench 也已经出现在公开评测里。决策模型这个类目正在从单一的商业 API 变成一组可以自己跑、自己训、自己校准的本地组件,Jeff 把这条路的最低门槛拉到了一张消费级显卡或者一台 M 系列笔记本的高度。
来源: