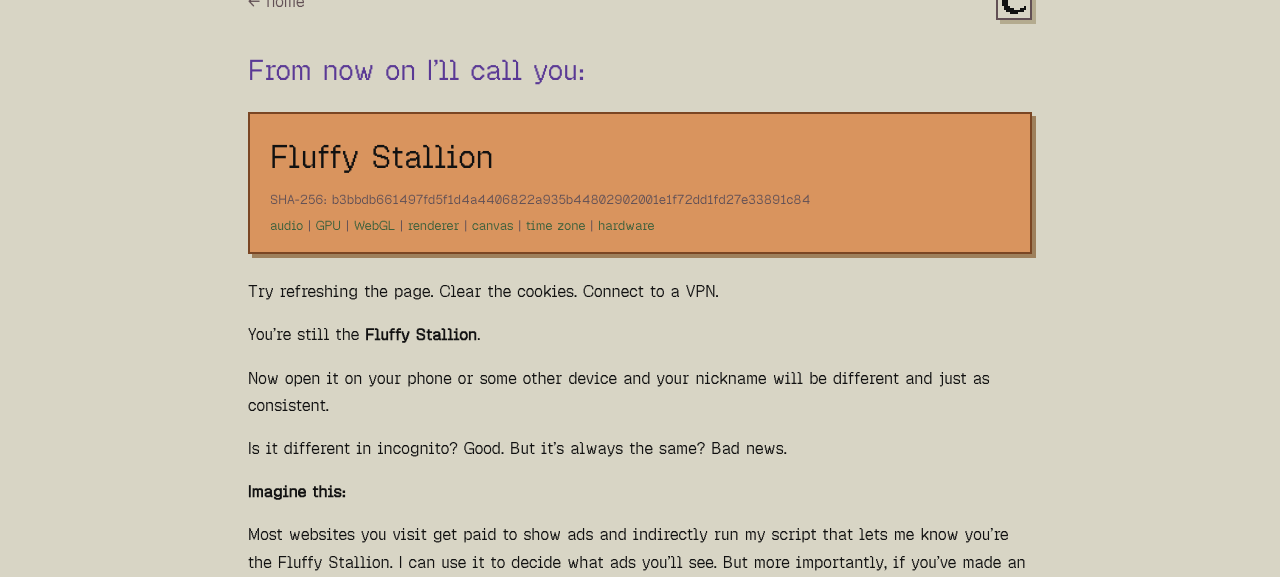
清除 Cookie、刷新页面、连上 VPN——页面右上角的昵称纹丝不动。这是 royfish.dev 上的一个现场演示:访客第一次打开页面,会领到一个由 SHA-256 哈希挑选的昵称;换隐身模式、清空浏览数据,昵称保持一致;换一台手机打开,昵称才变成另一个同样稳定的值。支撑这个昵称的并非存储在你设备上的任何数据,而是浏览器每次访问时主动交出的设备特征组合。这项技术在行业里叫浏览器指纹(browser fingerprinting),Google 已于 2025 年 2 月 16 日起正式允许其广告产品使用。
Cookie 退场留下的空缺
第三方 Cookie 的运作方式是把一小段数据存在你的设备上,网站靠读写这段数据在不同站点之间认出你。它的弱点恰好是「存在设备上」:用户可以清除,Safari 和 Firefox 已经默认拦截,欧盟的 Cookie 同意弹窗从法律层面把它围了个遍。
Google 在 2019 年承诺逐步废弃第三方 Cookie,并在 2020 年推出了 Privacy Sandbox 计划,声称要建立一套兼顾广告收入与隐私的替代方案。五年之后,Privacy Sandbox 的几项核心 API 因为性能不达预期和反垄断审查压力相继收缩,Google 在 2024 年 7 月正式宣布放弃废弃第三方 Cookie 的计划。转折发生在 2024 年 12 月 19 日:Google 通知广告主,自 2025 年 2 月 16 日起,使用其广告产品的组织可以采用指纹技术识别用户。英国信息专员办公室(ICO)随即公开批评这一决定,执行总监 Stephen Almond 称其「不负责任」(irresponsible);电子前哨基金会(EFF)的 Lena Cohen 评论,Google 曾亲口把指纹描述成「与用户控制不兼容」的技术,如今却为它敞开大门。此前的 Google 广告政策原文写明「不得使用设备指纹」,现在这条禁令已经移除。
与 Cookie 的根本差异只有一句话:Cookie 存在你的设备上,指纹不存在任何地方。指纹是网站在你浏览器里现场测量出来的一组特征值,算完之后哈希成一个标识符。你没有任何按钮可以清除它。
指纹由什么构成
网站的测量材料分两层。网络层是每次 HTTP 请求自带的:IP 地址、User-Agent 头(浏览器类型、版本、操作系统)、Accept-Language 头。这层的数据要么脆弱(IP 随移动网络、VPN、ISP 轮换频繁变化),要么太通用(全球几亿用户共享同一个 User-Agent 字符串),单靠它只能缩小范围。
真正让指纹稳定的是代码层。网站返回的 JavaScript 在你的硬件上运行,而你的硬件会以高度一致的方式响应测量:GPU 的型号与驱动行为、CPU 的核心数、内存大小、屏幕分辨率与像素比、刷新率、音频处理路径的浮点误差、系统装了哪些字体。这些测量不需要任何权限弹窗——它们藏在网页代码的正常执行过程里。
单看每一项都不足以识别一个人。最新的 Chrome 用在不同的人身上,法国语区有几百万用户,M4 芯片的 Mac 有几百万台。但把条件组合起来,候选池会急速收缩:「最新 Chrome + 法语 + M4」已经是小集合,再加几项硬件测量,池子里常常只剩一个人。指纹不需要全球唯一,只需要在你所在的样本范围内足够独特。
信息熵:指纹为什么几乎必然命中
理解指纹的威力需要一点信息论。一个特征能提供多少信息,用 bit 来度量:一个二选一、各占一半的特征值 1 bit;八分之一的人有的特征值 3 bit;128 分之一的人有的特征值 7 bit。这个量叫 surprisal(信息量),越罕见的答案给出的信息越多。
页面作者举了一个具体计算:某个特征 128 个人里只有 1 个人具备。回答「是」的概率是 1/128,信息量 log₂(128/1) = 7 bit,加权贡献 1/128 × 7 ≈ 0.055 bit;回答「否」的概率是 127/128,信息量约 0.0113 bit,贡献约 0.011 bit。合计这个特征的熵贡献只有约 0.066 bit——平均下来,问这一项几乎什么都得不到。但如果运气好抽中那个「是」,7 bit 一次到手。
独立的特征可以比特数直接相加:1 bit(性别)+ 3 bit(胡子)+ 7 bit(独眼)= 11 bit,即 2048 分之一。实际情况更复杂,Thomas Bayes 早就指出特征之间不独立——有胡子的大概率是男性,这些相关会让实际信息量低于简单相加。但指纹采集的特征足够多,每项贡献零点几到几个 bit,总量很容易超过把一个人从百万人里挑出来所需的 20 bit。
这套概率推理在别的领域同样致命。医学诊断里,一个准确率 99% 的检测用在患病率 0.01% 的人群上,阳性结果是误报的概率约是真实患病的 100 倍——因为先验概率差异悬殊。密码学里,四个随机单词的密码强度等价于八个随机键盘字符。法医学里,要在百万人城市中锁定一个人约需 20 bit,而目击者描述若只能把嫌疑人缩小到千分之一,则还有一千个可能对象。
五种现场测量方法
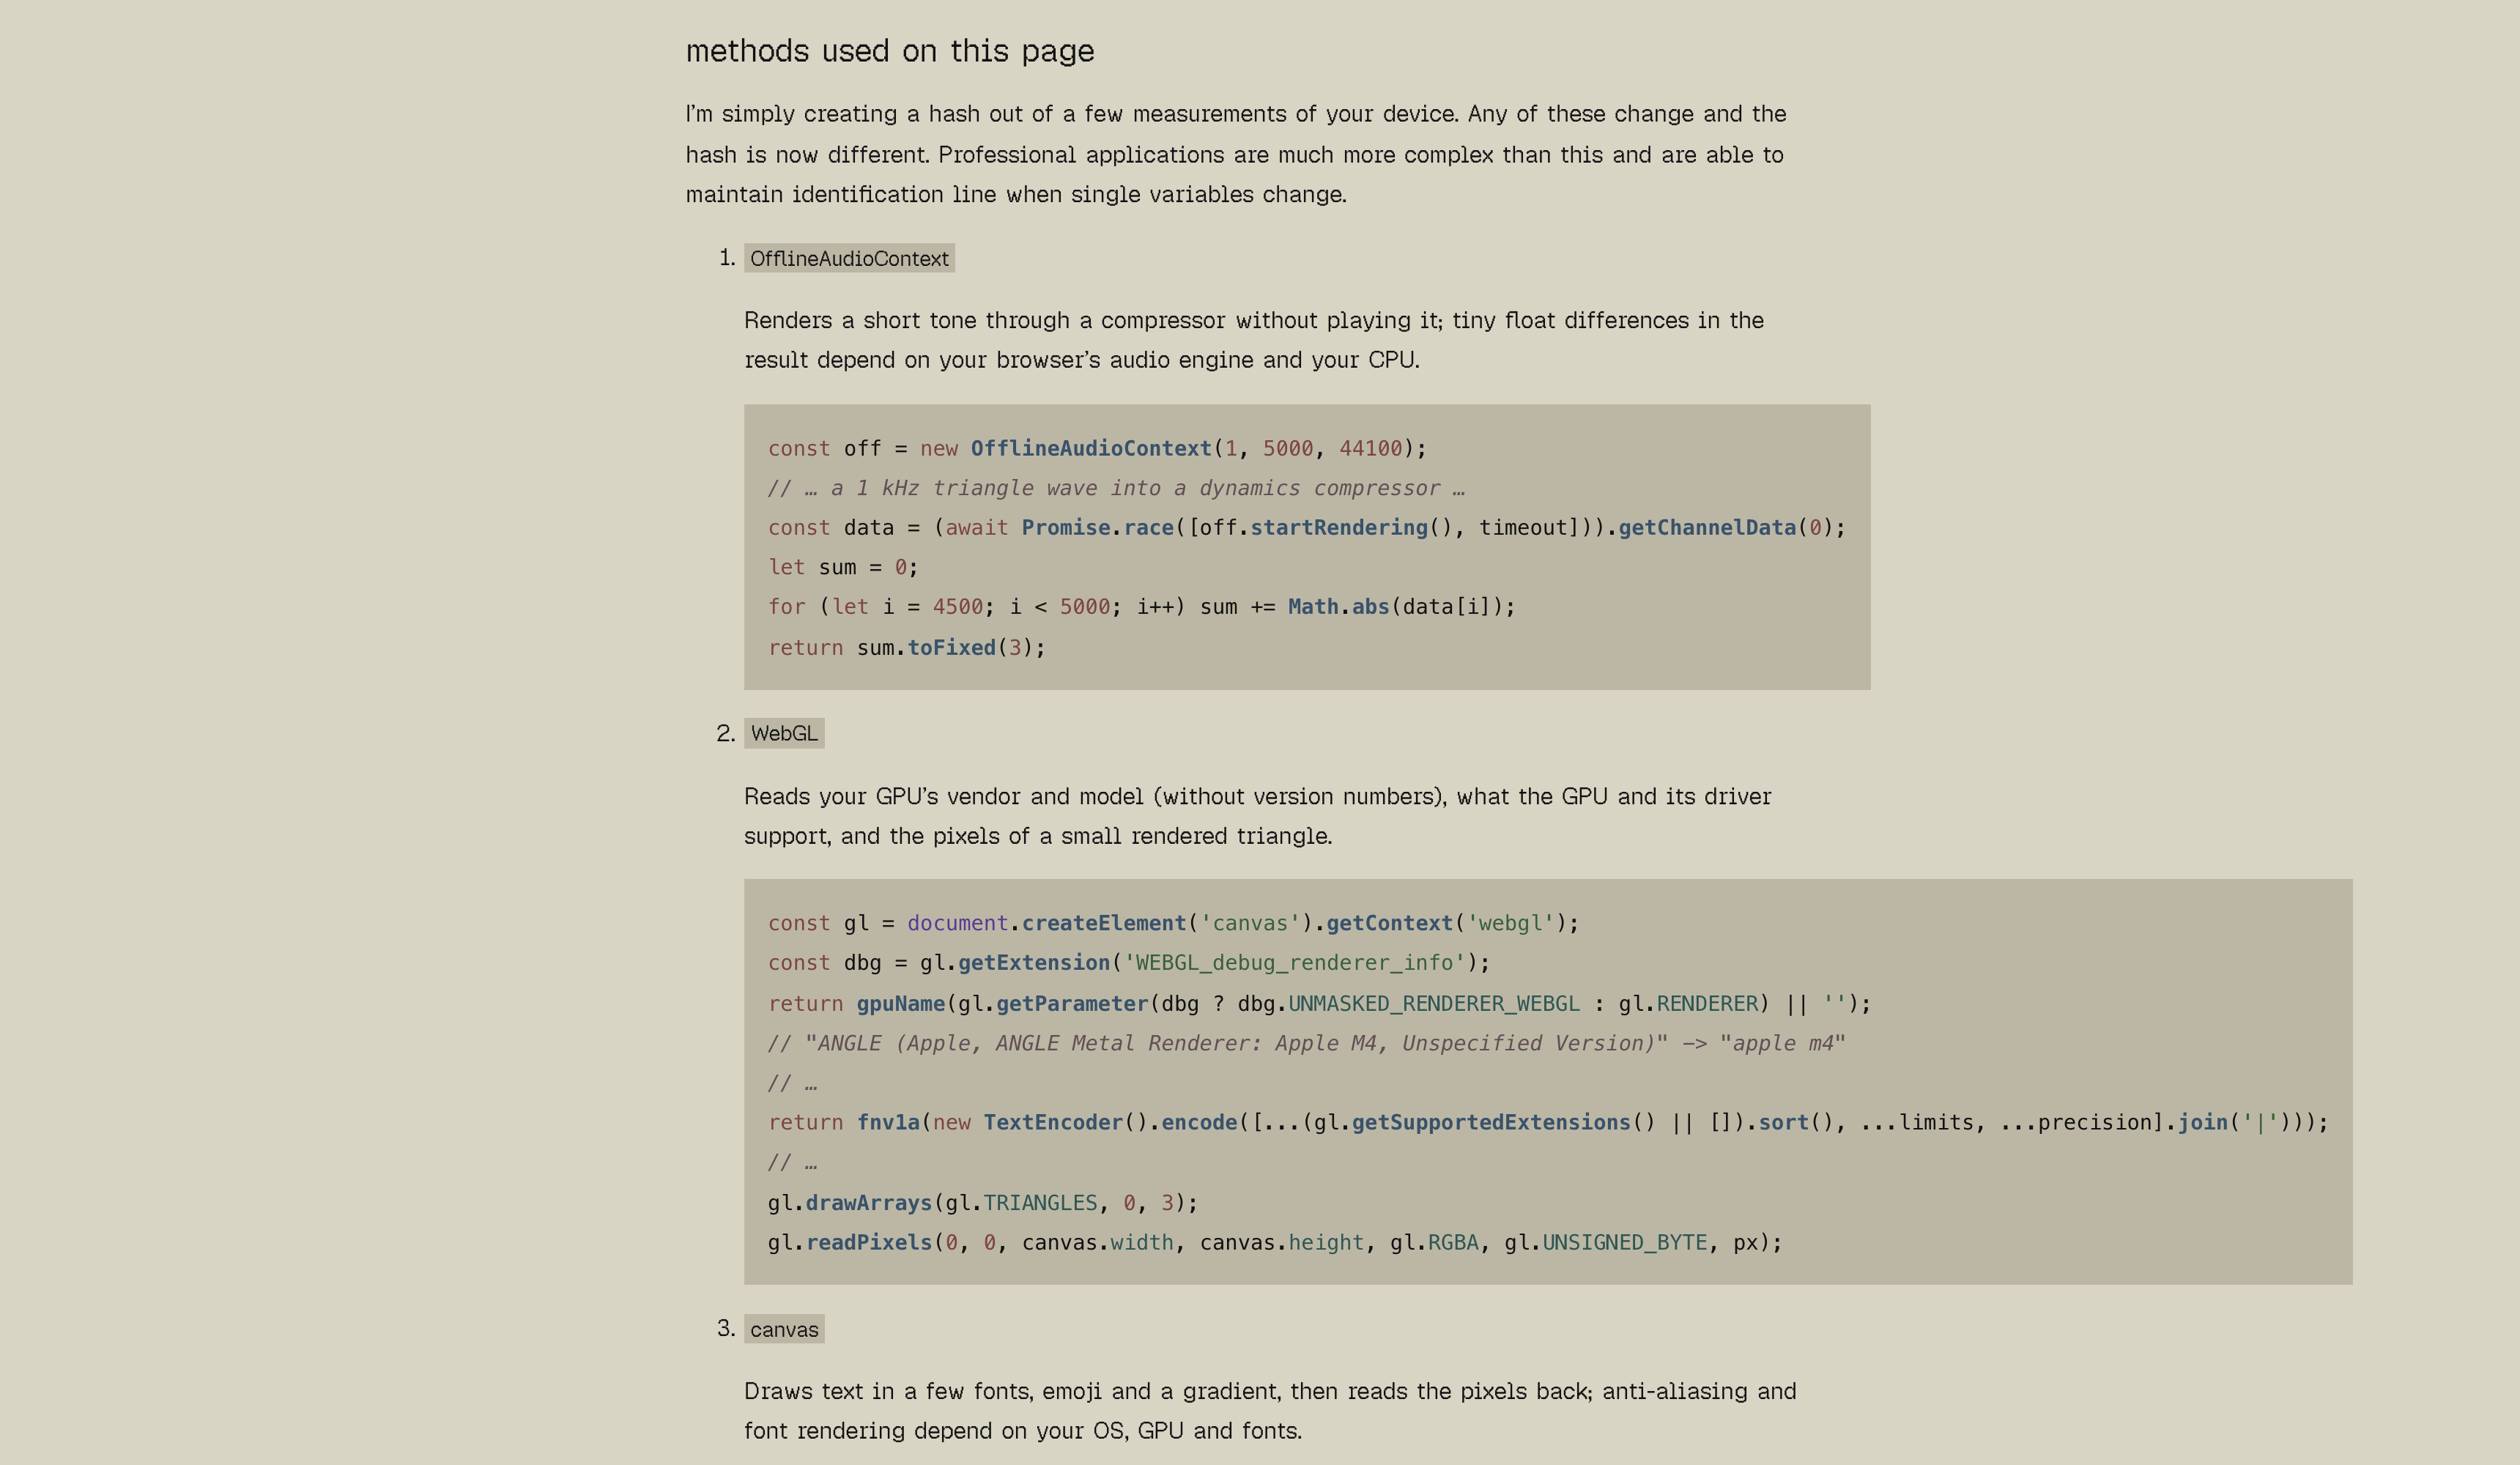
royfish.dev 在页面底部公开了自己用的五种测量,全部无需权限弹窗。专业级指纹系统远比这复杂,还能在单一特征变化时维持识别线,但教学版足以说明原理。
OfflineAudioContext:让浏览器在后台渲染一段 1 kHz 三角波通过动态压缩器,不播放、用户无感知,然后读取渲染结果的浮点样本。不同浏览器音频引擎和 CPU 浮点行为的微小差异会在样本求和里留下稳定差异——页面只对第 4500 到 5000 个样本求绝对值之和,保留三位小数,这个值在你的设备上几乎不变。
WebGL:先读取 GPU 的厂商与型号字符串(通过 WEBGL_debug_renderer_info 扩展拿 UNMASKED_RENDERER_WEBGL,例如 ANGLE (Apple, ANGLE Metal Renderer: Apple M4)),再把 GPU 支持的扩展列表、参数上限、着色器精度规格排序拼接后做 FNV-1a 哈希,最后画一个三角形并逐像素读回渲染结果。GPU 型号+驱动行为+渲染像素,三层信号都指向同一块芯片。
canvas:在画布上以几种字体绘制文字、emoji 和渐变,再读回像素。抗锯齿和字体光栅化由操作系统、GPU 和字体渲染引擎共同决定,同一段文字在不同设备上的像素级差异稳定可测。这也是 2014 年最早被大规模商用的指纹技术之一。
Intl:读取时区、日历、数字格式系统。这条对 VPN 免疫——你把 IP 换成了东京,但你的浏览器仍然报告你住处的时区和本机数字格式习惯。
navigator:CPU 核心数(hardwareConcurrency)、内存大小(deviceMemory,仅 Chrome 报告)、浏览器语言。
页面把五项测量拼成一个字符串,SHA-256 一次,哈希值再映射成一个「形容词+动物」的昵称。你看到的是哈希的可读化身,而非哈希本身。
重识别研究:几个特征就够
指纹的威力有严格的统计学背书。2019 年 Nature Communications 上的一项研究(Rocher, Hendrickx, de Montjoye,DOI: 10.1038/s41467-019-10933-3)用生成模型估算了「稀疏数据集里把一个人认出来」的成功率:只需 15 个人口统计学属性(邮编、性别、生日这类),99.98% 的美国人可以在任何数据集中被正确重识别。这个结论解释了为什么隐私监管机构对指纹如此警惕——去掉名字之后的「匿名」数据,靠属性组合就能还原回个人。
更早的经典工作来自 Latanya Sweeney:2000 年前后她用邮编+性别+出生日期三件套识别了 87% 的美国人,并据此推动了 HIPAA 去标识化规则的修订。指纹采集的特征数远超三件套,且测量无需用户配合。
反制:加噪声,还是全部一样
指纹难防的根源在于测量是被动发生的——你访问页面的那一刻,数据已经交出去了。现有的两条技术路线,对应两种对抗哲学。
随机化路线(Brave 的 farbling):给指纹采样的输出注入受控噪声。Brave 用「每个会话 × 每个站点」的种子确定性地扰动 canvas、WebGL、音频等 API 的返回值——同一个站点在同一次会话内读到的值稳定(网站功能不被破坏),跨会话或跨站点读到的值不同(指纹无法串联)。这项技术的学术源头是 2015 年的 PriVaricator 和 2017 年的 FPRandom 两篇论文。随机化的局限同样明确:安全公司 fingerprint.com 的实测指出,GPU 渲染器字符串这类强特征如果暴露得太精确,仍可作为跨会话匹配的稳定锚点,随机化没有覆盖的信号会泄露一致性。
同质化路线(Tor、Mullvad Browser):让所有用户看起来完全一样——统一的 User-Agent、统一的窗口圆角值、统一的时区处理,把每个人的指纹都压成同一个。代价是浏览器体验受损(固定窗口大小、禁用部分功能),采用者始终是小众。
Safari 和 Firefox 介于两者之间,提供部分防护但不足以对抗高级指纹;Chrome 用户在防护上接近裸奔。 EFF 的 Cover Your Tracks(coveryourtracks.eff.org)可以现场测试你的浏览器指纹独特度,并给出每一项特征的熵值。
值得单独一提的是隐私扩展的悖论:装指纹对抗扩展的人反而更独特——因为少数人才装,扩展本身成了特征;聪明的追踪脚本可以识别扩展干扰的信号,绕开被扰动的读数,改用未受保护的测量。JShelter 这类扩展通过拦截浏览器 API 来破坏指纹脚本,但会顺带弄坏一些网站。没有哪种扩展比得上浏览器引擎层的原生防护——要么换用带防护的浏览器,要么接受被测量。
开发者的双刃剑
对开发者来说,指纹同时是风控工具和合规雷区。反爬虫和反欺诈场景里,指纹是识别脚本流量、设备农场、撞库攻击的主力信号——纯靠 IP 和账号体系挡不住分布式攻击,指纹能把这些伪装背后的一致性暴露出来。但同一套技术在广告测量里使用,2025 年 2 月起在 Google 广告产品里是合法的,在欧盟 GDPR 语境下却需要合法基础和透明度——ICO 已经明确提醒企业,指纹不是法外之地。
近期学术进展也在给双方加码。2025 年 1 月同一团队在 Nature Communications 发表了重识别成功率的比例定律(scaling law),把「多少条记录、多少个属性会泄密」变成了可计算的公式。指纹对抗由此进入军备竞赛的下一阶段:测量端在加特征,防护端在加噪声和同质化,而每一次进步都同时服务于防御者和攻击者。
你可以现在就测试自己的浏览器:打开 coveryourtracks.eff.org,看它给你的指纹打多少 bit 的独特度评分,再看看它给出的那串「你的浏览器在多少台设备中是唯一的」结论。
参考:royfish.dev《Fingerprints are the new cookies》;Google Privacy Sandbox 官方博客(2024-07 放弃 Cookie 废弃计划、2024-12 指纹政策通知);ICO 对 Google 指纹政策的批评(2025-01);Brave 官方技术文档《Fingerprinting defenses 2.0》(farbling 机制,2021);Rocher, Hendrickx, de Montjoye, Nature Communications 2019,DOI: 10.1038/s41467-019-10933-3;EFF Cover Your Tracks